DataPrep спроектирован по принципу «сначала браузер»: инструмент запускается как обычный сайт, а всю тяжёлую работу берёт на себя фоновый движок. Для корпоративного масштаба подключается опциональный бэкенд — без смены инструмента и без переучивания пользователей.
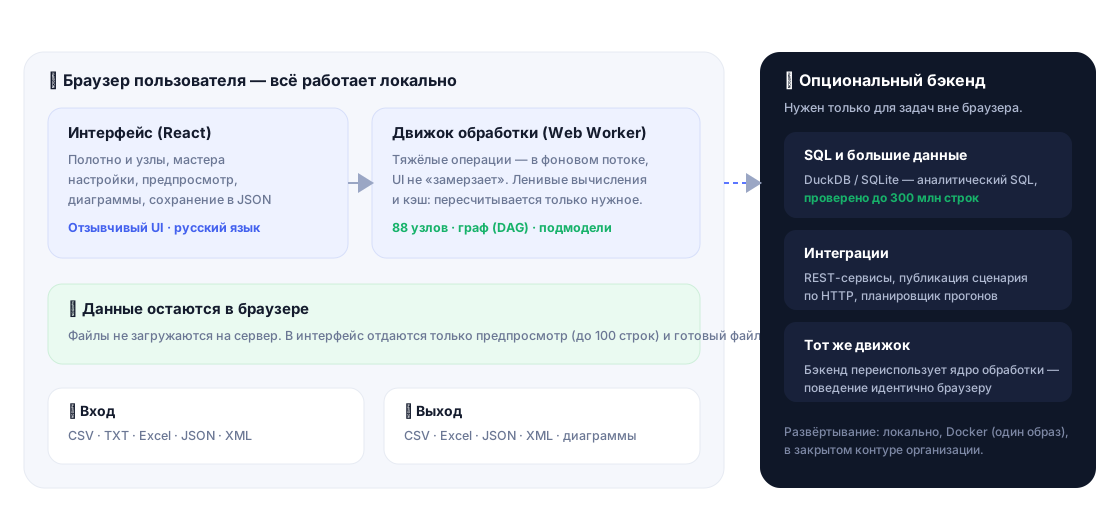
Ничего не нужно устанавливать пользователю. Открыл страницу — и работаешь. Тот же инструмент доступен на любом компьютере в организации.
Разбор файлов, фильтрация и расчёты идут в отдельном потоке (Web Worker). Поэтому интерфейс остаётся отзывчивым даже на больших наборах данных.
Пересчитывается только то, что реально изменилось и понадобилось. Это экономит время и ресурсы на повторных запусках.
Файлы не загружаются на внешние серверы. В интерфейс отдаётся только предпросмотр и готовый результат. Возможна работа офлайн.
Сценарий — это граф из узлов: ветвления, несколько источников, объединения. Реальные процессы описываются один в один.
Часть логики оформляется как вложенная «подмодель» и переиспользуется между задачами — как функция, только визуально.
DataPrep хранит описание полей (типы, метки) отдельно от самих строк. Это даёт корректную типизацию (числа, даты, логические значения) и предсказуемое поведение операций — без «сюрпризов» Excel.
Крупные таблицы не дублируются на каждом шаге — результаты фильтров это ссылки на исходные строки. Отсюда скорость и экономная работа с памятью.
В интерфейс отдаётся не весь набор, а первые строки для предпросмотра. Полный результат формируется только при экспорте или запуске — это держит UI лёгким.
Готовый конвейер сохраняется в открытый JSON-файл: его можно передать коллеге, поставить в регламент или перенести между средами. Никакого вендор-лока.
Замеры движка (та же логика, что в интерфейсе). В приложении эти операции идут в фоновом потоке, поэтому интерфейс не «замерзает».
| Объём | Импорт | Фильтр | Экспорт |
|---|---|---|---|
| 10 000 строк | ~22 мс | ~4 мс | ~2 мс |
| 100 000 строк | ~169 мс | ~35 мс | ~14 мс |
| 500 000 строк | ~754 мс | ~130 мс | ~71 мс |
| Режим больших данных (SQL / DuckDB) | линейное масштабирование — проверено до 300 млн строк / 22 ГБ | ||
Для по-настоящему больших данных подключается опциональный бэкенд с аналитическим SQL: тяжёлая агрегация уходит на движок больших данных, а в интерфейсе остаётся тот же визуальный сценарий.
Проверенный веб-стек — легко поддерживать и развивать силами обычной команды разработки.
Плагин-архитектура означает, что новые узлы добавляются по единому контракту, не затрагивая остальные — платформа расширяется под задачи компании без риска для существующих сценариев.
Посмотрите, какие задачи это уже решает.
 Data