

Как мы структурируем наши проекты dbt
Как служба поддержки dbt и консультанты по аналитике, мы создаем множество проектов на базе dbt. Со временем мы разработали внутренние соглашения о том, как их структуририровать.
В этой статье не ставится задача научить вас, как спроектировать окончательную модель для всхе заинтересованных сторон, здесь не рассказывается о том, следует ли вам денормализировать все в одну широкую главную таблицу или иметь много таблиц, которые необходимо объединить на уровне бизнес-аналитики. На эту тему есть целые книги. Но мы будем использовать этот материал в качестве руководства, когда у вас уже есть представление о том, что вы строите, для того, чтобы разбить преобразования на отдельные модели dbt.
Важно отметить, что это не единственный или объективно лучший способ структурировать проект dbt. Скорее, этот пост отражает наше текущее мнение. На эти мнения сильно повлияли:
- наши взгляды на дизайн модели данных; на которые, в свою очередь, влияют:
- виды аналитических задач, которые мы решаем для клиентов
- стек данных, с которым мы обычно работаем, в котором несколько источников данных загружаются сторонними инструментами, а хранилище данных оптимизировано для аналитических запросов (поэтому мы не сильно ограничены соображениями оптимизации производительности).
Наша точка зрения почти гарантированно изменится со временем, поскольку мы обновляем свои взгляды на моделирование, сталкиваемся с большим количеством аналитических проблем и эволюционируем стеки данных. Здесь также стоит четко указать: то, как мы структурируем проекты dbt, имеет смысл для наших проектов, но может не подходить для ваших! Эта статья есть на Discourse, и там мы сможет все обсудить — мне бы хотелось узнать, как другие участники сообщества структурируют свои проекты.
Для сравнения, (недавно обновленные) передовые методы отражают принципы, которые мы считаем верными для любого проекта dbt. Конечно, эти два документа идут рука об руку — наши проекты построены таким образом, что эти принципы легко соблюдать, в частности:
- Ограничивать ссылки на необработанные данные.
- Один раз переименовать и преобразовать поля.
- Группировать свои модели в каталоги
- Добавлять тесты к своим моделям
- Рассматрвать информационную архитектуру вашего хранилища данных.
- Разделять источнико-ориентированные и бизнес-ориентированные преобразования
Мы также недавно провели (и записали на ютуб) рабочее время по этой теме — в этой статье представлен общий план, но в видео на ютуб гораздо больше подробностей и обсуждений.
Преобразование данных
Данные в любом из наших проектов имеют три отдельных контрольных точки:
- Источники: схемы и таблицы в структуре, соответствующей исходному коду (т. е. таблицы и столбцы в структуре, основанной на том, что возвращает API), загруженные сторонним инструментом.
- Промежуточные модели: элементарная единица моделирования данных. Каждая модель имеет отношение один к одному с исходной таблицей данных, которую она представляет. Она имеет ту же степень детализации, но столбцы были переименованы, преобразованы или с пользой переработаны в согласованный формат.
- Модели витрин: модели, которые представляют бизнес-процессы и объекты, абстрагированные от источников данных, на которых они основаны.
В простом проекте это могут быть единственные модели, которые вы строите; более сложные проекты могут иметь ряд промежуточных моделей, которые помогут в этом пути, а также аксессуары к этим моделям (см. ниже).
Все еще в замешательстве? Давайте рассмотрим пример! Подумаем о бизнесе программного обеспечения, который использует Stripe и Braintree для сбора платежей по подписке. Их три этапа моделирования могут выглядеть так:
- Источники: платежные записи из Stripe API и платежные записи из Braintree API, загруженные в их хранилище данных с помощью стороннего инструмента.
- Промежуточные модели: платежи Stripe и Braintree преобразуются в единую форму с согласованными именами столбцов.
- Модели витрин: модель ежемесячного регулярного дохода (MRR), которая классифицирует доход на одного клиента в месяц как новый доход, обновления, понижения и отток, чтобы понять, как бизнес работает с течением времени. Будет полезно отметить, был ли доход получен через Stripe или Braintree, но это не принципиально отдельные модели.
Следует отметить, что между контрольными точками области подготовки данных и витрин происходит явное изменение: источники и промежуточные модели ориентированы на источники, тогда как модели витрин ориентированы на бизнес.
В наших проектах dbt это приводит нас к первому разбиению в каталоге models/, которое помогает нам провести это различие:
├── dbt_project.yml
└── models
    ├── marts
    └── staging
Подготовка необработанных данных
Целью промежуточного слоя является создание промежуточных моделей. Промежуточные модели берут необработанные данные, очищают и подготавливают их для дальнейшего анализа. Для пользователя, запрашивающего хранилище данных, отношение с префиксом stg_ указывает, что:
- Поля были переименованы и преобразованы в единообразном стиле.
- Типы данных, такие как часовые пояса, согласованы.
- Произошла легкая очистка, например, замена пустой строки значениями NULL.
- Возможно, произошло сведение объектов.
- Существует первичный ключ, который одновременно уникален и не равен нулю (и проверен).
В промежуточных моделях могут быть соединения чтобы добавлять дополнительные столбцы для контекста или обогащения; добавлять строки через объединения и удалять их через фильтры; дедуплицировать естественный ключ или хешировать суррогатный ключ.
Поскольку мы часто работаем с несколькими источниками данных, в нашем промежуточном каталоге мы создаем один каталог для каждого источника.
├── dbt_project.yml
└── models
    ├── marts
    └── staging
        ├── braintree
        └── stripe
Каждый промежуточный каталог содержит как минимум:
-
Одну промежуточную модель для каждого объекта, полезную для аналитики:
- С именем stg_<source>__<object>.
- Обычно материализуется в виде представления (если для производительности это не требуется в виде таблицы).
-
Файл src_<source>.yml, который содержит:
- Определения источников (source), тесты и документация
-
Файл stg_<source>.yml, содержащий
- Тесты и документацию для моделей в том же каталоге
├── dbt_project.yml
└── models
    ├── marts
    └── staging
        └── braintree
            ├── src_braintree.yml
            ├── stg_braintree.yml
            ├── stg_braintree__customers.sql
            └── stg_braintree__payments.sql
Некоторые пользователи dbt предпочитают иметь один файл .yml для каждой модели (например, stg_braintree__customers.yml). Это вполне разумный выбор, и мы рекомендуем его реализовать, если ваши .yml-файлы начинают становиться громоздкими.
А как же базовые модели?
Более ранние версии документации dbt рекомендовали внедрять «базовые модели» в качестве первого уровня преобразования — и мы привыкли организовывать и именовать наши модели таким образом, например, models/braintree/base/base_payments.sql.
Мы поняли, что, хотя причины, лежащие в основе этого соглашения, были действительными, но нейминг был опцией, поэтому в нашем недавнем обновлении лучших практик мы убрали упоминание о базовых моделях. Вместо этого мы заменили его принципами «однократного переименования и преобразования» и «ограничения зависимостей от необработанных данных».
При этом в наших проектах dbt каждый источник проходит ровно через одну модель следующего вида:
with source as (

    select * from {{ source('braintree', 'payments') }}

),

renamed as (

    select
        id as payment_id,
        order_id,
        convert_timezone('America/New_York', 'UTC', createdat) as created_at,
        ...

    from source

)

select * from renamed
Мы по-прежнему называем это базовым преобразованием. Если ваши исходные данные в хорошем состоянии, это преобразование может быть единственным, что нужно для построения промежуточной модели, и наша промежуточная модель — этот SQL.
Однако построение промежуточной модели может потребовать очистки, исправления и категоризации нескольких моделей или может потребовать присоединения или объединения с другим источником. Чтобы убедиться, что наш источник данных проходит через базовое преобразование, мы расширяем нашу DAG вверх от промежуточной модели, создавая отдельную базовую модель, из которой мы затем выбираем.
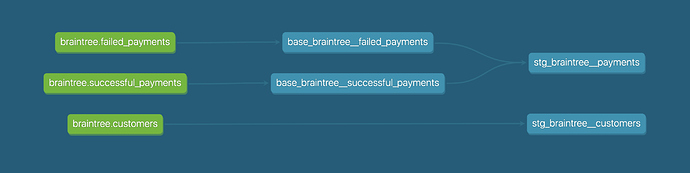
В наших проектах dbt мы размещаем эти базовые модели во вложенном базовом подкаталоге.
├── dbt_project.yml
└── models
    ├── marts
    └── staging
        └── braintree
            ├── base
            |   ├── base.yml
            |   ├── base_braintree__failed_payments.sql
            |   └── base_braintree__successful_payments.sql
            ├── src_braintree.yml
            ├── stg_braintree.yml
            ├── stg_braintree__customers.sql
            └── stg_braintree__payments.sql
Базовые модели в наших проектах:
- Часто используют эфемерную материализацию, поэтому они не видны конечным пользователям, запрашивающим наше хранилище.
- Тестируются в файле base.yml в том же каталоге, что и базовые модели.
Если нам нужны дополнительные преобразования между базовой и промежуточной моделями, мы создаем вложенный каталог staging/<source>/intermediate и помещаем туда эти преобразования.
Описание бизнеса через витрины
Витрины — это хранилища моделей, описывающих бизнес-сущности и процессы. Их часто группируют по бизнес-единицам: маркетинг, финансы, продукт. Модели, которые являются общими для всего бизнеса, сгруппированы в основной каталог.
├── dbt_project.yml
└── models
    ├── marts
    |   ├── core
    |   ├── finance
    |   ├── marketing
    |   └── product
    └── staging
О том, как проектировать модели, написаны целые книги, что выходит за рамки этой статьи. С нашей точки зрения, наша главная цель — построить модели фактов и измерений, абстрагированные от исходных данных, на которые они опираются:
- fct_<verb>: высокая узкая таблица, в которой представлены реальные процессы, которые произошли или происходят в настоящее время. В основе этих моделей обычно лежит неизменяемый поток событий: сеансы, транзакции, заказы, истории, голоса.
- dim_<noun>: широкая короткая таблица, в которой каждая строка представляет собой человека, место или вещь; окончательный источник истины при идентификации и описании сущностей организации. Они изменчивы, хотя и меняются медленно: клиенты, продукты, кандидаты, здания, сотрудники.
Там, где работа с промежуточными моделями ограничивается очисткой и подготовкой, таблицы фактов являются продуктом существенного преобразования данных: выбора (и сокращения) измерений, прокрутки данных, выполнения бизнес-логики и принятия обоснованных, уверенных решений.
Этот уровень моделирования значительно сложнее, чем создание промежуточных моделей, и модели, которые мы разрабатываем, в значительной степени адаптированы к аналитическим потребностям организации. Таким образом, у нас гораздо меньше условностей, когда дело доходит до этих моделей. Некоторые шаблоны, которые мы нашли полезными:
- Модели fct_ and dim_ должны быть материализованы в виде таблиц внутри хранилища для повышения производительности запросов. По умолчанию мы используем табличную материализацию, а там, где этого требует производительность, используем инкрементную материализацию.
- Промежуточные преобразования, необходимые для получения модели фактов или измерений, помещаются во вложенный каталог marts/<mart>/intermediate. Они называются <useful_name>__<transformation_in_past_tense>.sql. Отсутствие префикса и использование двойных подчеркиваний указывает на то, что это промежуточные модели, которым нельзя доверять, однако, возможно, их также стоит скрыть в другой схеме.
- Модели тестируются и документируются в файле <dir_name>.yml в том же каталоге, что и модели.
- Любая дополнительная документация помещается в файл <dir_name>.md в том же каталоге.
Таким образом, каталог «Marts» может выглядеть так:
├── dbt_project.yml
└── models
    ├── marts
    │   ├── core
    │   │   ├── core.md
    │   │   ├── core.yml
    │   │   ├── dim_customers.sql
    │   │   ├── fct_orders.sql
    │   │   └── intermediate
    │   │       ├── customer_orders__grouped.sql
    │   │       ├── customer_payments__grouped.sql
    │   │       ├── intermediate.yml
    │   │       └── order_payments__joined.sql
    │   ├── finance
    │   ├── marketing
    │   └── product
    └── staging
Весь этот проект приводит к следующему DAG:
Аксессуары для данных
Существуют и другие типы файлов SQL, которые находят применение в проектах dbt. В дополнение к постановкам и витринам, у нас есть каталоги моделей, такие как:
- utils: таблица all_days. Это полезно везде, хотя никогда не служит основой для анализа/отчетности.
- lookups: таблица сопоставления пользователей, таблица почтовых индексов и стран и т. д. Они с такой же вероятностью будут CSV seed, как и таблицы в производственной базе данных. Вы можете ссылаться на него в нескольких непредсказуемых точках во время моделирования и, возможно, даже в инструменте BI.
- admin: журналы аудита, складские операции, обслуживание Redshift и добавочные записи разных DDL, которые вы запускаете, чтобы обеспечить бесперебойную работу вашего проекта.
- metrics: точно определенные измерения, взятые из таблиц фактов, непосредственно способствующие составлению отчетов в виде временных рядов, и четко структурированные, чтобы можно было проводить непосредственное сравнение с целями и прогнозированием. Таблица метрик находится ниже от таблиц измерений и фактов в вашей DAG и заслуживает особого статуса.
- Packages: хотя это и не папка с моделями в основном проекте, пакеты, включающие модели (например, наш пакет snowplow), могут быть сконфигурированы в пользовательскую схему и шаблоны материализации из dbt_project.yml.
В проектах, где мы оказываемся с этими дополнительными моделями, мы часто используем пользовательские схемы в качестве каталогов на нашем складе, чтобы логически сгруппировать модели, выбирая имя схемы, которое соответствует имени каталога в нашем проекте dbt.
В заключение
В этой статье построение DAG для проекта dbt было описано слева направо, начиная с источников и заканчивая моделями витрин.
Однако стоит отметить, что в действительности мы часто сначала продумываем задачу моделирования справа налево — мы начинаем с идеи информационной панели или отчета, который хотим построить, затем наносим на доску структуру модели витрины, которая нам нужна на нашем складе, чтобы включить эту панель инструментов. На той же доске мы часто будем работать в обратном направлении, пока не достигнем источника, прежде чем мы начнем писать какой-либо реальный SQL. Я обнаружил, что только после того, как я несколько раз решал задачу моделирования, у меня появлялось интуитивное представление о том, как построить DAG слева направо. Другими словами: мы склонны думать о своем предназначении, прежде чем начать свое моделирование.
Мы стандартизировали наши соглашения об именах и типах в наших соглашениях о кодировании dbt.


