

Архитектура данных: слоистость, data mesh vs data lake и их сочетания
AI-ready дата-платформа требует другого подхода к управлению данными: не только хранения и обработки, но и инженерии данных как продукта, контрактов между доменными командами, прозрачности происхождения данных и обеспечении качества на каждом этапе использования. В этой главе рассматриваются основы слоистости данных, ключевые принципы data mesh и data lake, их преимущества и ограничения, а также паттерны сочетания этих подходов в рамках инфраструктуры для больших языковых моделей (LLM) и агентных систем. Особое внимание уделяется архитектурным решениям, интеграции между слоями, управлению метаданными и контрактами, а также практикам обеспечения безопасности и соответствия требованиям регуляторов.
Существует стремление строить архитектуру данных не как монолитную систему хранения, а как экосистему, где данные превращаются из активов в продукты: понятные, доступные и доверенные для конкретных доменов и сценариев использования. В контексте LLM и агентных систем это означает наличие управляемых потоков данных, проходящих через слои подготовки, семантической обработки и доставки фрагментов данных к моделям, векторным индексам и агентным сервисам. Глиняный фундамент такой архитектуры - это ясные контракты, стандартизованные схемы, управляемая семантика и ориентированные на продукт команды с ответственностью за качество и эволюцию набора данных.
- Краткое содержание главы
- Понимание слоистости данных и её роли в AI-ready платформах.
- Data mesh и data lake: принципы, преимущества, ограничения и критерии выбора.
- Паттерны сочетания mesh и lake для поддержки LLM и агентных систем.
- Архитектура данных под сценарии работы со знанием: векторные хранилища, семантика, контрактная архитектура и управление качеством.
- Практики внедрения: governance, metadata, безопасность, операционная устойчивость и миграции.
Слоистость данных: от сырья к ценности
Слоистость данных - это концепция разделения потока данных на последовательные уровни обработки, хранения и представления. Это позволяет трансформировать необработанные данные в управляемые, описанные и пригодные к использованию продукты данных. В контексте AI-ready платформ три базовых слоя выступают как минимум в виде:
- Raw (Bronze): источник данных в их исходной форме. Здесь сохраняются оригинальные файлы, потоки журналов, события и экспортируемые таблицы без значительной обработки. Цель уровня Bronze - полнота и устойчивость к изменениям форматов.
- Clean (Silver): данные проходят очистку, нормализацию, обработку ошибок, базовую денормализацию и преобразования, которые пригодны для аналитики и подготовки входов для моделей. Этот слой часто поддерживает схемы и валидацию данных.
- Curated / Feature (Gold): данные приводятся к бизнес-ценности: агрегаты, нормализованные справочники, признаки для моделей и подготовленные наборы для конкретных сценариев применения. В контексте LLM и агентных систем сюда включаются подготовленные признаки, фичи и векторные представления для ускорения поиска и ответов.
Дополнительно в AI-платформе вводятся специфические слои:
- Feature Store: хранение и версияция признаков для моделей и агентов, поддержка векторных представлений для быстрых retrieval-происхождений.
- Vector / Knowledge Store: индексирование и хранение эмбеддингов, структурированных знаний и контекстов дляGiven/LMM-агентов и ассистентов.
- Semantic Layer: слой метаданных, семантики и контрактов, который обеспечивает согласованность между доменными командами и системами.
Эта слоистость не сама по себе ценность, она служит сценографией для данных, которые затем проходят через механизмы управления качеством, lineage, версионирования и доступа. В рамках hybrid-архитектуры слои должны быть не просто «размещениями» данных, но бизнес-ориентированными сервисами: каждая команда имеет «свою» продуктовую часть данных, которая затем может быть потреблена другими сервисами через контракты. Для поддержки LLM и агентных систем важно обеспечить бесшовный переход от сырого источника к подготовленным признакам и к векторной инфраструктуре, снижая задержки и обеспечивая воспроизводимость результатов.
- Важные принципы:
- четко определить ответственность за каждый слой и владение данными;
- обеспечить контрактность между потребителями и производителями данных;
- поддерживать версионирование схем и данные о lineage;
- минимизировать задержки на критичных потоках данных, особенно для приглашения в реальное время LLM и агентов.
Data mesh и Data lake: принципы и критерии выбора
Data lake традиционно выступает как крупномасштабное хранилище «сырой» информации, доступное для обработки различными инструментами. Data mesh же предлагает архитектуру, ориентированную на продукты данных, где каждая доменная команда несет ответственность за предоставление, качество и управление своими данными как продуктом. Разберём ключевые различия, преимущества и ограничения, а также критерии выбора между этими подходами и их сочетанием.
-
Data lake: основная идея** - единое хранилище больших данных, над которым могут быть применены различные слои обработки и аналитики. Преимущества включают простоту доступа к сырым данным, масштабируемость и экономическую эффективность. Однако недостатки возникают из-за фрагментации знаний, отсутствия согласованных контрактов на качество и доступ к данным между доменами, сложности поддержания согласованности схем, метаданных и lineage, а также рисков для безопасности и соответствия.
-
Data mesh: ориентирован на десегментацию ответственности и создание данных как продукта. Суть в том, что доменные команды определяют набор данных, сервисы поставляются в виде «Data Products» с контрактами, метаданными и SLA. Преимущества - повышенная скорость внедрения, ясная ответственность, лучший контекст и релевантность данных для конкретных сценариев. Риск - необходима зрелость организационной культуры, наличие платформенной команды и инфраструктуры, поддерживающей переключение между продуктами и контрактами между командами.
-
Критерии выбора:
- зрелость организации: если команда умеет работать с контрактами, управлением версиями и metadata, mesh может быть эффективнее. В молодом масштабе lake с постепенным внедрением контрактной практики может быть прагматичнее.
- сценарии использования: для глобальных запросов к данным, исследования и аналитика может подойти lake; для операционных приложений, где нужна предсказуемость и оперативность - mesh.
- требование к скорости внедрения новых данных: mesh позволяет быстрее предоставлять данные командам-доменам, но требует больше организационных усилий.
- требования к семантике и контексту: если необходима единая семантика и строгие контракты, mesh с семантическим слоем и репозиторием признаков удобнее.
-
В рамках AI-ready платформы целесообразно рассматривать сочетание: создать federated data lake как базовую инфраструктуру хранения и обработки, поверх которой разворачиваются domain-specific data products (Data Mesh). Такой подход снижает риски консолидации и позволяет сдерживать дистанцию между техническими и бизнес-слоями. В рамках сочетания важно учитывать:
- Data contracts: версии схем, правила валидации, требования к качеству и задержкам.
- Метаданные и lineage: отслеживание происхождения и трансформаций через все слои.
- Семантическая совместимость: общие словари и онтологии, чтобы данные из разных доменов могли быть интерпретированы агентами и LLM.
- Управление доступом: единая политика доступа с делегированием по доменам, с поддержкой RBAC и ABAC.
-
Примеры инструментов и подходов:
- Lake: Delta Lake, Iceberg для управления транзакциями и версионированием.
- Mesh: концептуальные Data Products, data contracts, платформа как сервис, возможность публикации и каталогизации данных доменными командами.
- Метаданные и lineage: Apache Atlas, Amundsen как открытые решения, а также спецификации для контрактов и схем.
- Контракты и схемы: совместное использование Apache Avro/JSON Schema и Registry (например, Confluent Schema Registry) для обеспечения совместимости между потребителями и производителями данных.
-
В сочетании mesh+lake особенно важно:
- определить единый слой управления метаданными и lineage;
- обеспечить единые политики безопасности и аудита;
- внедрить механизмы контроля качества данных на каждом уровне;
- реализовать паттерны data products с четкими входами, выходами и SLA.
Архитектурные паттерны сочетания: слоистый mesh и lake для AI
Паттерны сочетания mesh и lake делят архитектуру на управляемые доменные продуктовые линии и централизованный технологический слой, который обеспечивает инфраструктуру, стандарты и глобальные сервисы. В контексте AI и агентов это выражается в следующих паттернах:
-
Federated data lake с доменными Data Products: базовое хранилище общего масштаба, которое поддерживает слои Bronze/Silver/Gold, а доменные команды создают свои продукты внутри этого слоя. Преимущества - экономия на хранении, единая сеть стоков и инфраструктуры, упрощение масштабирования. Ограничение - согласование стандартов, контрактов и качеств может быть сложным без зрелой платформы.
-
Data Mesh with shared platform services: каждая команда имеет свой Data Product, подписанный контрактами. В центральном слое размещаются сервисы стандартизации: реестр схем, генераторы признаков, семантический слой, контроль версий, мониторинг качества данных. Преимущества - быстрая поставка данных и явная ответственность; сложности - координация и культурная трансформация.
-
Semantic Layer как общая связующая ткань: независимые Data Products подписывают единые метаданные и контракты, инфраструктура поддерживает единое семантическое описание и политику доступа. Это позволяет агентам и LLM разумно сверяться с контекстом, понимая структурированные данные из разных доменов.
-
Event-driven data fabric: поддержка потоковых данных через оркестрацию событий, где события из доменов попадают в knowledge graph и вектора, что позволяет мгновенное обновление контекстов в агентных системах и LLM. Важно обеспечить idempotent-обработку, обработку в рамках SLA и устойчивость к повторным событиям.
-
Практические принципы реализации:
- контрактность на уровне схем, качеств, задержек и версии;
- единые политики доступа, аудита и соответствия;
- механизм семантической совместимости и общие онтологии;
- поддержка версионирования признаков и данных, чтобы модели и агенты могли воспроизводить результаты.
-
Примеры практической реализации:
- используйте федеративную схему с централизованной регистратурой контрактов и схем;
- внедрите слой управления признаками и векторные сервисы;
- обеспечьте репозитории метаданных и lineage на уровне платформы.
Архитектура данных под LLM и агентные системы
Для LLM и агентных систем характерна потребность в оперативном доступе к актуальным данным, контексту и знаниям, а также в устойчивости к изменению форматов и источников. Архитектура данных должна учитывать специфические требования:
-
Векторные хранилища и знания: для быстрых retrieval и контекстного усиления. Векторные индексы позволяют агентам и моделям быстро находить релевантные фрагменты текста, структурированный контекст и внешние знания. Важно обеспечить обновляемость векторных представлений, версионирование и интеграцию с классическими данными.
-
Семантическая согласованность: единая семантика и словари в рамках доменных продуктов. В контексте машинного обучения и агентов это снижает риск противоречий между данными из разных источников.
-
Продукты данных как сервис: Data Product owners отвечают за качество, доступность и версию набора данных. Это обеспечивает предсказуемость для обучения и инференса LLM и для поведения агентов.
-
Контракты и версионирование: внедряются схемы, правила валидации, SLA и ожидания по задержкам. Это критично для повторной воспроизводимости ответов LLM и устойчивых взаимодействий агентов.
-
Обеспечение контекстных слоёв: для LLM и агентов полезны не только структурированные таблицы, но и контекстуальные сущности, знания в графах и связанные источники. Это достигается через семантические слои и интегрированные knowledge graphs, которые связывают данные из разных доменов.
-
Архитектурные принципы:
- минимизация задержек на критичных путях: ingestion → Bronze/Silver → features/embeddings → агентные сервисы;
- поддержка версионирования данных и признаков без разрушения потребителей;
- обеспечение линейного трафика к LLM, минимизация дубликатов контекстов;
- устойчивость к изменению требований к данным и схемам.
-
Интеграционные сценарии:
- LLM-контекст и референсная база знаний: связываем данные из data lake с векторными хранилищами и knowledge graphs;
- агентные системы: взаимодействие через сервисные контрактные интерфейсы и через модули обработки естественного языка;
- обучение и инференс: управление версиями признаков и данных, синхронизация между обучением и эксплуатацией.
-
Примерная архитектура слоистого паттерна под LLM:
- Ingestion и Bronze: сбор и журналирование источников, структурированная запись потоков;
- Silver: очистка, нормализация и базовая семантика;
- Gold / Features: извлеченные признаки, подготовленные наборы и контекст для моделей;
- Vector Store и Knowledge Graph: эмбеддинги, контекст и знания;
- Serving Layer: API-интерфейсы к моделям и агентам, поддержка контрактов и версии.
Инфраструктура, протоколы и интеграции
Эффективная интеграция между слоями и между доменными командами требует согласованной инфраструктуры и согласованных протоколов взаимодействий. Основные аспекты включают:
-
Протоколы взаимодействия и обмена данными: поддержка streaming и batch, конвенции по сериализации (Avro/JSON), стандарты контрактов и схема регистров. В реальном времени для агентов и LLM критична надежность и низкая задержка.
-
Управление схемами и совместимостью: единый реестр схем, версияция, миграции схем, а также поддержка эволюции схем без разрыва потребителей. Это критично для устойчивости моделей, обучающих и эксплуатационных процессов.
-
Метаданные и lineage: отслеживание источников, трансформаций и зависимостей. Это помогает аудиториям понять, какие данные влияют на результаты моделей, и обеспечивает прозрачность для аудита.
-
Безопасность и контроль доступа: многоуровневые политики защиты данных, сегментация по доменам, использование OPA/OPA-политик, аудит доступа и журналирования. В контексте конфиденциальных данных и регуляторных требований это становится критически важным.
-
Инструменты интеграции: Apache Kafka или другие брокеры событий для потоков; Apache Spark, Flink для обработки; Delta Lake/Apache Iceberg для транзакционных и версионируемых таблиц; платформа для управления признаками и векторами; каталоги метаданных и репозитории контрактов.
-
Пример интеграционных слоев:
- Подключение источников данных: правила извлечения, нормализации и целей доставки.
- Обработка и хранение: Bronze/Silver/Gold, Event Hubs и потоковые каналы; orchestration через Airflow или Prefect.
- Модели и агенты: доступ к признакам, векторным индексам и знаниям через согласованные API; мониторинг результатов.
- Управление и безопасность: единый слой политики данных, аудит, контрактная оценка и соответствие.
-
Протоколы и open-source решения (1-2 примера на раздел):
- Delta Lake и Apache Iceberg как современные платформы для управляемых таблиц и версий данных.
- Apache Atlas или Amundsen как инструменты управления метаданными и lineage.
Управление данными, качество и governance
Ключ к устойчивости AI-платформы - качество и управляемость данных на протяжении всего цикла их использования. Governance в hybrid-архитектуре становится мостиком между инженерией, бизнесом и рисками.
-
Данные как продукт: владелец Data Product несет ответственность за качество, доступность и эволюцию набора данных. Он определяет показатели качества, SLA, требования к схеме и персонализацию под сценарии потребления.
-
Data contracts: формализованные соглашения между производителями и потребителями о схеме данных, типах признаков, валидности, задержках и коррекциях. Контракты должны поддерживать версионирование и эволюцию без разрушения потребителей.
-
Метаданные, lineage и семантика: единый слой метаданных обеспечивает прозрачность источников, трансформаций и контекстной информации для моделей и агентов. Это критично для аудита, повторяемости экспериментов и доверия к результатам.
-
Качество данных: набор метрик качества, валидности и полноты данных; мониторинг потока данных в реальном времени; автоматическая сигнализация и реагирование на деградацию.
-
Governance в масштабе: процессы и роли включают владельцев доменов, платформенную команду, команды по безопасности и комплаенсу; внедрение процессов управления изменениями, аудита и обучения сотрудников.
-
Семантическое выравнивание: единый словарь, онтологии и контексты, чтобы разные домены понимали данные одинаково, что критично для точности выводов LLM и согласованности поведения агентов.
-
Практические подходы:
- внедрение data contracts на каждом критически важном наборе данных;
- активное управление версиями схем, полей и признаков;
- обеспечение согласованности между слоями и доменами через общие политики и политики контроля доступа;
- использование автоматизированных тестов данных для проверки соответствия контрактам и качества.
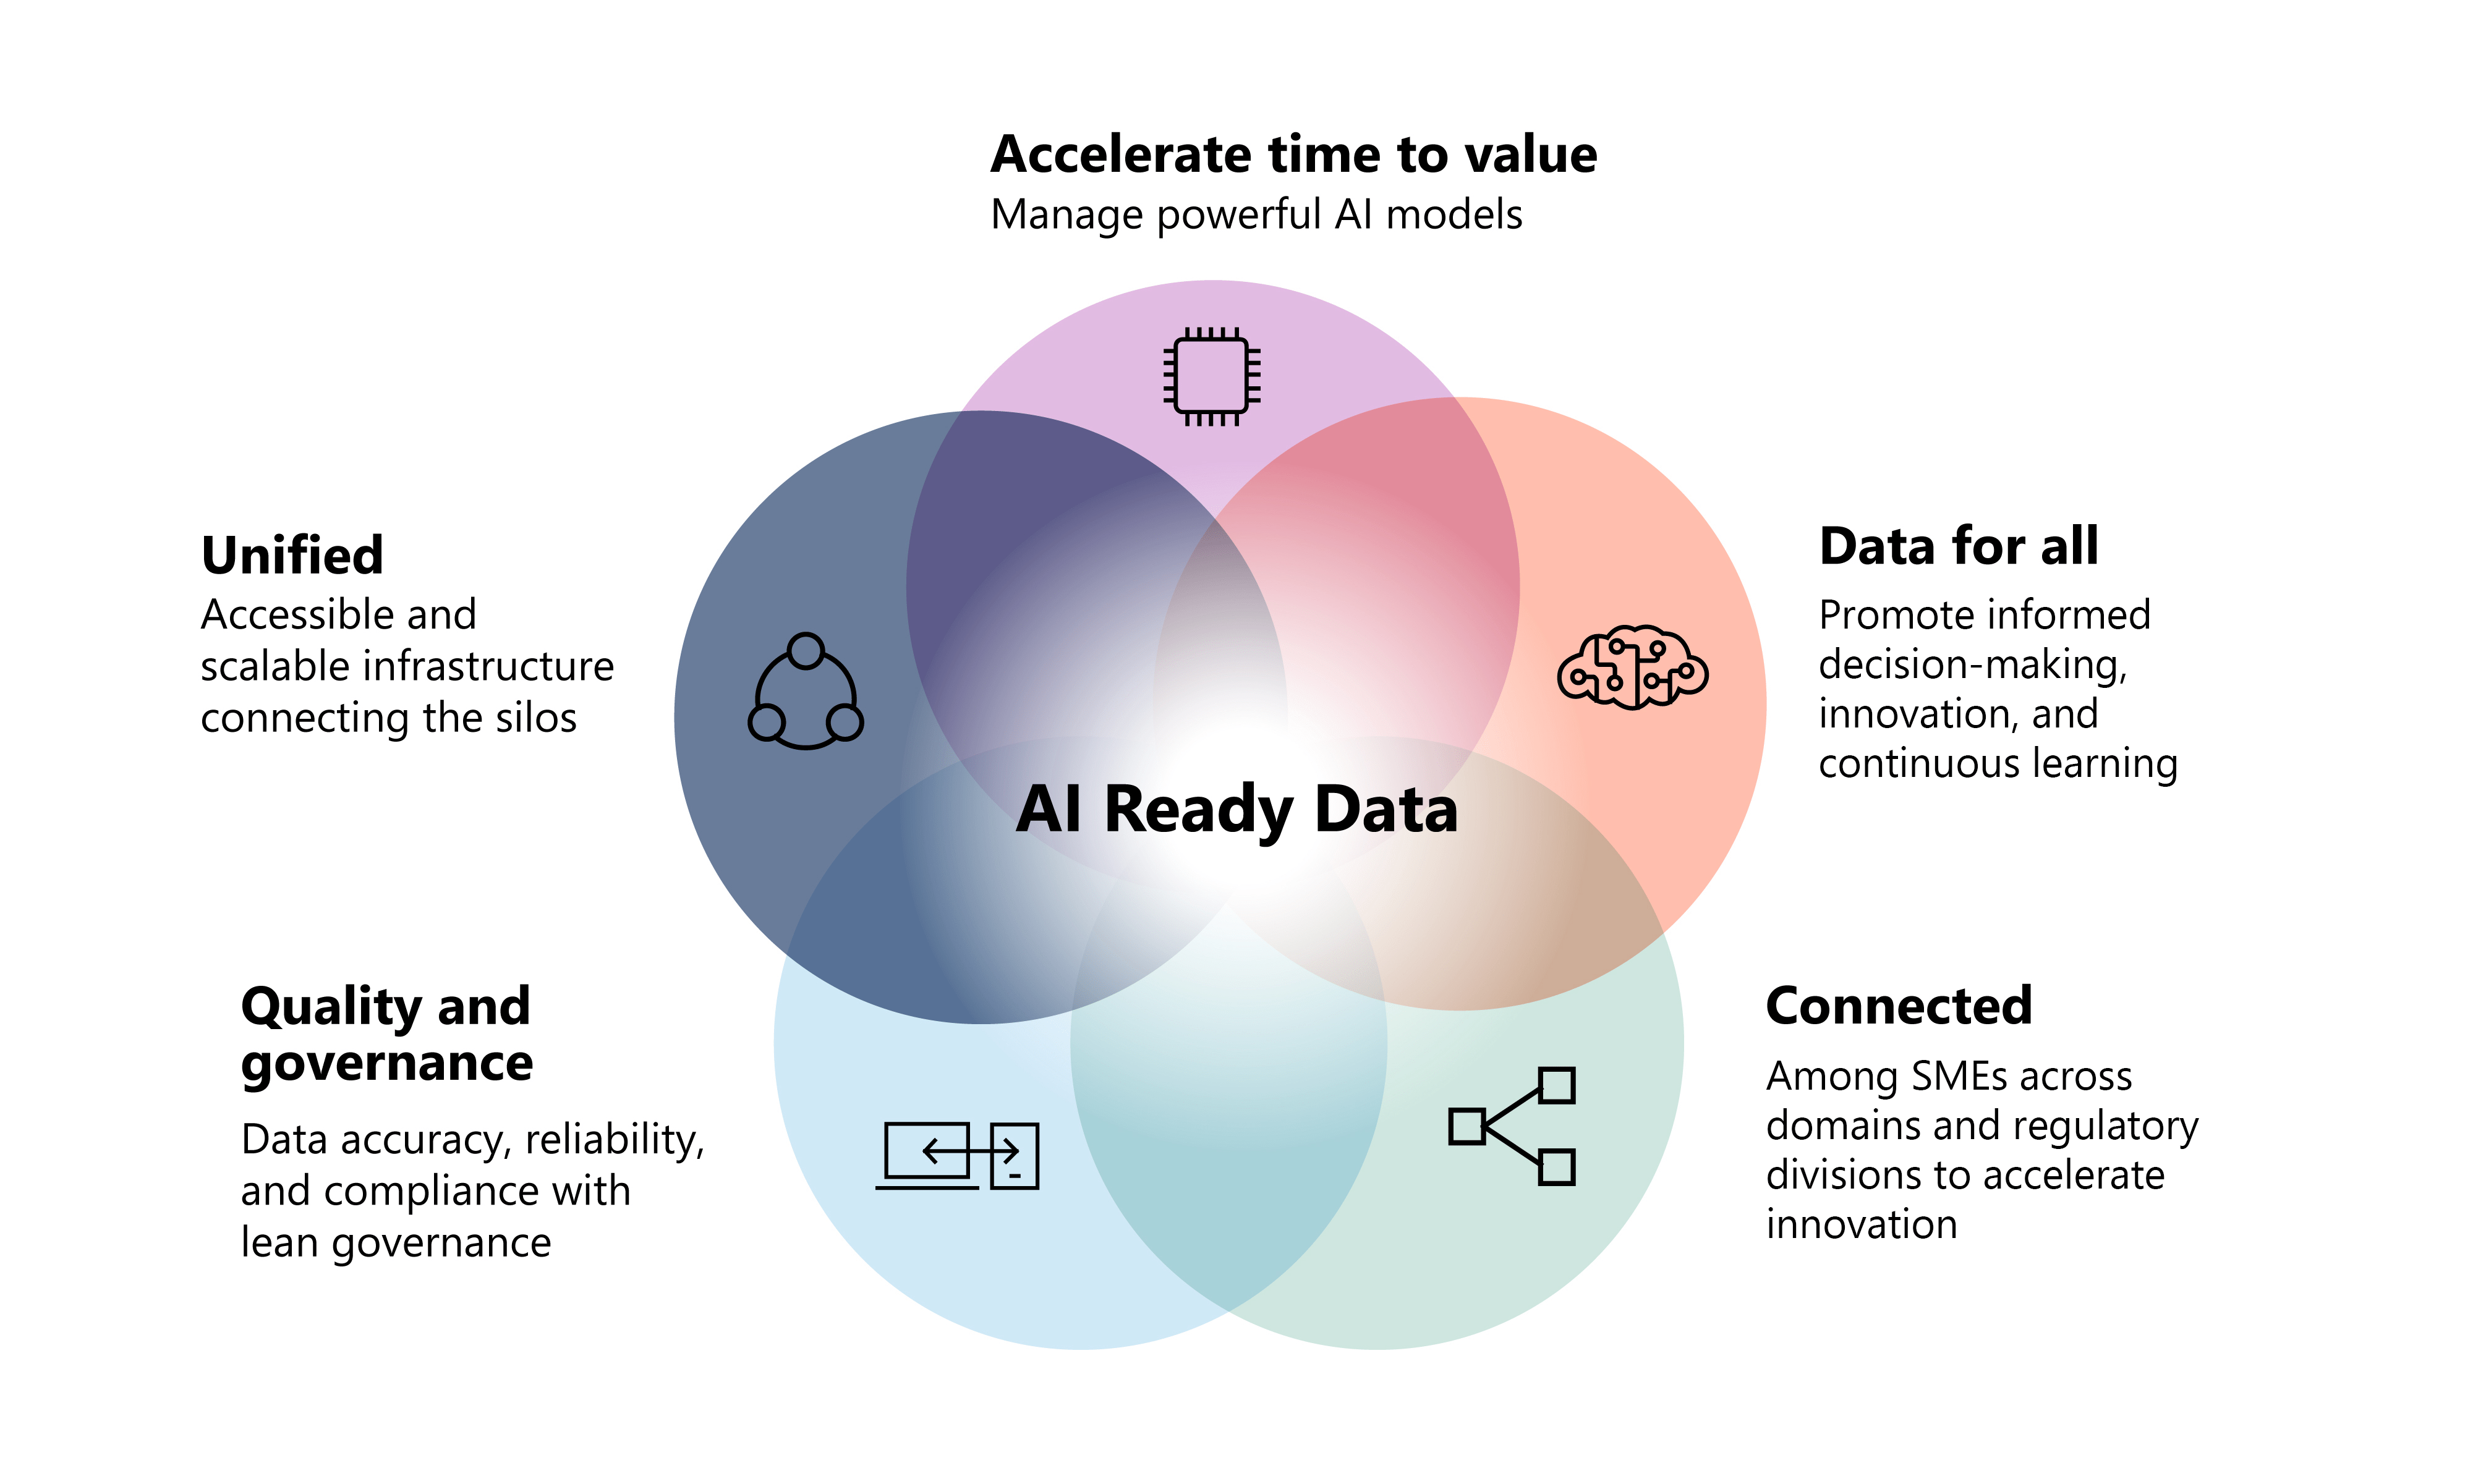
Безопасность, соответствие и операционная устойчивость
Архитектура данных для AI-ready платформ должна обеспечивать не только функциональные возможности, но и безопасность, защиту приватности и соответствие требованиям регуляторов. В сочетании mesh-lake это означает:
-
Контроль доступа на уровне доменов и Data Products: ролевой доступ, контекстуальные политики, возможность делегирования управления между доменными командами.
-
Защита приватности и конфиденциальности: применение техник минимизации данных, анонимизации и псевдонимизации, сегментация данных, чтобы ограничить доступ к чувствительным данным.
-
Аудит и прозрачность: хранение журналов доступа, изменений данных, контрактов и версий. Это важно для регуляторного контроля и внутреннего аудита.
-
Устойчивость и отказоустойчивость: репликация данных, отказоустойчивые потоки, мониторинг целей SLA и автоматические процедуры восстановления.
-
Комплаенс и соответствие: поддержка отраслевых стандартов и регуляторных требований; обеспечение соответствия локальным и международным требованиям.
-
Пример практических действий:
- настройка data contracts с автоматизированной проверкой соответствия версии;
- реализация политики доступа через центр доступа и политики ABAC/RBAC;
- внедрение мониторинга безопасности и оповещений в реальном времени;
- периодический аудит lineage и изменений в источниках данных.
Key takeaways
- Слоистость данных обеспечивает систематическую эволюцию от источников к ценности, поддерживая управляемость и воспроизводимость в рамках AI-ready платформ.
- Data lake и data mesh - не взаимоисключающие подходы: lake обеспечивает инфраструктуру хранения и обработки, mesh - ответственность за данные как продукт и контрактами между командами.
- Сочетание mesh и lake позволяет достичь скорости внедрения доменных Data Products и управляемости данных на уровне всего предприятия.
- В контексте LLM и агентных систем особенно важны векторные хранилища, семантические слои, контракты и lineage для обеспечения точности и доверия.
- Governance, качество данных и безопасность должны быть встроены в архитектуру с самого начала, включая управление версиями схем и данные о lineage.
- Инфраструктура и протоколы должны обеспечивать единый уровень совместимости: схемы, контрактные стандарты, политики доступа и мониторинг в реальном времени.
- Внедрение должно быть поэтапным: начать с ключевых доменных Data Products и расширять governance и контрактность по мере зрелости платформы.
FAQ
- Чем отличаются data mesh и data lake, и в чем их основные преимущества?
- Data lake - это крупное хранилище данных и их обработка; преимущество - масштабируемость и единая инфраструктура. Ограничение - отсутствие формальных контрактов и общей семантики между доменами. Data mesh - архитектура, где данные - это продукт, ответственность за данные лежит на доменных командах, данные публикуются через контракты и Data Products; преимущество - скорость внедрения и контекстуальная релевантность; риск - требует зрелости организационной культуры и платформенной поддержки. Для AI-ready платформ сочетание обеспечивает баланс между глобальной инфраструктурой и локальной адаптацией.
- Какие принципы управляют слоистостью данных в контексте LLM и агентов?
- Основные принципы: постепенная обработка данных отBronze до Gold, поддержка признаков и векторных представлений, единая семантика, контрактность и версионирование, обеспечение быстрого доступа к контексту для агентов и моделей, внимание к качеству и lineage на каждом уровне.
- Какие слои являются критически важными для обработки данных под LLM?
- Bronze (Raw), Silver (Clean), Gold (Curated/Features), Vector Store и Knowledge Layer. Эти слои обеспечивают последовательную подготовку данных, контекст и релевантные знания для моделей и агентов.
- Какие ключевые контракты следует внедрить между доменными командами?
- Контракты на схему данных, контракт на качество и задержку, версия признаков, SLA на доступность данных, правила обновления и миграции, а также проверки соответствия и lineage.
- Как обеспечить согласованность семантики между доменами?
- Внедрить общий словарь и онтологии, единый семантический слой, политики совместимости и централизованный реестр метаданных. Особое значение имеет семантическая согласованность для интеграции знаний в агентные сервисы и LLM.
- Какую роль играют метаданные и lineage в governance Data Products?
- Метаданные и lineage позволяют понять происхождение данных, трансформации и зависимости. Это критично для аудита, повторного использования и доверия к результатам моделей и агентов, а также для обнаружения деградаций качества.
- Какие инструменты обычно применяют для реализации данных паттернов?
- Хранилища и движки: Delta Lake, Apache Iceberg; управление схемами: Confluent Schema Registry; управление метаданными и lineage: Apache Atlas, Amundsen; orchestration и потоковая обработка: Apache Airflow, Apache Flink; векторные хранилища и знания: Weaviate, FAISS, Pinecone; обеспечение доступа и безопасность: OPA, RBAC/ABAC.
- Как внедрять governance и безопасность без торможения скорости внедрения?
- Встроить governance в платформах как сервис: стандартизировать контракты, схемы и политики; автоматизировать тестирование и валидацию данных; обеспечить прозрачность lineage и мониторинг в реальном времени; постепенно внедрять политики безопасности с учётом доменных потребностей.
- Какие риски следует учитывать при миграции к mesh+lake?
- Риск раздробления стандартов и конфликтов между доменными командами, дополнительные затраты на организацию и обучение, необходимость устойчивых процессов изменений и контроля качества данных. Управлять ими можно через поэтапный подход: начать с ключевых доменов, внедрить центральные сервисы контрактов, обеспечить совместную работу платформенной команды и бизнес-областей, а затем расширять.
- Какие ключевые шаги можно предпринять для начала внедрения в организации?
- Определить набор первого слоя Data Products и доменных владельцев; внедрить единый реестр схем и контрактов; настроить базовую инфраструктуру lake плюс mesh-поддержку; внедрить метаданные и lineage на критичных наборах данных; обеспечить базовые политики доступа и безопасности; начать пилот с несколькими сценариями использования LLM и агентных систем; потом масштабировать и разворачивать дополнительные домены и Data Products.
Эта глава суммирует принципы и практику сочетания слоистости, data mesh и data lake для обеспечения устойчивой архитектуры данных, ориентированной на LLM и агентные системы. В условиях быстрого роста требований к данным и гибкости платформы такой подход позволяет достигать баланса между централизованной инфраструктурой и локальной, бизнес-направленной эволюцией данных как продукта.


