

Архитектура StarRocks: компоненты, слои и взаимодействие
StarRocks выступает как аналитическая база данных нового поколения, ориентированная на производительную аналитику и интерактивные запросы. Архитектура этой системы построена вокруг разделения обязанностей между компонентами обработки SQL, планирования выполнения и хранения данных, а также вокруг наращиваемых слоев взаимодействия с внешними источниками данных и инструментами бизнес-аналитики. В рамках главы рассматриваются принципы модульности, слоев и протоколов взаимодействия, которые обеспечивают масштабируемость, низкую задержку выполнения запросов и гибкость интеграций.
Глубокое понимание архитектуры позволяет не только оценивать текущие слабые места и узкие места в производительности, но и проектировать грамотные решения по хранению больших массивов данных, выбору стратегий загрузки данных и настройке схем выполнения запросов для конкретных сценариев анализа.
- Основные компоненты архитектуры StarRocks: Frontend (FE), Backend (BE), каталог и координацию, планировщик и исполнительный движок, слой хранения и инжестинга.
- Слои обработки запросов и данных: от клиентского запроса до конечной выдачи результатов, включая оптимизацию, распределенную обработку и хранение на уровне планшетов/сегментов.
- Алгоритмы и протоколы: векторизованный движок, предикат-пушдоун, динамические фильтры выполнения, стратегии объединения данных и управление версиями.
- Интеграции и эксплуатационные аспекты: протоколы доступа (MySQL-совместимый, JDBC/ODBC), загрузка данных, безопасность, мониторинг и аварийное восстановление.
Компоненты архитектуры StarRocks
Компоненты образуют дефиницию границ ответственности и маршрутизации запросов между частями системы. Главные элементы включают Frontend (FE), Backend (BE), каталог состояния и координацию, исполняющую часть движка, а также механизм хранения данных и загрузки.
- Frontend (FE) - это центральный узел обработки метаданных, а также точка входа для SQL-запросов. FE отвечает за разбор, анализ и валидацию запросов, построение оптимального плана выполнения и координацию между узлами BE. Значимым является наличие каталога объектов: баз данных, таблиц, разделов и версий. FE обеспечивает контроль доступа, обеспечение согласованности схем и метаданных, а также интеграцию с инструментами мониторинга и безопасностью.
- Backend (BE) - расчётный узел, отвечающий за выполнение частей плана, чтение и запись данных, управление сегментами и планшетами (частями таблиц), обработку входящих запросов и агрегацию результатов. BE располагает вычислительную мощность и локальные хранилища, а также реализует векторизованный движок исполнения. Взаимодействие BE с FE координируется через RPC-инфраструктуру: запросы планирования, управление версиями, выполнение и отправка ответов.
- Каталог и координация (система метаданных) - дистрибуированная подсистема, сохраняющая схемы, статистику, информацию об разделах и репликации. Она обеспечивает единый взгляд на кластер и поддерживает согласованность конфигураций и параметров по всей инфраструктуре. В рамках реализации часто используются механизмы консенсуса (например, Raft) для устойчивости к сбоям и корректной координации между FE и BE.
- Планировщик и исполнительный движок - подсистема, получающая на вход логическую траекторию запроса и превращающая её в физически исполняемые шаги на кластере BE. Планировщик выбирает стратегии соединения таблиц, источников данных, способов агрегации и распределения нагрузки. Исполнительный движок реализует операторы сканирования, фильтрации, проекции, агрегации, сортировки, соединений и обмена данными между узлами.
- Слой хранения данных - организует хранение столбцовых форматов, управление сегментами (tablet/segment) и версиями строк, обеспечивает компрессию, индексацию и управление версиями (MVCC). Этот слой обеспечивает быстрый доступ к колоннам, эффективную компрессию и быструю фильтрацию данных, а также управление архивами и удаляемыми версиями.
- Инжестинг и внешние данные - поддержка загрузки данных через пакетные и потоковые режимы. В StarRocks предусмотрены механизмы загрузки из файловых систем (HDFS, S3) и потоковые входы (Kafka и аналогичные источники). Это способствует скорому попаданию данных в аналитическую среду и минимизации задержек между поступлением данных и аналитикой на их основе.
- Безопасность и управление доступом - интеграция механизмов аутентификации, авторизации, шифрования и аудита. В архитектуре выделяются роли и политики доступа к данным, что особенно важно для многоклиентской аналитики и соответствия требованиям регуляторов.
- Мониторинг и наблюдаемость - сбор метрик, логов и трассировок. Наличие интеграций с Prometheus, Grafana и подобными инструментами обеспечивает прозрачность поведения кластера, позволяет оперативно выявлять узкие места и принимать корректирующие меры.
В рамках архитектуры StarRocks подчёркнуто внимание к эффективной координации между FE и BE, чтобы минимизировать сетевые задержки и обеспечить предсказуемые времена выполнения. Важным аспектом является устойчивость к сбоям, достигаемая за счёт репликации метаданных и данных, а также возможности горизонтального масштабирования по числу узлов.
Слои и взаимодействие
Путь запроса в StarRocks начинается с клиента, который подключается через совместимый протокол, чаще всего MySQL-заработок, JDBC или ODBC. Этот уровень абстрагирует пользователя от внутренних реализаций и обеспечивает совместимость с большим количеством BI-инструментов и аналитических платформ.
- Этап разборки и анализа - FE принимает SQL, выполняет разбор, лексическую и синтаксическую проверку, затем выполняет семантику и разрешение имён. Затем FE обращается к каталогу для проверки существования объектов и их текущих схем.
- Этап планирования и оптимизации - FE строит логическую и физическую стратегию выполнения. Векторизация, статистика распределения данных, и правила оптимизации позволяют выбрать эффективный план. В этом этапе применяются предикаты пуш-даун, выбор стратегий соединения и распределение нагрузки на кластер.
- Этап исполнения - план разбивается на фрагменты, которые отправляются на BE-узлы. Каждый BE отвечает за выполнение своей части. В процессе исполнения применяется обмен данными между узлами, переработка данных локально и сбор результатов для агрегации на FE.
- Этап возврата результатов - после завершения обработки FE формирует итоговый результат и возвращает клиенту. В случае больших наборов данных результаты могут быть частично агрегированы на BE, а затем перенаправлены FE для финальной подгонки и форматирования вывода.
- Инжестинг и обновление данных - вставки и загрузка данных проходят через соответствующие сервисы FE/BE. Инструменты потоковой загрузки и пакетной загрузки используют координацию и консистентность, чтобы поддерживать согласованные версии и минимизировать конфликт между параллельными операциями загрузки и аналитическим чтением.
Реализация взаимодействий между слоями основывается на высокопроизводительных RPC-протоколах, которые обеспечивают небольшой оверхед при передаче планов, метаданных и результатов. Взаимодействие между FE и BE ведется через распределённые вызовы, которые могут включать управление версиями данных, управление транзакциями и координацию выполнения, а также передачу промежуточных результатов для агрегаций и сортировок.
Архитектура хранения данных и форматы
Хранение в StarRocks базируется на колоночном формате, который оптимизирован под аналитические нагрузки с большими объёмами сканируемых данных. Эффект достигается за счёт следующих принципов:
- Таблеты и сегменты - данные таблиц разделены на логические единицы хранения (сегменты/таблеты), что обеспечивает эффективное параллелизование и локальные операции ввода-вывода. Каждый сегмент содержит данных в колонках и метаданные о версиях и статистике.
- MVCC и версии - поддержка множественных версий строк для обеспечения согласованности чтения в условиях параллельной записью и чтения. Это позволяет реализовать чтение в консистентной точке времени и уменьшить блокировку во время выполнения запросов.
- Компрессия и индексация - колоночный подход позволяет применять эффективные схемы компрессии для уменьшения требуемого объёма хранения и ускорения сканирования. Статистики колонок (гистограммы, частоты уникальных значений) используются для оценки селективности и планирования.
- Управление версиями и очистка - периодические задачи компакции объединяют мелкие сегменты и устаревшие версии, выполняя перерасход памяти и дискового пространства за счёт удаления устаревших версий и уплотнения секций.
- Распределение данных - данные разделяются по ключам, хеш-распределение позволяет равномерно распределять нагрузку между BE-узлами и минимизировать hotspots. Репликация обеспечивает устойчивость к сбоям.
Эти принципы обеспечивают высокую пропускную способность чтения и обработки запросов. В то же время механизмы MVCC и транзакционная модель позволяют поддерживать корректность данных при параллельной работе сотен рабочих потоков и десятков запросов, выполняющихся одновременно.
Оптимизация запросов: алгоритмы и протоколы
Производительная аналитика требует сочетания грамотной оптимизации и эффективной реализации исполнителя. В StarRocks реализованы несколько ключевых подходов:
- Предикат-пушдоун и проекция - запросы сканируют только нужные столбцы и применяют фильтры как можно раньше, что сокращает объем чтения и снижает задержку. Это критично для больших фактовых таблиц со множеством измерений.
- Статистика и оптимизация по стоимости - FE собирает статистику по данным (кардинальность, распределение значений, столбцовые гистограммы) и применяет планировщик, выбирая наиболее экономный план выполнения. Этот подход снижает число операций полного сканирования и уменьшает сетевой трафик между узлами.
- Распределённые соединения и планы исполнения - для больших наборов данных применяются распределённые методы объединения: хеш-джоин, объединение по разделам, иногда локальные стратегии на узлах. Выбор зависит от размера сторон соединения и доступности памяти.
- Динамические фильтры и ранняя фильтрация - на этапе выполнения применяется динамический фильтр, который формируется во время выполнения и переносится к узлам-источникам для дальнейшей фильтрации еще до передачи больших наборов данных.
- Векторизованный движок - обработка данных идёт пакетами (векторами), что значительно повышает пропускную способность за счёт снижения накладных расходов на интерпретацию отдельных строк и лучшей локальности памяти.
- Управление памятью и спиллы - планировщик учитывает лимиты памяти и использует механизм спилл-памяти, чтобы не вызывать переполнения и не приводить к падениям выполнения больших операторов агрегации или сортировок.
- Стратегии хранения и чтения - выбор между прямым сканированием и чтением из кэша, если данные повторно запрашиваются. Это особенно полезно для повторяющихся аналитических запросов и квази-детерминированной выборки.
- Транзакционная согласованность - в контексте параллельного выполнения и вставок важна согласованность данных: механизмы MVCC обеспечивают корректное чтение незавершённых изменений и корректную видимость результатов.
Эти механизмы позволяют StarRocks достигать низкой задержки при больших объёмах данных и поддерживать высокую скорость обработки даже в условиях высокой конкурентности. Важным аспектом остаётся баланс между вычислительной нагрузкой и сетевыми операциями, что достигается через продуманное распределение задач по BE-узлам и эффективную маршрутизацию операций агрегации и соединений.
Интеграции и протоколы взаимодействия
Совместимость и интеграции являются важной частью архитектуры, обеспечивая удобство подключения к существующим пайплайнам данных и BI-инструментам. В StarRocks применяется несколько уровней взаимодействия:
- Протокол доступа - чаще всего StarRocks предоставляет MySQL-совместимый сетевой протокол, что упрощает подключение к BI-инструментам и средам разработки без необходимости перехода на новые клиентские библиотеки. Поддержка JDBC/ODBC обеспечивает широкие возможности интеграции.
- Взаимодействие между компонентами - FE и BE общаются через высокопроизводительные RPC-каналы. Протоколы передачи планов выполнения, метаданных и результатов оптимизированы с учётом задержек и пропускной способности сети. В реальных кластерах часто применяются передовые RPC-библиотеки, ориентированные на низкую латентность и эффективную сериализацию.
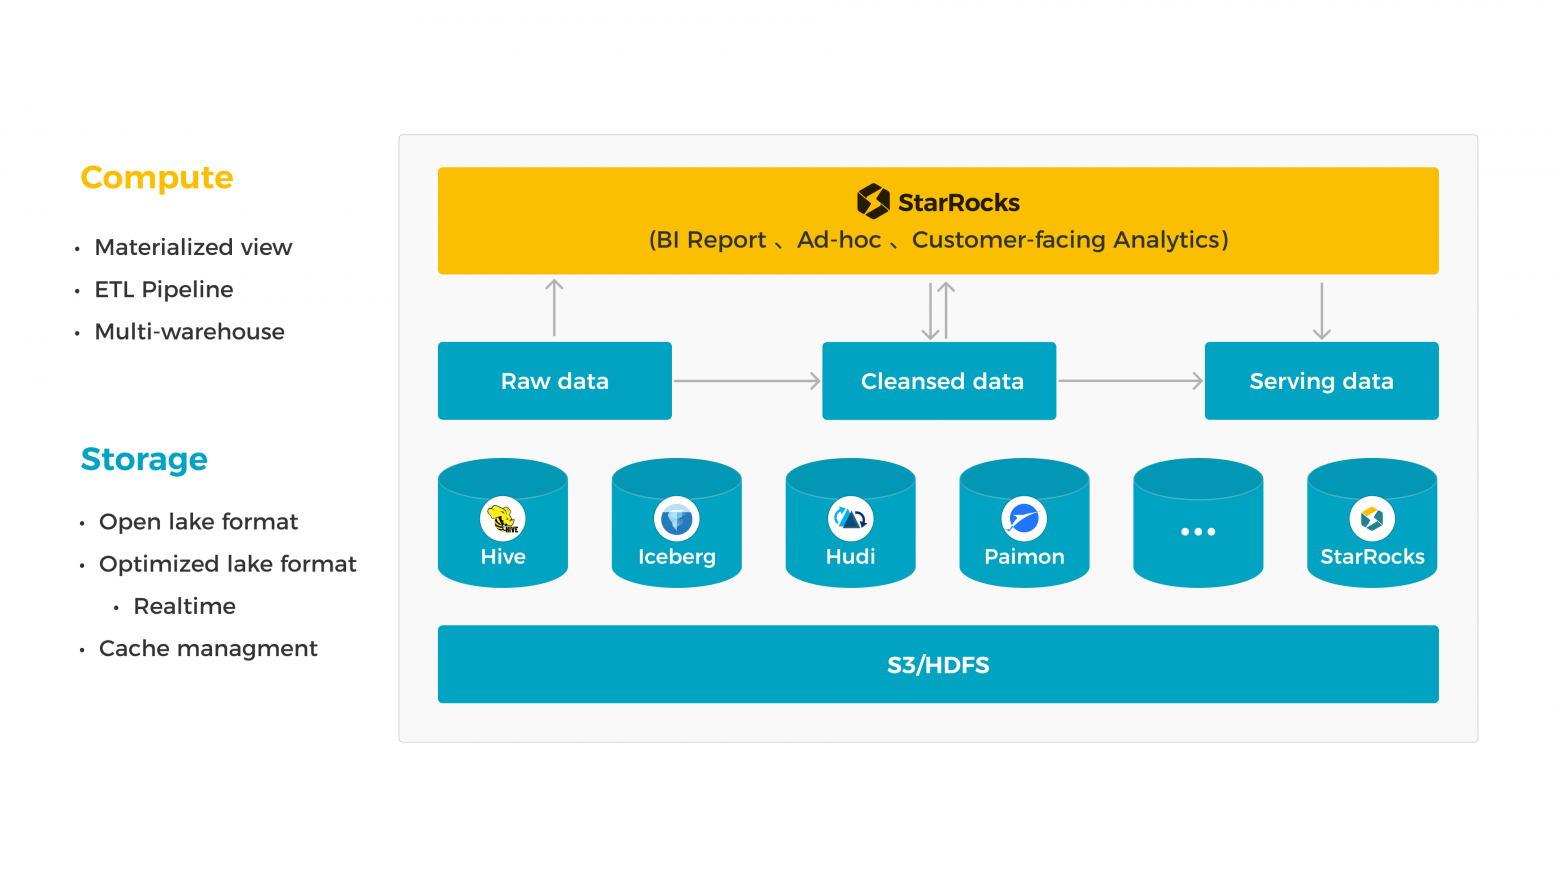
- Интеграции с источниками данных - загрузка данных осуществляется через пакетную загрузку или потоковую загрузку из внешних источников (HDFS, S3, локальные файловые системы). Это позволяет строить конвейеры данных, охватывающие источники и целевые аналитические хранилища.
- Инструменты загрузки и обработки потоков - поддержка потоковой загрузки через Kafka или подобные конвейеры обеспечивает минимальные задержки между поступлением данных и их доступностью для анализа. Протоколы и коннекторы ускоряют построение реального времени и накопление данных.
- Безопасность и аудит - передача данных в зашифрованном виде (TLS), а также управление ролями и доступом. Аудит операций и соответствие требованиям инфраструктурной безопасности обеспечивают надёжность эксплуатации.
- Экосистема инструментов - StarRocks интегрируется с BI/ETL-платформами через стандартные коннекторы и интерфейсы, позволяя аналитикам работать с привычными инструментами без адаптации.
Интеграционные решения должны подбирать баланс между совместимостью и специфическими требованиями конкретного проекта: объем данных, скорость загрузки, требования к доступности, требования к соответствию регламентам и региональные особенности.
Инфраструктура и эксплуатационные практики
Эффективная эксплуатация архитектуры требует ясной политики развертывания, мониторинга и обновления:
- Развертывание и масштабирование - горизонтальное масштабирование по BE-узлам и по FE-узлам с учётом потребностей анализа и загрузок. Автоматизированные пайплайны развёртывания позволяют минимизировать время простоя и ускорить обновления.
- Высокая доступность - механизмы отказоустойчивости, репликации и выбора лидера. В случае сбоя узла кластер продолжает работу с минимальными задержками, а данные остаются доступными благодаря резервированию по данным и метаданным.
- Эксплуатация и мониторинг - внедряются мониторинг-системы (prometheus/grafana или аналоги) для отслеживания задержек выполнения, использования памяти, нагрузки на сеть и потребления дискода. Включается трассировка запросов и сбор профилей исполнения для анализа узких мест.
- Бэкап и восстановление - регулярно создаются снимки состояния метаданных и данных. В случае сбоев предусмотрены планы восстановления и миграции версий.
- Конфигурации и оптимизация - параметры кластера (лимиты памяти, параллелизм загрузки, размеры батчей для сканирования) настраиваются под характер нагрузок. Лучшие практики включают тестирование на небольших нагрузках и постепенное наращивание размеров кластера.
- Безопасность и соответствие - регулярные обновления зависимостей, управление ключами, аудит доступа, а также тестирование политик шифрования и безопасности сетевых соединений.
Эти практики подталкивают к принятию управляемых решений по архитектуре, позволяя организации достигать требуемого уровня производительности при контролируемом риске и предсказуемых издержках.
Key takeaways
- Архитектура StarRocks основана на чётком разделении ролей между FE и BE, поддержке дистрибуции и консистентности метаданных через распределённый каталог.
- Эффективная обработка запросов достигается за счёт векторизованного исполнителя, предикат-пушдоун, динамических фильтров и распределённых стратегий соединений.
- Хранение данных реализуется через колоночный формат, MVCC, сегменты/таблеты и компрессию с учётом статистики колоночных значений.
- Интеграции через MySQL-совместимый протокол и коннекторы JDBC/ODBC обеспечивают широкую совместимость с BI-инструментами и внешними источниками данных.
- Надёжная эксплуатация зависит от мониторинга, резервирования, политики безопасности и продуманных стратегий загрузки данных и обновления кластера.
- Правильный баланс между хранением, вычислениями и сетью критически важен для минимизации задержек и обеспечения предсказуемой производительности на больших объёмах данных.
- Постоянный сбор статистики и профилирование запросов позволяет выявлять узкие места и адаптировать планы выполнения в реальном времени.
FAQ
- Какие основные различия между FE и BE в StarRocks?
FE отвечает за обработку метаданных, анализ и планирование запросов, управление схемами и безопасностью, а также координацию между узлами. BE выполняет абстракцию исполнения и доступ к данным, читает сегменты, обрабатывает вычисления и отправляет результаты обратно FE. Такое разделение позволяет масштабировать ввод-вывод и вычисления независимо, повышая гибкость в кластерах большой размерности.
- Как StarRocks обеспечивает консистентность данных в условиях параллельной нагрузки?
Система применяет MVCC-методы, версии строк и контроль над временем видимости изменений. Запросы видят согласованные результаты благодаря версионности и корректной координации между FE и BE. В случае параллельной вставки режимы блокировок минимизируются, потому что читаются версионированные данные, а старые версии управляются через компакцию и удаление устаревших записей.
- Какие протоколы используются для взаимодействия клиента и кластера?
Клиентская часть обычно подключается через MySQL-совместимый протокол, что обеспечивает совместимость с большим количеством клиентов и BI-инструментов. Взаимодействие между FE и BE строится на высокопроизводительных RPC-протоколах. Это сочетание упрощает интеграцию и обеспечивает низкую задержку передачи планов выполнения и результатов.
- Какие стратегии оптимизации особенно важны для аналитических запросов в StarRocks?
Ключевые стратегии включают предикат-пушдоун и колоночную проекцию, сбор статистики и применение модели стоимостьной оптимизации, использование векторизированного исполнения, динамических фильтров и эффективных стратегий соединения. Эти подходы позволяют быстро извлекать точечные и агрегатные результаты из больших наборов данных.
- Как осуществляется загрузка данных в StarRocks?
Загрузка поддерживает пакетные режимы (LOAD DATA) и потоковые режимы через внешние источники (HDFS, S3) и потоковые конвейеры (например, Kafka). Интеграция с источниками данных осуществляется через брокерские и конвейерные механизмы, позволяющие минимизировать задержку между поступлением данных и их доступностью для анализа.
- Какие способы хранения данных применяются в StarRocks и зачем?
Колоночный формат обеспечивает эффективную компрессию и быстрый доступ к нужным столбцам. Таблеты/сегменты разделяют данные для параллельной обработки. MVCC позволяет безопасно читать данные во время параллельных обновлений. Все это обеспечивает высокую производительность сканирования и гибкость управления версиями.
- Что важно учесть при проектировании инфраструктуры StarRocks в организации?
Важны выбор архитектуры (- prem vs облако), стратегия масштабирования и балансировка вычислений и хранения, планирование отказоустойчивости, настройка параметров для конкретных нагрузок и обеспечение достаточного мониторинга. Регулярное тестирование под реальные сценарии и детальная профилировка запросов позволяют поддерживать требуемые SLA и стабильность кластера.
- Какие типичные узкие места возникают в архитектуре StarRocks и как их избегать?
Узкие места встречаются в случаях неэффективной статистики, неправильной размещения данных и нехватки памяти на BE. Эффективное устранение включает обновление статистики, перераспределение ключей, настройку параметров памяти и оптимизацию планов выполнения. Регулярный мониторинг и аудит планов позволяют заранее выявлять проблемные участки.
- Какие роли играют внешние интеграции в аналитике StarRocks?
Интеграции обеспечивают доступ к данным и удобство анализа: подключение BI-инструментов через JDBC/ODBC и MySQL-подобный протокол, потоковые источники для своевременной аналитики в реальном времени и конвейеры загрузки для поддержки пайплайнов обработки данных.
- Какова роль транзакционной поддержки в такой архитектуре?
Транзакционная поддержка обеспечивает согласованность и целостность данных при параллельной загрузке и чтении. MVCC и контроль версий позволяют выполнять чтение и запись без сильной блокировки, поддерживая аналитические нагрузки и многопользовательскую работу в рамках одного кластера.


