

Влияние памяти на производительность: задержки, пропускная способность и throughput
Память выступает критическим ресурсом в распределенной среде Trino. Её объём и организация использования напрямую влияют на задержки выполнения операций, пропускную способность и общую способность сервиса обслуживать одновременные запросы. Эффективное управление памятью требует согласования архитектурных решений, поведения кэширования и ограничений, задаваемых cost-based optimizer (CBO). В рамках данной главы рассмотрены механизмы учета памяти, влияние памяти на планирование и исполнение запросов, а также практические подходы к конфигурации и мониторингу для повышения throughput.
Память в Trino распределяется между узлами и операторами выполнения. На каждом узле запускается JVM-сервис с выделенной памяти под выполнение рабочих потоков, а также под хранение временных структур операторов (например, хеш-таблиц, сортировочных буферов и промежуточных агрегаций). Взаимодействие между уровнями памяти, кэширования и spill-обработкой создает баланс между задержкой выполнения и размером данных, которые можно обработать без обращения к внешним данным. При разработке решений по оптимизации производительности следует учитывать не только архитектурно-правильную настройку памяти, но и сценарии, когда ограничение памяти приводит к изменению выбора плана и метода исполнения.
- В этой главе мы соединяем архитектурную часть памяти и практику применения в рамках оптимизации Trino: как память влияет на задержку и throughput, как кэширование смещает узлы и запросы, и какие процессы внедрения требуют изменений в процессах планирования и эксплуатации.
Краткое содержание главы
- Архитектура памяти в Trino: учет памяти, управление пулами и влияние на задержку.
- Влияние памяти на выбор плана и исполнение: как бюджеты памяти формируют решения по методам соединения и агрегации.
- Роль кэширования в производительности: OS-кэш, кэш на уровне коннекторов и результаты кеширования запросов.
- Практические настройки и интеграция с cost-based optimizer: бюджет памяти, spill, revocation и влияние на планирование.
- Мониторинг и диагностика памяти: метрики, инструменты и процесс улучшения конфигурации.
Архитектура памяти и её влияние на задержки
Архитектура памяти в Trino опирается на разделение бюджета памяти между узлами и между операторами выполнения внутри каждого запроса. На стороне исполнителя используются два основных слоя памяти: управляемая память JVM и off-heap память, которая чаще применяется для минимизации влияния GC на задержку. Управляемая память чаще подвержена задержкам из-за сборки мусора, тогда как off-heap участок уменьшает частоту и длительность GC-циклов для больших рабочих наборов.
В рамках Trino ключевые концепции включают:
- Memory pools и MemoryManager: каждый запрос получает квоту памяти, распределяемую между операторными деревьями. Эффективная конфигурация должна учитывать пики потребления памяти внутри отдельных операторов, таких как HashJoin, HashAggregate, Sort и другие.
- Перераспределение памяти (memory revocation): при росте конкуренции за ресурсы система может отзывать память у менее приоритетных задач и, при отсутствии альтернатив, прерывать выполнение запросов. Этот механизм обеспечивает честную эксплуатацию кластера и предотвращает «замыкание» узла из-за одного ресурсоемкого запроса.
- OS и page cache: операционная система кэширует данные файловой системы, что может снижать задержку доступа к источникам данных (HDFS, S3 и пр.). Взаимодействие между JVM-буферами, off-heap памятью и page cache определяет характер задержек на этапах чтения и обработки больших объемов данных.
Подсистемы и их взаимодействие
- Учет памяти: каждый оператор получает квоту памяти и агрегирует её под свои нужды. В рамках Execution Engine распределение памяти ориентировано на максимизацию параллелизма и минимизацию задержек по каждому узлу.
- Управление памятью во времени выполнения: память выделяется и освобождается по мере продвижения выполнения. При превышении порогов включается spill на диск и перераспределение ресурсов между задачами, что влияет на latency и throughput отдельных этапов выполнения.
- Off-heap vs on-heap: отключение сторонней сборки мусора за счет off-heap-режима может значительно снизить латентность долгих рабочих нагрузок, но требует аккуратного контроля за безопасностью и корректной очисткой памяти.
Роль spill и внешней памяти
Когда объем обрабатываемых данных превышает доступную память, Trino прибегает к spill в временное хранилище на диске. Это особенно критично для операций с большими хеш-таблицами, больших агрегаций и сортировок. Spill значительно увеличивает задержку, так как данные нужно перемещать между памятью и диском, а также может привести к дополнительной I/O-накладке. Однако spill позволяет обрабатывать запросы больших размеров без кардинального увеличения памяти в кластере, что влияет на throughput в пике.
Для оптимизации подобных ситуаций важно понимать компромисс между памятью и disk I/O: достаточный запас памяти снижает латентность отдельных операторов, однако требует большего объема ресурсов на каждом узле. В контексте CBO именно распределение памяти между альтернативными планами может менять выбор между HashJoin, NestedLoop, Sort-merge и Broadcast-join.
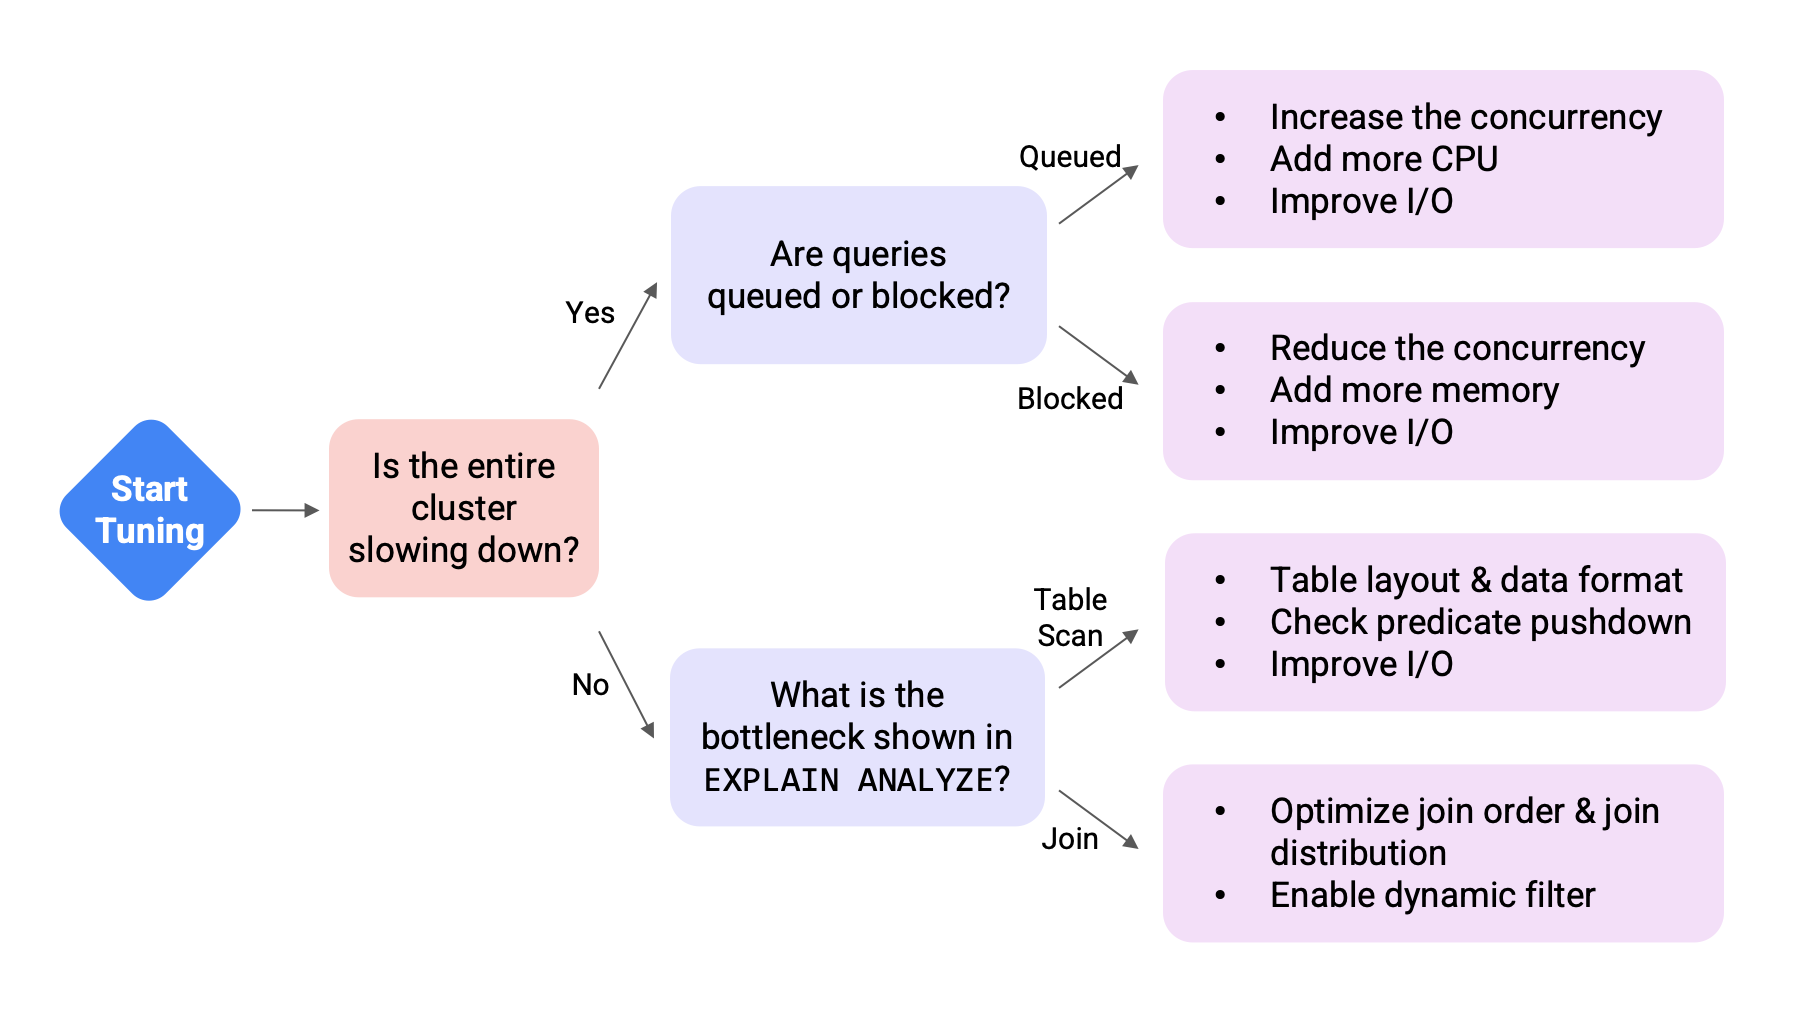
Влияние памяти на выбор плана и исполнение
Cost-based optimizer учитывает статистику и вероятность дешевизны тех или иных стратегий исполнения. Однако реальная стоимость исполнения не ограничивается только CPU и сетевыми затратами: она напрямую зависит от того, сколько памяти доступно для выполнения того или иного оператора. В условиях ограниченной памяти план может выглядеть одним образом, но при изменении бюджета памяти - другим.
- Алгоритмы соединения: Hash Join требует значимого объема памяти для построения хеш-таблиц. В условиях ограниченной памяти может быть предпочтительным использование Sort-M merge или Nested Loop с ограниченной областью переподборки, что меняет задержку и пропускную способность. В некоторых сценариях CBO может предложить адаптивное переключение между стратегиями в процессе выполнения.
- Агрегация и сортировка: агрегации требуют буферов для сохранения промежуточных результатов; сортировка - дополнительной памяти под буферы и ступени слияния. При нехватке памяти система может перераспределить работу через spill, что заметно увеличивает латентность, но позволяет сохранить проход через данные без перепланирования.
- Распределённая обработка и параллелизм: бюджеты памяти на узел ограничивают степень параллелизма, который можно применить к конкретному оператору. В результате план может включать больше фаз материализации данных или дополнительную переработку, что влияет как на задержку, так и на throughput.
Практически это означает: при проектировании архитектуры и настройке параметров следует рассматривать не только статистическую оценку стоимости плана, но и реальные ограничения памяти на уровне узла. В контексте CBO важно регулярно тестировать планы под нагрузкой с различными профилями памяти и учитывать влияние spill и перепланировок на latency distribution и общий throughput.
Роль кэширования в производительности
Кэширование выступает одним из самых эффективных инструментов снижения задержки и увеличения throughput, но требует аккуратного подхода к управлению и координации между уровнями.
- OS-кэш: файловая система и системный кеш операционной системы могут существенно ускорить повторные обращения к данным без повторной загрузки из источников. Хорошее попадание данных в кеш снижает latency на чтении и уменьшает нагрузку на сеть и хранилище.
- Кэш коннекторов: некоторые коннекторы поддерживают локальные или централизованные кэши схем доступа к данным. Это существенно сокращает повторные операции чтения с внешних источников и ускоряет повторные запросы.
- Результатное кеширование (result cache): при повторных запросах можно возвращать результаты из кеша, минуя повторное вычисление частей плана. Этот подход особенно эффективен для часто повторяющихся запросов или константных подчастей запросов. В рамках экосистемы Trino данная функциональность может быть реализована как опциональная возможность в некоторых версиях и плагинах, включая интеграцию с Iceberg и подобными системами.
- Кэш-фреймворки и Iceberg: современные коннекторы и обработчики данных часто включают локальные кэши метаданных файлов и данных. Например, кэширование файловой метадстановки и метаданных Iceberg может существенно ускорить сканирование больших таблиц и уменьшить задержку доступа к поверхностному уровню данных.
Важно помнить, что кеширование - это баланс между скоростью доступа и валидностью данных. Неправильно настроенный кеш может вернуть устаревшие результаты или повлечь за собой перерасчеты в сторону более частых обращений к источнику данных. Поэтому кэширование следует сочетать с корректнойInvalidation-политикой и мониторингом hit-rate, размером кеша и временем жизни записей.
Настройка памяти и интеграция с cost-based optimizer
Настройка памяти - это не простая подстановка чисел. Влияние на планирование и исполнение тесно связано с поведением CBO, который использует статистику и бюджеты памяти для выбора наиболее вероятно эффективного плана. Ряд практических принципов следует учитывать:
- Бюджеты памяти: конфигурация параметров query.max-memory и query.max-memory-per-node определяет верхнюю границу памяти, доступной для выполнения запроса и каждого узла. Эффективная настройка требует анализа типичных нагрузок: одновременно выполняемые длинные агрегации, хеш-обработки и сортировки.
- Spill и перераспределение памяти: включение spill позволяет обрабатывать большие объемы данных, но добавляет дополнительную задержку. В сценариях с ограниченной памятью spill может быть приемлемым компромиссом для сохранения throughput, особенно когда количество параллельно выполняемых запросов велико.
- Динамическое планирование и адаптивность CBO: современные версии CBO поддерживают адаптацию плана в ходе выполнения на основе фактического поведения. Это особенно полезно в сценариях, когда первоначальные предположения об объёме памяти оказались неверны или распределение памяти между операторами изменилось во времени выполнения.
- Архитектурные ограничения и интерфейсы: при внедрении в существующую инфраструктуру следует учитывать ориентиры по доступному объему памяти на отдельных узлах, а также совместимость с существующими коннекторами и их настройками кэширования и spill.
Практические настройки памяти можно свести к нескольким базовым рекомендациям:
- Задайте размеры памяти таким образом, чтобы часто встречающиеся операции не нуждались в spill для основного объема рабочих нагрузок. Это обеспечит более низкие задержки и более предсказуемый throughput.
- Включайте spill только там, где память ограничена и реальные сценарии требуют продолжения выполнения, чтобы избежать накладок на I/O в случае высокой конкуренции за ресурсы.
- Включайте мониторинг по памяти и проверьте влияние на планирование CBO на тестовых данных под типичные профили нагрузки.
## Пример конфигурации памяти в config.properties (условные значения)
query.max-memory=16GB
query.max-memory-per-node=4GB
query.max-total-memory-per-node=8GB
memory-revocation-enabled=true
spill-enabled=true
Данные настройки являются отправной точкой. В реальных условиях требуется адаптация под специфику workload: размер таблиц, частота повторных обращений к данным, характер источников и уровень параллелизма. Взаимодействие настроек памяти с CBO требует регулярного тестирования на репрезентативных сценариях, чтобы убедиться, что выбор плана стабилен и соответствует реальным ресурсам.
Мониторинг, диагностика и инструменты
Упрощение диагностики проблем памяти требует комплексного набора метрик и инструментов:
- Метрики памяти запроса: резервация памяти на уровне запроса, фактическое потребление, пик памяти, количество spill-операций, размер spill-файлов.
- Метрики по узлу: общее занятие памяти, доступная память, регистрируемые события revocation и частота прерываний выполнения запросов.
- Метрики по оператору: пиковая память, используемая конкретными операторами (HashJoin, Sort, GroupBy), чтобы локализовать точки перегрузки.
- Взаимодействие с системой мониторинга: Prometheus/Grafana или другие платформы мониторинга, которые позволяют строить дашборды по памяти, latency, throughput иspill-показателям.
- Тестовые профили и нагрузочные тесты: выполнение тестов под имитацией реальных сценариев с различной степенью параллелизма и объема данных, чтобы увидеть, как изменения в памяти влияют на планирование CBO и итоговую производительность.
Рекомендованы следующие практики:
- Регулярная проверка hit-rate кэширования и доли повторного чтения данных через OS-кэш.
- Анализ распределения задержек по фазам выполнения: чтение данных, сборка, агрегация и сортировка.
- Мониторинг количества прерываний по памяти и их влияние на задержку отдельных этапов выполнения.
- Временная изоляция изменений параметров памяти на тестовом окружении перед внедрением в продакшн.
Практические сценарии внедрения
- Сценарий а: большая аналитическая нагрузка с повторяемыми запросами к большим таблицам. Эффект от настройки memory-профиля и spill минимален, если кэширование данных и repetition-часть запроса эффективны. В этом случае CBO может выбрать планы, оптимизирующие повторные чтения и использующие локальные кэши.
- Сценарий b: много одновременных запросов, каждый из которых имеет умеренный объем данных. В этом случае правильная настройкаMemory и revocation может обеспечить более равномерный throughput и предотвратить перегрузку узла. Spill может быть включен как запасной механизм.
- Сценарий c: редкие длинные запросы, где задержка критична. Эффективное управление memory и off-heap режим может снизить влияние GC и уменьшить latency, но требует тщательного мониторинга и тестирования на реальных данных.
- Сценарий d: коннекторы с поддержкой кэша метаданных. Включение кеширования может существенно ускорить сканирование таблиц Iceberg или аналогичных структур, но необходимо следить за согласованностью данных и правилами инвалидации кеша.
Комбинация архитектурной настройки памяти, выборов плана через CBO и разумного кэширования позволяет значительно повысить throughput и снизить задержки при типичных сценариях эксплуатации Trino. Однако нереалистичные ожидания от кеша и чрезмерной памяти могут привести к снижению эффективности использования кластера. Важно поддерживать дисциплину тестирования, мониторинга и коррекции параметров.
Key takeaways
- Память на каждом узле и в каждом операторе критически влияет на задержки и throughput; правильное балансирование снижает задержку и повышает пропускную способность.
- Spill на диск - необходимый механизм для обработки больших нагрузок, но он неизбежно добавляет задержку; целесообразность spill зависит от профиля нагрузки и доступного капитала памяти.
- Планирование на основе CBO базируется на предположениях о памяти; реальная доступность памяти может привести к перераспределению плана во время выполнения.
- Кэширование на разных уровнях (OS-кэш, коннекторный кеш, кеш результатов) может значительно снизить latency, но требует четких правил инвалидации и согласованности данных.
- Эффективная настройка памяти требует синергии между конфигурацией параметров, мониторингом реального поведения запросов и тестированием под нагрузкой.
- Мониторинг памяти должен включать не только использование буферов, но и показатели spill, ревокаций памяти и задержек по фазам выполнения.
- Внедрение оптимизаций по памяти должно сопровождаться проверкой влияния на планирование CBO и длительных сценариев, чтобы избежать неожиданных регрессий.
FAQ
- Что такое memory revocation и как она работает в Trino?
- Memory revocation - механизм принудительного освобождения памяти у выполняющихся задач в условиях нехватки ресурсов. Он позволяет сохранить QoS на уровне кластера, но может привести к прерыванию отдельных потоков или перераспределению ресурсов между запросами. Включение revocation требует ясных правил приоритетов и мониторинга, чтобы минимизировать негативные эффекты на latency выполняемых запросов.
- Как определить оптимальный memory budget для узла?
- Оптимальный бюджет зависит от объема данных, типов операций (HashJoin, Sort, Aggregation), степени параллелизма и доступности физической памяти. Рекомендуется тестировать под реальными профилями нагрузки: начинайте с умеренного бюджета и постепенно увеличивайте, наблюдая за latency и spill-частотой. Важной метрикой является баланс между снижением задержки и ростом I/O из-за spill.
- Какие сигналы указывают на необходимость spill?
- Частые случаи превышения memory-порога на отдельных операторов, увеличение количества прерываний по памяти и стойкое увеличение задержки на фазе обработки чтения/постобработки. Если задержка растет без видимого прироста CPU, вероятно, потребуется spill или перераспределение памяти.
- Как CBO учитывает память при выборе плана?
- CBO использует статистику и бюджеты памяти как входные параметры для оценки стоимости разных планов. Однако фактическая доступность памяти может различаться в ходе выполнения. Поэтому хорошо работает адаптивное планирование, которое может менять стратегии на основе реального поведения запросов.
- Какие инструменты полезны для мониторинга памяти в Trino?
- Метрики памяти запроса, узла и операторов; частота spill-операций; задержки по фазам выполнения; мониторинг hit-rate кеша и согласованности кеша; использование Prometheus/Grafana или аналогичных систем для построения дашбордов.
- Как память влияет на выбор метода соединения в плане?
- Hash Join требует значительного объема памяти для построения хеш-таблиц; при ограничениях памяти может менее выгодно применяться Sort-merge или Nested Loop. CBO может предлагать альтернативные планы, когда бюджеты памяти не позволяют эффективное использование хеш-структур.
- Какие практики можно применить для агрегаций и сортировок under memory pressure?
- Оптимизация размера промежуточных буферов, включение spill для крупных агрегаций и сортировок, использовать off-heap-механизмы, чтобы снизить влияние GC и ускорить выполнение. В некоторых случаях стоит рассмотреть агрегацию по частям и последующее слияние.
- Что делать, если кеш не попадает в кеш (miss) часто?
- Оценить размер кеша, частоту инвалидации и стратегию обновления. Увеличение размера кеша может помочь, но неизбежно потребует дополнительных ресурсов. Важно понять, какие запросы повторяются и каковы их паттерны доступа к данным.
- Насколько критично в рамках производственной среды сочетать памяти и кэширование?
- Очень критично. Плохая настройка кэша может привести к устаревшим данным и неверным результатам или ухудшению производительности при повторных обработках. Необходимо явно определить правила валидности и инвалидации кеша.
- Какие ошибки встречаются чаще всего при настройке памяти в Trino?
- Чрезмерное увеличение memory-бюджета без учета реального профиля нагрузки; игнорирование spill и последующая нехватка ресурсов на пике; отсутствие мониторинга и тестирования под нагрузкой; неправильное сочетание off-heap и on-heap режимов; неподходящие конфигурации для конкретного коннектора и источника данных.
Глава предлагаемая здесь конструктивно соединяет архитектурный уровень памяти, механизмы кэширования и влияние на планирование в рамках cost-based optimizer. В итоге достигается более предсказуемый latency, стабильный throughput и оптимизированное использование инфраструктуры при разнообразных профилях запросов и источников данных.


