

Модели данных: dimensional, data vault, anchor modeling и схемы согласования
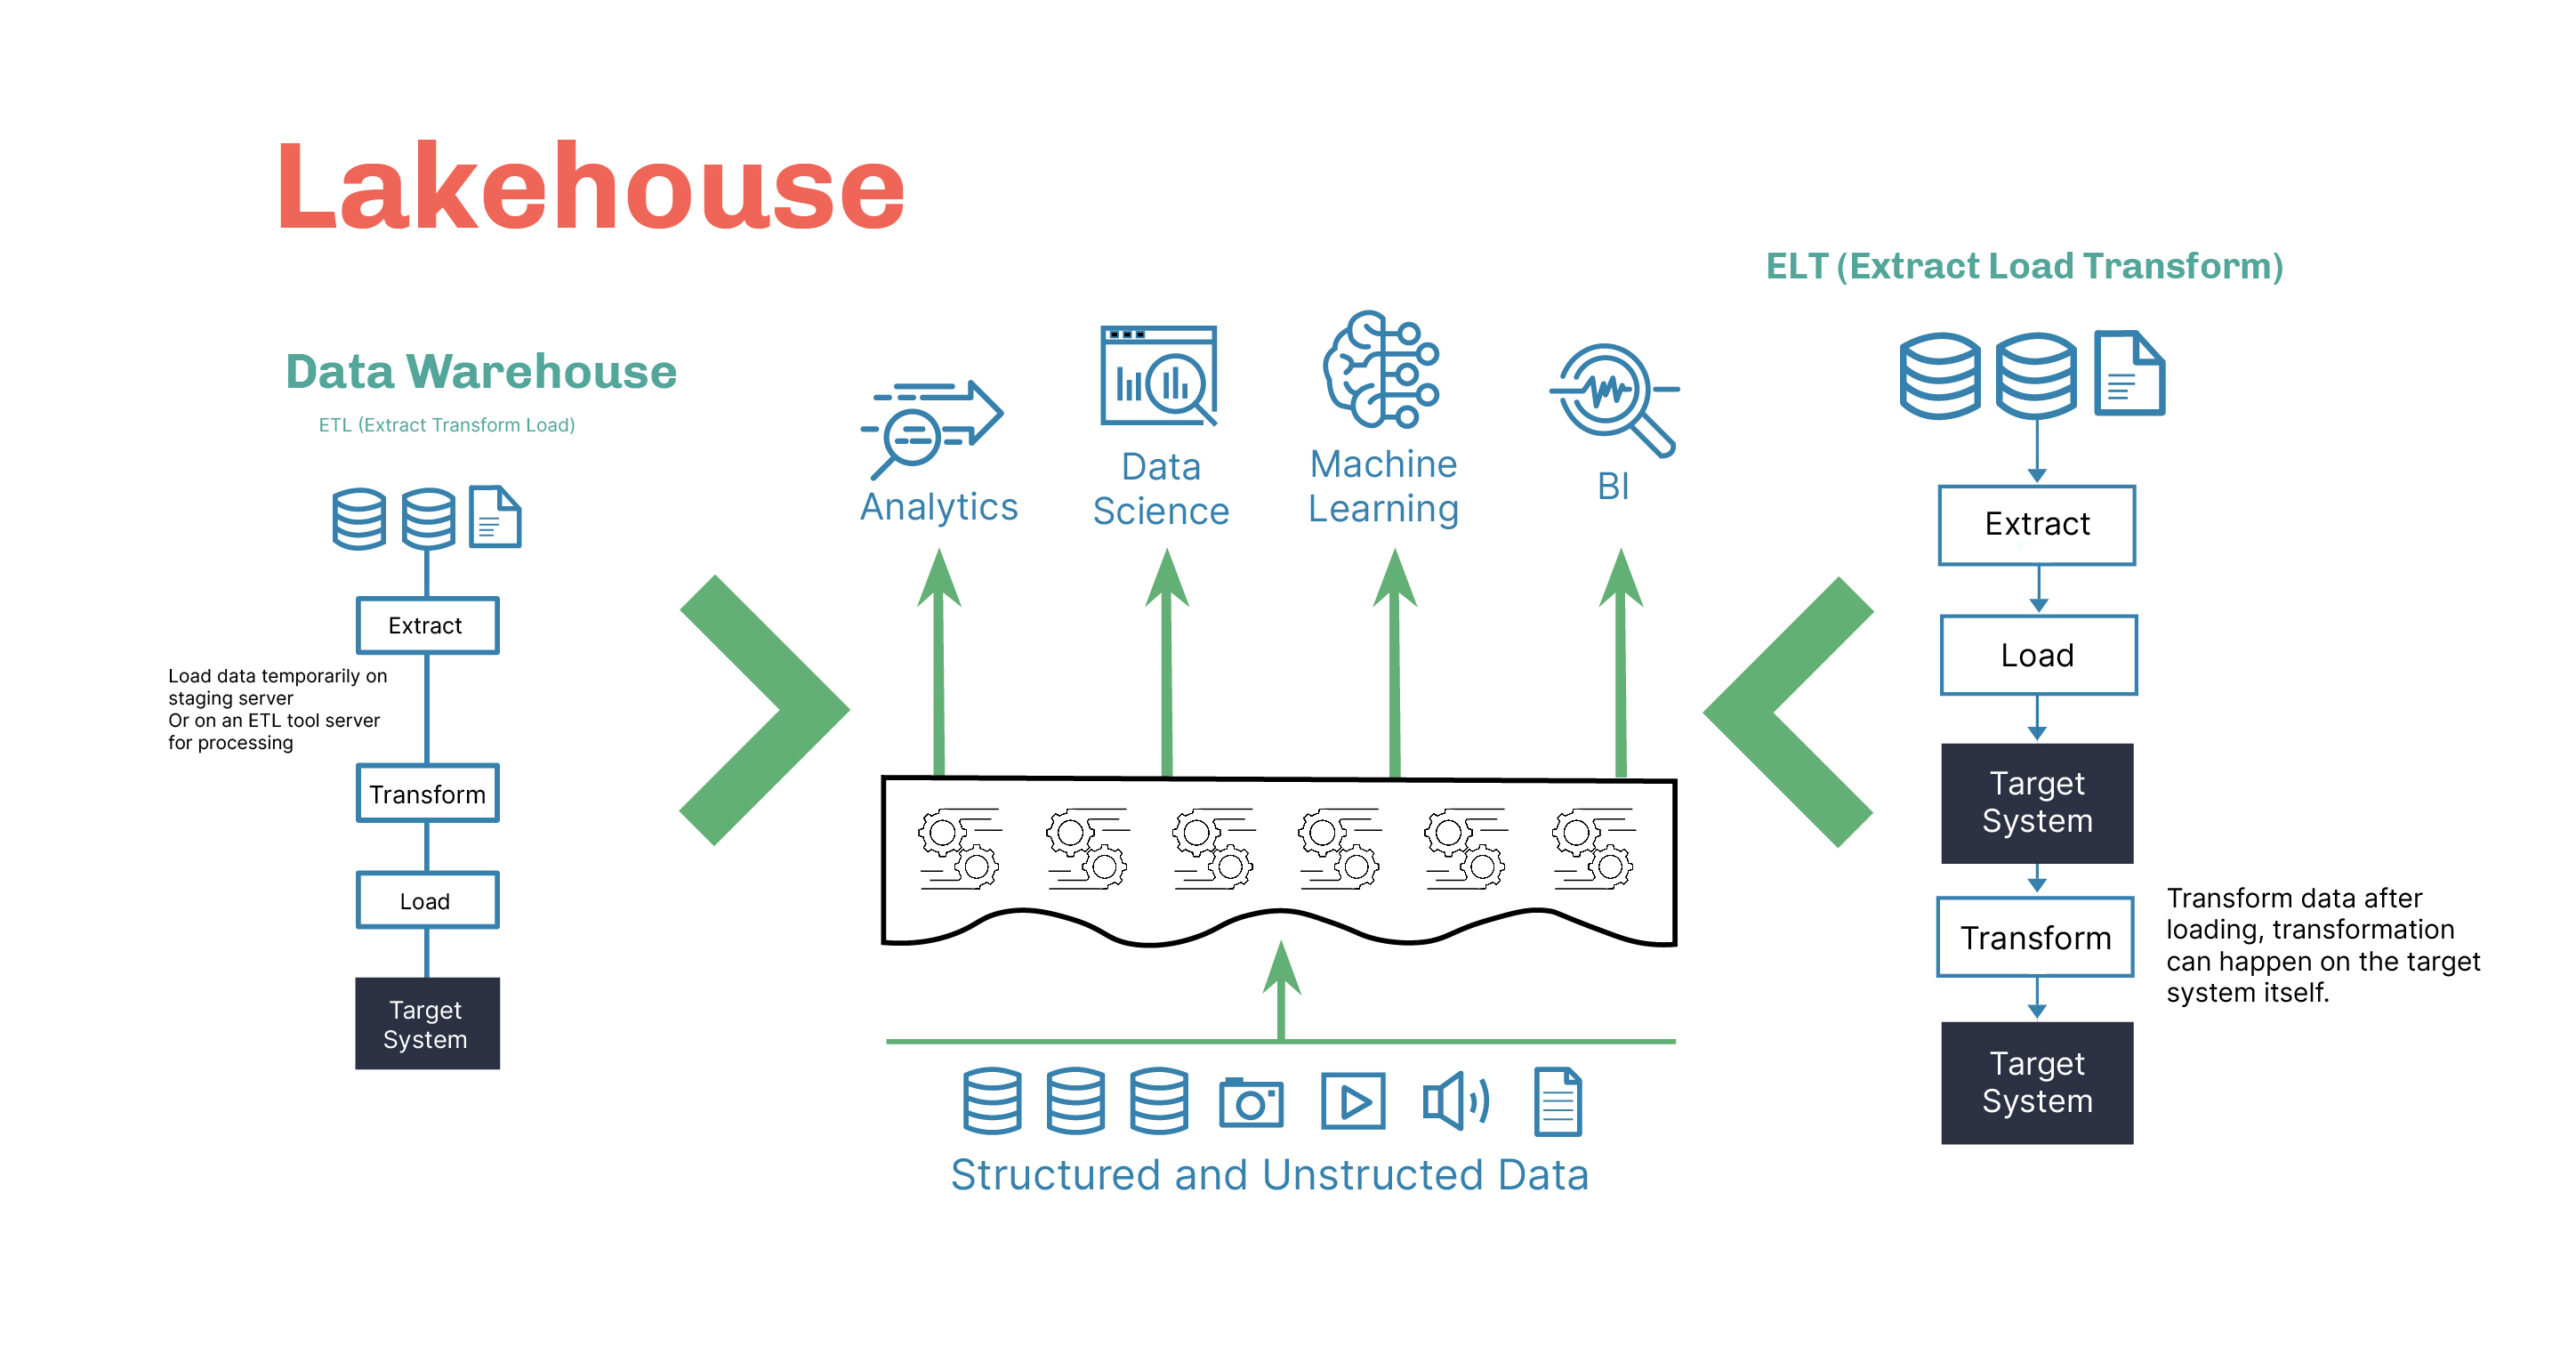
В условиях перехода к архитектурным моделям Data Lakehouse и традиционным Data Warehouse (DWH) выбор модели данных становится стратегическим решением. Правильная модель не только определяет структуру хранения и время отклика запросов, но и влияет на скорость адаптации под новые бизнес-случаи, качество управляемости данных и способность поддерживать согласованность между разнородными источниками. В данной главе рассматриваются три ключевых подхода к моделированию данных - dimensional, Data Vault и Anchor Modeling - а также концепции схем согласования, их преимущества и ограничения в контексте современных архитектур. Особое внимание уделяется тому, как каждая модель вписывается в сценарии Lakehouse и DWH, какие паттерны интеграции применяются на уровне хранения, обработки и метаданных, и какие алгоритмы лежат в основе загрузки данных, версиирования и аудита.
Далее приводятся конкретные принципы построения схем, методы реализации и практические ориентиры для выбора подхода в зависимости от бизнес-циклов, уровня зрелости данных и регуляторных требований. В центре внимания - как сочетать архитектурную гибкость Lakehouse с надёжной управляемостью и предсказуемостью DWH, чтобы обеспечить эффективную поддержку аналитических сценариев: от операционной аналитики и моделирования до регуляторной отчетности и продвинутой бизнес-интеллектуальной аналитики.
-
Уточнение контекста: архитектура и схемы согласования выступают как связующее звено между бизнес-требованиями и техническим решением. В рамках данного материала рассматриваются способы построения устойчивых моделей данных, которые сохраняют историчность и поддерживают согласованность между доменами, а также демонстрируются практические примеры реализации в рамках современных платформ.
-
Внимание к реализациям: описание опорных паттернов, алгоритмов загрузки и трансформации, управление схемами эволюции, а также рекомендации по интеграции с инфраструктурой Lakehouse (например, поддержка форматов и метаданных, протоколы доступа, транзакционные гарантии) и DWH-подходами (централизация качества, консолидация ключей и бизнес-логики).
Краткое содержание главы
- Общее представление трех основных моделей данных и их роль в архитектурах Lakehouse и DWH.
- Dimensional моделирование: принципы, SCD-паттерны, плюсы и ограничения для аналитических запросов.
- Data Vault: структура, принципы разворачивания, масштабируемость и паттерны загрузки.
- Anchor Modeling и схемы согласования: принципы, сравнение с DV и Dimensional, сценарии использования.
- Практические рекомендации по выбору модели под бизнес-сценарии и интеграционные паттерны в Lakehouse и DWH.
- Рекомендации по управлению метаданными, эволюцией схем и обеспечению согласованности данных.
- Инструменты и технологии, поддерживающие внедрение выбранной модели.
Введение: контекст и базовые принципы
Архитектура Lakehouse объединяет потенциал хранения большого объема полуструктурированных данных и возможности транзакционных систем DWH. Это требует пересмотра традиционных подходов к моделированию данных: не каждая задача требует строгого «звезды» или «снежинки», и не все изменения бизнес-логики должны проходить через сложную схему DV. Однако задача сохранения историчности, консистентности и возможности эффективной агрегации остается актуальной. В таких условиях выбор между dimensional моделированием, Data Vault и Anchor Modeling становится вопросом компромиссов между скоростью вывода, уровнем нормализации, сложностью изменений и возможностью масштабирования.
- Dimensional моделирование: простота использования, понятность для бизнес-пользователей, быстрые запросы за счет денормализации, но потенциально меньше гибкости при частых изменениях бизнес-правил и сложных сценариях интеграции.
- Data Vault: высокая адаптивность к изменению сфер бизнеса, масштабируемость и детальная история изменений, однако увеличение количества таблиц и сложность обеспечения консистентности могут усложнить запросы и внедрение.
- Anchor Modeling: фокус на минимизацию null-значений, улучшенную эволюцию схем и реконсилиацию между доменами, но требует освоения новой парадигмы моделирования и может привести к более сложным SQL-запросам.
Выбор конкретной модели во многом определяется бизнес-случаем: требования к скорости реакции, частота обновления справочных данных, объем исторических данных, требования к аудиту и регуляторная нагрузка, а также наличие компетенностей в команде и зрелость инфраструктуры управления метаданными. В следующих разделах детально рассматриваются каждый из подходов, их архитектурные принципы, типичные паттерны загрузки и интеграции, а также практические примеры реализации в рамках Lakehouse и DWH.
Dimensional моделирование: принципы, преимущества и ограничения
Дименсиональная модель строится вокруг двух основных типов объектов: фактов и измерений (dimensions). Фактовые таблицы содержат количественные показатели бизнес-процессов (например, продажи, заказы, клики), а размерные таблицы - контекст для этих фактов (клиенты, товары, время, география). Веса и контексты упрощают агрегацию и аналитические запросы, делают их интуитивно понятными для бизнес-пользователей. Преимущество данного подхода - простота запросов, предсказуемые паттерны отчетности и совместимость с большинством BI-инструментов.
- Простота запросов: пользователи формируют запросы по бизнес-измерениям без глубокого знания маршрутизации данных через сложные связи.
- Эффективные агрегации: денормализация обеспечивает быстрые ответов на типичные аналитические задачи.
- Управление изменениями: SCD (Slowly Changing Dimensions) паттерны позволяют сохранять историю изменений в измерениях.
Однако dimensional modeling имеет и ограничения:
- Эволюция измерений: добавление новых атрибутов к измерениям может потребовать переработки существующих схем и пересчета исторических данных.
- Фрагментация контекста: при расширении бизнес-доменов возможно увеличение числа связанных размерностей и фактов, что усложняет обеспечение единообразия ключей.
- Гибкость к изменениям правил: когда бизнес-правила меняются часто, поддержка единых конформированных измерений может быть ограничена, особенно в распределенной среде.
Архитектурная реализация в Lakehouse часто сочетает легкую денормализацию с учетом форматов хранения (Parquet, ORC), эффективной компрессии и фильтрации на уровне хранения. Паттерны извлечения-заргузки (ELT) позволяют сначала сохранять данные «как есть», а затем прецизировать их в звездной схеме. В рамках DWH Dimensional Modeling традиционно оптимизируется под консистентность и предсказуемые производственные нагрузки, где производители аналитических решений требуют быстрого доступа к агрегированным данным.
-- Пример: простая dimensional модель (факты и измерения)
CREATE TABLE dim_customer (
  customer_key INT PRIMARY KEY,
  customer_id VARCHAR(50),
  name VARCHAR(100),
  region VARCHAR(50),
  load_ts TIMESTAMP
);

CREATE TABLE fact_sales (
  sale_id BIGINT PRIMARY KEY,
  customer_key INT,
  product_key INT,
  store_key INT,
  date_key INT,
  amount DECIMAL(18,2),
  quantity INT,
  load_ts TIMESTAMP
);
Таким образом, dimensional моделирование отлично подходит для быстрого старта аналитики и эффективной поддержки типовых бизнес-процессов. В контексте Lakehouse это дополняется гибкостью хранения и возможностями обработки больших массивов полуструктурированных данных, однако следует учитывать риск фрагментации контекста и потребность в дисциплине при управлении ключами и версиями измерений.
Data Vault: принципы, структура и загрузка
Data Vault ориентирован на максимальную устойчивость к изменениям бизнес-логики и источников данных, а также на хранение полного исторического следа изменений. Основные строительные блоки DV:
- Хабы (Hubs): таблицы бизнес-ключей, которые формируют уникальные бизнес-объекты (например, клиент, продукт).
- Связки (Links): связи между хабами, отражающие транзакционные или композиционные зависимости.
- Сателлиты (Satellites): история атрибутов и контекстной информации, привязанная к соответствующим хабам и связям.
Достоинства Data Vault:
- Эволюционная схема: добавление новых источников и бизнес-правил происходит без радикальных переработок существующих структур.
- Историчность и аудируемость: DV принято как устойчивая к изменениям архитектура, которая сохраняет полную историю изменений и поддерживает соответствие требованиям регуляторов.
- Масштабируемость: благодаря разделению бизнес-ключей и контекста можно параллельно загружать данные из разных источников и объединять их в консолидированном слое.
Недостатки:
- Возрастающая сложность: количество таблиц и связей может вырасти существенно, что усложняет разработку, тестирование и оптимизацию запросов.
- Производительность: сложные соединения между хабами, связками и сателлитами могут приводить к более дорогостоящим запросам по сравнению с денормализованной звездной схемой.
Типичные паттерны загрузки в DV:
- Погружение бизнес-ключей в хабы - уникальные идентификаторы бизнес-документов, без исторических атрибутов.
- Построение связей через Link-таблицы - отображение отношений между хабами.
- Satellites для контекста и истории - хранение атрибутов и изменений, обновляющихся по времени.
Пример структуры DV:
- hub_customer (customer_key, business_key, load_ts)
- hub_product (product_key, business_key, load_ts)
- link_order_customer (order_key, customer_key, load_ts)
- sat_customer_attribute (customer_key, attribute_name, attribute_value, load_ts)
Далее приведем простой фрагмент кода, демонстрирующий создание структуры DV и загрузку в ELT-процессах:
-- Создание DV-элементов (псевдокод)
CREATE TABLE hub_customer (
  customer_key VARCHAR(64) PRIMARY KEY,
  business_key VARCHAR(255),
  load_ts TIMESTAMP
);

CREATE TABLE sat_customer_attribute (
  customer_key VARCHAR(64),
  attribute_name VARCHAR(100),
  attribute_value VARCHAR(255),
  load_ts TIMESTAMP
);

CREATE TABLE link_order_customer (
  order_key VARCHAR(64),
  customer_key VARCHAR(64),
  load_ts TIMESTAMP
);
-- Пример загрузки: генерация хеша бизнес-ключа для хаба
INSERT INTO hub_customer (customer_key, business_key, load_ts)
SELECT MD5(business_key) AS customer_key, business_key, CURRENT_TIMESTAMP
FROM staging_customers;
Data Vault хорошо сочетается с архитектурами Lakehouse: в слое хранения можно сохранить не только структурированные DV-тables, но и сырые данные источников (_RAW), а в бизнес-слой перейти к DV-слоям с очищением, интеграцией и версионированием. DV обеспечивает гибкость при интеграции новых систем, но требует дисциплины в проектировании процессов загрузки и управления метаданными.
Anchor Modeling: принципы и практическая реализация
Anchor Modeling представляет собой альтернативу DV и Dimensional Modeling, направленную на минимизацию крупных узких мест при эволюции схем и особенно полезную для сложной интеграции доменов. Основные принципы:
- Анкеры (Anchors): центральные «точки» сущности, которые хранят ключевой контекст.
- Атрибуты (Attributes): данные, привязанные к анкерам через отдельные таблицы атрибутов.
- Связи (Ties): связи между анкерными сущностями, которые формируют сложные зависимости без «жестких» связей в одной таблице.
- Сателлиты (Satellites): история атрибутов и атрибутивную контекстную информацию.
Преимущества Anchor Modeling:
- Гибкость эволюции: новые атрибуты добавляются как новые таблицы атрибутов, что упрощает изменение схем без переработки существующих структур.
- Минимизация null-значений: отказ от большой числа nullable столбцов в одной таблице - данные структурируются по мелким темпоральным частям.
- Улучшенная поддержка историчности и согласованности между доменами: связи между анкерами и тире создают легко поддерживаемые правила доступа и lineage.
Недостатки:
- Потребность в переработке SQL-запросов: логику выбора атрибутов и их соединения нужно выстроить через несколько таблиц атрибутов и связей, что увеличивает сложность запросов.
- Кривая обучаемости: архитектура менее традиционна для бизнес-пользователей и требует больше времени на обучение команды.
Пример упрощенной структуры Anchor Modeling:
- Anchor: customer_anchor (customer_key, business_key, load_ts)
- Attribute: customer_name_attr (anchor_key, attribute_name, value, load_ts)
- Tie: customer_product_tie (anchor1_key, anchor2_key, load_ts)
- Satellite: customer_history_sat (anchor_key, history_field, value, start_ts, end_ts)
Пример SQL-структурирования и загрузки атрибутов:
CREATE TABLE customer_anchor (
  anchor_key VARCHAR(64) PRIMARY KEY,
  business_key VARCHAR(255),
  load_ts TIMESTAMP
);

CREATE TABLE customer_name_attr (
  anchor_key VARCHAR(64),
  attribute_name VARCHAR(100),
  value VARCHAR(255),
  load_ts TIMESTAMP
);

CREATE TABLE customer_history_sat (
  anchor_key VARCHAR(64),
  history_field VARCHAR(100),
  value VARCHAR(255),
  start_ts TIMESTAMP,
  end_ts TIMESTAMP
);
Anchor Modeling особенно эффективен в средах с частой эволюцией доменных моделей и множеством источников. Он позволяет поддерживать согласованные схемы через разделение различной функциональности на мелкие компоненты, что упрощает управление изменениями и консолидацию данных.
Схемы согласования: конформность, сопоставления и паттерны
Схемы согласования (conformed schemas) отвечают за обеспечение единообразия бизнес-логики и фактов в разных доменах и источниках. Основные принципы:
- Конформированные измерения и факты: общие элементы справочных слоев, которые используются во всех доменах для обеспечения сопоставления и согласованности.
- Роль-производимые измерения (Role-playing dimensions): одна и та же таблица измерений может играть роль в нескольких контекстах.
- Общие ключи и справочные таблицы: использование единых бизнес-ключей, чтобы связать данные из разных витрин и интеграционных слоев.
- Контракты данных и схемная эволюция: регламентирование изменений в схемах, версионирование и поддержка «продуктовых» контрактов между источниками и потребителями.
Паттерны согласования особенно ценны в рамках DWH, когда требуется регуляторная совместимость и единая аналитическая персона. В Lakehouse данном подходе обеспечивается через общий слой контрактов и метаданных, где изменения распространяются через связанные домены без разрушения существующих решений. В практике это реализуется через:
- конформированные размерности в слое источников данных;
- общие бизнес-ключи и hash-подтверждения, обеспечивающие сопоставления между системами;
- слои согласованных фактов, где агрегатные показатели единообразны и сравнимы;
- управление версиями схем и схемными изменениями через метаданные и миграционные паттерны.
Пример может выглядеть так:
- dim_time_conformed (date_key, calendar_year, quarter, month_name)
- dim_customer_conformed (customer_key, customer_profile_key, segment)
- fact_sales_conformed (sale_key, customer_key, product_key, date_key, amount)
Согласованные схемы требуют дисциплины в управлении ключами и бизнес-правилами, потому что любое изменение в одном домене должно отражаться на всех связанных доменах. В рамках Lakehouse это достигается через единый реестр схем, хранение версий и правила совместимости, чтобы избежать несовместимости при обновлении источников.
Практическая реализация под бизнес-сценарии: выбор модели и интеграционные паттерны
Выбор между dimensional, Data Vault и Anchor Modeling зависит от ряда факторов:
- Скорость изменений и частота добавления источников: DV и Anchor Modeling предпочтительнее в условиях частой эволюции доменов и бизнес-правил.
- Требования к истории и аудиту: DV и Anchor Modeling обеспечивают богатую историческую составляющую, но DV более привычен для регуляторных задач; Anchor упрощает эволюцию и аудит за счет мелкой зернистости.
- Нагрузка на аналитические запросы: dimensional моделирование обеспечивает быструю агрегацию и простые запросы; при сложной интеграции DV/Anchor может потребоваться дополнительная логика соединений.
- Инфраструктура и компетенции: Lakehouse предоставляет гибкость для всех подходов, однако конкретная команда может быстрее разворачиваться на DV-или Dimensional-моделях в зависимости от опыта и инструментов.
Интеграционные паттерны в Lakehouse и DWH:
- ELT-потоки: данные сначала загружаются «как есть», затем трансформируются в целевые модели. Lakehouse снижает издержки на копирование и позволяет хранить сырые данные в RAW-слое для дальнейшей переработки.
- Метаданные и схема-реестр: единый реестр для версионирования схем и контрактов между источниками и потребителями. Это особенно критично в долгоживущих системах, где регуляторные требования могут изменяться.
- Управление ключами и консолидация: использование хеш-ключей, конформированных ключей и surrogate-ключей для обеспечения устойчивости к изменениям источников.
- Границы доменов и контракты данных: явное разделение доменов через ограничение доступа и обеспечение согласованности через общие ключи и схемы.
Применение к конкретным кейсам:
- Аналитика по клиентскому профилю и продажам: dimensional моделирование в сочетании с конформированными аспектами для масштаба и быстрого анализа. В Lakehouse можно построить Star-схему поверх DV-слоя, сохранивность и high-level представления для бизнес-пользователей.
- Интеграция множества источников: Data Vault или Anchor Modeling лучше подходят для сложной интеграции и эволюции правил. DV обеспечивает детальную историю связей и контекст, Anchor - гибкость в добавлении новых атрибутов без переработки существующих структур.
- Регуляторные требования и аудита: DV и Anchor Modeling обеспечивают защищенное хранение истории изменений и детальный аудит за счет разделения контекста и атрибутов, что упрощает требования к аудиту.
Реализация практических сценариев (инструменты и ограничения)
Как и в любой архитектуре, выбор платформенных решений и инструментов существенно влияет на реальный результат. В рамках открытых решений и практик можно привести следующие ориентиры:
- Хранение и обработка: Apache Iceberg и Delta Lake как примеры современных форматов хранения, поддерживающих транзакционность и эволюцию схем. В открытом источнике они обеспечивают открытое управление схемами и надлежащую поддержку транзакций в больших массивах данных.
- Управление изменениями: использование миграционных скриптов и паттернов миграции для поддержания согласованности между версиями моделей. Метаданные и схемы должны обновляться синхронно с изменениями в слоях данных.
- Управление качеством данных: внедрение контрактов данных, автоматических тестов на консистентность ключей и валидации атрибутов, контроль версионирования и мониторинг качества.
Начальные примеры реализации в рамках Data Lakehouse и DWH:
- Реализация dimensional-схемы на Lakehouse к примеру может включать Star-схему поверх дата-слоя, с хранением в Parquet/ORC и использованием внешних ключей через конформированные таблицы.
- Реализация DV-гипотезы в Lakehouse может включать набор хабов, связей и сателлитов с поддержкой истории и слежения за изменениями, где сырые данные сохраняются в RAW слое, а целевые DV-структуры - в curated слое для аналитики.
Key takeaways
- Выбор модели данных должен основываться на характере изменений бизнес-правил, требованиях к истории и регуляторной нагрузке.
- Dimensional моделирование обеспечивает простые и быстрые аналитические запросы, но может потребовать дополнительных средств эволюции при изменениях доменов.
- Data Vault предлагает высокую адаптивность и сохранение истории, но может потребовать более сложной архитектуры и запросов.
- Anchor Modeling обеспечивает гибкость и минимизацию null-значений, но требует изменения привычной парадигмы моделирования и знаний SQL-паттернов.
- Схемы согласования помогают обеспечить единообразие между доменами, что особенно важно в рамках регуляторной отчетности и консолидации данных.
- Lakehouse предоставляет инструменты для гибридной реализации: можно сочетать DV/Anchor с Dimensional слоем и строить конформированные паттерны через единый слой метаданных.
- Управление метаданными, версиями схем и контрактами данных является критическим элементом устойчивой архитектуры в условиях эволюции бизнеса и источников данных.
FAQ
- В чем основное различие между Dimensional Modeling и Data Vault в контексте Lakehouse?
- Dimensional Modeling ориентирован на простые, удобные для бизнес-пользователей схемы с быстрыми запросами и агрегатами. Это часто подходит для быстрого вывода и стандартной аналитики. Data Vault же спроектирован для устойчивости к изменениям источников и бизнес-правил, с подробной историей и возможностью параллельной загрузки данных из множества систем. В Lakehouse можно сочетать оба подхода: использовать dimensional как слой представления для бизнес-потребителей и DV как слой интеграции источников и управления историей.
- Как Anchor Modeling дополняет DV и Dimensional Modeling?
- Anchor Modeling фокусируется на минимизации сложностей схем, улучшении эволюции и интеграции между доменами за счёт мелких компонентов ( anchors, attributes, ties, satellites). Это позволяет легче добавлять новые атрибуты и источники без радикального переработания существующих структур. В сочетании с DV или Dimensional можно добиться как высокой адаптивности, так и простой аналитики.
- Какие паттерны выбора схемы следует применять под регуляторные требования?
- При строгих требованиях к аудитам и аудиту изменений стоит рассмотреть Data Vault за счёт его детального слежения за изменениями и истории. Также можно строить конформированные слои для единообразия между доменами и использовать миграционные стратегии для поддержки соответствия. В Lakehouse можно использовать гибридный подход: DV для интеграции и истории, Dimensional для бизнес-аналитики и согласованных агрегаций, Anchor - для эволюционных изменений.
- Какие существуют общие принципы загрузки и интеграции для всех подходов?
- Принципиально важна разделенность слоев: сырые данные (RAW), интегрированные/управляемые данные (CURATED или DV-слой), и слоя агрегаций/представления. Это позволяет сохранить историю и управлять качеством без потери гибкости. Управление метаданными и контрактами между слоями критично для устойчивой эволюции схем.
- Как обосновать выбор между DV и Dimensional Modeling в большой организации?
- Оцените скорость изменений источников и сложность бизнес-правил: если источники часто меняются и требуется сохранение полной истории, DV или Anchor дают преимущества. Если же приоритет - скорость поставки аналитики и простота использования для бизнес-пользователей, dimensional-модель может быть предпочтительнее, возможно в сочетании с DV в слое интеграции.
- Какие инструменты чаще всего применяются в практиках DV и Anchor Modeling?
- Для DV и Anchor Modeling широко применяются современные открытые инструменты и платформы, включая Apache Iceberg и Delta Lake как слои хранения, поддерживающие транзакционность и эволюцию схем. В рамках проекта также используются инструменты для управления метаданными, репозитории схем и контракты данных.
- Какова роль схем согласования в рамках многоуровневых аналитических сред?
- Схемы согласования обеспечивают единообразие между доменами, что особенно важно для регуляторной отчетности и консолидации. Это достигается через конформированные измерения и факты, общие ключи и паттерны совместимости между источниками. В Lakehouse конформность поддерживается через общий слой метаданных и схемную регламентацию.
- Какие риски стоит учитывать при переходе от DWH к Lakehouse с использованием DV/Anchor?
- Риск несогласованности между слоями, сложности миграций и увеличенного объема запросов при сложной архитектуре. Преодоление требует четкой стратегии миграции, управляемого перехода между слоями, и усиленного контроля качества данных и контрактов.
- Какие признаки того, что требуется конформная схема согласования?
- Разрозненная аналитика по нескольким доменам, необходимость единого контекста и консолидации сигналов, требования к регуляторному аудиту и поддержанию совместимых ключей. В таких случаях схема согласования помогает обеспечить единообразие и предсказуемость.
- Как начать внедрять набор паттернов в реальном проекте?
- Начать можно с пилотного кейса, который охватывает несколько источников и бизнес-процессов. Выбор скилловой команды и определения роли DV/Anchor/Dimensional паттернов в конкретном кейсе - следующий шаг. Важна настройка слоев хранения и метаданных, а также формализация контрактов между источниками и потребителями. Затем постепенно расширять модель, обеспечивая совместимость и управление историей.
- Конкретные примеры реализаций и миграций следует сопровождать стратегией управления метаданными, документированием ключевых бизнес-правил и регулярными аудитами качества данных.
Эта глава охватывает ключевые принципы моделирования данных в контексте выбора архитектуры под бизнес-сценарии, сравнивая dimensional, Data Vault и Anchor Modeling, а также паттерны схем согласования. В следующем разделе можно углубиться в конкретные кейсы компаний и подробно разобрать сценарии миграции с одной модели к другой, с акцентом на архитектуру Lakehouse и пути к устойчивому управлению данными.


