

Эксплуатация моделей прогноза спроса: мониторинг, обновление, ревью
Прогноз спроса - ключевой элемент цифровой трансформации цепочек поставок и продаж. Эффективность бизнес-решений зависит не только от качества самой модели, но и от того, как она эксплуатируется в реальном времени: как собираются данные, как рассчитываются метрики, как выявляются дрейфы и как организуется обновление моделей. В этой главе рассмотрены практики мониторинга качества прогноза, стратегии обновления моделей и процессы ревью, ориентированные на устойчивую производительность бизнес-процессов. Особое внимание уделяется интерпретации таких метрик, как MAPE, Bias и Forecast Accuracy, а также архитектуру интеграций между источниками данных, вычислительными сервисами и системами управления моделью.
Мониторинг устойчивости прогноза требует системного подхода: он должен охватывать данные, моделирование, операционные параметры и управление изменениями. Цель - раннее выявление деградации, своевременное обновление моделей и прозрачная отчетность для стейкхолдеров. В условиях многозонального планирования, сезонности и множества продуктовых сегментов важно строить общие принципы, которые остаются применимыми при разных моделях и в разных бизнес-контекстах.
- Архитектура мониторинга и данных
- Метрики качества прогноза и их интерпретация
- Мониторинг пайплайна и дрейф-детекция
- Стратегии обновления моделей и контроль версий
- Governance, ревью и интеграционные протоколы
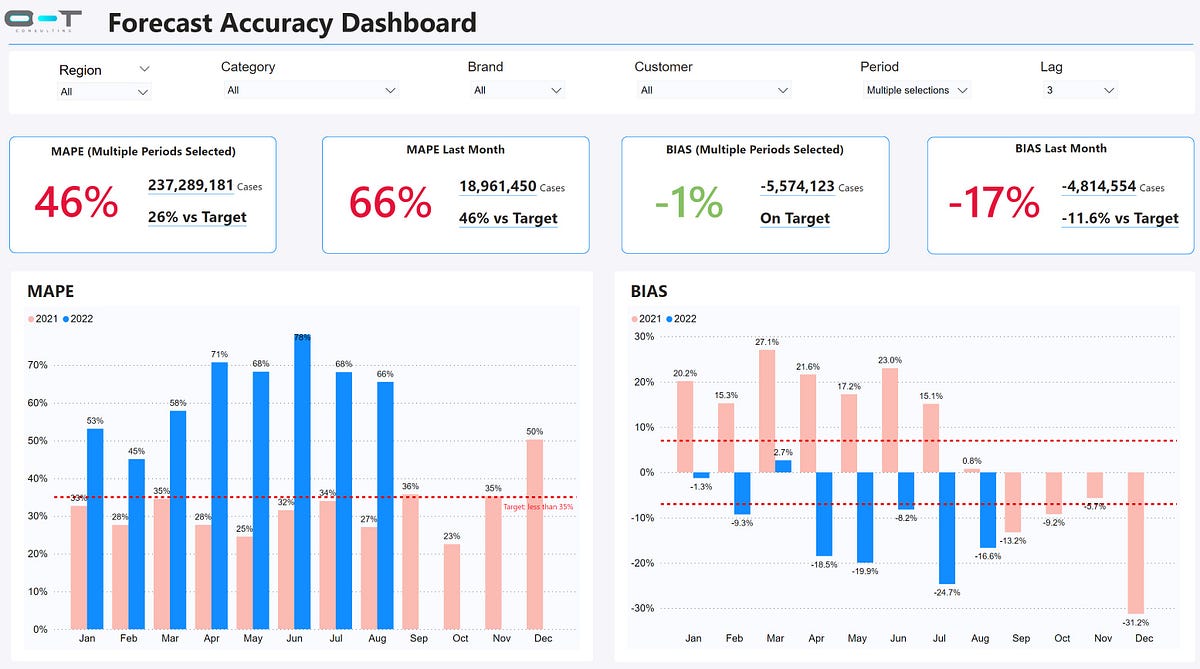
Архитектура мониторинга и данных
Эффективная эксплуатация требует четко реализованной архитектуры, где каждый элемент выполняет свою задачу и передает данные в понятной форме в единую систему наблюдения. Основные компоненты архитектуры включают источники данных, пайплайны ingestion и очистки, вычислительную среду для прогноза и метрик, хранилища для моделей и метрик, а также визуализацию и алертинг.
- Источники данных охватывают исторические факты спроса, внешние регрессоры (цены, акции конкурентов, погодные условия, праздники), а также данные по запасам и поставкам. Важно обеспечить качество входных данных: полноту, непротиворечивость и timeliness.
- Пайплайн обработки должен поддерживать как пакетную, так и потоковую обработку. Для предсказаний на уровне SKU/проектов требуется гибкость в настройке окон обучающих данных, фильтров выбросов и учета сезонности.
- Хранилища и управление данными включают data lake/warehouse, feature store для повторного использования признаков и модельный реестр для контроля версий и совместного применения моделей.
- Вычислительная платформа должна обеспечивать повторяемость расчетов: идентичные версии кода, фиксированные зависимости, контроль версий данных и моделей, а также возможность воспроизводимого разворачивания в проде.
- Мониторинг и алертинг осуществляются через систему наблюдения за метриками, событийные алерты и дашборды. В качестве примера практик можно указывать Prometheus + Grafana для метрик и alerting, а для управления версиями и экспериментов - MLflow или аналогичный инструмент.
- Интеграции и протоколы: REST/gRPC API для обмена прогнозами и метриками между сервисами, обобщенные события через брокеры сообщений (Kafka, RabbitMQ), а также CI/CD для автоматизированного развёртывания новых версий моделей и пайплайнов.
Эта архитектура обеспечивает прозрачность происхождения данных и воспроизводимость расчётов, что критично для аудита и регуляторной сопоставимости. В условиях корпоративной архитектуры важно выработать обоснованные политики доступа, управления версиями и регрессионного тестирования, чтобы изменения в моделях не приводили к непредвиденным бизнес-эффектам.
- В качестве примечания: для мониторинга и визуализации можно сочетать Prometheus с Grafana, а для управления экспериментами и версиями моделей - MLflow. В рамках интеграции с ERP/CRM системами следует проектировать RESTful API слои и использовать событийно-ориентированные протоколы для минимизации задержек и потерь данных.
Архитектурная схема эксплуатации
- Источники данных → Ingestion/Validation → Feature Store → Модели прогнозирования → Метрики прогноза → Модельный регистр → Дашборды и алерты
- Управление версиями: каждая версия модели привязана к конфигурации признаков, набору данных, метрикам и времени развёртывания.
- Drift-детекция: регулярно оценивайте статистические изменения в входных признаках и целевой переменной; интегрируйте механизм с алертингом на пороги дрейфа.
- Безопасность и соответствие: журналирование доступа к данным и моделям, хранение метаданных об обработке персональных данных и соблюдение регулятивных требований.
Метрики качества прогноза: MAPE, Bias, Forecast Accuracy и их интерпретация
Ключевая задача эксплуатации - корректно интерпретировать результаты прогноза и принимать управленческие решения на основе устойчивой картины качества. Рассмотрим базовые метрики и принципы их применения в контексте спроса.
MAPE (Mean Absolute Percentage Error) измеряет среднюю абсолютную ошибку в процентах относительно фактических значений. Он интуитивно понятен для бизнес-пользователей, позволяет сравнивать прогнозы между ассортиментами и периодами, но чувствителен к нулевым и близким к нулю фактическим значениям и к экстремальным значениям в данных. Поэтому в некоторых случаях применяют модификации MAPE, например, MAPE with stabilized denominator или Weighted MAPE по сегментам.
Bias отражает систематическую склонность прогноза к пере- или недопрогнозу. Выражается как среднее значение разности forecast - actual. Негативное bias указывает на тенденцию недооценивать спрос, позитивное - переоценивать. В отличие от MAPE, Bias позволяет выявить направление ошибки и служит индикатором устойчивости модели к изменению бизнес-условий или сезонности.
Forecast Accuracy - более общий термин, который часто трактуют как 1 - MAPE или как альтернативные нормы, например MASE (Mean Absolute Scaled Error). MASE сравнивает ошибку прогноза с ошибкой простого базового прогноза на обучающем периоде, что позволяет нормировать метрику по сложности временного ряда и baixos сезонов. В практических рамках часто применяют несколько версий Forecast Accuracy, чтобы учитывать специфику бизнеса: сеансовая, SKU-уровень, региональная сегментация.
- В контексте эксплуатации важно применять метрики не как единичные показатели, а как набор индикаторов, охватывающих разные уровни агрегирования: SKU, категория, регион и временной горизонт. Это позволяет выявлять слабые места прогноза и обосновывать решения о переработке признаков, изменении окна обучения и стратегии обновления.
- Интерпретацию следует сочетать с бизнес-персонализацией. Например, малые значения MAPE у небольших сегментов не гарантируют высокого доверия к прогнозу для крупных сегментов, где прошлые ошибки приводят к существенным финансовым последствиям.
- При слабом уровне стабильности целевых значений полезны дополнительные метрики: например, качество предсказания в отдельных сезонных окнах, устойчивость к выбросам, скорость деградации по времени. В условиях значимой сезонности требуется анализ по согласованию с бизнес-календарём (праздники, распродажи).
Примеры вычислений
import numpy as np

def metrics(actual, forecast):
    a = np.asarray(actual, dtype=float)
    f = np.asarray(forecast, dtype=float)
    mask = a != 0
    mape = np.mean(np.abs((a[mask] - f[mask]) / a[mask]))
    bias = np.mean(f - a)
    mase = np.mean(np.abs(a[1:] - f[:-1])) / np.mean(np.abs(a[1:] - a[:-1]))
    return {'MAPE': mape, 'Bias': bias, 'MASE': mase}

## Пример
actual = [100, 120, 0, 80, 150]
forecast = [110, 115, 5, 78, 145]
print(metrics(actual, forecast))
Важно помнить о клиппинге и нормализации. При отсутствии устойчивой базы для MAPE полезно переходить к альтернативам (MASE, sMAPE) и учитывать специфику нулевых значений. В дополнение к чистым числовым метрикам полезны графики: распределение ошибок, зависимость ошибки от уровня спроса, сезонные паттерны ошибок. Визуализация помогает обнаружить скрытые паттерны и объяснить бизнес-эффекты.
Мониторинг качества прогноза: пайплайн и этапы
Эффективный мониторинг строится как повторимый цикл, который начинается с определением целей и порогов, затем переходит к сбору данных, расчёту метрик и выводу действий. Принципы такого пайплайна:
- Данные и вычисления: сбор корректных данных в рамках заданной временной шкалы, проверка на полноту и консистентность, обработка пропусков.
- Расчет метрик: регулярный пересчет MAPE, Bias, Forecast Accuracy по всем уровням агрегации; хранение истории метрик для анализа трендов.
- Drift и аномалии: детекция дрейфа в признаках и целевой переменной; алертинг при выходе за заранее заданные пороги. Важна настройка границ: слишком чувствительные пороги приведут к шуму, слишком жесткие - к задержке реагирования.
- Отчеты и алертинг: дашборды для стейкхолдеров, автоматические уведомления по каналам коммуникации и ежедневные/недельные отчеты о качестве прогноза.
- Этапы континуального улучшения: сбор обратной связи, анализ причин снижения качества, корректировка признаков и модели, план обновления.
Что касается инструментов, в реальных условиях целесообразно комбинировать подходы. Пример практики: сбор метрик в Prometheus, визуализация в Grafana, хранение истории метрик в Data Lake и использование MLflow для отслеживания версий моделей и гиперпараметров. Такой набор обеспечивает прозрачность, масштабируемость и возможность проведения ретроспективных ревью.
- Важные аспекты: согласование метрик с бизнес-целями, учет сезонности и календарных факторов в настройках порогов, обеспечение согласованности временных зон и периодов для сравнения.
Уровни мониторинга и alerta
- Уровень операционного мониторинга: задержки в доставке данных, доступность сервисов прогноза, корректность полноты входных признаков.
- Уровень метрик прогноза: значения MAPE, Bias и Forecast Accuracy по сегментам и горизонтам; дрейф в признаках и целевой переменной.
- Уровень бизнес-індікаторов: связь ошибок прогноза с фактическими финансовыми последствиями, такими как недопоставка или перепроизводство.
Пример интеграционного сценария
- Источник данных: ERP/CRM данные по продажам, внешние регрессоры.
- Ингест: потоковая сборка через Kafka, запись в Data Lake.
- Вычисления: периодическое обновление признаков, обучение и прогнозирование на выделенном кластере.
- Метрики: расчет MAPE, Bias и Forecast Accuracy, сохранение в метрик-слое и модельном реестре.
- Визуализация: дашборды в Grafana, отчеты в BI-платформе.
- Алерты: пороги по дрейфу и качеству, интеграция с корпоративной службой уведомлений.
Обновление моделей: стратегии retraining, пайплайн ревью
Обновление моделей - критически важный процесс в условиях изменяющейся спросовой динамики. Эффективная стратегия должно сочетать предсказуемость, минимизацию рисков деградации и быструю реакцию на новые паттерны.
- Типы обновления:
- Временное обновление по расписанию: регулярные переобучения (например, ежемесячно). Это обеспечивает прогнозную устойчивость к сезонным изменениям.
- Ретренинг по триггерам дрейфа: обновление активируется при детекции дрейфа в признаках или целевой переменной, а также при ухудшении метрик за определенный период.
- Гибридное обновление: периодические обновления и дополнительные перерасчеты по событиям, например после крупных промо-акций или изменений в ассортименте.
- Процедуры обновления:
- Валидация на отложенной выборке: проверка нового набора данных без влияния на текущие прогнозы.
- A/B тотально проводить можно через каналы shadow-рroduction: новую модель разворачивают в тестовом окружении, сравнивают с продакшн-версией по ключевым метрикам.
- Canaries и blue/green развёртывания: обновление распространяется на подмножество бизнес-подразделений или SKU, затем постепенно расширяется при подтверждении эффективности.
- Контроль версий и модельный реестр: каждая версия модели фиксируется, сопровождается конфигурацией признаков, данными обучающего набора, временными метками.
- Пайплайны обновления:
- Этап подготовки: сбор данных, переработка признаков, валидация данных.
- Этап обучения: тренировка новой версии модели с использованием обновленных признаков.
- Этап оценки: расчет метрик на отложенной выборке, сравнение с базовой версией, анализ ошибок.
- Этап развёртывания: выбор стратегии (canary/blue-green), регистрация новой версии и запуск в проде.
- Роли и ответственность: ML-инженер отвечает за архитектуру и исполнение обновления, бизнес-спонсор - за приемлемость бизнес-рисков, аналитик - за интерпретацию изменений и эффект на планирование продаж.
- Риск-менеджмент обновлений: план восстановления в случае ухудшения метрик, возможность отката к предыдущей версии, документирование причин и результатов изменений.
Пример технических рекомендаций по обновлению:
- Устанавливайте статические окны обучения и валидации, чтобы иметь сопоставимые метрики.
- Вводите мониторинг деградации по секциям продукта и регионам, чтобы обнаружить сегментные дрейфы.
- Используйте в качестве базовой линии простые модели на основе MA (Moving Average) или экспоненциальное сглаживание для сравнения с более продвинутыми моделями.
- Автоматизируйте тесты регрессии метрик перед развёртыванием новой версии в продакшн.
## Пример упрощённой регрессионной валидации обновления
## Необходимо заменить на реальные процессы обучения и подсчета метрик в вашей системе

def train_model(X_train, y_train):
    ## пример: простая регрессия
    from sklearn.linear_model import LinearRegression
    model = LinearRegression().fit(X_train, y_train)
    return model

def evaluate(model, X_valid, y_valid):
    preds = model.predict(X_valid)
    mape = np.mean(np.abs((y_valid - preds) / y_valid))
    bias = np.mean(preds - y_valid)
    return mape, bias

## Пример использования в пайплайне обновления
## X_train, y_train, X_valid, y_valid — подготовленные наборы
model = train_model(X_train, y_train)
mape, bias = evaluate(model, X_valid, y_valid)
print('MAPE:', mape, 'Bias:', bias)
Ревью и управление качеством: процессы и организация
Эффективная эксплуатация требует формализованных процессов ревью и управления качеством, которые поддерживают согласованность, объяснимость и соответствие регулятивным требованиям. Ключевые элементы:
- Роли и ответственности: выстроить четкую структуру ролей - аналитик данных, ML-инженер, бизнес-менеджер, ассистент по комплаенсу. Каждая роль имеет свои арены ответственности: от данных до бизнес-решений и аудита.
- Документация и регламенты: регламент версионности, описание моделей, датасетов, методов подготовки данных и параметров обучения. Ведение журнала изменений и обоснование решений в рамках governance-процедур.
- Регистрация изменений и тестирование: каждое обновление модели должно сопровождаться набором тестов на регрессии и валидности метрик, а также документом обоснования изменений и ожидаемого бизнес-эффекта.
- Ревью метрик и выводов: в рамках ежеквартальных ревью оцениваются не только численные метрики, но и влияние на оперативную работу и финансовые показатели. Выясняются причины изменений и формулируются корректирующие действия.
- Контроль доступа и аудит: аудит данных и моделей, контроль версий артефактов, журналирование доступа и операций.
Интеграция процессов ревью в корпоративные практики требует единых политик и стержневых процессов: документирование, верификация и утверждение изменений, а также прозрачная коммуникация с бизнес-подразделениями. В качестве практического подхода можно внедрить ежеквартальные ревью по набору SKU и регионов, где оцениваются не только метрики ошибок, но и соответствие бизнес-планам и рисковым факторам.
Протоколы интеграции и CI/CD моделей
- Непрерывная интеграция: автоматическое тестирование новых версий моделей с использованием набора валидационных метрик и регрессионных сценариев.
- Непрерывная поставка: автоматизированное развёртывание через канальные окружения, включая canary и blue/green деплойменты для минимизации рисков.
- Модельный реестр и управление артефактами: хранение данных о версиях, конфигурациях признаков и метриках, связанные с конкретным временным окном и горизонтом прогноза.
- Протокол обмена данными: стандартизованные API для доступа к прогнозам и метрикам, обеспечивающие совместимость между системами планирования, торговли и финансов.
- Безопасность и соответствие: управление секретами, аудит доступа и хранение метаданных под регулятивные требования.
Key takeaways
- Эффективная эксплуатация прогнозных моделей требует системного подхода к мониторингу метрик качества и управлению изменениями.
- Метрики MAPE, Bias и Forecast Accuracy дают разные ракурсы на качество прогноза; их совместное использование позволяет выявлять направление ошибок, сравнивать сегменты и горизонты.
- Архитектура мониторинга должна охватывать источники данных, feature store, модельный реестр, пайплайны вычислений и визуализацию, с четкими протоколами алертинга.
- Обновление моделей требует продуманной стратегии: триггеры дрейфа, тестирование на отложенной выборке, canary/blue-green развёртывание и контроль версий.
- Governance и ревью обеспечивают прозрачность, соблюдение регламентов и управляемость изменений; интеграционные протоколы поддерживают единое окружение для прогнозирования.
- Практические инструменты (Prometheus + Grafana, MLflow) позволяют реализовать устойчивую систему мониторинга и управления версиями, если они адаптированы к корпоративной архитектуре.
- Важно сочетать технические практики с бизнес-контекстом: метрики должны отражать финансовые последствия и операционные риски, а обновления - быть согласованы с планами продаж и запасов.
FAQ
- Какие метрики стоит использовать в первую очередь при эксплуатации прогноза спроса?
- Начните с MAPE для оценки относительной точности и Bias для направления ошибок. Дополнительно добавьте Forecast Accuracy (через MASE или аналогичную нормализацию) для сравнения моделей на разных горизонтах. По мере необходимости вводите дополнительные метрики по сегментам и регионам, чтобы выявлять локальные дрейфы и стратегически важные области.
- Что делать, если MAPE очень велик для определенного SKU?
- Анализируйте причинно-связанные факторы: сезонность, аномалии продаж, качество входных данных. Возможно, потребуется переработка признаков, изменение окна обучения или отдельная модель для этого SKU. Рассмотрите разделение сегментов и использование адаптивных весов в метрике.
- Какую роль играют дрейф и аномалии в эксплуатации?
- Дрейф указывает на изменение распределения данных и может снижать качество прогноза. Важно иметь детекторы дрейфа, которые инициируют пересмотр признаков, переобучение и обновление модели. Аномалии помогают обнаружить неконсистентные данные и временно отключать прогнозы, чтобы предотвратить неверные решения.
- Какие подходы к обновлению моделей наиболее безопасны?
- Канареечное развёртывание и canary/blue-green стратегии минимизируют риск применения новой версии. Рекомендовано иметь тестовый стенд, где новая версия сравнивается с текущей по ключевым метрикам и бизнес-рискам, прежде чем развёрнуть на всей сети.
- Как обеспечить прозрачность процессов ревью?
- Введите регламенты, описание изменений и обоснований, журнал изменений, а также регулярные ревью-совещания с бизнес-аналитиками и финансовыми представителями. Документация должна быть понятной для стейкхолдеров и доступной для аудита.
- Какие инструменты подходят для мониторинга и управления версиями в крупных организациях?
- Пример подхода: Prometheus для сбора метрик и алертинга, Grafana для визуализации, MLflow для версий моделей и управление экспериментами. В рамках устойчивой архитектуры можно интегрировать Airflow или Kubeflow для оркестрации пайплайнов и автоматизации обновлений.
- Как связать метрики с бизнес-результатом?
- Соотносите показатели качества прогноза с операционными и финансовыми метриками: точность прогноза влечет за собой соответствие запасов, планирование производства и маржу. Регулярно проводите анализ влияния ошибок прогноза на издержки, стоки и обслуживание клиентов.
- Какие требования безопасности важны при эксплуатации прогноза?
- Убедитесь в наличии контроля доступа к данным и моделям, хранении метаданных о вариантах обучения, журналировании изменений и соблюдении регулятивных требований к персональным данным и финансовой информации.
- Как встраивать обновления в существующие бизнес-процессы?
- Обеспечьте тесную связь с планированием запасов и продаж; внедряйте обновления в периоды низкого операционного давления, используйте этапы проверки и согласования с бизнес-партнерами; формируйте планы по откату и регулятивные процедуры при необходимости.
- Как оценивать эффективность обновления?
- Сравнивайте новую версию с текущей по ретроспективным и текущим метрикам, анализируйте влияние на бизнес-показатели (объемы продаж, запасы, обслуживание) и проводите A/B или shadow-режимы, чтобы оценить поведение без риска для продакшена.


