

Архитектурные слои Data Mesh: домены, платформа, сервисный уровень
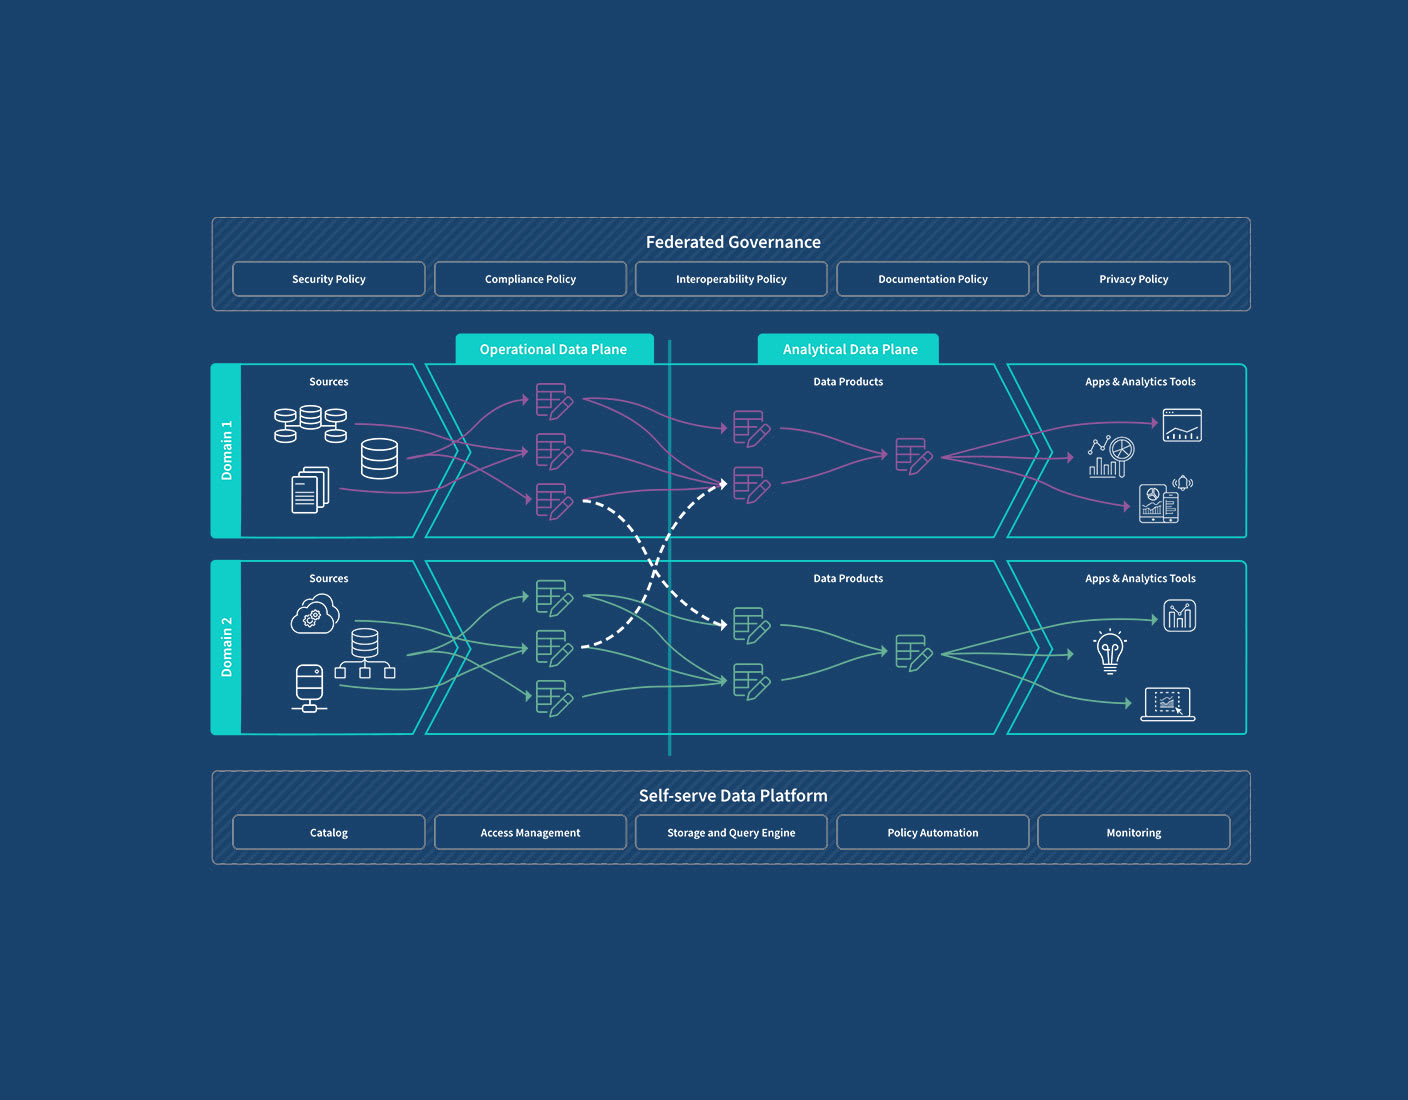
Data Mesh представляет собой не просто набор технологий, а архитектурную парадигму, в которой ответственность за данные распределена между доменными командами, поддерживается общей платформой и закреплена через сервисный уровень операционализации. В рамках этой главы разбираются три взаимосвязанных слоя: домены и их data products, платформа как сервисная инфраструктура и сервисный уровень, обеспечивающий доступ, качество, безопасность и устойчивость данных в корпорации. Цель - показать, как эти слои работают вместе: от определения границ домена до развёртывания продуктивных потоков данных в корпоративном DWH и Lakehouse через стандартизированные контракты, процессы и технологии.
Непрерывная операционализация данных требует ясной архитектуры взаимодействия между слоями. Домены отвечают за бизнес-сценарии и качество данных внутри своей области, платформа обеспечивает повторяемые сервисы, а сервисный уровень задаёт рамки контроля, обмена и мониторинга. В практике крупной организации это означает: перевод бизнес-вопросов в data products, обеспечение доступности и согласованности через контрактные интерфейсы, и прозрачную управляемость затрат, рисков и изменений.
Краткое содержание главы
- Как формируются домены и data products, какие артефакты сопровождают их жизненный цикл
- Какие сервисы и инфраструктура образуют Data Mesh Platform и как они взаимодействуют с доменами
- Как организовать операционализацию данных: контракты, безопасность, качество и наблюдаемость
- Какие протоколы и форматы данных поддерживают архитектуру Data Mesh в DWH и Lakehouse
Архитектурная модель доменов и data products
Доменная архитектура Data Mesh строится вокруг ответственности команд за конкретные бизнес-области. Каждая доменная команда отвечает за свой data product - набор данных с понятным контрактом, качественными характеристиками и жизненным циклом. Такой подход позволяет сократить зависимость от централизованного бюро данных и ускорить поставку данных в бизнес-случаи: аналитика маркетинга, финансов, операционного контроля и пр.
Data product - это не просто набор таблиц или файлов. Это контракт, который определяет:
- интерфейс потребителям: набор доступных сущностей, их имена, типы и версии.
- качество данных: требования к полноте, точности, своевременности и устойчивости к ошибкам.
- контракт обновления: версия схемы, политика эволюции, совместимость.
- управляемость и наблюдаемость: метрики доступности, времени задержек, доли ошибок.
Для иллюстрации приведём пример контрактной спецификации data product в формате JSON Schema, который описывает набор полей и требования к ним. Такой контракт обеспечивает совместимость между доменами-производителями и доменами-потребителями, а также упрощает тестирование контрактов в CI/CD.
{
  "$schema": "https://json-schema.org/draft/2020-12/schema",
  "title": "Customer",
  "type": "object",
  "properties": {
     "customer_id": {"type": "string"},
     "name": {"type": "string"},
     "email": {"type": "string", "format": "email"},
     "signup_date": {"type": "string", "format": "date-time"},
     "status": {"type": "string", "enum": ["ACTIVE","INACTIVE","SUSPENDED"]}
  },
  "required": ["customer_id","email","signup_date"]
}
Такое описание служит «мостиком» между командами: производитель может валидировать данные, потребитель - проверять данные на соответствие ожиданиям, платформа - регистрировать версии и отслеживать влияние изменений. Важной практикой является хранение контрактов в едином каталоге, с версионированием и observability-метриками по каждому data product. Разделение ответственности между доменами снижает риск монолитной зависимости и ускоряет адаптацию к изменению бизнес-требований.
Рисковые зоны и контроль: эволюция схемы и контроль версий должны быть предсказуемыми. В идеале контракт и схема имеют версию, обратная совместимость поддерживается через режимы "совместимо с предыдущей версией" или "модульная эволюция". Для это применяются тесты на совместимость изменений схем, контрактные тесты и контроль доступа на уровне контрактной платформы. Привязка контрактов к событиям и потокам (например, события Kafka или обновления в Lakehouse) обеспечивает репликацию изменений без разрушения потребляющих систем.
Глубокая связь доменов с данными в Lakehouse/DWH требует архитектурного консенсуса: домены публикуют данные в общую область хранения, но не в «слепой» общий набор таблиц. Каждый data product держит свою логическую границу, собственную схему хранения и собственные политики доступа. Платформа предоставляет кросс-доменные сервисы - каталог данных, безопасную аутентификацию и авторизацию, контроль версий и мониторинг - но не берет на себя ответственность за бизнес-правила домена. Такой подход позволяет доменам быстро адаптироваться к конъюнктуре рынка, сохраняя при этом единое корпоративное управление данными.
Важной частью концепции является обеспечение ее практической реализуемости: какие именно сервисы и артефакты делегируются доменам, а какие создаются централизованно платформой. Примерные артефакты домена включают:
- data product backlog и описание сценариев использования;
- контракт данных и спецификация схемы;
- схема хранения и политики качества;
- тесты контракта и интеграционные тесты;
- метаданные и lineage, описывающие происхождение данных и трансформации.
В рамках этого слоя критично также обеспечить непрерывную интеграцию между доменами и платформой: автоматизированные контракты, предусогласование изменений, мониторинг качества и согласованности. Практика показывает, что без прозрачной схемы контроля изменений и без согласованных правил управления версиями данные быстро теряют доверие бизнес-слоя.
Платформа Data Mesh: сервисная инфраструктура и инфраструктура
Data Mesh Platform выступает как набор повторяемых сервисов, предоставляющих доменным командам необходимую базовую инфраструктуру. Здесь формируются общие сервисы для каталогизации, качества данных, политики доступа, мониторинга и оркестрации. Эту часть архитектуры принято рассматривать как “платформенную” слоем, который обеспечивает масштабируемость и устойчивость всей экосистемы.
Ключевые компоненты Platform:
- каталог данных и гид по данным (data catalog) с поддержкой тегирования по доменам, бизнес-слоям и уровням секретности;
- регистр схем (schema registry) и поддержка форматов данных (Avro/JSON Schema/Protobuf);
- сервисы управления качеством данных: правила валидации, тесты, мониторинг и алерты;
- политика доступа и управления идентификацией: единый подход к аутентификации и авторизации, RBAC/ABAC, интеграция с корпоративной IAM;
- обмен сообщениями и потоками данных: брокеры событий (например, Apache Kafka) или другие Pub/Sub механизмы;
- оркестрация и выполнение вычислений: дата-пайплайны в рамках Data Mesh, поддерживающие как пакетные, так и стриминговые сценарии (Airflow, Prefect, Dagster);
- инфраструктура хранения и вычислений: Lakehouse, Data Lake, DWH-слой, поддержка версионирования данных и транзакционной целостности;
- observability и мониторинг: трассировка данных, lineage, KPI по задержкам, доступности и качеству, система оповещений.
Платформа должна быть «самообслуживаемой» для доменов: минимальные барьеры входа, понятные стандарты и быстрый доступ к нужным сервисам. Важным организационным фактором является построение пула реиспользуемых сервисов и шаблонов (пример: общая пайплайновая инфраструктура, набор преднастроенных коннекторов к источникам и направляющим механизмам потребления данных). Это позволяет устранить дублирование усилий и ускорить внедрение новых доменов.
Технологические примеры: для развёртывания и эксплуатации Platform можно использовать линейку решений и инструментов, которые уже доказали себя в корпоративной среде. В открытом мире это могут быть Apache Kafka в качестве слоя обмена сообщениями и Delta Lake/Apache Iceberg как слои хранения, обеспечивающие транзакционность и широкий набор возможностей для исторических запросов. В реальных условиях часть инструментов может быть внутренней разработки или адаптированной под корпоративные требования, однако принципы остаются теми же: единый каталог, единая политика доступа, единая эволюция контрактов.
С точки зрения архитектурной практики важна автономность доменов по отношению к платформенным сервисам, но и четкие интерфейсы взаимодействия. Платформа должна предоставлять:
- единый контракт для регистрации дата-продукта и его версий;
- контрактные тесты для проверки соответствия данных ожиданиям потребителей;
- метрики качества и lineage, автоматически обновляющиеся при изменениях;
- политики безопасности, применяемые к данным в рамках конкретного домена;
- механизмы обнаружения и решения конфликтов между доменами, связанных с доступом и качеством.
Если говорить об интеграции с существующими инструментами, то часто выбираются решения с открытым исходным кодом, которые хорошо поддерживаются сообществом и способны гибко адаптироваться к требованиям: например, Kafka для стриминга и Catalog/Schema Registry для контрактов; Delta Lake или Apache Iceberg для управляемой версии хранения. В корпоративной практике предпочтение отдается сочетанию открытости с гарантированной поддержкой и интеграциями в рамках собственной экосистемы.
Сервисный уровень: операционализация данных
Сервисный уровень - это совокупность практик и сервисов, которые превращают данные в управляемый продукт и обеспечивают его жизнеспособность в повседневной эксплуатации. Здесь ключевые задачи - доступ, безопасность, качество и наблюдаемость данных, а также процессы управления изменениями, инцидентами и соответствием требованиям регуляторов.
Контроли сервиса опираются на Data Product контракты: потребитель ориентируется на заранее согласованную схему и правила обработки, а платформа обеспечивает безопасный и управляемый доступ к данным. Важной парадигмой является сегментация прав доступа на уровне data product и данных внутри него, чтобы разные домены могли работать независимо друг от друга, но при этом происходила прозрачная координация в рамках общей политики.
Качество данных в сервисном слое строится вокруг нескольких слоёв:
- профилирование и мониторинг источников: определение уровня полноты, точности, задержки;
- контрактные тесты и регрессия схем: проверка совместимости новых версий данных со старым потребителями;
- мониторинг lineage и воздействий изменений: отслеживание того, как изменения в одном домене влияют другие домены и бизнес-процессы;
- управление географией хранения и регуляторикой: соответствие требованиям локализации данных, защиты персональных данных (PII) и аудиту доступа.
Безопасность и комплаенс оформляются как целостная платформа: единая модель идентификации, авторизации и аудита (IAM/Audit), политики шифрования, контроль над копированием и экспортом данных, управление ключами и секретами. Такой подход уменьшает риск нарушения нормативов, позволяет быстро внедрять новые требования по защите данных и поддерживает культуру ответственного использования данных.
Наблюдаемость - критически важный элемент. Это не просто сбор телеметрии, а системное представление о том, где данные проходят, кто ими пользуется, как изменялся их статус, и как это влияет на бизнес. Эффективная наблюдаемость строится на:
- lineage данных от источника до потребителя;
- метриках производительности и задержек;
- событиях качества и инцидентах;
- автоматических алертах и дашбортах для всех заинтересованных сторон.
Практика операционализации требует процедур, которые работают в рамках бизнес-ритмов. Это включает в себя:
- процессы принятия изменений: когда новая версия контракта считается зрелой и готовой к внедрению;
- тестовые среды для функционального и интеграционного тестирования;
- регламент деплоёв и откатов, чтобы минимизировать риск простоя;
- регламенты управления данными, чтобы обеспечить согласованность в разных доменах.
Переход к сервисному уровню часто сопровождается культурными изменениями: доменные команды должны развивать продуктовый подход к данным, а при этом сохранять стороны согласованности и прозрачности. В этом процессе критически важны обучающие программы, методики совместной работы и инструментальная поддержка в виде шаблонов, гайдлайнов и готовых конфигураций.
Интеграционные протоколы и контракты
Для эффективной интеграции между доменами и платформой необходим единый набор протоколов и форматов данных, которые позволяют автономной работе доменов сохранять согласованность на уровне всей экосистемы. Контракты данных - основа такого взаимодействия: они задают интерфейсы, стандарты и правила обработки данных между публикующим доменом и потребителем. Контракты должны быть живыми документами: версионирование, эволюция схем и тесты контрактов поддерживаются посредством CI/CD.
Типичные протоколы и подходы включают:
- обмен событиями через брокеры сообщений (например, Kafka) с семантикой событий: создание, обновление, удаление; строгие схемы и валидаторы для каждого события;
- структурированные форматы данных: Avro или JSON Schema, поддерживающие версионирование и строгие проверки;
- сервисные интерфейсы для доступа к данным, включая REST или gRPC-API, где применимо к данным как услугам;
- инструментальные средства для регистрации и обнаружения схем (schema registry) и каталогов данных (data catalog) с прозрачной привязкой к версиям контрактов;
- контрактное тестирование и интеграционные тесты, которые запускаются как часть CI/CD;
- менеджеры доступа на уровне контрактов, позволяющие определить, какие домены имеют доступ к каким данным и на каких условиях.
Интеграционные паттерны включают:
- событие-ориентированную архитектуру для потоковой передачи изменений между доменами;
- пакетное обновление наборов данных через атомарные операции и защиту от двойной записи;
- раннее обнаружение несовместимости через тесты контрактов и проверки в пайплайнах;
- централизованные политики управления доступом, но с делегированием прав до уровня data product.
Чтобы обеспечить практичность, рекомендуется упрощать взаимодействие на уровне потребителей: потребительский контракт можно «потреблять» через универсальный адаптер, который преобразует данные под нужды конкретного домена, избегая тем самым прямого тесного связывания доменов. Это снижает риск каскадных изменений и ускоряет внедрение новых Data Product без ущерба для существующих потребителей.
Примеры технологий и решений в рамках протоколов и контрактов могут включать:
- Apache Kafka в качестве транспортного слоя и конвенции по семантике событий;
- Confluent Schema Registry или аналогичные инструменты для управления схемами;
- форматы данных Avro/JSON Schema и поддержка совместимости версий;
- REST/gRPC-слои для сервисной эмуляции и доступа к данным, где эти интерфейсы необходимы.
Реализация и практические паттерны на Lakehouse и корпоративном DWH
Реализация Data Mesh в контексте Lakehouse и корпоративного DWH требует переноса концепций в конкретные паттерны архитектуры и операции. В организациях, где уже есть централизованные DWH и/или Lakehouse-архитектуры, Data Mesh предлагает добавить автономию доменов, сохранив единое управление и совместимость. Практические паттерны включают:
- Domain-first ingestion: домены публикуют данные напрямую в общую площадь хранения, используя контрактные схемы и схему эволюции. Это позволяет минимизировать задержку между бизнес-событием и доступностью данных для анализа.
- Data discovery и семантическая репрезентация: единый каталог данных с метаданными по доменам, схемам и воздействующим потребителям. Каталог служит «оригиналом истинности» по доступности и качеству данных.
- Обобщённая платформа как сервис: повторно используемые конвейеры обработки и верификации данных, которые домены могут адаптировать под свои требования, снижая издержки и ускоряя внедрение.
- Контракты как основа безопасности: доступ к данным обеспечивается через согласованные контракты, которые прописывают политики доступа, аудит и соответствие требованиям регуляторов.
- Набор стандартных сервисов для мониторинга и качества: детальная регистрируемая линейка параметров качества и наблюдаемость на уровне data product, чтобы выявлять деградацию на ранних стадиях и принимать корректирующие меры.
- Эволюция схем и тестирование: последовательная эволюция без разрушительных изменений, поддержка обратной совместимости и автоматизированные тесты контрактов и схем.
- Учет затрат и управляемость стоимостью: мониторинг использования, оптимизация хранения и вычисления, понятная калькуляция стоимости доступа к данным в рамках Data Mesh.
Пример реализации в Lakehouse может включать:
- публикацию данных доменов в Delta Lake с использованием транзакций и версионирования;
- регистрацию схем в Schema Registry и связь с данными в каталоге;
- настройку механизмов lineage: от источника до потребителя, чтобы гарантировать прозрачность происхождения данных;
- внедрение политик доступа на уровне data product и детализированных правил фильтрации и маскирования данных.
На уровне кода целевые сценарии лучше описывать конфигурациями и инфраструктурными настройками, чем длинными фрагментами логики. Например, простую конфигурацию для регистрации нового data product в каталоге можно представить как YAML/JSON-несколько строк, обозначающих домен, схему и политику доступа. В менеджменте конфигураций зачастую применяются шаблоны инфраструктуры как код (IaC), которые позволяют доменным командах разворачивать новые data products с минимальным содержанием кода и повторяемыми шагами.
Ключевые принципы реализации:
- единый контракт как центр взаимодействия между доменами и платформой;
- автономия доменов в публикации и управлении data products;
- устойчивость к изменениям и безопасная эволюция схем;
- прозрачность и наблюдаемость на уровне всего жизненного цикла данных;
- эффективная настройка доступа и аудита на уровне contracts;
- совместная работа между бизнес-единицами и IT-подразделением для достижения целей цифровой трансформации.
Key takeaways
- Data Mesh строится на трех взаимодополняющих слоях: домены и data products, платформа как набор повторяемых сервисов, сервисный уровень операционализации данных.
- Контракты данных и схемы служат мостом между автономией доменов и необходимостью единого корпоративного управления данными.
- Платформа обеспечивает повторяемые сервисы, каталогизацию, управление качеством, безопасность и наблюдаемость; домены фокусируются на бизнес-логике и ценности данных.
- Интеграционные протоколы и форматы должны поддерживать версионирование, тестирование контрактов и прозрачную эволюцию схем без нарушения потребителей.
- Операционализация включает управление доступом, качество данных, мониторинг и управление изменениями в рамках жизненного цикла data product.
- Реализация в Lakehouse/DWH достигается через domain-first ingestion, общую платформенную инфраструктуру и контрактно‑управляемые процессы.
- Внедрение требует культурных изменений: переход к продуктовой ориентации данных, обучение и наличие готовых шаблонов и конвейеров.
FAQ
- Что такое Data Mesh и зачем он нужен в корпоративных DWH и Lakehouse?
Data Mesh - это децентрализованный подход к управлению данными, который распределяет ответственность за данные между доменными командами, поддерживает их через общую платформу и закрепляет операционализацию через контрактный сервисный уровень. Он нужен для ускорения доставки данных бизнес-подразделениям, снижения тесной зависимости от централизованного бюро данных и повышения гибкости в эволюции данных в условиях больших компаний.
- Какие основные артефакты формируют data product в Data Mesh?
Data product включает контракт данных (структура и версия схемы), описание бизнес-сценариев, политики качества и доступности, требования к хранению и трансформациям, а также метаданные и lineage. Контракт данных обеспечивает совместимость потребителей и позволяет автономно развивать продукт при сохранении согласованности с платформой.
- Какую роль играет платформа в Data Mesh?
Платформа предоставляет повторяемые сервисы: каталог данных, регистр схем, управление качеством, политики доступа, оркестрацию и мониторинг. Она позволяет доменным командам сосредоточиться на бизнес-логике, сохранив единое управление и безопасность на уровне всей корпоративной экосистемы.
- Какие форматы данных и протоколы наиболее подходят для Data Mesh?
Чаще всего применяются форматы с версионированием, такие как Avro или JSON Schema, совместно с системами обмена сообщениями (например, Kafka) и устойчивыми хранениями (Delta Lake, Apache Iceberg). REST/gRPC могут использоваться для сервисно-ориентированных интерфейсов, где это необходимо для доступа к данным как услугам.
- Как обеспечить совместимость между доменами при эволюции схем?
Обеспечить это можно через версионирование контрактов, тесты совместимости, и политику эволюции схем. Регистрация версий схем и автоматизированные контрактные тесты в CI/CD помогают быстро выявлять несовместимости и управлять ими без разрыва потребителей.
- Какие практики помогают обеспечить безопасность и соответствие требованиям?
Используйте единую IAM-модель, RBAC/ABAC, аудит доступа и шифрования, управление секретами, а также политикой доступа на уровне data product. Включите требования регуляторов (PII, GDPR и т. п.) в конструкт контрактов и мониторинг соответствия.
- Как начать внедрять Data Mesh в существующую инфраструктуру DWH/Lakehouse?
Начните с определения доменов и data products, создайте начальные контракты, настройте единую платформу с каталогацией и регистром схем, внедрите базовые политики доступа и качество данных. Постепенно расширяйте набор доменов, применяйте контрактное тестирование и развивайте культуру продуктовой ответственности за данные.
- Какие риски чаще всего встречаются при переходе к Data Mesh?
Риски включают фрагментацию данных, сложности в управлении версиями схем, слабую дисциплину по контрактам и недостаточную эволюцию допуска к данным. Проблемы могут также возникать из-за несогласованности между доменами в отношении стандартов и методик качества.
- Какие примеры инструментов чаще всего применяют в Data Mesh?
Часто используют Apache Kafka для обмена сообщениями, Schema Registry для управления схемами, Delta Lake или Apache Iceberg для управляемого хранения и поддержки транзакций, а также инструменты каталога данных и оркестрации (Airflow, Dagster). Выбор зависит от специфики инфраструктуры и зрелости платформы.
- Как оценить успех внедрения Data Mesh?
Успех оценивается по времени выхода data products на рынок, снижению задержек доступа к данным, увеличению числа потребителей и качеству данных, а также по уровню соблюдения политик безопасности и затратной эффективности. Важны показатели lineage, доступности и согласованности, а также удовлетворенность бизнес-подразделений.


