

Идентичность и профили: объединение, сопоставление и дедупликация
Идентичность клиента в CDP служит мостиком между разрозненными источниками данных и единым хранилищем профилей. В потоковых сценариях задача состоит не только в том, чтобы собрать все события, но и в том, чтобы быстро и надёжно соединять их с существующими профилями, избегать дубликатов и поддерживать непрерывно обновляемый канонический вид. Эффективная реализация идентичности требует сочетания архитектурных подходов, алгоритмов сопоставления и строгих правил обработки персональных данных. Эта глава посвящена архитектуре идентичности, моделям профилей, алгоритмам дедупликации и практикам реализации в реальном времени.
Понимание идентичности подразумевает построение графа идентификаций, где узлы - это уникальные идентификаторы пользователя (канонический идентификатор), а связи - отражают принадлежащие атрибуты, привязки к устройствам и канальным идентификаторам. В реальном времени этот граф постоянно перерабатывается: новые события приводят к ре-матчингу, обновлению профилей и корректировкам связей. В основе лежит принцип: первым шагом является нормализация входных идентификаторов, вторым - определение соответствия между узлами графа, третьим - устойчивое объединение в канонический профиль с сохранением истории изменений. Важным аспектом является соблюдение принципов приватности и управляемости данных: хранение цепочек преобразований, возможность отката и аудит действий оператора.
Краткое содержание главы
- Архитектурные принципы идентичности в CDP: граф идентичности, конвейеры обработки и модели консистентности.
- Модели профилей и схемы данных: канонический профиль, атрибуты, согласование источников и правовые аспекты.
- Алгоритмы сопоставления и дедупликации: детерминированное и вероятностное сопоставление, пороговые механизмы и графовые подходы.
- Реализация в реальном времени: конвейеры, интеграции, обеспечение консистентности и управляемость данных.
- Управление качеством данных и соответствие требованиям: валидация, аудит, политика хранения и безопасность.
Архитектура идентичности в CDP
Стратегия идентичности строится вокруг нескольких взаимосвязанных слоев. На вход идут потоковые события из множества каналов: веб- и мобильные приложения, CRM, оффлайн-данные, рекламные платформы. Эти события проходят через конвейеры нормализации и обогащения атрибутами, затем попадают в сервис сопоставления и объединения идентичностей. В центре - граф идентичности, который поддерживает канонический узел и множество линков к внешним идентификаторам. Реализация может опираться на графовую базу данных или на хорошо нормализованную реляционную модель с эффективной ссылочной структурой.
Ключевые принципы:
- идемпотентность и повторяемость операций: повторное поступление того же события не должно приводить к расхождению профиля;
- поддержка streaming- и batch-сценариев: идентичность должна быть консистентной как в реальном времени, так и при периодических дампах;
- управление конфликтами атрибутов: последовательно выбирать наиболее актуальные значения и хранить историю изменений;
- прозрачная политика соответствия: хранение аудита изменений и возможность отката в случае ошибок.
Архитектурные компоненты:
- Ingestion Layer: прием потоков с унифицированными схемами идентификаторов.
- Identity Resolution Service: модуль сопоставления и дедупликации, поддерживающий детерминированные и probabilistic-правила.
- Canonical Profile Store: канонический профиль и связывающая информация.
- Link/Identity Graph: граф связей между идентификаторами и атрибутами.
- Policy and Governance Layer: правила обработки PII, хранение согласий и журнал аудита.
Ниже приводится пример схемы данных для базового канонического профиля (упрощённая JSON-структура). Это ориентир для проектирования схем и обменов между сервисами.
{
  "canonical_id": "user:abc123",
  "attributes": {
    "email": "john.doe@example.com",
    "phone": "+1-555-0100",
    "device_id": "device_xyz",
    "name": "John Doe",
    "loyalty_tier": "gold"
  },
  "links": [
    {"type": "email", "id": "john.doe@example.com"},
    {"type": "phone", "id": "+1-555-0100"},
    {"type": "device", "id": "device_xyz"}
  ],
  "score": 0.95,
  "consents": [{"type": "marketing", "granted": true, "ts": "2024-12-01T12:00:00Z"}],
  "history": [
    {"ts": "2024-11-20T10:00:00Z", "action": "merge", "from": "guest:tmp1"}
  ]
}
Дедупликация и объединение в реальном времени требуют минимизации задержек и обеспечения устойчивости к частичным данным. В архитектуре целесообразно внедрять go-low-latency очереди между Identity Resolution Service и Canonical Profile Store, поддерживающую exactly-once semantics. Для гарантий консистентности в рамках распределённой архитектуры применяются подходы типа транзакций на уровне приложения, idempotent-операций и схемы снапшотов профилей на заданные интервалы.
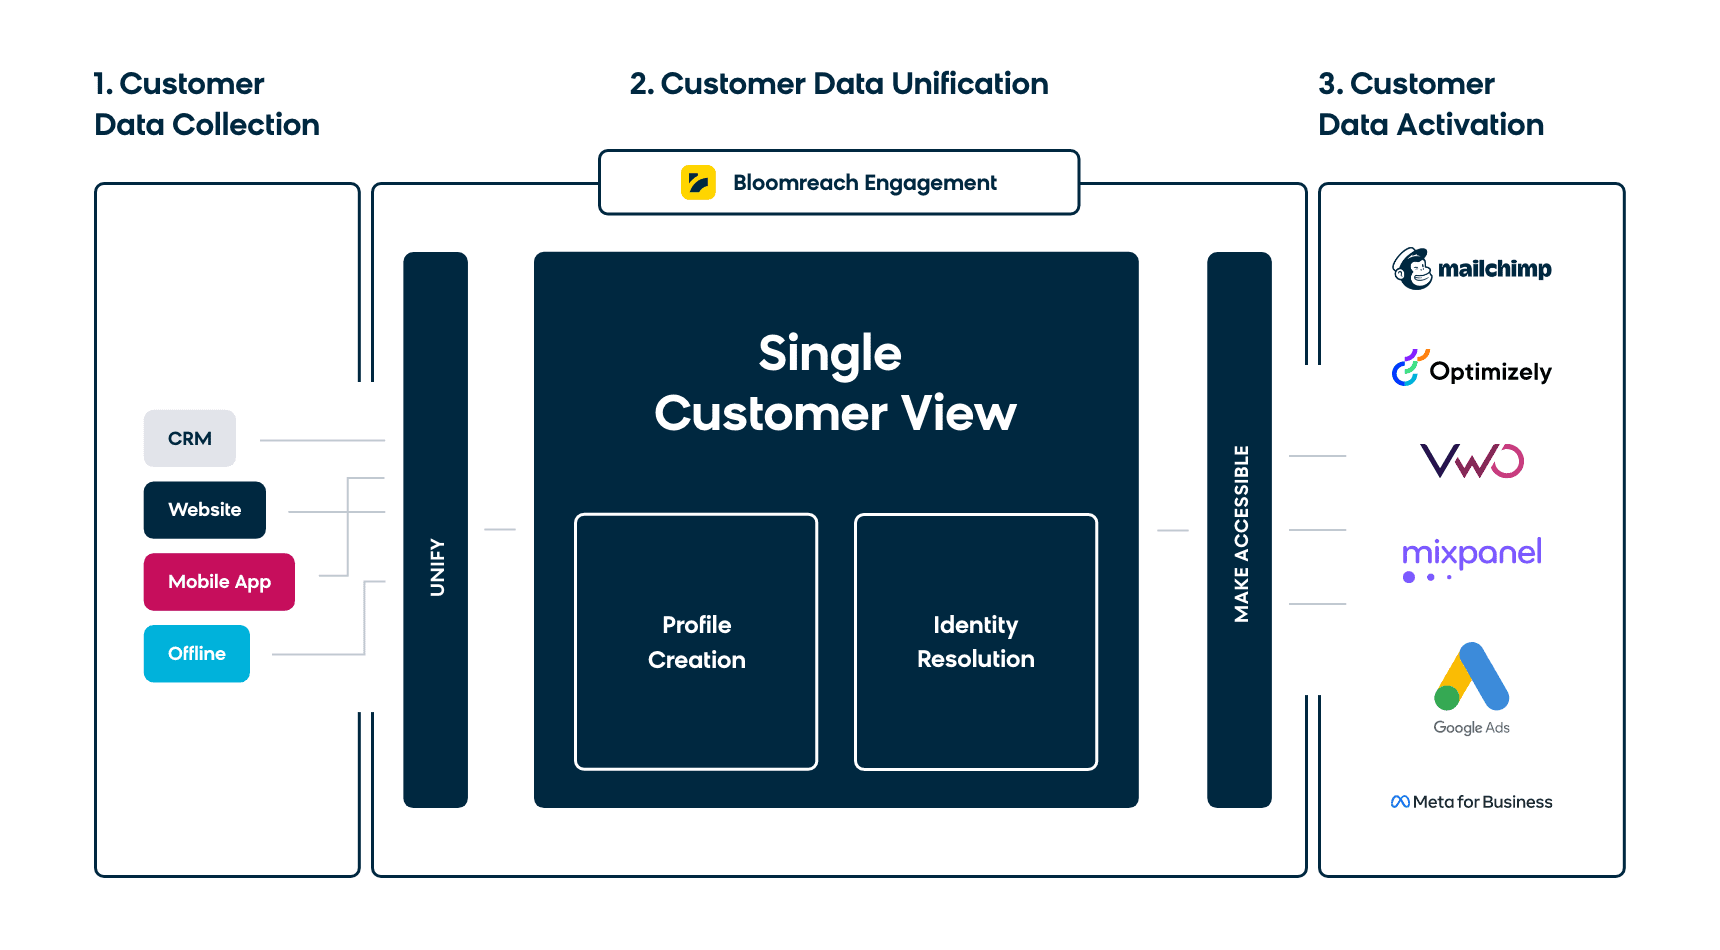
Модели профилей и схемы данных
Профиль клиента в CDP представляет собой совокупность атрибутов, связанных идентификаторами: канонический идентификатор, внешние линкеры (email, телефон, устройства), а также контекст поведения и согласия на обработку данных. Важна ясная отделённость между "каноническим" профилем и временными источниками информации. Канонический профиль - это единая точка принятия решений о персонализации и сегментации, а источники данных - “истории” атрибутов, которые дополняют и обновляют этот профиль.
Ключевые элементы модели:
- канонический профиль: устойчивый узел, к которому привязаны все внешние идентификаторы;
- атрибуты профиля: демография, поведенческие признаки, предпочтения, статус лояльности, приватные данные;
- контекст согласий: в каких случаях и какие данные доступны для обработки;
- история атрибутов: хронология изменений, что позволяет восстанавливать моментальные состояния и проводить ретроспективный анализ;
- связь между идентификаторами: графовые ребра, которые показывают, что два внешних идентификатора принадлежат одному и тому же каноническому пользователю.
Схемы должны быть достаточными для оперативного использования в реальном времени, но при этом гибкими - для адаптации под новые источники идентификаторов. Практикуемая модель часто строится на трёх слоях:
- слой входных идентификаторов: чистые, нормализованные значения идентификаторов;
- слой сопоставления: правила детерминированного и вероятностного сопоставления между идентификаторами;
- слой канонического профиля: объединение атрибутов, управление версиями и истории.
Управление версиями атрибутов и атрибутными источниками критически важно: при изменении атрибута важно сохранять контекст происхождения и способность отката. В этом смысле целесообразно хранить "историю свойств" с привязкой к временным штампам и источникам.
Алгоритмы нормализации идентификаторов играют важную роль. Нормализация включает очистку, приведение к унифицированным форматам (например, нормализация телефонов и email-форматов), устранение вариантов написания и привязку к существующим линкерам. Хорошо работают правила трансформации, устойчивые к ошибкам ввода и региональным особенностям.
Алгоритмы сопоставления и дедупликации
Сопоставление идентичностей в CDP строится на двух базовых режимах: детерминированном и вероятностном. Детерминированное сопоставление опирается на строгие правила: совпадение по одному или нескольким уникальным атрибутам (например, одно и то же зафиксированное значение email+phone). Вероятностное сопоставление оценивает вероятность того, что два идентификатора относятся к одному пользователю, на основе множества атрибутов и статистических моделей.
Ключевые принципы:
- детерминированное соответствие обеспечивает высочайшее доверие в случаях с однозначными ключами;
- вероятностное сопоставление требуется там, где данные фрагментированы, неполны или имеют неоднозначности;
- пороги и веса атрибутов должны быть адаптивны: они зависят от источника, доверия к данным и бизнес-правил;
- графовый подход позволяет аккуратно объединять несколько узлов и распадать связи в случае ошибок.
Типовая архитектура сопоставления:
- нормализация входных идентификаторов;
- локальное сопоставление внутри потока (мини-объединение узлов);
- кластеризация и формирование кандидататов для канонического профиля;
- вычисление и обновление скоринговых значений;
- обновление графа и профиля в хранилище.
Графовые подходы являются мощным инструментом для объединения разнотипных источников. Они позволяют учитывать сложные отношения между идентификаторами и атрибутами, включая устройства, аккаунты и каналы, а также хранить историю связей и изменений. При реализации следует учитывать потребности в масштабируемости и задержках: графовые операции должны поддерживаться как в реальном времени, так и в пакетной обработке.
Пример простого алгоритма детерминированного сопоставления (описатель, без избыточности кода):
- если существуют идентификаторы a и b, где a.email совпадает с b.email, и оба имеют действительно валидированные значения email, то считать их связанными;
- если a.phone и b.phone совпадают после нормализации (удаление кодов страны, форматирование), и оба принадлежат к одному региону, считать связанными;
- если нет явного совпадения, но есть перекрёстывание других атрибутов (например, один и тот же device_id или общие адреса и имена), формировать кандидатуру для вероятностного сопоставления и вычислять скоринг.
Пороговые значения для строгого сопоставления должны подбираться эмпирически, с учётом качества источников и требований к персонализации. В рамках CDP целесообразно поддерживать несколько режимов: мягкое сопоставление для маркетинговых сценариев и жёсткое для сегментаций, где необходима высокая точность.
## Пример упрощенного алгоритма вероятного сопоставления
def score_match(a, b):
    score = 0
    if normalize_email(a.email) == normalize_email(b.email):
        score += 0.5
    if normalize_phone(a.phone) == normalize_phone(b.phone):
        score += 0.3
    if a.name and b.name and similar(a.name, b.name):
        score += 0.1
    if a.device_id and b.device_id and a.device_id == b.device_id:
        score += 0.2
    return score

def is_match(a, b, threshold=0.6):
    return score_match(a, b) >= threshold
Также применяются продвинутые методы графовой агрегации и поиск связей через методы общих соседей, линов между идентификаторами и атрибутами, риск-скоринг по качеству данных. В реальном мире полезно комбинировать два подхода: deterministic rules для надёжных случаев и probabilistic для зон со слабой идентификацией. Важно обеспечить сохранение истории связей и возможность аудита изменений графа идентичности.
Реализация в реальном времени: конвейеры и интеграции
Чтобы поддерживать актуальность канонического профиля, конвейер идентичности должен обрабатывать входящие события с минимальной задержкой и устойчивостью к задержкам источников. Основные принципы реализации в реальном времени:
- потоковая обработка: входные события обрабатываются по ключу идентификации, что позволяет «привязать» событие к каноническому профилю немедленно;
- upsert-операции в профиле: обновление канонического профиля и графа происходит через атомарные операции вставки/обновления;
- обработка поздних событий: предусмотрены механизмы возврата изменений и корректировки профиля при получении событий с задержкой;
- exactly-once semantics по критериям идемпотентности и журналированию действий;
- интеграции с источниками: CRM, веб- и мобильные приложения, рекламные платформы, оффлайн источники - все они подключаются через коннекторы и адаптеры, поддерживающие единый формат идентификаторов.
Типовые конвейеры включают:
- Ingestion Layer → Normalization → Identity Resolution → Canonical Profile Store → Identity Graph → downstream systems (segmentation, personalization, analytics).
- В дополнение к реальному времени используются пакетные этапы (batch reconciliation) для очистки графа и обновления профилей на заданной периодичности.
Технологические подходы и примеры интеграций:
- Соединение с брокером сообщений (Kafka, Kinesis) обеспечивает устойчивый поток событий и повторную обработку при сбоях.
- Использование форматов данных JSON/Avro для гибкости и совместимости между компонентами.
- Хранилище профилей может быть реализовано как графовая база данных (например, Neo4j) или как масштабируемая реляционная/NoSQL система с хорошо разработанными индексами для идентификаторов и атрибутов.
- Поддержка сценариев приватности: хранение консентных атрибутов и режимов обработки, возможность блокировки определённых атрибутов для персональных запросов.
Особо стоит отметить обработку поздних событий (late events) и конфликты между обновлениями атрибутов. В реальном времени важно иметь стратегию версионирования профилей: каждое изменение должно сопровождаться временной меткой и источником. Это позволяет реконструировать состояние профиля на любой момент времени и корректировать решения персонализации, если требуется.
Примеры интеграций и протоколов:
- интеграция с веб- и мобильными источниками через единый event формат (напр., EventBridge или Kafka темплейты);
- подключение к CRM-системам через адаптеры, обеспечивающие нормализацию ключевых идентификаторов;
- настройка пайплайна с протоколами безопасности и управления доступом (SASL/OAuth2) и безопасной передачей данных.
## Пример upsert-операции в профиле (упрощённо)
## MERGE INTO profiles AS p
USING (SELECT canonical_id, attributes FROM new_identities) AS n
ON p.canonical_id = n.canonical_id
## WHEN MATCHED THEN
  UPDATE SET p.attributes = merge_attributes(p.attributes, n.attributes),
             p.last_updated = CURRENT_TIMESTAMP
## WHEN NOT MATCHED THEN
## INSERT (canonical_id, attributes, last_updated)
  VALUES (n.canonical_id, n.attributes, CURRENT_TIMESTAMP);
С точки зрения проектирования API и контрактов между сервисами, рекомендуется:
- определять четкий формат идентификаторов и единый набор атрибутов, которые считаются «ключевыми» для сопоставления;
- внедрять согласование источников и механизм версионирования атрибутов;
- стандартизировать обработку ошибок и управление задержками, чтобы поддерживать предсказуемость поведения конвейера.
Управление качеством данных и соответствие требованиям
Качество данных в контексте идентичности означает точность, полноту и непротиворечивость атрибутов, а также корректность связей в графе. В CDP эти требования усиливаются за счёт потоковой природы данных и необходимости поддерживать персональные данные в соответствии с требованиями регуляторов.
Практики обеспечения качества:
- валидация входящих идентификаторов и атрибутов по формату и диапазону;
- нормализация данных: единый формат email, унифицированный формат телефонов, привязка к регионам;
- дедупликация и кросс-источник консолидации с учётом веса источников;
- аудит и журнал изменений: хранение истории операций, источников и причин изменений;
- мониторинг и сигнализация: пороги сбоев, задержек и уровня качества данных;
- управление консентами: явное хранение согласий и их сроков действия, автоматическое исключение данных при отзыве согласия.
Развитие процессов управления идентичностью тесно связано с организационными изменениями. Эффективная реализация требует согласования между командами по данным, продукту и безопасности. Внедрению подвержены следующие практики:
- определение ответственных за качество и консент: владельцы профилей и политики;
- регулярные аудиты схем данных и их соответствия требованиям;
- документирование бизнес-правил сопоставления и процедур разрешения конфликтов;
- обеспечение обучающих программ для команд по правильному использованию идентичности и обработке персональных данных.
Key takeaways
- Идентичность в CDP строится на каноническом профиле и графе идентификаторов, обеспечивая единый вид клиента в потоке событий.
- Детерминированное и вероятностное сопоставление должны работать совместно: детерминированное - для надёжных случаев; вероятностное - для неполных данных.
- Реализация в реальном времени требует устойчивого конвейера, exactly-once семантики и обработки поздних событий.
- Архитектура должна обеспечивать историю изменений, аудит и возможность отката профилей.
- Безопасность и соответствие требованиям - неотъемлемая часть дизайна: консенты, регуляторные требования, аудит и контроль доступа.
- Графовые подходы дают мощный инструментарий для объединения множества идентификаторов и атрибутов без потери гибкости.
- Интеграции с источниками и протоколами должны быть построены на единых форматах данных, обеспечении совместимости и надёжности.
FAQ
- Что такое канонический профиль и зачем он нужен в CDP?
Канонический профиль - это единая, устойчиво поддерживаемая сущность клиента, к которой привязаны все внешние идентификаторы и атрибуты. Он позволяет единообразно проводить персонализацию, сегментацию и анализ поведения, независимо от того, через какие каналы пришёл пользователь. Канонический профиль служит источником истины для downstream-систем и обеспечивает согласованность данных во времени.
- Какие типы сопоставления применяются в идентичности?
Используются детерминированное сопоставление (правила, где однозначно совпадают ключевые атрибуты, например email) и вероятностное сопоставление (оценка сходства на основе нескольких атрибутов и статистических моделей). Комбинация позволяет достигать высокой точности в условиях различной полноты данных.
- Как обрабатываются поздние события в реальном времени?
Поздние события обрабатываются через механизмы «late event handling»: повторное сопоставление, корректировка профиля и запись новой версии атрибутов. Важна версия профиля и хранение временных меток изменения, чтобы можно было восстановить состояние профиля на любой момент.
- Какие данные должны быть в атрибутах профиля?
В атрибутах профиля лежат идентификаторы (email, телефон, device_id), демографические и поведенческие признаки, статус лояльности, согласия на обработку данных и контекст взаимодействия. Важно разделять канонические атрибуты и временные источники, чтобы сохранять прозрачность происхождения данных.
- Какие архитектурные паттерны предпочтительны для масштабирования?
Рекомендуются конвейеры с разделением фаз: ingestion, normalization, resolution, storage. Использование графовой базы или хорошо индексированной схемы, поддержка stream-processing и batch reconciliation. Важны горизонтальная масштабируемость, idempotent-операции и Exactly-Once semantics.
- Как обеспечить приватность и соответствие требованиям?
Внедряются политики согласия, хранение только необходимых атрибутов, логирование доступов, аудит изменений и возможность удаления или анонимизации данных по запросу. Привязка идентичности к правовым требованиям и соблюдение принципов privacy-by-design являются обязательной частью архитектуры.
- Как измерять качество идентичности?
Ключевые метрики: доля совпадений по ключевым атрибутам, точность детерминированного сопоставления, полнота профиля, задержка обработки, частота конфликтов атрибутов, процент late events, аудит и количество откатов.
- Какие существуют паттерны контроля версий профиля?
Каждое изменение профиля фиксируется с временной меткой, источником и причиной. Восстановление состояния профиля на заданную дату проводится через снапшот-версионирование, что упрощает ретроспективный анализ и корректировку персонализации.
- Какие ошибки чаще всего возникают в идентичности и как их избегать?
Частые проблемы - неполные источники, несогласованные форматы идентификаторов, задержки событий и неправильные пороги сопоставления. Чтобы минимизировать риски, применяются проверки качества на каждой стадии конвейера, аудит изменений и регулярная калибровка правил сопоставления на основе обратной связи.
- Что наиболее критично для успешной реализации идентичности в CDP?
Ключевые факторы - четко сформулированная политика доступа и согласий, единый формат идентификаторов, надёжный конвейер обработки событий, и графовая модель, которая позволяет эффективно связывать множество идентификаторов. В сочетании с практиками качественного управления данными это обеспечивает точную персонализацию и устойчивую аналитику в реальном времени.


