

Идентификация и сопоставление пользователей: identity resolution
Идентификация и сопоставление пользователей лежат в основе единого профиля клиента в CDP. Глобальная цель - связать различные цифровые и офлайн-идентификаторы в единую картину поведения и предпочтений, чтобы маркетинг и продажи могли работать с точным, унифицированным профилем в реальном времени. В рамках продуктового подхода это значит рассматривать identity resolution как набор взаимосвязанных компонентов: от сборки идентификаторов до правила сопоставления, хранения и управления разрешениями на использование данных. Правильная реализация обеспечивает не только точность объединения, но и прозрачность операций, соблюдение регуляторных требований и устойчивость систем к обновлениям источников данных.
Identity resolution - это не единичный алгоритм, а конструктор для создания устойчивой идентичности клиента в рамках CDP. Он должен поддерживать многоканальные сигналы, динамически обновлять граф идентификаторов, обеспечивать соответствие бизнес-правилам и позволять оперативно внедрять новые источники данных. В продуктовом контексте особенно важно фокусироваться на пользовательском опыте: какие конфигурации доступны маркетологам и продавцам, как быстро можно развернуть новое подключение источников, какие политики конфиденциальности применяются к различным сегментам аудитории и какие показатели качества идентификации применяются для мониторинга эффективности.
- Краткое содержание главы
- Что такое identity resolution в рамках CDP и почему он критичен для сегментации и персонализации.
- Архитектура identity resolution как составной части продукта CDP: ключевые компоненты, потоки данных, интеграции и модель хранения.
- Алгоритмы сопоставления: детерминированное и вероятностное сопоставление, правила качества и управление конфликтами.
- Интеграции данных и источники: как собрать идентификаторы из онлайн и офлайн источников, как обрабатывать потоковую и батчевую загрузку.
- Управление качеством, приватность, соответствие требованиям: governance, защита данных, согласие пользователя, аудит и прозрачность.
- Практические сценарии внедрения и измерения эффективности: пилоты, масштабы, KPI и организация команд.
Что такое identity resolution в рамках CDP
Identity resolution представляет собой процесс объединения разрозненных идентификаторов, связанных с конкретным пользователем, в единый canonical identity. В CDP это позволяет преобразовать неструктурированные или частично идентифицированные данные в единый профиль, на котором могут работать сегментация, персонализация и атрибуция. В продуктовом контексте ключевые концепты включают:
- Идентификаторы: уникальные признаки пользователя** - cookies, мобильные токены, email, номера телефонов, идентификаторы приложений, офлайн-карты лояльности и т. д. Важно различать идентификаторы, привязанные к устройствам, сессиям и людям.
- Canonical identity: устойчивый, перекрестно-канальный идентификатор, который становится «одной истинной» точкой сопоставления внутри CDP.
- Identity graph: графовая модель, где вершины** - идентификаторы, а рёбра - связи между ними; граф показывает, какие источники относятся к одному клиенту.
- Deterministic vs probabilistic сопоставление: детерминированное совпадение основывается на явных связях (одинаковые email, номер телефона и т. п.), вероятностное - на сочетании признаков и сигнала доверия, когда прямой связи недостаточно.
- Контроль данных и соответствие: политика использования идентификаторов, согласие пользователя, минимизация данных, аудит и ретри‑возможности.
Эта глава ориентирована на продуктовый подход: какие компоненты нужно иметь в CDP, какие сценарии внедрения позволяют быстро запускать и масштабировать identity resolution, какие метрики и governance процедуры необходимы для поддержания качества и доверия.
Архитектура решения: сущности, потоки и микросервисы
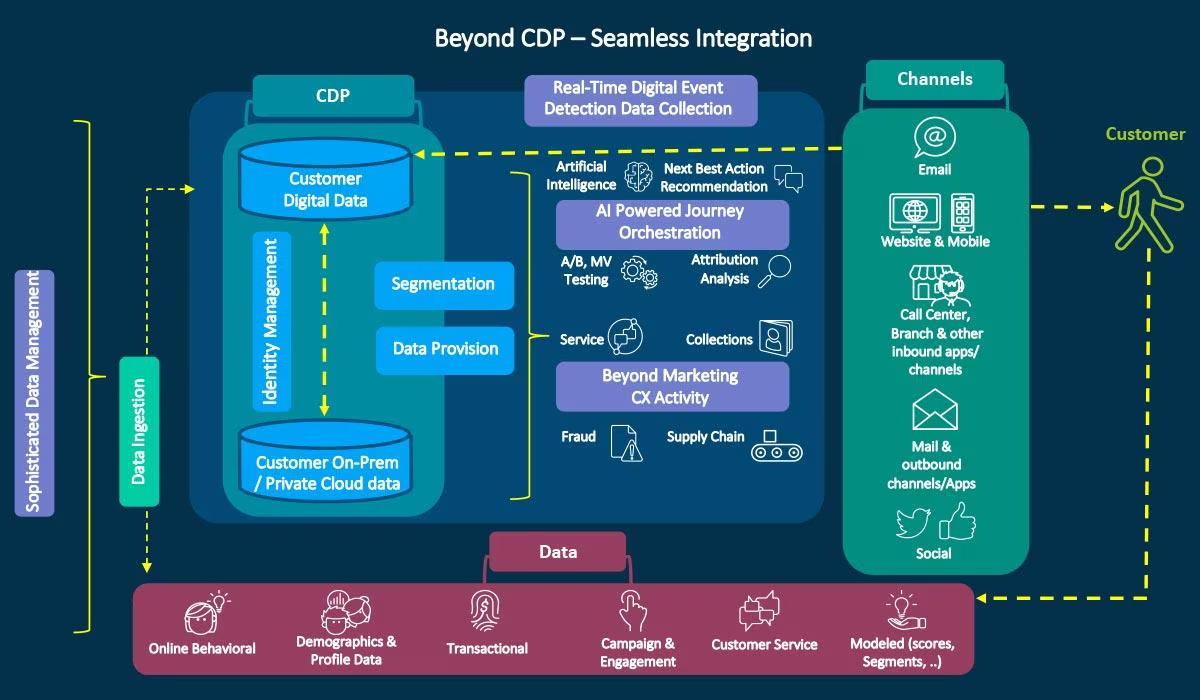
Архитектура identity resolution в CDP строится вокруг трех слоев: источники и сбор данных, ядро разрешения идентичности и слой использования готового профиля в целях сегментации и персонализации. В продуктовой реалии это означает наличие понятной модульной картины, четких контрактов между сервисами и возможности расширения без разрушения текущего функционала.
- Источники идентификаторов: веб- и мобильные трекеры, CRM, SPID- и ERP-системы, офлайн продажи, программы лояльности, call-center данные и платформа рекламы. Каждый источник имеет свои форматы, частоты обновления и требования к качеству данных.
- Интеграционная платформа: коннекторы для синхронизации данных в реальном времени и по расписанию, нормализация данных, управление схемами идентификаторов, обработка ошибок и ретривал данных.
- Ядро identity resolution: граф идентификаторов, механизм сопоставления, правила бизнес-логики, хранение canonical identity, механизмы эволюции графа при добавлении новых источников и изменений в политике конфиденциальности.
- Сервис использования профиля: сегментация, персонализация, Recommendation Systems, управление consent и privacy preferences, API-слой для всех потребителей внутри маркетинга и продаж.
- Governance и безопасность: управление доступами, аудит операций, контроль версий правил сопоставления, мониторинг аномалий и регуляторные отчеты.
Важнейшее преимущество продуктового подхода - возможность наглядно показать и управлять связями между идентификаторами, а также гибко адаптировать правила сопоставления под требования бизнеса. Архитектура должна поддерживать как потоковую обработку для реального времени (например, с оповещениями и автоматизированными триггерами), так и пакетную обработку для глубокой калибровки и ретроактивной коррекции профилей.
- Реализация и интеграции требуют четких контрактов: формат данных, версии схем, правила именования идентификаторов, политики хранения и правила кэширования.
- Для масштабируемости следует применять event-driven подход: события добавления нового идентификатора, обновления атрибутивной информации, триггеры на обновление canonical identity и синхронизацию с внешними системами.
- Архитектура должна учитывать privacy-by-design: встроенные механизмы обработки согласий, ограничение доступа к PII, однако позволяющие маркетинговым сценариям активировать персонализацию в рамках разрешенного объема данных.
Алгоритмы сопоставления: правила, качество и управление конфликтами
Алгоритмы identity resolution в CDP опираются на сочетание детерминированного и вероятностного подходов. В продуктовой постановке ключевые вопросы - какие признаки считать достаточными для «соответствия», как настраивать доверие к сопоставлениям и как оперативно реагировать на противоречивые сигналы.
- Детеминсированное сопоставление: опирается на явные совпадения идентификаторов (один и тот же email, номер телефона и т. п.). Это самый надёжный слой, но часто ограничен по охвату, особенно в онлайн-каналах и в новых источниках данных.
- Вероятностное сопоставление: использует набор признаков** - география, поведенческие сигналы, устройство, временные паттерны, контекст взаимодействия - и выносит вероятность того, что два идентификатора относятся к одному пользователю. Решающими здесь являются вероятностные пороги и калибровка модели под бизнес-требования.
- Правила качества и пороги: бизнес-правила устанавливают минимальный порог сопоставления, при котором идентификаторы считаются связанными. Важно иметь гибкость по сценарию: повышенный порог для критических сегментов, снижение порога для широких кампаний с умеренным риском перекрестной сегментации.
- Конфликты и разрешения: иногда разные источники дают конфликтующую информацию. Принципы разрешения могут включать приоритет источника, логику временного веса признаков, или доверительную иерархию: источник с более высоким качеством считается более надежным.
- Эволюция графа идентификаторов: после каждого сопоставления граф обновляется. Важна возможность отката операций, ретреконструкция графа и проведение ретроактивной чистки для устранения ошибок и ошибок старых данных.
- Мониторинг и аудит: регулярная проверка точности, trackability изменений и доли совпадений по каналам. В продукте это позволяет маркетологам видеть реальный эффект от улучшений идентификации на точность сегментации и эффективность кампаний.
Алгоритмически оптимальная реализация требует сочетания платных и открытых методов: детерминированные наборы правил для критичных сценариев и обучаемые модели для более «серой» зоны, где данные неполные или шумные. Важной частью является контекстная настройка - различные сегменты аудиторий и разные цели кампании требуют отдельных порогов, политик и бизнес-правил.
Интеграции данных и источники: данные в реальном времени и батчевые
Ключ к устойчивой identity resolution - возможность собирать идентификаторы из множества источников и приводить их к единому canonical identity без потери качества. В продуктовой практике следует рассматривать две параллельные ветви обработки: потоковую (реального времени) и пакетную (ретропереработку и калибровку).
- Онлайн-источники: веб- и мобильные приложения, клиентские порталы, виджеты, чат-боты. Здесь доминируют события в реальном времени: входы, клики, покупки, обновления профиля. Важна скорость обработки и минимальная задержка обновления профиля.
- Офлайн-источники: POS-терминалы, CRM, сервисные центры, программы лояльности. Эти данные часто требуют консолидированной загрузки в батчевом режиме, с последующей коррекцией canonical identity и ретривалами для онлайн-сервисов.
- Внешние источники: платформы рекламы, DSP, data-management platforms (DMP), партнёры. В этом случае нужен устойчивый контракт данных, понятные политики атрибутивной связи и согласования использования данных в рекламных сценариях.
- Обработка потоков и батчей: реальное время поддерживает оперативное изменение профиля и мгновенную персонализацию, в то время как батчевые процессы позволяют глубже верифицировать сопоставления, проводить ретроспективную корректировку и поддерживать длительный аудит соответствий.
- Нормализация и сопоставление: в процессе интеграции различаются форматы идентификаторов и правила нормализации. Необходимо обеспечить единообразие на уровне схем, версий идентификаторов, правил валидации и агрегирования сигналов по каналам.
- Управление качеством и чисткой: постоянная проверка на дубликаты, пропуски, несоответствия и конфликтные сигналы. В рамках продукта это включает автоматические конвейеры очистки и механизмы ручной коррекции через доверительные бизнес-процессы.
Особое внимание уделяется приватности и соответствию: согласия и предпочтения пользователя должны быть агрегированы и применяться на уровне каждого источника, а также учитываться в общих правилах сопоставления. В современных CDP требуются гибкие механизмы динамического обновления политик по согласиям в зависимости от региональных требований и контракты на обработку персональных данных.
Управление качеством, приватность и соответствие требованиям
Эффективная identity resolution невозможна без прочной основы governance и прозрачности операций. В продуктовой парадигме это означает:
- Контроль доступа и аудит: кто имеет право видеть или менять каналы идентификации, какие правила сопоставления применяются и какие изменения внесены в canonical identity. Важно обеспечить полную прослеживаемость изменений и возможность отката.
- Управление согласием: хранение версий согласий по каждому пользователю, автоматическое применение ограничений на основе согласий, поддержка сценариев отзыва согласия и удаления данных.
- Защита данных и минимизация: при обработке идентификаторов применяется принцип минимизации данных и защиту PII. Политики шифрования, разделение данных по слоям и безопасный доступ к идентификаторам внутри инфраструктуры.
- Соответствие требованиям регионов: регламентированные требования по GDPR, CCPA, РФ ФЗ-152 и другие фрагменты законодательства. В CDP необходимо иметь шаблоны политик, адаптируемые под региональные правила и бизнес-требования.
- Данные качества и мониторинг: метрики точности сопоставления, доля дубликатов, скорость обновления canonical identity, задержки в обработке потоков, коэффициент согласования между источниками. Рекомендовано внедрять дашборды для маркетинга, юридического отдела и инженеринга.
- Этические принципы и прозрачность для пользователей: предоставление возможностей пользователю видеть, какие данные о нём используются, почему и как. Встраивание механизмов запросов на исправление и обновление данных.
Эти аспекты обеспечивают не только соблюдение законодательства, но и доверие к CDP как к источнику данных для персонализированных коммуникаций. В продуктовом контексте governance не должна восприниматься как ограничения - она должна быть встроенным средством снижения рисков и повышения качества персонализации.
Внедрение и эксплуатация: сценарии внедрения и KPI
Успешная реализация identity resolution требует планирования по стадиям внедрения, соответствия требованиям и быстрому получению бизнес-результатов. Практические сценарии включают:
- Пилотные проекты: ограниченная группа источников и каналы, контроль над качеством данных и точностью сопоставления. На этапе пилота важно зафиксировать бизнес-правила, определить пороги доверия и собрать начальные показатели точности.
- Поэтапное расширение: добавление новых источников идентификаторов, расширение графа идентификаторов, расширение использования canonical identity в сегментации и персонализации. Важна поддержка модульной интеграции и обратной совместимости.
- Масштабирование в реальном времени: внедрение потоковой обработки, обработка больших объемов событий, обеспечение низкой задержки и детерминированной консистентности графа. В этом сценарии критичны устойчивость сервисов и мониторинг задержек.
- Операционная эксплуатация: регламент обновления правил сопоставления, периодический аудит и обновление моделей, управление версиями графа и откат изменений. Включение команд data engineering, marketing и legal в совместные рабочие процессы.
- KPI и бизнес-эффекты: точность сопоставления (match rate и accuracy), охват аудитории (cross-device coverage), скорость обновления профилей, качество сегментации, CTR и конверсия по персонализированным кампаниям, показатель согласования с согласиями пользователя.
Важно помнить: identity resolution - это не технический инструмент ради самого инструмента. Это стратегический элемент, который напрямую влияет на качество сегментации, точность персонализации и соответствие регуляторным требованиям. Эффективная организация команды и процессов вокруг identity resolution повышает скорость внедрения новых источников, улучшает качество данных и снижает риск ошибок в коммуникациях с клиентами.
Key takeaways
- Identity resolution объединяет разрезанные идентификаторы в единую canonical identity через граф идентификаторов, обеспечивая единый профиль клиента для всех каналов.
- В продуктовой архитектуре CDP identity resolution состоит из источников идентификаторов, ядра сопоставления и слоя использования профиля, с фокусом на модульность, контрактные интерфейсы и безопасность.
- Детерминированное и вероятностное сопоставление работают в тандеме: детерминированные сигналы дают уверенность, вероятностные - охват и адаптивность к новым источникам.
- Интеграция онлайн и офлайн источников требует планирования потоковой и пакетной обработки, нормализации данных, управления качеством и соблюдения согласий и регуляторных требований.
- Governance, безопасность и конфиденциальность являются не ограничениями, а основой доверия к данным и эффективной персонализации.
- Внедрение должно быть управляемым и постепенным: пилоты -> расширение -> масштабирование в реальном времени с четкими KPI.
- Эффективная identity resolution повышает точность сегментации, ускоряет время выхода персонализированных кампаний и улучшает атрибуцию маркетинговых и коммерческих действий.
FAQ
- Что такое canonical identity и зачем она нужна в CDP?
Canonical identity - это единый, устойчивый идентификатор клиента, который связывает все источники идентификаторов в рамках CDP. Он обеспечивает консистентность профиля при изменении устройств, каналов и источников данных. Наличие canonical identity упрощает сегментацию, персонализацию и атрибуцию, так как все сигналы сопоставляются с одним «якорем» вместо разбросанных и противоречивых идентификаторов.
- Как различаются детерминированное и вероятностное сопоставление в практическом использовании?
Детерминированное сопоставление опирается на явные совпадения между идентификаторами (одинаковые email, телефон и т. п.) и даёт наивысшую точность. Вероятностное сопоставление применимо, когда явных связей недостаточно; здесь учитываются поведенческие сигналы, временные паттерны, контекст взаимодействия и прочие признаки. В современных CDP обе методологии применяются в разных сценариях, с динамическим выбором порогов и верификацией результатов.
- Какие источники данных требуют особого внимания к качеству идентификации?
Источники, которые часто приходят без полной идентификационной информации, требуют большего внимания: мобильные приложения с неполной идентификацией, офлайн-каналы без прямых идентификаторов и новые партнерские источники. Для таких случаев критична гибкая настройка правил сопоставления и поддержка вероятностного слоя, а также мониторинг точности по каналам.
- Какие KPI применяются для оценки эффективности identity resolution?
Ключевые KPI включают долю совпадений (match rate), точность сопоставления (accuracy), охват cross-device, задержку обновления профиля, долю дубликатов, а также влияние на показатели кампейнов - CTR, конверсию и ROI персонализированных коммуникаций.
- Какие регуляторные требования влияют на identity resolution?
Основные направления - обработка PII, согласие пользователя, возможность отзыва согласия и право на удаление данных. Необходимо поддерживать аудит согласий, аудит действий по идентификаторам, защиту данных и соответствие региональным законам (GDPR, CCPA, национальные регуляторы). В рамках российской практики - требования к локализации данных, управления доступами и аудитам операций.
- Какой режим развертывания подходит для Identity Resolution?
Наилучший подход - модульное развертывание с пилотами и поэтапным расширением. Это позволяет проверить работу нового коннектора или источника, скорректировать правила экспериментов и минимизировать риски. В реальном времени важна устойчивость архитектуры к пиковым нагрузкам и мониторинг задержек, тогда как для ретроактивной корректировки необходимы батчевые конвейеры и возможность отката изменений.
- Какие ограничения и риски следует учитывать при внедрении?
Риски включают неверное сопоставление, перегрузку графа идентификаторов, нарушение согласий и регуляторных ограничений, а также сложности в обеспечении консистентности между онлайн- и офлайн-данными. Важно заранее определить пороги доверия, обеспечить роль-based доступ и иметь планы на откат изменений, чтобы снизить риск ошибок в коммуникациях с клиентами.
- Какие технологические решения часто применяются в open-source или российской экосистеме?
Для практической реализации можно рассмотреть две примеры: open-source решения для управления идентификатором и графами идентификаторов, а также локальные инструменты для обработки данных и управления согласиями. В рамках ограничений по количеству примеров следует упоминать лишь те инструменты, которые действительно усиливают смысл и соответствуют требованиям проекта.
- Как начать проект identity resolution в рамках CDP?
Начать стоит с определения целевых источников данных, форматов идентификаторов и политики согласия. Затем разработать план внедрения по этапам, определить KPI и начать с пилотного проекта, чтобы собрать данные по точности сопоставления и влиянию на сегментацию. После успешного этапа пилотирования - масштабировать на новые источники и каналы, обеспечивая governance и безопасность на каждом шагу.
- Как обеспечить прозрачность для бизнес-пользователей?
Предоставьте визуальные дашборды по состоянию identity graph, порогам сопоставления, качеству данных и политике согласия. Включите объяснения к каждому решению сопоставления и регламентируйте доступ к чувствительным данным. Обеспечение понятных инструкций и прозрачности в процессах усилит доверие маркетологов и менеджеров по продажам к данным CDP.
Глава охватывает вопросы проектирования и эксплуатации identity resolution в CDP с точки зрения продуктовой ценности: как идентификаторы превращаются в единый и управляемый профиль клиента, какие механизмы позволяют сохранять качество и приватность, и как быстро переходить от концепций к реальному бизнес-эффекту через корректно выстроенные процессы внедрения и мониторинга.


