

Распределение нагрузки и планирование загрузок: incremental, CDC, SCD
В рамках курса по ETL-процессам в Hadoop данная глава посвящена подходам планирования загрузок и балансировке нагрузки между источниками данных и целевыми хранилищами. Особое внимание уделено трем концепциям: инкрементальные загрузки, CDC (Change Data Capture) и SCD (Slowly Changing Dimensions). Рассматриваются архитектурные решения, протоколы передачи, схемы хранения и интеграционные паттерны, которые позволяют поддерживать актуальность данных при больших объемах и разнообразии источников, сохраняя при этом управляемость и предсказуемость затрат на ресурсы.
Эффективное распределение нагрузки требует не только выбора подходящего формата ingestion и хранения, но и ясного определения SLA к обновлениям, стратегии репликации, а также правильной обработки изменений на уровне размерностей и фактов. В этом контексте рассматриваются принципы балансировки нагрузки между пакетной и потоковой обработкой, выбор технологий и стандартов взаимодействия между системами, а также практики минимизации дубликатов, потерь данных и задержек.
- Инкрементальные загрузки и архитектура хранения: как извлекать только изменившиеся данные и корректно интегрировать их в целевые секции хранения.
- CDC как механизм передачи изменений в реальном времени и синхронизации между источниками и хранилищами.
- SCD для размерностей: варианты реализации, согласованность истории изменений и влияние на аналитические запросы.
- Инструменты интеграции и планирования загрузок: паттерны оркестрации, управление зависимостями, мониторинг и аудит.
- Практические рекомендации по выбору технологий (на примере ограниченного числа инструментов) и шаблоны архитектур для Hadoop-экосистемы.
Краткое содержание главы
- Определение ролей инкрементальных загрузок, CDC и SCD в рамках ETL-процесса Hadoop.
- Архитектурные принципы планирования загрузок: баланс нагрузки, SLA, выбор между пакетной и потоковой обработкой.
- Реализация инкрементальных загрузок: сигнатуры изменений, дедупликация, upsert-логика и хранение версий.
- Реализация CDC и управление потоками изменений: интеграция через брокеры сообщений, гарантийность и идемпотентность.
- Реализация SCD в dimensión-хранилищах: варианты типов изменений, стратегия хранения и восстановления истории.
- Оптимизация хранения и партиционирования: форматы файлов, шардирование, компакция и эффективная фильтрация.
Архитектурные принципы планирования загрузок
Контекст и требования к загрузкам
Планирование загрузок в Hadoop строится на балансе между скоростью обновления данных и стоимостью обработки. Ключевые требования включают минимизацию задержки между появлением изменений в источнике и их доступностью в целевом хранилище, гарантии целостности данных, а также предсказуемость ресурсных затрат. В рамках классической архитектуры ETL это подразумевает наличие четкой границы между входными потоками (источники, брокеры сообщений, файлы) и слоем обработки (Spark, MapReduce, Flink) с ясной политикой версионирования и мониторинга.
Из теории следует, что выбор стратегии обработки зависит от частоты обновлений, объема данных и требований к консистентности. Для низкой задержки часто выбирают потоковую обработку и CDC-образные паттерны, тогда как при больших пакетах можно обрамлять данные пакетной обработкой с эффективной агрегацией и дельта-письмами. Важно обеспечить совместимость форматов, совместное использование метаданных и единообразную политику ошибок, чтобы предотвратить повторное выполнение операций и рассогласование версий.
Источники и потоки данных: пакетная против потоковой обработки
Определение источников и характер потока данных напрямую влияет на архитектуру сохранения и индексирования. Пакетная загрузка (batch) обеспечивает высокую производительность на больших объемах, но задерживает свежесть данных. Потоковая обработка (streaming) позволяет минимизировать задержку за счет непрерывной обработки входящих изменений. В реальной среде чаще применяется гибридный подход, где критичные данные обрабатываются потоками через CDC-подобные каналы, а остальная часть обновляется пакетами по расписанию.
Планировщики и обмен сообщениями: Airflow, Oozie, NiFi
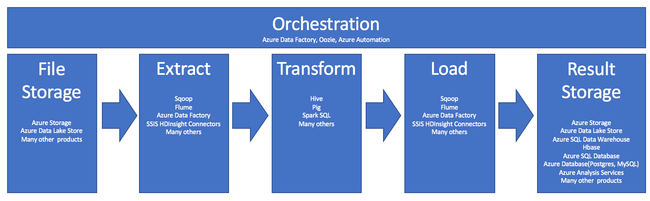
Эффективная оркестрация загрузок требует использования планировщиков и конвейеров обмена данными. В Hadoop-экосистеме часто применяются такие решения как Apache Airflow или Apache Oozie для планирования DAG-цепочек, а также инструменты для интеграции данных, например Apache NiFi, который делает упрощение для схем ingestion из различных источников и их маршрутизацию. Важно обеспечить idempotentность операций и устойчивость к сбоям: повторная обработка должна приводить к корректным результатам без повреждения целевых таблиц.
Пример паттерна: оркестрация и контроль версий
Архитектурно целесообразно разделять конвейеры на:
- конвейер ingress (ингестинг): сбор изменений из источников и их упаковка в единицы передачи;
- конвейер трансформации: применение бизнес-логики, агрегаций, нормализации и подготовки к хранению;
- конвейер загрузки: запись в целевые хранилища с поддержкой версионирования и упрощенной обработкой ошибок.
Паттерн позволяет независимо масштабировать компоненты, держать архитектуру модульной и проще внедрять новые источники без радикальных изменений в существующих конвейерах.
Инкрементальная загрузка: механизмы, сигнатуры, границы
Инкрементальные загрузки ориентированы на считывание только тех изменений, которые произошли с момента последней загрузки. Это снижает нагрузку на сеть и вычислительную инфраструктуру, а также упрощает поддержание актуальности данных.
Механизмы определения изменений
На практике применяются несколько сигнатур изменений:
- временной штамп (last_modified, updated_at) и период актуальности записи;
- контрольные суммы (checksum) для обнаружения изменений в больших бинарных полях;
- лог изменений источника (journal) или последовательность событий в CDC-потоке.
Комбинации сигналов обычно дают наилучшее сочетание точности и производительности. В Hadoop контексте целесообразно хранить в целевых таблицах минимальные сигнатуры изменений и поддерживать связь между обновлениями и версиями записей с помощью версионирования полей.
Алгоритмы и паттерны
- Append-only с UPSERT: данные добавляются как новые записи, старые помечаются устаревшими, поддержка "is_current" или "valid_to".
- Upsert через журнал изменений: хранение изменений в том же формате, что и источник, и применение их на целевой таблице с использованием транзакционных механизмов.
- Дедупликация на этапе записи: удаление дубликатов по ключу до применения изменений, чтобы избежать конфликтов при повторной обработке.
При реализации в Hadoop-окружении рекомендуется использовать системы управления версиями данных, которые поддерживают upsert-операции и отделяют изменения от физических файлов. В качестве примера можно рассмотреть решения на базе Apache Hudi или Apache Iceberg, которые облегчают реализацию инкрементных загрузок и upsert-логики на уровне метаданных и логов изменений.
## Пример демонстрирует паттерн инкрементной загрузки с upsert через Spark и Hudi
## Это не рабочий код, а иллюстративный фрагмент

from pyspark.sql import SparkSession

spark = SparkSession.builder.appName("IncrementalLoad").getOrCreate()

## Delta-файлы или CDC-изменения
delta_df = spark.read.format("parquet").load("/data/delta/stream")

## Запись в Hudi с upsert-операцией
delta_df.write.format("hudi") \
  .option("hoodie.datasource.write.operation", "upsert") \
  .option("hoodie.datasource.write.recordkey.field", "id") \
  .option("hoodie.datasource.write.precombine.field", "last_modified") \
  .option("hoodie.table.name", "fact_sales_incremental") \
  .mode("append") \
  .save("/data/hudi/fact_sales_incremental")
Роль хранителей метаданных и версиях
Чтобы обеспечить предсказуемость и воспроизводимость загрузок, необходимо поддерживать:
- ведение версии схем и миграций;
- хранение истории изменений и временных меток;
- процедуру восстановления после ошибок с минимальным количеством потерянных записей.
Выбор между хранилищами типа Hudi и Iceberg влияет на инфраструктуру и доступность функций: оба решения поддерживают upsert и time-travel, но отличаются реализацией транзакций и уровнем поддержки в экосистеме.
Архитектура и интеграция
Инкрементальные конвейеры хорошо сочетаются с брокерами сообщений (например, Apache Kafka) для передачи изменений и минимизации задержки. При проектировании следует учитывать требования к задержке, надёжности и потребности в идемпотентности потребителей.
CDC: измененные данные и потоки событий
CDC обеспечивает передачу изменений из источников в целевые хранилища на уровне отдельных записей. Это особенно важно для аналитики в реальном времени и для синхронизации между системами.
Основные концепции
- источники изменений: логи операций базы данных (WAL/redo log), журналы изменения таблиц, брокеры сообщений.
- форматы событий: Debezium-формат, собственные конвейеры на базе Kafka, SNS/SQS-подобные очереди.
- гарантии доставки: at-least-once, exactly-once (при правильной настройке и идемпотентности потребителей).
CDC требует внимания к порядку событий, idempotentности и обработке конфликтов при параллельной записи в целевые таблицы. В Hadoop-архитектурах CDC-слой обычно представляет собой поток изменений, который затем применяют к данным в целевых хранилищах с учетом схемы хранения и логики версионирования.
Интеграционные паттерны
- события из Kafka идут в потоковую обработку (Spark Structured Streaming, Flink) и записываются в целевые таблицы с upsert-логикой.
- источники изменений могут возвращать изменения для разных табличных контекстов: фактные данные, размерности, справочники.
- обеспечение идемпотентности достигается через уникальные ключи и детерминированные стратегии разрешения конфликтов.
Практическая часть
В реальных проектах CDC чаще всего требует:
- контроль версий схем и схем миграций;
- обработку события "delete" как специального tombstone-сообщения;
- сохранение контекста времени изменения для корректного восстановления истории.
SCD: управляемые изменения размерностей
SCD (Slowly Changing Dimensions) описывает, как хранить историю изменений размерностей в аналитических конвейерах. В Hadoop-управлении изменениями размерностей особенно важна длительная история, зависимость кэширования и скорость доступа к актуальным данным для бизнес-логики и аналитических запросов.
Типы изменений и выбор подхода
- Type 1: стирание изменений, замена старого значения новым без сохранения истории. Простота, но история теряется.
- Type 2: сохранение полного история изменений с добавлением новой версии строки (новый surrogate key) и отметок времени. Это обеспечивает полный аудит изменений.
- Type 3: ограниченная история, часто сохраняется текущее и предчующее значение в отдельных колонках. Ограниченная история, пригодна для некоторых сценариев анализа.
- Type 4: размерность в отдельной таблице, где хранится только архив, а основная таблица остаётся текущей. Удобно для чистоты запросов к текущей информации.
В Hadoop-экосистеме на практике чаще применяют SCD Type 2 в сочетании с транзакционными механизмами и индексированием, чтобы поддерживать историю изменений и обеспечивать точный контроль версий.
Как реализовать SCD Type 2
Реализация предполагает создание surrogate key для каждой новой версии записи и добавление полей, описывающих период действия записи, например:
- surrogate_key
- natural_key (идентификатор бизнес-объекта)
- атрибуты размерности
- valid_from, valid_to
- is_current (или аналогичный флаг)
Далее при появлении изменений выполняют следующие шаги:
-
Найти текущую активную запись по natural_key и обновить её поле valid_to на дату начала изменений, устанавливая is_current = false.
-
Вставить новую запись с новым surrogate_key, тем же natural_key и новыми атрибутами, устанавливая valid_from = дата изменения, valid_to = 9999-12-31 и is_current = true.
-
Обеспечить корректную индексацию и хранение в рамках целевой таблицы (обычно в парадигме upsert).
Пример структуры таблицы SCD Type 2
| surrogate_key | natural_key | attribute_1 | attribute_2 | valid_from | valid_to | is_current |
|---|---|---|---|---|---|---|
| 1001 | P-001 | Red | Large | 2023-01-01 | 9999-12-31 | true |
| 1002 | P-001 | Red | Medium | 2022-06-15 | 2023-01-01 | false |
Реализация такого паттерна может быть поддержана с помощью управляемых транзакций и специальных механизмов в Hudi или Iceberg, которые оптимизируют upsert-операции и делают запросы к истории размера более эффективными.
Архитектура и интеграция
SCD Type 2 хорошо сочетается с CDC, когда изменения в источнике приводят к появлению новой версии размерности. В качестве примера можно рассмотреть обработку изменений в dimension‑таблицах через потоковую обработку и обновления в целевых таблицах с использованием upsert-логики. В случае больших размерностей полезно разделять данные на партиции по времени (момент обновления) и по business-ключам, чтобы ускорить запросы к текущей и исторической версии.
Хранение и оптимизация распределения нагрузки
Эффективное хранение и оптимаизация загрузок требуют разумного выбора форматов, партиционирования и методов компрессии, которые обеспечивают быструю фильтрацию данных и минимальные затраты на обработку.
Партиционирование и форматы
- Партиционирование по времени (date_partition) и по бизнес-ключам для обеспечения локальности доступа и эффективных фильтров.
- Выбор форматов: Parquet или ORC для столбцовых представлений, которые поддерживают predicate pushdown и эффективные схемы сжатия.
- Контроль размера файлов и управление компакцией: небольшие файлы создают перегрузки на Namenode, слишком крупные - задерживают обработку. Оптимальная стратегия - компрессия и периодическая апгрейд-упаковка файлов.
Метаданные и управление изменениями
Для Hadoop-окружений ключевую роль играет управление метаданными и схемами. В сочетании с Hudi или Iceberg, метаданные позволяют обеспечить time-travel, глобальные транзакции и безопасную приводку к конкретной версии данных. Важны:
- поддержка схем: эволюция полей без breaking changes;
- поддержка версии таблиц и миграций;
- мониторинг и аудит операций записи.
Интеграции и паттерны
- Ингестинг через Kafka обеспечивает низкую задержку и устойчивость к сбоям; обработчики должны быть идемпотентными и поддерживать повторную отправку без дубликатов.
- NiFi может выступать как фронтенд-ингестор, маршрутизирующий данные в HDFS, Hive/IR, или директно в Hudi/Iceberg.
- Выбор между Hudi и Iceberg зависит от требований к консистентности, функциональности upsert, совместимости с экосистемой и поддержки управляемых транзакций. В рамках этого курса достаточно опираться на оба решения как на инструменты, которые существенно расширяют возможности инкрементальных загрузок и SCD, но выбирать стоит на основе конкретной задачи и зрелости инфраструктуры.
Мониторинг и управление ресурсами
Эффективное планирование загрузок требует мониторинга задержек, очередей обработки, дискового I/O и использования CPU. В Hadoop-пайплайнах критично иметь дашборды для:
- времени выполнения конвейеров;
- задержки по источникам и потребителям;
- доли ошибок и повторных попыток;
- размерности и их актуальность.
Key takeaways
- Инкрементальные загрузки позволяют снизить объём обработки и ускорить доставку данных, опираясь на сигнатуры изменений и версионирование.
- CDC обеспечивает поток изменений из источников в целевые хранилища и требует аккуратной обработки времени и идентификаторов событий.
- SCD Type 2 охватывает требования к сохранению полной истории размерностей; в Hadoop‑окружении его удобно реализовывать на базе транзакционных форматов и систем управления таблицами.
- Выбор между Hudi и Iceberg во многом определяется требованиями к транзакциям, поддержке upsert и интеграции в существующую экосистему.
- Архитектура планирования загрузок должна включать четкую оркестрацию, мониторинг и возможность масштабирования при изменении источников.
- Оптимизация хранения строится на грамотном партиционировании, формате файлов, компрессии и управлении метаданными.
- Современная инфраструктура ETL в Hadoop строится на сочетании потоковой обработки, пакетной загрузки и устойчивой интеграции через брокеры сообщений и коннекторы.
FAQ
- Что такое incremental load и чем он отличается от обычной загрузки?
Incremental load - это подход к загрузке данных, при котором извлекаются и записываются только те данные, которые изменились или были добавлены после последней загрузки. Он минимизирует пропускную способность, снижает нагрузку на хранилище и ускоряет обновления. В отличие от полной загрузки, incremental load требует механизмов идентификации изменений (таймштампы, сигнатуры, журналы изменений) и схемы обработки обновлений (upsert, дублирующее устранение, версия записей).
- Как выбрать между CDC и простой инкрементальной загрузкой?
CDC применяют, когда источник данных поддерживает лог изменений и обеспечивает стрим изменений в реальном времени. Это особенно полезно для синхронизации между системами и для аналитики в реальном времени. Инкрементальная загрузка эффективна, когда источник позволяет легко определить изменения без полноценных событий, например при использовании timestamp-меток. В реальной архитектуре часто применяются оба подхода: CDC для потока изменений и пакетные обновления для менее частых или сложных обновлений.
- Какие преимущества дает SCD Type 2 в аналитике?
SCD Type 2 сохраняет полноценную историю изменений размерности, что позволяет анализировать динамику характеристик объектов во времени. Это важно в бизнес-процессах, где исторические контекстуальные данные необходимы для анализа трендов, сравнения периодов и аудита. В Hadoop-среде реализация Type 2 часто сочетается с upsert и временем действия записей, что обеспечивает совместимость с инструментами бизнес-аналитики и BI.
- Какие риски связаны с реализацией CDC в Hadoop?
Основные риски связаны с корректной обработкой параллельных изменений, обеспечением идемпотентности потребителей и управлением порядком событий. Необходимо внимательно проектировать ключи, обработку tombstone-сообщений, а также обеспечивать единообразные временные метки. Неправильная обработка может привести к дублированию данных или рассинхронизации между источниками и хранилищами.
- Какие рекомендации по выбору форматов и партиционирования в процессе загрузок?
Рекомендуется использовать столбцовые форматы Parquet или ORC для эффективной фильтрации и сжатия. Партиционирование по времени и по бизнес-ключам улучшает локальность данных и ускоряет запросы. Следует избегать избыточного числа мелких файлов и поддерживать баланс между количеством файлов и размером каждого файла, чтобы не перегружать Namenode и не снижать производительность чтения.
- Как обеспечить консистентность и повторяемость ETL-процессов?
Необходимо внедрить идемпотентность на уровне потребителей изменений, фиксировать версии схем и метаданные конвейера, а также использовать транзакционные механизмы при записи в целевые хранилища. В идеале применяются tolerant к сбоям конвейеры, хранение журналов изменений и стратегии отката.
- Какие роли играют инструменты инжестинга и оркестрации в архитектуре?
Инструменты инжестинга (например, NiFi) обеспечивают гибкость маршрутизации данных из разных источников в Hadoop-хранилища. Оркестратор (Airflow, Oozie) управляет зависимостями, временем запуска и мониторингом исполнения конвейеров, что критично для SLA и устойчивости системы.
- Какую роль играют транзакции и метаданные в рамках Hudi и Iceberg?
Оба решения поддерживают транзакции на уровне таблиц и управление версиями файлов. Это позволяет реализовать upsert, time travel и эффективные операции чтения исторических данных. Выбор между ними обычно базируется на существующей экосистеме, требованиях к совместимости и функциональности.
- Какие характерные ошибки встречаются при проектировании загрузок и как их избегать?
Распространены ошибки: неподходящее партиционирование, несогласованные временные метки, отсутствие идемпотентности, нарушение целостности при повторной обработке, слабый контроль версий схем. Избежать их можно применяя модульное тестирование конвейеров, контроль версий, единые правила миграций и детальное журналирование.
- Как оценить экономическую эффективность директив инкрементальных загрузок?
Необходимо проводить анализ TCO: затраты на хранение, вычисления, сетевой трафик, а также стоимость поддержки инфраструктуры. Инкрементальные подходы обычно уменьшают затраты на хранение и сеть, но требуют более сложных механизмов мониторинга и контроля версий. Важна детальная модель SLA и предсказуемость пиков нагрузки.


