

Девопс для ETL в Hadoop: CI/CD, тестирование конвейеров и окружения
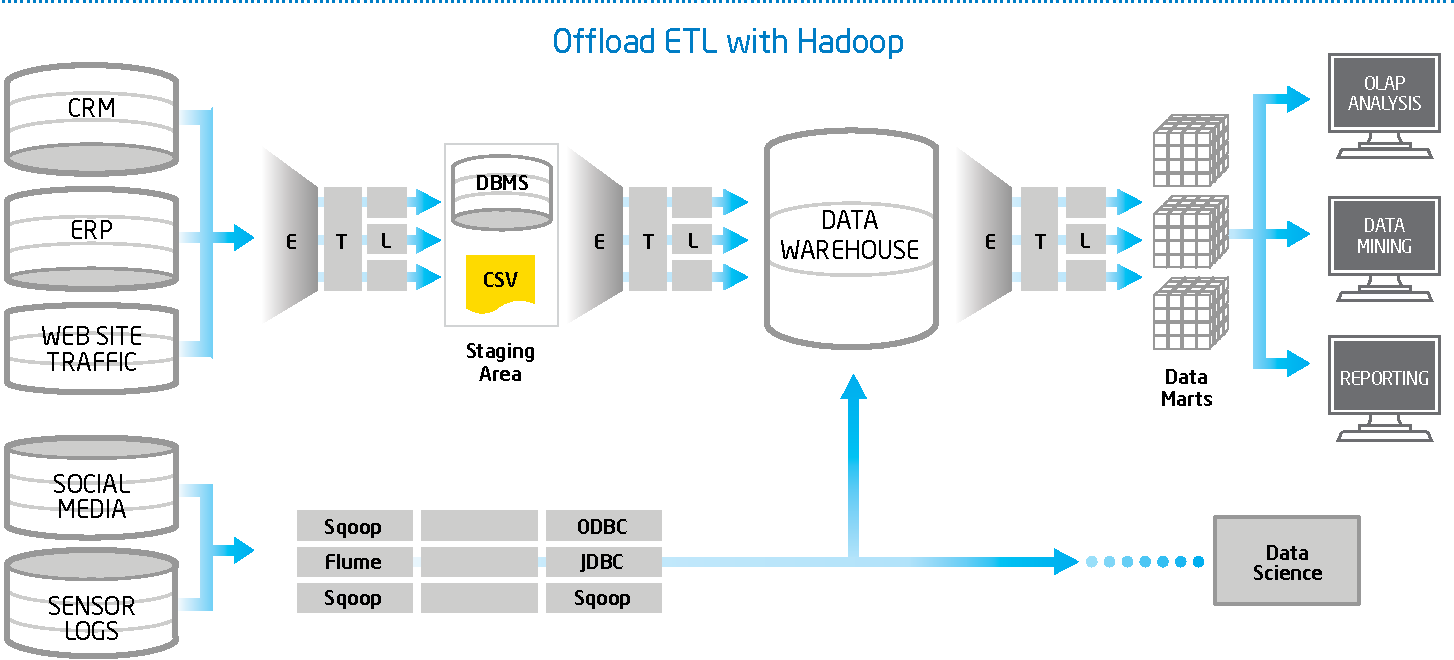
DevOps-подход для ETL в Hadoop - это не только автоматизация развёртывания и тестирования конвейеров, но и создание воспроизводимой и управляемой среды для переработки больших данных: от ingestion до хранения с эффективной схемой partitioning. В рамках данной главы изложены принципы архитектуры, практики CI/CD, методики тестирования и организационные аспекты формирования устойчивых окружений. Рассматриваются как классические инструменты экосистемы Hadoop, так и современные подходы к управлению инфраструктурой и данными: архитектура протоколов взаимодействий, управление версиями, контроль качества данных и обеспечение безопасности.
Эффективный DevOps для ETL в Hadoop обеспечивает три ключевых эффекта: воспроизводимость конвейеров и их параметров в разных окружениях, устойчивость к сбоям за счёт идемпотентных операций и повторной обработки данных, а также прозрачность и управляемость процессов по данным и метаданным. Эти принципы применяются на всех стадиях цикла: от проектирования конвейера до выпуска изменений в продакшн и последующего мониторинга.
Краткое содержание главы
- Архитектура DevOps для ETL в Hadoop: стек технологий, роли и взаимодействие между компонентами, управление конфигурациями и безопасностью.
- CI/CD конвейеры для Hadoop ETL: инфраструктура как код, пайплайны как код, артефакты и стратегии развёртывания.
- Тестирование конвейеров ETL: виды тестирования, данные для тестирования, инструменты качества данных и впечатляющее значение контроля качества.
- Окружения и управление ими: разработка, тестирование, продакшн, автоматизация provisioning и безопасность.
- Интеграции и хранение метаданных: линейность данных, каталоги и форматы хранения, связь ingestion и управления данными.
- Практические алгоритмы и протоколы: идемпотентность, контроль версий, стратегии повторной обработки и транзакционной поддержки.
Архитектура DevOps для ETL в Hadoop
Стратегия DevOps в контексте Hadoop-ETL основывается на разделении ролей, автоматизации повторяемых операций и управлении конфигурациями на уровне инфраструктуры и приложений. Архитектура должна обеспечивать воспроизводимость конвейеров при переходе из стадии в стадию (dev → test → prod), устойчивость к сбоям и возможность аудита. В рамках Hadoop портфеля из ingestion-слоя, обработки и хранения важна тесная связь между инструментами ingestion (NiFi, Flume, Kafka), вычислительным движком (Spark, MapReduce), и системами управления хранением (Hive, Iceberg, Hudi, Parquet). Эту связку следует рассматривать как единый производательный контур с единым центром управления версиями, метаданными и доступом.
- Инфраструктура как код и конфигурационное управление. Для облачных и гибридных сред целесообразно применять Terraform для развёртывания кластерной инфраструктуры и облачных сервисов, Ansible или SaltStack для конфигурации компонентов, а также Helm для управления пакетами в Kubernetes, если используется оркестрация сервисов вокруг Hadoop-окружения. Такой подход упрощает создание Dev и Prod окружений и обеспечивает воспроизводимость, что критично для повторяемости ETL-конвейеров. Это снижает риск ручных ошибок и ускоряет возвраты к предыдущим конфигурациям после изменений.
- Контроль версий и артефакты. В SCM-уровне целесообразно хранить не только код конвейера, но и конфигурации, параметры среды и скрипты миграций схем. Артефактный репозиторий (например, Nexus, Artifactory) хранит контейнеризованные образцы сервисов, конфигурационные пакеты и образы компонентов интеграции (Kafka Connect, NiFi). Версионирование артефактов обеспечивает точное соответствие между кодом и окружением, облегчая откат.
- Безопасность и соответствие. Kerberos и TLS остаются базовыми механизмами аутентификации и защиты каналов. Управление доступом и политики на уровне данных реализуются через Ranger (или аналог) для контроля доступа, Atlas - для управления метаданными и строгой линии учёта данных. Встраивание политики безопасности в конвейеры должно происходить на этапе планирования: например, ограничение прав на создание временных файлов, контроль над записью в продакшн-хранилища и обеспечение аудита изменений.
- Мониторинг, журналирование и аудит. Центральное логирование и мониторинг (ELK/EFK, Prometheus+Grafana) позволяют отслеживать состояние конвейеров, задержки обработки и сбои в ingestion, а также обеспечивают видимость по данным и исполнения процессов. Линии данных, связанные с метаданными, должны иметь привязку к журналам изменений и трассировку событий обработки.
Для иллюстрации архитектурной картины можно рассмотреть простой стек: NiFi или Kafka Connect для ingestion, Spark для обработки, Hive/ Iceberg для хранения, Atlas для метаданных и Ranger для доступа, ELK/Prometheus для мониторинга, Jenkins/GitLab CI для CI/CD. Важным является не столько набор конкретных инструментов, сколько принципы: единый источник конфигураций, контроль версий, повторяемость и управляемость безопасностью на протяжении всего конвейера.
Инструменты и интеграции: пример конфигураций
- Ingestion: Apache NiFi обеспечивает потоковую обработку входных данных и управление маршрутизацией. В сценариях грациозной дегазации данных NiFi позволяет настраивать retry-логику и схемы преобразования без изменения кода конвейера.
- Обработка: Apache Spark в режиме batch и streaming обеспечивает единое API и возможность использования Iceberg/Hudi как таблиц хранения.
- Хранение и манипуляции данными: Iceberg или Hudi поддерживают частотное partitioning и эволюцию схем, позволяя конвейеру плавно адаптироваться к изменениям источников и требований.
- Метаданные и безопасность: Atlas для линейности данных и lineage; Ranger для политик доступа, Kerberos/LDAP для аутентификации и TLS для шифрования трафика.
- Мониторинг и аудит: Prometheus/Grafana для метрик, ELK/EFK для журналирования, интеграция с Atlas для прослеживаемости изменений в данных.
Необходимые принципы: архитектура должна быть модульной и расширяемой, чтобы можно было подменять компоненты ingestion, обработки или хранения без радикального переработки всей цепочки. Такой подход упрощает внедрение новых источников данных и визуализацию больших потоков данных в режиме реального времени.
CI/CD конвейеры для Hadoop ETL
CI/CD для Hadoop-ETL предполагает неразрывное связь между кодом конвейера, инфраструктурой и данными. Концептуально пайплайны должны поддерживать автоматическое тестирование, безопасное развёртывание и контроль версий окружений. В зависимости от контекста организации и зрелости процессов, можно опираться на Jenkins, GitLab CI, GitHub Actions или комбинацию инструментов.
- Пайплайны как код. Конвейер должен описываться в виде кода на уровне CI-сервера. Это обеспечивает прозрачность и облегчает ревизии, ревёрсы и аудит изменений. Включение этапов сборки, статического анализа скриптов ETL и тестовых прогонов, а также процедур развёртывания в тестовые и продакшн-окружения - стандартная практика.
- Стратегия развёртывания. В качестве модели применима progressive release (dev → test → prod) с поддержкой canary и blue/green. Такой подход минимизирует риск для продакшн-потоков и позволяет на ранних стадиях выявлять проблемы совместимости между версиями кода и структурой данных.
- Управление артефактами и конфигурациями. Артефакты конвейера должны сопровождаться версионированием. Конфигурации окружений - храниться как код и применяться через инфраструктуру как код. Это обеспечивает воспроизводимость окружений и возможность отката.
- Инструменты и стек.
- Для оркестрации конвейеров - Jenkins, GitLab CI или GitHub Actions.
- Для оркестрации данных - Apache Airflow (как диспетчер рабочих процессов) или Apache Oozie для устоявшихся Hadoop-решений.
- В качестве примера можно рассмотреть комбинацию GitLab CI + Apache Airflow: код конвейера хранится в репозитории, тесты запускаются на CI-сервере, а выполнение реальных задач инициируется Airflow в кластере.
- Пример пайплайна. Ниже приведен упрощённый фрагмент, демонстрирующий идею пайплайна: он проверяет код конвейера, прогоняет тесты и разворачивает изменённый конвейер в тестовом окружении, а затем - в продакшн.
pipeline:
  stages:
    - build
    - test
    - deploy
  build:
    script:
      - mvn -f etl-pipeline/pom.xml -B -DskipTests package
  test:
    script:
      - python tests/test_etl.py
      - spark-submit --class org.example.DataQualityCheck tests/quality_check.jar
  deploy:
    stage: deploy
    script:
      - terraform apply -auto-approve
      - airflow dags trigger etl_prod
Обоснование такого подхода состоит в том, что код конвейера, конфигурации окружений и схемы зависимостей должны быть задокументированы и версионированы. В противном случае риск возникновения регрессий возрастает, и восстановление после сбоев становится затруднительным.
Тестирование конвейеров ETL
Тестирование в контексте Hadoop-ETL должно охватывать не только корректность отдельных скриптов, но и качество данных, соответствие контрактам и устойчивость к изменениям источников. Это включает в себя взаимосвязанные тесты на нескольких уровнях: юнит-тесты для логики трансформаций, интеграционные тесты для взаимосвязей между системами и end-to-end тесты с использованием реальных или синтетических данных.
- Типы тестирования
- Юнит-тесты для преобразований, написанных на PySpark/Scala.
- Интеграционные тесты проверяют взаимодействие ingestion, обработки и хранилища: корректность форматов, совместимость схем, правильность записи в Iceberg/Hudi.
- Data quality tests (проверки консистентности, санитизация данных, соответствие ограничительным условиям) с использованием рамок вроде Great Expectations или Deequ.
- Контракты данных и линейность. Контракт-тесты подтверждают, что данные соответствуют объявленным схемам и бизнес-правилам на протяжении конвейера.
- Инструменты
- Deequ (Scala/Java) для проверки качества данных на уровне Spark-приложений, включая проверки несоответствия схем, пропусков и уникальности ключей.
- Great Expectations (Python) для описания и выполнения цепочек проверок на этапе тестирования и, частично, в продакшне через мониторинг результатов.
- Практические принципы
- Резервные тестовые данные должны быть изолированы от продакшна и обновляться независимо.
- Тесты должны быть репродуцируемыми и детализированными: трассируемость, где возникла ошибка и какие данные были задействованы.
- Тестирование должно сопровождаться мониторингом качества данных в продакшне: метрики пропусков, латентности и соответствия контрактам должны сигнализировать об отклонениях.
Инструменты и примеры
- Deequ. Реализация проверок в Spark-приложениях позволяет автоматически формулировать проверки по схеме данных и бизнес-графикам. Пример использования включает определение правил для уникальности ключей и отсутствия пропусков в критических столбцах.
- Great Expectations. Гибкая система декларативной проверки данных и построения отчетов. Преимущество - понятные сообщения об ошибках и возможность хранения контрактов в коде.
Безопасно и надёжно тестирование конвейера требует подхода, интегрированного в процесс CI/CD: тесты должны запускаться в тестовых окружениях в рамках пайплайна, после чего результат выполнения автоматически влияет на переход к следующему этапу развертывания.
Окружения: разработка, тестирование и продакшн
Управление окружениями в рамках Hadoop-ETL требует высокого уровня дисциплины и автоматизации. Одинаковые конфигурационные параметры, версии компонентов и политики безопасности должны быть сценариями, а не ручными настройками.
- Environment as code. Планы развёртывания, параметры кластера, сетевые политики и политики безопасности должны храниться как код. Использование Terraform/CloudFormation для инфраструктуры и Ansible/Chef для конфигурации обеспечивает воспроизводимость и упрощает откат.
- Раздельные окружения. Обычно применяются dev, test (staging) и prod. Размещать ближе к продакшн-масштабу можно отдельные тестовые кластеры, копии данных или синтетические датасеты. Такой подход позволяет тестировать новые версии, не влияя на живые данные.
- Архитектура окружений и безопасность. Включение Kerberos и Ranger в каждом окружении обеспечивает единый уровень безопасности. Необходимо обеспечить автоматическое управление ключами и секретами, например через Vault или аналогичный механизм, чтобы минимизировать риск утечек.
- Управление изменениями и аудит. Внесение изменений в конфигурацию окружения и конвейера должно происходить через запросы на изменение в системах контроля версий, что облегчает аудит и откат.
Организационные аспекты включают в себя регламентированные процессы прохождения изменений, согласование с командами эксплуатации и разработки, и подготовку документации по каждому окружению: параметры ресурсов, политики доступа, графики обновлений и потенциальные риски.
Интеграции и хранение метаданных
Эффективная ETL-система требует тесного связывания потоков данных, метаданных и политики управления доступом. Метаданные обеспечивают трассируемость, обнаружение зависимостей и аудит изменений.
- Метаданные и линейность. Apache Atlas (или аналогичные системы) позволяют описывать источники данных, преобразования, зависимости и lineage. Это критично для соблюдения требований по управлению данными и аудиту.
- Хранение и формат данных. Форматы хранения (Iceberg, Hudi) поддерживают управление схемами и partitioning, позволяют эволюцию схем без прерывания потока, упрощают версионирование таблиц и оптимизируют запросы.
- Интеграции ingestion-платформ. Ingestion-слой (NiFi, Kafka) должен быть тесно связан с метаданными, чтобы можно было отслеживать источник, путь данных и состояние. Важно обеспечить согласие между данными в конвейере и их описанием в каталоге.
- Безопасность и контроль доступа к данным. Совместная работа Atlas и Ranger позволяет определить правила доступа на уровне набора данных, столбцов и операций. Это критически важно в условиях регуляторной прозрачности.
В рамках данной темы Open-source примеры: Apache Atlas для линейности и каталогов данных; Apache NiFi как инструмент ingestion, интегрируемый с Spark и Hive через общий слой хранения. В рамках современных подходов также упоминаются Iceberg/Hudi как форматы хранения, которые упрощают управление схемой и разделение по партитионам, обеспечивая эффективное хранение и быстрые запросы.
Практические алгоритмы и протоколы
Эффективная DevOps-взаимосвязь с ETL в Hadoop требует внимания к состоянию конвейера, устойчивости к сбоям и точному контролю версий данных и скриптов. Ниже перечислены ключевые алгоритмы и протокольные подходы, которые применяются в современных реалиях.
- Управление состоянием и идемпотентность. В операциях записи в HDFS/Hive-таблицы и при повторной записи данных необходимо проектировать конвейеры так, чтобы повторные запуски не приводили к дубликатам или непредсказуемым изменениям. Это достигается через идемпотентные операции, уникальные ключи и детерминированные идентификаторы партий.
- Транзакционная поддержка и контроль версий. Для таблиц форматов Iceberg/Hudi реализована поддержка операций MERGE/UPSERT и атомарной записи в рамках транзакций. Это позволяет безопасно применить обновления и слияния в больших наборах данных и поддерживает откат до предыдущих версий при необходимости.
- Обеспечение надежности через backoff и retries. В сетевых вызовах и в чтении источников данных следует использовать адаптивный экспоненциальный backoff с ограничением числа повторов и сбросами на уровне конвейера, чтобы снизить нагрузку на источники и предотвратить перегрузку кластера.
- Контроль версий, откаты и аудит. Все изменения в коде конвейера, скриптах обработки и конфигурациях окружения должны фиксироваться в системе контроля версий, чтобы обеспечить ретроспективу, возможность отката и детальные отчеты.
- Принципы тестирования при трансформациях. В сценариях, когда структура источников может изменяться, следует внедрять тесты на эволюцию схем и проверку обратной совместимости. Проведение регрессионных тестов на фиксациях ошибок и повторная загрузка данных - важнейшая задача для надежности.
- Применение мониторов и оповещений. Инструменты мониторинга должны работать в тесном контакте с конвейером: задержки сборки, проблемы с доступом к данным, сбои в ingestion и ошибки обработки - все это должно приводить к уведомлениям и соответствующим действиям.
Пример ситуации: поток ingestion через Kafka, где гарантии доставки настроены на «exactly-once». В такие моменты важно иметь транзакционную поддержку в продюсере и consumers, оновляющий контроль за состоянием обработки, чтобы избежать дубликатов в целевой таблице Iceberg/Hudi. Комбинация продюсерских транзакций Kafka и атомарной записи в Iceberg обеспечивает высокий уровень согласованности.
Key takeaways
- DevOps для ETL в Hadoop требует сочетания архитектурной дисциплины, инфраструктуры как код и политики безопасности, чтобы обеспечить воспроизводимость и аудит.
- CI/CD для Hadoop-ETL должен поддерживать пайплайны как код, артефакты версионированы и окружения разворачиваются через инфраструктуру как код с поддержкой canary/blue-green.
- Тестирование конвейеров требует интеграции юнит-тестов трансформаций, тестов качества данных и контракты между источниками и хранилищами, с автоматизированным прогоном в тестовых окружениях.
- Окружения должны быть воспроизводимыми и разделёнными: dev, test и prod, с едиными политиками доступа, безопасностью и управлением секретами.
- Метаданные и хранение данных должны быть взаимосвязаны через каталоги и линейность, что обеспечивает прозрачность и соответствие требованиям к управлению данными.
- Практические алгоритмы включают идемпотентность, транзакционные подходы, контроль версий и устойчивость к сбоям через backoff и ретраи.
- В продуктивной среде эпизоды изменений должны проходить через строгий контроль версий и аудит, чтобы обеспечить стабильность и безопасность процессов.
FAQ
- Какие основные принципы следует учесть при выборе инструментов для ingestion в Hadoop?
- Важны совместимость и поддержка в рамках вашего стека: NiFi, Flume, Kafka Connect - это не просто инструменты, а конвейеры, которые должны хорошо интегрироваться с Spark и системами хранения. Выбор зависит от источников данных, требований к задержкам и потребности в маршрутизации данных. Определите критерии: поддержка протоколов, сложности конфигураций, требования к мониторингу и масштабируемость.
- Как обеспечить воспроизводимость конвейера в разных окружениях?
- Используйте инфраструктуру как код и конфигурации как код: Terraform/Ansible, Helm, и храните параметры окружения в версиях вместе с кодом конвейера. Применяйте пайплайны как код для автоматического развёртывания и тестирования в каждой стадии. Промежуточные результаты должны храниться в артефактном репозитории с явной версией, чтобы можно было откатиться.
- Какие практические методы обеспечения качества данных в ETL?
- Применяйте контрактное тестирование и проверку данных на каждом этапе конвейера. Используйте Deequ для Spark-валидаций и Great Expectations для декларативных проверок данных в Python. Эти проверки позволяют ловить проблемы на ранних стадиях и обеспечивают буквы закона по бизнес-правилам и схемам.
- Как организовать безопасные и эффективные окружения?
- Разграничение окружений по ролям и политикам доступа, совместимое с Kerberos и Ranger. Реализация секретов через безопасное хранилище (Vault или аналог) и автоматическое обновление ключей по расписанию. Регулярно проводите аудит прав и изменений.
- Какие подходы к мониторингу конвейеров наиболее эффективны?
- Централизованное логирование и метрики, интегрированные с Atlas и Ranger. Метрики задержек, пропускной способности, ошибок и статуса конвейера должны быть доступны в дашбордах. Линии данных и их состояние обязаны быть видимыми в каталоге метаданных.
- Как избежать проблем с миграцией схем?
- Используйте Iceberg/Hudi для эволюции схем. Эти форматы поддерживают изменения схем без прерывания обработки и позволяют организовать версионирование и управление партитионами. Включайте тесты на эволюцию схем и регрессионные тесты в пайплайны.
- Что взять на заметку при внедрении CI/CD в Hadoop-проектах?
- Уделяйте внимание управлению версиями окружений и конфигураций. Вводите процессы ревью изменений в конвейер и инфраструктуру, чтобы снизить риск регрессий. Гарантируйте повторяемость через артефакты и параметры окружения, и не забывайте про секьюрити-политики.
- Какие есть подводные камни в тестировании конвейеров?
- Тестирование должно отражать реальное поведение в продакшн-сценариях: объем данных, распределение, задержки и характер ошибок. Не полагайтесь только на маленькие тестовые наборы. Включайте тесты на эволюцию схем, на устойчивость к сетевым сбоям и на повторную обработку.
- Какие практики полезно внедрить на старте проекта по ETL в Hadoop?
- Обеспечьте базовую среду для CI/CD, используйте пайплайны как код, настройте мониторинг и аудит. Введите окружения dev/test/prod и политику версионирования для конвейера и конфигураций. Начните с нескольких критичных источников данных и таблиц, постепенно расширяя покрытие.
- Какие современные тенденции стоит учитывать в будущем?
- Рост использования форматов Iceberg и Hudi для хранения и частичной эволюции схем. Усиление автоматизации через Data Quality-as-a-Service, интеграция с каталожными сервисами и более тесная интеграция между ingestion-платформами и системами управления данными в рамках единых процессов DevOps.


