

Маштабирование кластера и развитие зрелости управленческих практик
В условиях растущего объема данных и усложнения аналитических сценариев Hadoop-кластер становится краеугольным элементом цифровой трансформации. Масштабирование здесь выступает не только как техническая задача добавления узлов, но и как управленческий процесс, требующий согласованных решений по архитектуре, эксплуатации, мониторингу и управлению изменениями. Эффективность эксплуатационных практик напрямую определяет скорость роста, устойчивость к сбоям и способность адаптироваться к новым требованиям бизнеса.
В данной главе рассмотрены принципы архитектурного масштабирования Hadoop-кластера, практики достижения предсказуемой производительности и отказоустойчивости, а также зрелость управленческих процессов - от планирования емкости и внедрения автоматизации до организационных изменений и культуры непрерывного улучшения. В конце представлены практические рекомендации и ответы на часто возникающие вопросы системной эксплуатации.
- Архитектурные принципы масштабирования Hadoop-кластера и роль управленческих практик в реальном времени.
- Практики планирования емкости, конфигурации, мониторинга и автоматизации.
- Механизмы отказоустойчивости и управление изменениями при росте кластера.
- Инструменты интеграции, контроль версий конфигураций и обеспечение согласованности по командам.
- Пояснение того, как выстроить процесс принятия решений, управление рисками и непрерывное улучшение.
Архитектурные принципы масштабирования Hadoop-кластера
Масштабирование Hadoop-кластера предполагает не только увеличение числа узлов, но и перераспределение ролей, переработку алгоритмов обработки и адаптацию сетевой инфраструктуры. В классической архитектуре ключевые компоненты - HDFS для хранения данных, YARN для управления вычислениями и экосистема обработчиков (MapReduce, Spark и др.). При удачном масштабировании эти компоненты работают как единая согласованная система, способная поддерживать рост входной нагрузки без значимой потери качества обслуживания.
- Горизонтальное масштабирование и его границы. Масштабирование кластера обычно реализуется за счет добавления рабочих узлов, что позволяет увеличить совокупные вычислительные ресурсы и емкость хранилища. Однако реальное увеличение пропускной способности зависит от согласованности между сетью, дисковыми подсистемами и планированием размещения данных. Важно внедрять политики размещения блоков, чтобы обеспечить локалитет данных и минимизировать сетевые задержки. В крупных кластерах критически важна архитектура Federation или NameNode HA с несколькими активными пространствами имен - такие подходы снижают «узкие места» и позволяют параллельно масштабировать хранение и вычисления.
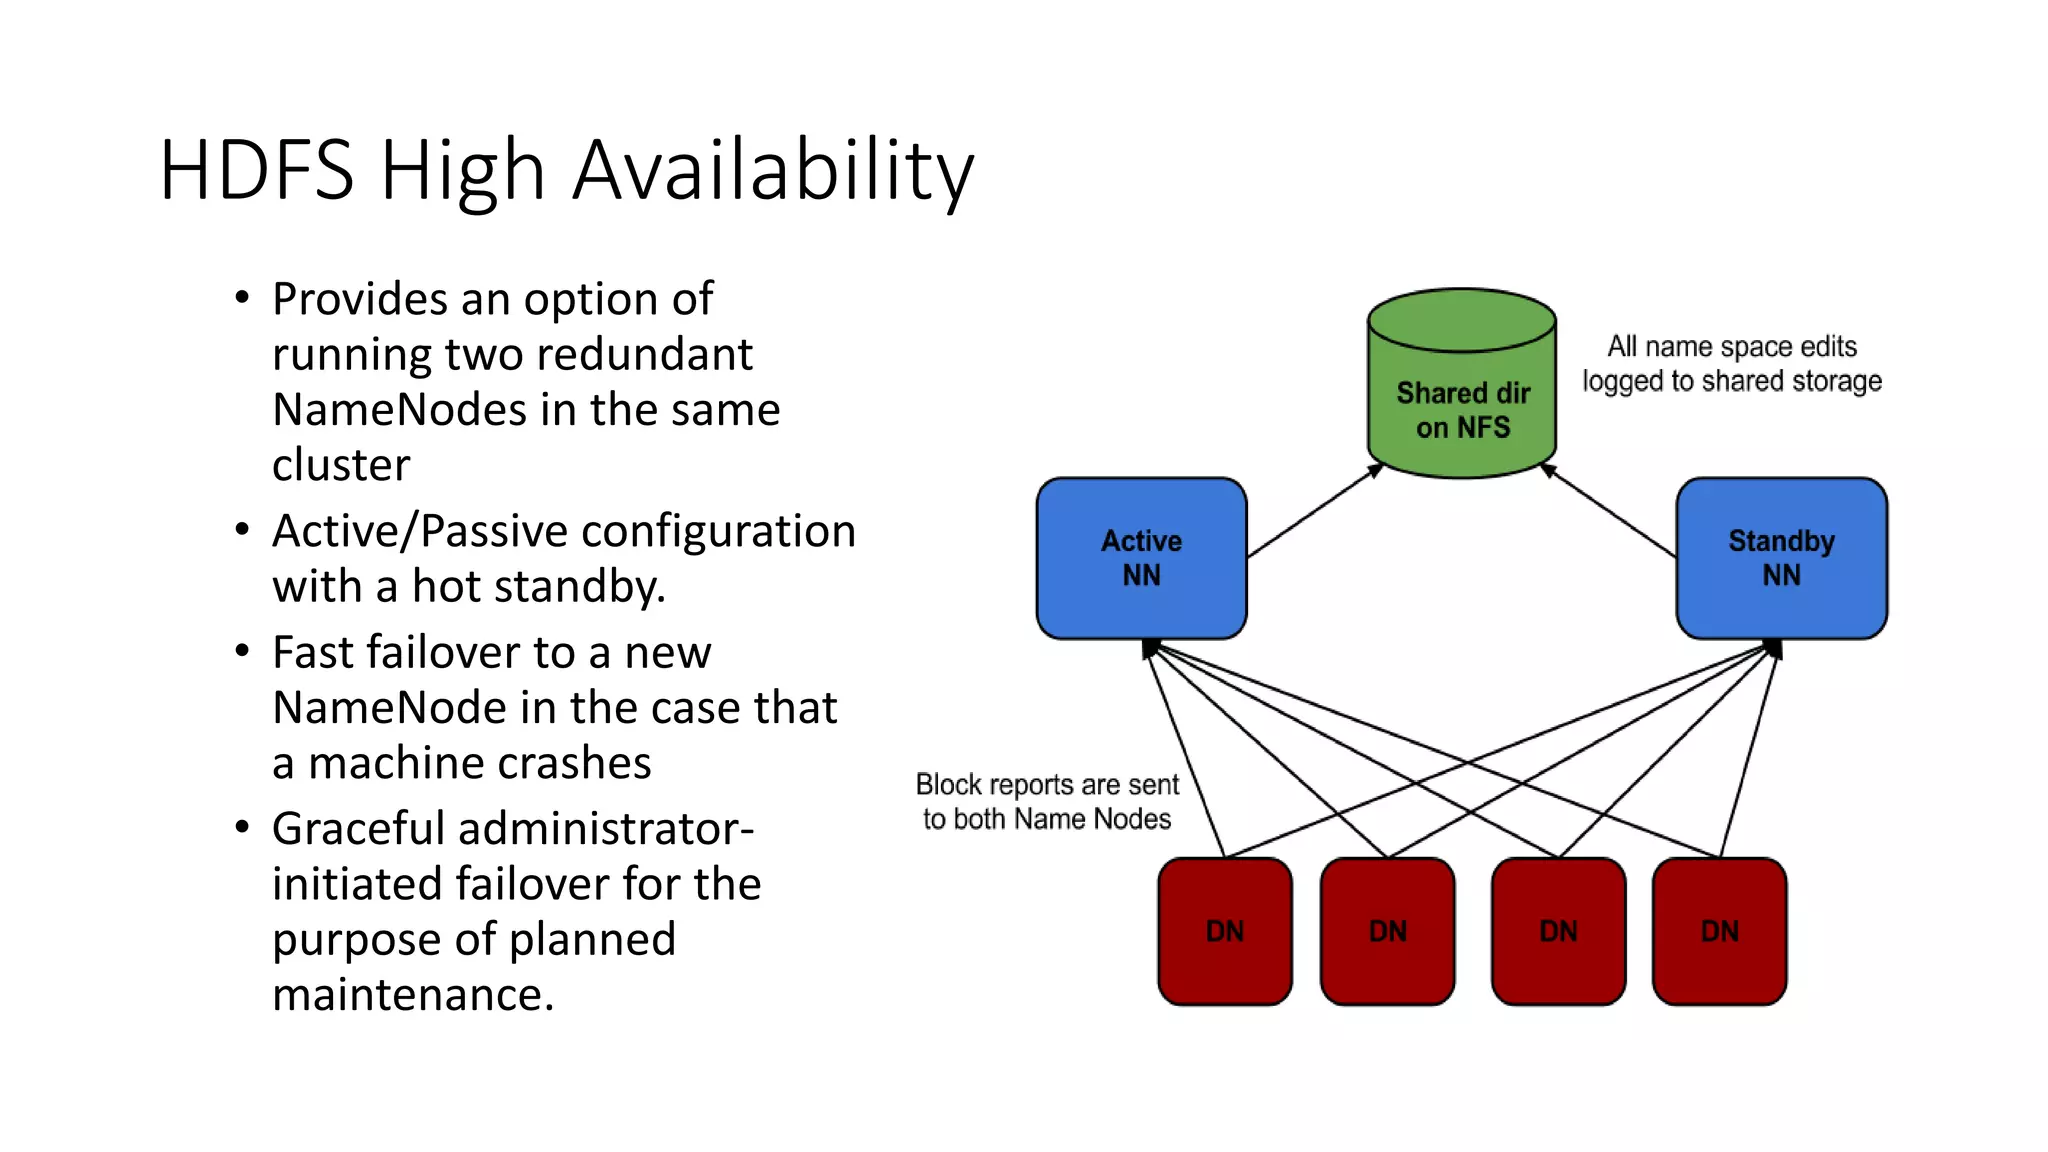
- Архитектура и отказоустойчивость. Гарантии доступности обеспечиваются за счет высокодоступных конфигураций, репликации данных и механизмов отказоустойчивости сервисов управления ресурсами. Типичные решения включают HA для NameNode (с журналируемым журналом через JournalNode), HA для ResourceManager и внедрение решения по хранению координаторских данных. В реальном кластере полезно рассмотреть разнесение узлов хранения и вычислений, использование независимых подкластеров и локализацию сетевых зависимостей.
- Уровни хранения и данными слои. Этапы проектирования должны учитывать дисковую подсистему: HDD для массового хранения, SSD для кэширования и операций ввода-вывода, а также возможность применения erasure coding в HDFS для эффективного использования пространства. В больших кластерах стоит рассмотреть гибридное хранение и политику репликации, которая соответствует требованиям к доступности и скорости восстановления после сбоев.
- Протоколы взаимодействия и консистентность. Взаимодействие между компонентами реализуется через набор протоколов RPC, heartbeat-сигналов и механизмов координации через ZooKeeper. Конфигурационные изменения, обновления и фазы перезапуска требуют четко регламентированных процедур, чтобы исключить рассинхронизацию параметров и обеспечить совместимость версий в разных частях кластера.
Важным элементом является баланс между единым управляемым кластером и независимыми подмодулями. При этом следует помнить: масштабирование не равно автоматизации. Автоматизация дополняет архитектуру, но не снимает необходимость в продуманной политике эксплуатации, в частности в отношении мониторинга, алертинга и тестирования изменений.
- Интеграция с инструментами управления. Управление жизненным циклом кластера становится практическим способом внедрения архитектурных решений. Инструменты типа Apache Ambari или коммерческие Cloudera Manager/Microsoft HDInsight позволяют централизованно управлять конфигурациями, обновлениями и мониторингом, снижая риск человеческой ошибки. В рамках открытой экосистемы полезно рассматривать Prometheus и Grafana для мониторинга метрик и алертинга, а также Elasticsearch/Logstash/Kibana для журналирования и расследования инцидентов.
Технологические подходы к масштабированию
Переход к более крупному кластера требует системного подхода к планированию и реализации изменений. Эффективное масштабирование начинается с понимания реальных рабочих нагрузок и возможностей архитектуры. Необходимо сочетать методы планирования емкости, правильной настройки сервисов и устойчивой инфраструктуры.
- Планирование емкости и sizing. Прогнозирование спроса на вычислительные ресурсы необходимо делать на основе действующих профилей рабочих нагрузок: MapReduce, Spark-пайплайны и интерактивные запросы. Модели должны учитывать сезонность, пиковые интервалы обработки и долговременное хранение. Часто применяются сценарии “потребление-плюс-запас” и моделирование очередей в YARN, чтобы заранее определить количество узлов, необходимое для поддержания целевой задержки и ошибок. Важно включать резерв мощности для действий по перераспределению данных и восстановления после сбоев.
- Разделение задач и конфигурация сервисов. В крупном кластере полезно отделить слои управления и вычислительную часть. YARN Configuration и выбор планировщика (Capacity Scheduler, Fair Scheduler) должны соответствовать политике приоритизации задач и требовать минимизации конфликтов между работающими заданиями. Учет местоположения данных (data locality) должен учитываться на уровне планирования задач и размещения контейнеров, особенно когда применяются большие объемы переработки в Spark.
- Хранилище и сети. Эффективное масштабирование требует соответствующей сетевой инфраструктуры и дискоструктуры. Пропускная способность сетевых каналов и задержки должны быть достаточны для распределенной обработки. Функции erasure coding в HDFS снижают затраты на хранение, но добавляют вычислительную нагрузку на восстановление данных, что требует планирования времени восстановления.
- Интеграции и автоматизация. Использование инструментов конфигурационного управления и IaC (Infrastructure as Code) облегчает масштабирование и обновления. Terraform и Ansible могут применяться для разворачивания кластеров и последующего конфигурационного приведения в соответствие с принятыми стандартами. Это позволяет быстро восстанавливать инфраструктуру, если процесс масштабирования требует повторных развертываний.
Производительность и отказоустойчивость в условиях растущего кластера
Рост кластера приносит не только увеличение мощности, но и новые вызовы в области производительности и устойчивости. Эффективная эксплуатация требует системного подхода к мониторингу, оптимизации и управлению рисками.
- Метрики и мониторинг. Ключевые показатели включают пропускную способность (throughput), задержку (latency), время отклика запросов, долю ошибок, загрузку узлов и эффективность кэширования. Важно отслеживать не только глобальные метрики, но и локальные: загрузку отдельных DataNodes, балансировку нагрузки, журналирование и частоту сбоев контейнеров. В рамках практики целесообразно внедрять поэтапные пороги алертинга, что позволяет раннее обнаружение проблем без ложных срабатываний.
- Оптимизация гиперпараметров и рабочих нагрузок. Для повышения производительности следует рассмотреть баланс между репликацией данных, размером блоков HDFS, стратегиями исполнения запросов и стратегиями переработки. Примеры включают управление skew-данными, настройку shuffle-передач, выбор типа объединений в Spark и оптимизацию стратегий кэширования. Важно также минимизировать частые перерасходы памяти и освобождение ресурсов в момент больших объединений данных.
- Отказоустойчивость и восстановление. В случае сбоев узлов кластера восстанавливается работоспособность за счет репликаций и переориентации задач. Важные аспекты - быстрый деокомм по узлу, балансировка данных после восстановления, настройка тестирования на отказ и планирование rolling upgrades без прерывания обслуживания. Архитектура HA для NameNode и ResourceManager обеспечивает минимальные простои в случае аварий.
- Управление изменениями и непрерывное улучшение. В зрелой среде изменения в конфигурациях и обновления кластеров происходят через регламентированные процессы с отслеживанием версий, тестированием на стенде и планами отката. Внедрение процедур изменения на уровне кластера, запуска автоматических регламентов на тестовых средах и проведение mini-откатов позволяют снизить риск в продакшене.
- Безопасность и соответствие. Роль механизмов Kerberos, Ranger/Sentry и политики доступа становится критической по мере роста кластера. Необходимо обеспечить секьюрность доступа к данным, журналированию и аудиту действий пользователей и сервисов, что особенно важно для глобальных развертываний и межрегиональных инфраструктур.
Управленческие практики зрелости
Масштабирование требует трансформации управленческих практик. Эффективная эксплуатационная среда строится на процессах, обеспечивающих предсказуемость, управляемость и прозрачность.
- Планирование изменений и управление версиями. В рамках зрелой методологии требуется централизованный реестр изменений, который связывает конфигурации кластера, версии компонентов, планы тестирования и регламенты отката. Важна регламентированная процедура согласования изменений с участием команд эксплуатации, разработчиков и SRE.
- Управление конфигурациями и drift-контроль. Наличие единой источник правды для конфигураций, отслеживание изменений, автоматическое тестирование и обязательная проверка совместимости версий компонентов - ключевые элементы. Практики drift-контроля позволяют своевременно выявлять расхождения между целевой конфигурацией и фактическим состоянием кластера.
- Инцидент-менеджмент и постинцидентные разборы. Система оповещений, документированные runbooks и четко определенные роли позволяют оперативно реагировать на сбои. Ретроспективы после инцидентов должны приводить к конкретным мерам улучшения архитектуры, процессов и инструментов.
- Автоматизация и инфраструктура как код. Внедрение IaC делает масштабирование повторяемым и предсказуемым. Автоматизация разворачивания, обновления и тестирования кластера снижает риск ошибок и ускоряет внедрение изменений. В рамках открытых решений полезно сочетать Terraform/Ansible с практиками тестирования инфраструктуры.
- Продуктовая ориентация управления данными. Управление данными и их качеством требует единых стандартов, политик доступа, классификации данных и процедур резервного копирования/восстановления. В условиях больших кластеров важна роль аудитории и платформы в обеспечении соответствия требованиям регуляторов и бизнес-потребностям.
- Роль команд и культуры. В зрелой среде формируются постоянные команды по эксплуатации кластера, ответственные за устойчивость и развитие среды. Налаженная коммуникация между инженерными, аналитическими и административными подразделениями обеспечивает эффективное коллективное принятие решений и ускорение внедрения изменений.
Инструменты и интеграции
Эффективная экосистема инструментов позволяет реализовать архитектурные решения и управленческие практики в повседневной эксплуатации. В рамках технического подхода уместно упомянуть:
- Ambari как инструмент жизненного цикла кластера - сбор метрик, контроль версий и автоматизацию операций. Он помогает избегать ручных ошибок на schaal-фазах и упрощает повторяемые процессы.
- Prometheus и Grafana для мониторинга и визуализации. Эти решения позволяют строить таргетированные дашборды, настраивать алертинг и анализировать динамику изменения параметров кластера.
- Инструменты управления конфигурациями и IaC - Terraform и Ansible. Они упрощают развёртывание и обновления, поддерживают повторяемость изменений и облегчают тестирование на стендах.
- Безопасность и управление доступом - Apache Ranger или Sentry для разграничения доступа к данным и сервисам. В условиях больших кластеров обеспечение прозрачности доступа становится критически важным.
- Интеграции с обработкой данных и хранением - интеграция с Spark, Hive, Presto и прочими компонентами экосистемы Hadoop. Эти взаимодействия должны быть продуманны с точки зрения производительности и управления безопасностью.
Важно, чтобы набор инструментов соответствовал целям и масштабу кластера. Избыток решений может привести к сложности эксплуатации, в то время как минимальный набор - к нехватке возможностей для автоматизации и мониторинга. Выбор репозитория инструментов должен базироваться на реальных требованиях: частоте изменений, необходимости автоматизации, сложности разворачивания и требованиях к безопасности.
Примеры практических подходов и сценариев внедрения
- Сценарий 1: Разворачивание HA NameNode и Capacity Scheduler. В рамках увеличения кластера с фокусом на критичные задачи аналитики, команда вводит HA NameNode с журналируемым журналом и переключение активного узла. Планировщик задач переводится на Capacity Scheduler для поддержки приоритетов и предсказуемого поведения под нагрузкой. В качестве инфраструктуры применяются IaC-скрипты для быстрой развёртки и тестирования.
- Сценарий 2: Геораспределение данных и ERASURE coding. Для кластера с региональными пользователями реализуются разделенные namespace и использование ERASURE coding для экономии пространства. Обеспечивается межрегиональная репликация согласно требованиям по доступности, включая регламентированный план восстановления.
- Сценарий 3: Автоматизация мониторинга и реагирования на сбои. Включает создание единого дашборда по критическим метрикам, настройку алертинга, автоматическую переконфигурацию в случае дефолтной метрики и запуск регламентированного плана реагирования на инциденты.
Key takeaways
- Масштабирование кластера - это сочетание архитектурной устойчивости, эффективного планирования и управленческого контроля.
- Глобальная архитектура кластера должна поддерживать отказоустойчивость, локализацию данных и минимальные задержки на этапах обработки.
- Эффективная эксплуатация требует системного мониторинга, устойчивых процессов изменений и культуры непрерывного улучшения.
- Инструменты управления конфигурациями и IaC уменьшают риск ошибок и ускоряют развёртывания.
- Важна сбалансированная интеграция инструментов мониторинга, журналирования и безопасности.
- Управленческие практики - ключ к предсказуемости роста: регламентированные изменения, управляемая версия и постинцидентные разборы.
- Правильная стратегия масштабирования учитывает как потребности бизнеса, так и операционные ограничения кластера.
FAQ
Вопрос 1: Как выбрать стратегию масштабирования: Federation против HA NameNode в большом кластере?
Выбор зависит от характера нагрузки и требований к доступности. Federation позволяет разделить пространство имен и масштабировать автономно по секциям данных, что снижает риск перегрузки одного узла. HA NameNode обеспечивает высокий доступ и устойчивость к сбоям одного Namespace, но не дает распределения по именам и не снимает ограничений одной точки отказа в пространстве имен. В практике разумно сочетать Federation с HA NameNode, чтобы иметь и масштабируемость по данным, и устойчивость к сбоям управляющих компонентов. Важно также предусмотреть консистентность и единый риск-менеджмент для всего кластера.
Вопрос 2: Какие узлы масштабировать в первую очередь при росте нагрузки?
При росте нагрузки особенно важно масштабировать вычислительную часть (YARN) и дисковую подсистему, потому что задержки чаще возникают из-за нехватки вычислительных ресурсов и дискового ввода-вывода. Увеличение пропускной способности сети и улучшение локалитета данных тоже критично, чтобы снизить задержки. В зависимости от профиля нагрузки можно начать с увеличения количества NodeManager и DataNode, затем увеличить ResourceManager и HDFS-подсистему, а затем рассмотреть расширение сетевой инфраструктуры и кэширования.
Вопрос 3: Как оптимизировать планировщик задаче в YARN для мультитасковых рабочих нагрузок?
Выбор планировщика должен соответствовать требованию приоритетности задач. Capacity Scheduler хорошо подходит для корпоративных сценариев с четким разделением ресурсов между отделами, а Fair Scheduler - для равномерного распределения ресурсов между различными рабочими очередями. В случаях Spark-пайплайнов и интерактивных запросов полезно использовать гибридный подход и своевременно адаптировать параметры, такие как ограничение ресурсов по очередям, настройку очередей и параметры конфигурации контейнеров. Мониторинг очередей и задержек поможет корректировать параметры в режиме реального времени.
Вопрос 4: Каким образом обеспечить устойчивость к сбоям в крупном кластере Hadoop?
Ключевые элементы - HA для NameNode и ResourceManager, репликация данных HDFS, планирование ремонта и ре-баланса данных после сбоев, а также тестирование процедур восстановления на стендах. Важно иметь регламентированные runbooks для инцидентов, мониторинг и автоматическое уведомление, а также процедуры отката после изменений.
Вопрос 5: Какие практики позволяют быстро масштабировать инфраструктуру без рисков для качества сервиса?
Применение IaC и автоматизированного разворачивания, модульного тестирования изменений, а также регламентированного процесса тестирования в стенде перед переходом в продакшн. Важна повторяемость и нотификация об изменениях. Использование централизованного мониторинга и алертинга позволяет заранее выявлять проблемы до воздействия на пользователей.
Вопрос 6: Какие штрихи безопасности являются критическими для масштабируемого кластера?
Независимый контроль доступа к данным и сервисам, централизованные политики авторизации и аутентификации (Kerberos, Ranger/Sentry), аудит действий пользователей, регулярные проверки конфигураций на соответствие политикам безопасности. В условиях растущего кластера такжеа управлять секретами и конфиденциальной информацией через безопасные хранилища и процессы.
Вопрос 7: Как интегрировать мониторинг и журналирование в существующую экосистему?
Рекомендуется внедрить единый стек для мониторинга и журналирования, который охватывает метрики Hadoop, приложения и инфраструктуру. Prometheus/Grafana для мониторинга, Elasticsearch/Logstash/Kibana для журналирования и алертинг, интеграция с Ambari/Cloudera Manager для управления конфигурациями и обновлениями. Важно обеспечить корреляцию между метриками, журналами и инцидентами для ускоренного расследования.
Вопрос 8: Как снизить стоимость владения при масштабировании?
Эффективно использовать ERASURE coding в HDFS для экономии места, оптимизировать размер блоков и коэффициент репликации, обеспечить баланс между производительностью и стоимостью хранения. Внедрение гибридной инфраструктуры, кэширования и использования SSD-ускорителей для часто используемых данных позволяет снизить задержку и повысить общую эффективность, не увеличивая расходы на хранение пропорционально росту кластера.
Вопрос 9: Как выстроить культуру непрерывного улучшения в эксплуатации Hadoop-кластера?
Разработайте регламентированные процессы постинцидентного анализа, регулярные ревью конфигураций и изменений, поощряйте участие команд в анализе причин сбоев и предложениях по улучшению. Введите практику постоянного обучения, обмена знаниями и документирования лучших практик. Выстраивание взаимодействий между командами разработки, эксплуатации и безопасностью повышает скорость реакции и устойчивость к нестандартным сценариям.


