

Терминология и контекст: Data Lakehouse, S3-совместимое хранилище, BI-слой
Data Lakehouse становится ядром современных архитектур аналитики и бизнес-аналитики, объединяя гибкость хранения сырьевых данных и мощь производительных аналитических движков. В контексте MinIO как S3‑совместимого хранилища эта концепция приобретает практическую форму: хранение данных в объектном формате, поддержка богатыми метаданными слоев и унификация доступа через единый API. Глава формирует базу для эффективной реализации интеграций Spark, Trino, ClickHouse и BI‑слой: от базовых понятий до архитектурных паттернов и практик эксплуатации.
Смысл курса в том, чтобы показать, как эти элементы работают вместе в рамках современного data ecosystem: как выбрать модель хранения, какие данные и форматы хранить, как обеспечить консистентность и управляемость, как устроить доступ для аналитики и отчетности через BI‑пользователя и BI‑слой. В конце главы читатель сможет привести теорию к конкретным решениям по проектированию и внедрению, учитывая требования к масштабируемости, безопасности и автоматизации процессов.
- Data Lakehouse как концепция и ключевые компоненты
- Rationale и принципы использования S3‑совместимого хранилища (MinIO) в рамках аналитических стеков
- Архитектура интеграций Spark, Trino, ClickHouse и BI‑слоя: узлы, формат данных и потоки
- Управление данными и метаданными, безопасность, мониторинг и операционная устойчивость
Data Lakehouse: концепции и эволюция
Data Lakehouse является объединением преимуществ «data lake» и «data warehouse». В основе лежит единый объектный слой для хранения больших массивов данных и слой метаданных, который обеспечивает структурированную интерпретацию данных и поддержку транзакций на уровне метаданных. В этой парадигме данные чаще хранятся в колонночных форматах (Parquet, ORC), что обеспечивает эффективное сжатие и быстрый доступ к колонам во многих аналитических задачах. С точки зрения архитектуры, Lakehouse добавляет к хранению данные слои управления метаданными, транзакционности и схем, что позволяет выполнять ACID‑операции на уровне внешних источников данных и таблиц.
Преимущества Lakehouse состоят в унификации процессов загрузки, трансформаций и аналитики: данные становятся доступны для различных инструментов без сложности миграций и повторной выгрузки. Однако переход к Lakehouse требует внимания к данным метаданных, версиям файлов, схемам и управлению временем жизни данных. В рамках интеграции MinIO это означает, что хранение объектов, файлы Parquet и каталоги должны синхронизироваться с механизмами таблиц и форматами метаданных, чтобы обеспечить согласованность запросов в Spark, Trino и ClickHouse, а также корректную работу BI‑слоя.
Архитектура и слои Lakehouse
- Объектное хранилище как источник данных: суммарный нефильтрованный поток, оптимизированный под масштабируемость и параллелизм.
- Метаданные и управление схемами: каталоги, таблицы, версии, временные метки, транзакционные журналы.
- Форматы колонного хранения и таблиц: Parquet, ORC; поддержка внешних таблиц и функционал источников данных.
- Модели доступа: единый API (S3), подходы к авторизации, аудит, шифрование и управление цепочками доверия.
С точки зрения проектирования инфраструктуры, важно разделять физический слой хранения и логический слой таблиц. MinIO выступает в роли физического хранилища с S3‑совместимым API, ключевым является выбор слоя метаданных и каталога для поддержки транзакций и изменений, а также совместимости с движками анализа.
Роли форматов и метаданных в аналитическом стеке
- Форматы файлов: Parquet обеспечивает эффективное сканирование и компрессию, что критично для больших объемов данных.
- Каталоги и таблицы: Iceberg, Delta Lake или Apache Hudi выступают как слои управления таблицами, предоставляющие транзакции, атомарные операции и схему эволюции.
- Метаданные и lineage: прозрачная прослеживаемость источников, версий и изменений способствует соответствию требованиям управления данными и аудита.
Iceberg, Delta Lake и подобные слои не являются обязательными для каждой реализации, но они заметно упрощают управление схемами, историей и консистентностью в большом масштабе. В связке с MinIO они позволяют строить устойчивые конвейеры данных, где Spark выполняет ETL/ELT‑операции, Trino обеспечивает интерактивный SQL‑доступ к данным, а BI‑платформы - визуализацию и аналитику без повторной загрузки данных.
S3‑совместимое хранилище: принципы и требования к MinIO
MinIO реализует S3‑совместимый интерфейс, ориентированный на высокую производительность, горизонтальное масштабирование и отказоустойчивость. Для аналитических стеков ключевые аспекты включают согласованность данных, модель безопасности, управление версиями объектов, настройку политики доступа и параметры сетевой используемости.
Принципы API S3
- Идентификацию объектов по ключам и структурированным путям, bucket‑правая изоляция и версии объектов для аудита и восстановления.
- Поддержку операций PUT/GET/DELETE, а также список объектов и управление кустами (buckets) через единый REST API.
- Механизмы multipart‑upload, помогающие загружать большие файлы параллельно, что особенно важно для больших файлов Parquet и каталогов данных.
Консистентность и доступность
- MinIO обеспечивает слабую форму консистентности на уровне отдельных операций в некоторых конфигурациях, но в большинстве сценариев следует руководствоваться строгой моделью консистентности читателя после записи для операций с архитектурой Lakehouse.
- Выбор конфигурации распределенного кластера, использование erasure coding и репликаций влияет на доступность и устойчивость к сбоям.
- В рамках интеграций с Spark/Trino/ClickHouse важно учитывать требования к временем фиксации данных и кэшам, особенно при частых обновлениях или мутациях таблиц.
Архитектура и безопасность
- Управление доступом через IAM‑модули и политики, интеграции с внешними системами управления идентификацией.
- Шифрование данных на уровне REST и в покое, контроль версий объектов и аудит доступа.
- Мониторинг и алертинг на уровне API‑пользовательских запросов, объёмов трафика и задержек.
Производительность и масштабирование
- Вертикальная и горизонтальная масштабируемость MinIO, распределение нагрузки через балансировку запросов и оптимизация параллелизма загрузки/чтения.
- Расположение объектов и каталоги по физическим узлам кластера снижают задержки доступа к данным, что особенно заметно при больших параллельных запросах в Spark и Trino.
- Использование кэширования на уровне клиента и промежуточных слоев аналитики для снижения повторных сканов данных.
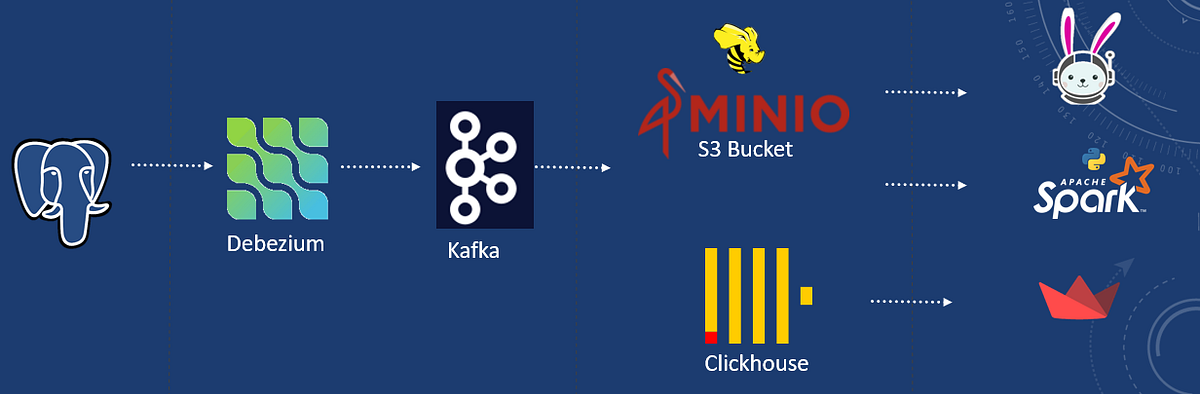
Архитектура интеграций: Spark, Trino, ClickHouse и BI‑слой
Интеграции MinIO с аналитическими движками и BI‑слоем строятся на трех китах: доступ к данным через S3‑совместимый API, управление форматами хранения и метаданными, и организации рабочих потоков от загрузки до визуализации.
Spark: чтение и запись в Lakehouse
Spark предоставляет гибкие механизмы чтения и записи данных в Parquet и других форматах, поддерживая внешние таблицы и таблицы на базе каталога. В связке с MinIO ключевые моменты:
- Использование форматов Parquet/ORC для эффективного сканирования, столбцового доступа и сжатия.
- Работа через данные каталога (Iceberg/Delta Lake) для поддержки ACID‑операций, версий таблиц и времени жизни данных.
- Параллелизм загрузки и выгрузки, управление разделами (partitions) и упорядочиванием данных в Parquet для ускорения срезов и агрегаций.
- В условиях больших объемов стоит стратегически рассмотреть миграцию на Iceberg/Delta для обеспечения транзакций и простого эволюционирования схем.
Trino: интерактивная аналитика над Lakehouse
Trino обеспечивает быстрый SQL‑доступ к данным в MinIO через S3‑совместимый интерфейс. Основные аспекты:
- Объектное хранение как источник данных для внешних таблиц и каталогов.
- Поддержка таблиц Iceberg/Delta Lake как слоя метаданных для эффективной фильтрации и оптимизации запросов.
- Модель кэширования и оптимизации запросов, включая стратегию pushdown и файл‑производительность на уровне форматов Parquet.
ClickHouse: высокопроизводительная аналитика на данных в MinIO
ClickHouse способен читать данные из S3‑совместимого хранилища напрямую, а также работать с внешними таблицами и файловым сервисом. В контексте Lakehouse:
- Использование внешних таблиц для Parquet/ORC в S3‑архиве; оптимизация чтения за счет распознавания схем и совместимой сериализации.
- В сочетании с Iceberg/Delta для управления версиями и обновлениями данных, если это реализовано через слой каталога.
- Распределенная обработка и вертикальное масштабирование ресурсов вычислений при больших объемах запросов.
BI‑слой: от источников к визуализации
BI‑платформы консолидируют данные из Spark/Trino/ClickHouse и представляют их через отчетность, дашборды и планирование. В контексте MinIO и Lakehouse:
- Обеспечение единых источников для отчетности и снижения задержек за счет оптимизаций кэширования и вековых версий данных.
- Путь от источника к отображению: источник в Lakehouse → каталог таблиц → OLAP‑модели/предварифицированные виды → BI‑слой.
- Управление метаданными и lineage, чтобы BI‑пользователь видел происхождение данных, актуальность и время обновления.
- Безопасность и контроль доступа на уровне BI: роли и политики, разделение прав между источниками данных и уровнями представления.
Управление данными, метаданными и операционная устойчивость
Lakehouse требует согласованной политики управления данными и метаданными. Основные аспекты включают:
- Метаданные и каталог: хранение схем, версий таблиц, временных меток и зависимостей между данными. Iceberg/Delta Lake помогают поддерживать транзакционность и эволюцию схем без слепых зон.
- Архитектура и жизненный цикл данных: политики архивации, удаления, версионирования и хранения резервных копий.
- Безопасность и соответствие требованиям: роли, политики доступа к Bucket‑и, шифрование в пути и на диске, аудит операций, хранение ключей и управление секретами.
- Мониторинг и observability: сбор метрик производительности запросов, задержек, числа операций, доступности, журналов и алертинг‑платформы.
- Этики и качество данных: процессы профилирования, данных, обнаружение аномалий, ретроспективный анализ изменений и контроль источников.
Паттерны интеграции и практики эксплуатации
Паттерны хранения и организации данных
- Разделение «операционных» и «аналитических» данных через разные каталоги или уровни в Lakehouse. Это позволяет снизить конкуренцию за ресурсы и ускорить аналитические задачи.
- Разумное использование разделов иpartitioning в Spark и Trino: поддержка эффективного параллельного выполнения и минимизация сканирования не нужных данных.
- Применение Iceberg/Delta как слоя транзакций: обеспечивает атомарные операции и историю изменений без потери согласованности.
Паттерны доступа и консистентности
- Единый источник доступа через S3 API упрощает интеграцию между движками и BI‑слоем.
- Обеспечение согласованности чтения после записи там, где это критично, учитывая особенности архитектуры MinIO и форматов хранения.
- Валидация схем и миграции: управление эволюцией схем без простой деградации доступности.
Практики безопасности и управления кадрами
- Централизованное управление доступом к Bucket‑и и таблицам, разделение ролей между загрузкой данных и анализом.
- Регулярные проверки аудита, журналирования и соответствия требованиям регуляторов.
- Резервное копирование метаданных и файловой базы, тестирование восстановления.
Мониторинг, производительность и оптимизация
- Мониторинг задержек операций и пропускной способности на уровне MinIO, сетевой инфраструктуры и узлов аналитических движков.
- Оптимизация форматов и сжатия: Parquet, соответствующие схемы nested структур.
- Распределенная настройка кэширования на клиенте и сервере для повторных запросов и горячих точек анализа.
Key takeaways
- Data Lakehouse объединяет гибкость хранения в объектном хранилище и управляемость через слои метаданных и транзакционности, что критично для больших аналитических нагрузок.
- MinIO как S3‑совместимое хранилище обеспечивает единый и унифицированный доступ к данным для Spark, Trino, ClickHouse и BI‑слоя, требуя внимания к консистентности, безопасности и производительности.
- Правильная архитектура требует выбора слоев метаданных (Iceberg/Delta), корректной схемой организации данных и разумной политики жизненного цикла.
- Интеграции с Spark, Trino и ClickHouse опираются на параллельную обработку, форматы Parquet и внешние таблицы, что позволяет достигать эффективной производительности и гибкости.
- BI‑слой должен опираться на единый источник данных, обеспечивать lineage и прозрачность доступа, поддерживать аудит и соответствие.
- Безопасность, аудит и мониторинг интегрированы на каждом уровне: от MinIO до BI‑пользователя, что повышает устойчивость архитектуры.
- Практические паттерны: разделение оперативных и аналитических данных, использование таблиц метаданных, контроль версий и продуманная загрузка данных снижают риски и упрощают эволюцию инфраструктуры.
FAQ
- Что такое Data Lakehouse и чем он отличается от традиционных Data Lake и Data Warehouse?
Data Lakehouse представляет собой объединение преимуществ двух подходов: гибкое сохранение неструктурированных и структурированных данных в объектном хранилище (как в Data Lake) и управляемость, транзакционность, схемы и быстрые аналитические запросы (как в Data Warehouse). В Lakehouse используется слой метаданных (каталог), транзакционная поддержка и форматы колонного хранения, что позволяет выполнять сложные аналитические задачи без необходимости копирования данных между репозиториями.
- Какие роли играет MinIO в Lakehouse‑архитектуре?
MinIO служит физическим S3‑совместимым хранилищем, где размещаются данные в Parquet/ORC и другие форматы, а также каталоги и версии таблиц. Он обеспечивает единый доступ через S3‑API, масштабируемость и отказоустойчивость. В связке с Iceberg/Delta Lake MinIO позволяет реализовать транзакционность, эволюцию схем и управляемый жизненный цикл данных, сохраняя при этом совместимость со Spark, Trino и BI‑слоем.
- Как выбрать между Iceberg, Delta Lake и Delta‑Pager в контексте MinIO?
Iceberg и Delta Lake - это слои управления таблицами, которые добавляют транзакционность, эволюцию схем и версионирование. Выбор зависит от стека: Spark и Trino традиционно хорошо работают с Iceberg, тогда как некоторые сценарии с Delta Lake проще реализовать в рамках конкретной платформы или экосистемы. В любом случае важно обеспечить поддержку ACID‑операций и единый каталог метаданных, чтобы BI‑слой имел устойчивый доступ к данным и их версиям.
- Какие требования к консистентности данных в MinIO при частых обновлениях?
MinIO поддерживает консистентность на уровне операций и предоставляет механизмы для контроля версии объектов и атомарных операций в рамках каталогов таблиц. При частых обновлениях рекомендуется использовать слои таблиц (Iceberg/Delta) для обеспечения атомарности и корректной истории изменений, а также продуманную стратегию кэширования в клиентах вычислений и BI.
- Какие вызовы возникают при интеграции Spark с MinIO?
Ключевые вызовы - обеспечение эффективного сканирования Parquet файлов, настройка разделов (partitions), корректная работа с каталогами и форматами таблиц, а также согласование версии и схемы между Spark и слоем метаданных. Важным является направление изменений через транзакционный слой, чтобы Spark мог безопасно прочитать согласованные версии таблиц.
- Как Trino обеспечивает интерактивность при работе с MinIO?
Trino обеспечивает быстрый SQL‑доступ к данным в MinIO через S3 API и внешние таблицы Iceberg/Delta, применяя pushdown к фильтрам, распознавая разделы и оптимизируя сканирование. При этом критично правильно настроить каталоги и схемы, чтобы запросы не сканировали данные без нужды, а выполнялись по индексации и статистике.
- Как ClickHouse взаимодополняет MinIO в Lakehouse?
ClickHouse может читать данные из S3‑совместимого хранилища напрямую и обрабатывать их на высокой скорости. Это полезно для интерактивной аналитики и дашбордов. Для более сложного управления схемами и версиями лучше сочетать ClickHouse с Iceberg/Delta как слоем метаданных, чтобы сохранить согласованность и историю изменений.
- Какие практики обеспечивают устойчивость BI‑слоя в контексте MinIO?
BI‑слой требует единых источников, прозрачности lineage и контроля доступа. Встроенная интеграция с Lakehouse обеспечивает актуальные данные и версии, а также возможность аудита. Важны кэширование, своевременная синхронизация моделей данных и обеспечение безопасного доступа к данным через роли и политики.
- Какие риски существуют при неправильной архитектуре и как их минимизировать?
Риски включают несогласованность данных между движками, потерю версий и слепые зоны в данных, слабый контроль доступа и проблемы с доступностью. Риск можно минимизировать за счет использования Iceberg/Delta как слоя метаданных, строгих политик доступа, регулярного аудита и мониторинга, а также тестирования восстановления данных и репликации.
- Какие шаги на старте проекта помогут быстрее достичь целей?
Начните с определения сценариев использования и требуемой модели данных: какие источники и какие форматы нужны. Затем выберите слой метаданных (Iceberg/Delta) и спроектируйте каталоги таблиц и схему. Настройте MinIO в соответствии с требованиями безопасности и производительности, подключите Spark/Trino/ClickHouse, и реализуйте базовые ETL/ELT‑потоки и BI‑слой. Затем постепенно добавляйте паттерны транзакций, версий и мониторинга, чтобы обеспечить устойчивую и расширяемую архитектуру.


