

Архитектурные паттерны интеграции DWH и XBRL: ETL/ELT, data virtualization и микросервисы
Взаимодействие DWH и XBRL требует продуманной архитектуры, которая обеспечивает своевременную генерацию отчётности по таксономиям, корректную маппинг-валидацию фактов к концептам XBRL и при этом сохраняет полную трассируемость данных. Выбор паттернов ETL/ELT, возможностей data virtualization и микросервисной структуры напрямую влияет на скорость внедрения, масштабируемость и устойчивость к изменениям налоговых нормативов и финансовой отчетности. В данной главе рассматриваются архитектурные решения и принципы реализации, которые позволяют обеспечить единый источник истины для XBRL-отчётности из DWH и сопутствующих источников.
Дорожная карта интеграции состоит из нескольких слоёв: слой источников данных и бизнес-правил, слой маппинга и таксономий XBRL, слой подготовки и валидации фактов, слой формирования XBRL-документов и механизмов аудита, а также слой сервисов для эксплуатации и мониторинга. В рамках паттернов ETL/ELT акцент делается на правила трансформации и выбор места исполнения - внутри ETL-агентов или непосредственно в DWH. Data virtualization выступает мостом между различными системами, снижающим копирование данных и ускоряющим доступ к моделям знаний, а микросервисы разделяют зоны ответственности, обеспечивая явные контракты и повторное использование логики преобразований и валидации.
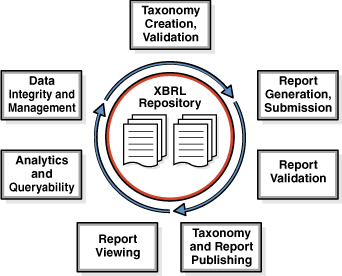
Краткое содержание главы
- Архитектурные принципы: требования к трассируемости, целостности данных и соответствию Taxonomy-версиям XBRL.
- Паттерны ETL и ELT: когда и почему выбирать тот или иной подход, влияние на производительность и консистентность.
- Data virtualization как мост между источниками: концепция, плюсы и ограничения, организационные аспекты внедрения.
- Микросервисы и сервисная архитектура интеграции: контрактная модель, устойчивость к изменению таксономий, организационные принципы.
- Валидация и контроль качества: тестирование трансформаций, проверки соответствия XBRL-формату, аудит и мониторинг.
Контекст и цели архитектуры интеграции DWH и XBRL
Формирование XBRL-отчётности начинается с точного отображения фактов учреждения в концепты таксономий. Это требует не только точного маппинга полей, но и контроля за темпами загрузки, источниками данных, валидностью единиц измерения и периодов. Архитектура должна поддерживать:
- Трассируемость и аудит изменений: любая трансформация должна оставлять следы в lineage, чтобы можно было восстановить источник фактов и временные этапы генерации XBRL-документов.
- Управление версиями таксономий: поддержка нескольких версий таксономий, соответствие выпуску нормативных актов и способности откатиться к предыдущим версиям при необходимости.
- Интеграцию разнотипных источников: ERP, CRM, банковские и учетные системы, внешние источники для консолидированных показателей - все должны приходить в единую схему и корректно маппиться на концепты XBRL.
- Надёжность и производительность: пакетная обработка, резервирование, обработка больших объёмов фактов и одновременная генерация множества инстансов XBRL.
- Гигиену данных и качество: верификация уникальности записей, полноты фактов по каждому периоду, корреляцию между фактовыми и контекстуальными данными.
Важно осознавать, что выбор паттерна исполнения трансформаций (ETL vs ELT) влияет на задержку между источником и готовым документом, на требования к вычислительным ресурсам и на возможность оперативной адаптации под изменение Taxonomy. В контексте XBRL ключевые требования к архитектуре включают поддержку "происхождения" каждого факта, возможность повторной генерации документов и возможность верификации с использованием отдельных валидаторов XBRL-документов.
ETL против ELT на стыке DWH и XBRL: выбор паттерна и алгоритмы
Традиционный ETL-паттерн предполагает извлечение данных из источников, их преобразование в промежуточном слое и загрузку уже готовых фактов в целевые структуры XBRL или в staging-слой, из которого затем формируются инстансы. ELT-организация переносит большую часть вычислений в целевой DWH или облачный хранилище данных, используя мощность аналитических платформ. Различия в подходах влияют на контроль версий трансформаций, на задержку подготовки инстансов и на требования к ресурсам.
- Преимущества ETL: большую часть логики трансформаций можно централизовать и валидировать до загрузки в DWH, что упрощает прослеживаемость исходников и снижает риск частичных ошибок в процессе генерации инстансов. Это полезно на ранних стадиях проекта, когда Taxonomy часто обновляется, а требование к консистентности данных выше.
- Преимущества ELT: высокая гибкость и масштабируемость за счёт выполнения трансформаций внутри мощной вычислительной платформы DWH/облака; удобство адаптации под частые обновления Taxonomy, поскольку можно повторно выполнить трансформацию на полном объёме данных. Это особенно ценно при больших объёмах данных и необходимости быстрой адаптации к новым формам представления фактов.
Реальный выбор часто зависит от следующих факторов:
- Скорость изменений Taxonomy и частота обновления справочников: ELT облегчает адаптацию за счёт повторной трансформации, не требуя радикального изменения внешних ETL-процессов.
- Объём данных и доступная вычислительная инфраструктура: если целевые хранилища мощны и оптимизированы под аналитические запросы, ELT может дать выигрыш по задержке данных; при ограничениях инфраструктуры предпочтительнее ETL с валидацией до загрузки.
- Необходимость строгой пред-валидации: для некоторых реестров требуется строгий контроль на этапе загрузки; тогда ETL-цепочка с валидациями и тестами на входе может быть предпочтительнее.
- Вариативность источников и частота изменений схем: ETL упрощает внедрение новых источников за счёт строгой схемной конвертации на входе, тогда как ELT делает адаптацию более зависимой от возможностей целевого DWH.
Алгоритм реализации может выглядеть так:
- ETL: извлечение данных, кросс-валидации с бизнес-правилами, нормализация полей под концепты XBRL, сохранение в staging, загрузка в целевые структуры и затем генерация инстансов.
- ELT: загрузка «сырых» фактов в staging, выполнение трансформаций через SQL-операторы и хранимые процедуры в целевом хранилище, формирование факт-таблиц и инстансов XBRL на базе готовых маппингов и правил.
В бытовом примере ELT-подхода можно рассмотреть упрощённый сценарий трансформации фактов в DWH без лишней копии данных за пределами хранилища. Такой подход позволяет централизовать логику трансформации и ускорить обновления Taxonomy. В качестве иллюстрации приведён упрощённый SQL-процесс, который выполняется внутри DWH после загрузки staging-данных:
-- Пример ELT-логики: загрузка исходных фактов, последующая трансформация в DWH
INSERT INTO xbrl_facts (entity_id, period, concept, value, unit)
SELECT s.entity_id, s.period, m.concept, s.value, m.unit
## FROM staging_fact s
JOIN taxonomy_mapping m ON s.source_field = m.source_field
WHERE s.source_system = 'ERP';
Важно помнить, что столь простой фрагмент не заменяет полноценной модельной архитектуры. Он иллюстрирует концепцию переноса вычислений в хранилище, но требует строгого управления зависимостями, координации версий маппинга и надёжной обработкой ошибок. В реальных системах ELT будет дополняться слоями управления качеством данных, проверками целостности и регламентами отката.
Data virtualization как мост между разнотипными источниками и процессами XBRL
Data virtualization выступает как слой логической интеграции, который позволяет формировать единое представление бизнес-данных над источниками, не требуя физического копирования данных во всех случаях. Для интеграции DWH и XBRL virtualization имеет ряд преимуществ:
- Мгновенная доступность к актуальным данным: можно выполнять запросы к ERP, BMS, внешним репозиториям и DWH через единый семантический слой, что упрощает маппинг и ускоряет генерацию фактов для Taxonomy.
- Концептуальная абстракция: семантические модели и понятия XBRL можно описать в виде словарей, которые затем связываются с физическими источниками через маппинг-слои виртуализации.
- Гибкость в адаптации к изменениям: при обновлениях Taxonomy или добавлении новых источников не требуется копирование больших объёмов данных, достаточно обновить контракты на уровне виртуального слоя.
- Контроль доступа и безопасность: virtualization позволяет реализовать унифицированные политики доступа, которые применяются к любым источникам данных, включая чувствительную финансовую информацию.
- Поддержка разных форматов и API: REST/gRPC-интерфейсы, соединение с DWH через JDBC/ODBC и прямые запросы к источникам.
Однако у virtualization есть и ограничения, которые следует учитывать:
- Задержка и производительность: реальный pushdown вычислений в источники и кэширование зависят от реализации и объёма данных.
- Управление семантикой: необходимо строгие правила соответствия между бизнес-терминами Taxonomy и физическими атрибутами источников.
- Модель управления данными: требуется четкая стратегия версионирования контекстов и маппинга, чтобы не возникало расхождений между версиями таксономий и данными в источниках.
С точки зрения практических решений можно опираться на двух подходящих примерах. Во-первых, концептуальные и открытые инструменты для интеграции и маппинга: Arelle как валидатор XBRL, который может работать в связке с виртуализацией для проверки соответствия инстансов и таксономий. Во-вторых, коммерческие решения по data virtualization, которые поддерживают масштабируемое соединение с DWH и внешними источниками, например Denodo или Dremio. Выбор конкретного продукта определяется требованиями по производительности, требованиям к лицензированию и интеграционной совместимости. В рамках данного раздела достаточно упомянуть эти примеры как ориентиры: они иллюстрируют реальные варианты реализации, но не обязуются быть единственно верными.
Инфраструктурная схема virtualization может выглядеть как набор слоёв: семантический слой, который описывает концепты и связи с источниками; адаптеры источников, обеспечивающие доступ к данным; слой кэширования и оптимизации запросов; слой маппинга факторов и таксономий; и слой действий по формированию XBRL-инстансов. Интеграция с Taxonomy-менеджером и валидатором в этом контексте становится логикой бизнес-правил, прописанной в контрактно-семантических сервисах.
{
  "source": "ERP",
  "period": "2023-12",
  "taxonomyVersion": "Tax-2023.1",
  "mappingProfile": "FIN-CORE",
  "action": "generateXBRLInstance"
}
Микросервисы и сервисная архитектура интеграции
Разделение архитектуры на микросервисы становится природной реакцией на требования гибкости и скорости адаптации к изменениям в Taxonomy и источниках данных. Основные принципы:
- Разделение по доменам: сервисы маппинга, обработки Taxonomy, валидации и генерации инстансов XBRL выделяются в независимые сервисы. Это позволяет обновлять логику в рамках одного домена без риска затронуть другие части цепочки.
- Контракты и версионирование: OpenAPI-описания контрактов должны быть стабильными и версионироваться вместе с изменениями маппинга и правил валидации. Контракты позволяют другим сервисам строить надежные потребители и упрощают CI/CD.
- Асинхронность и устойчивость: обмен сообщениями через брокеры (например, Kafka) обеспечивает устойчивость к временным сбоям источников, позволяет повторно обрабатывать события и делает цепочку более надёжной.
- Idempotentность и аудит: сервисы должны быть идемпотентными, чтобы повторные сообщения не приводили к дубликатам фактов или инстансов; каждое изменение должно быть записано в журнал аудита и lineage.
- Безопасность и соответствие: маршруты, авторизация, шифрование данных в движении и в хранении должны быть встроены в архитектуру сервисов.
В контексте микросервисной архитектуры кросс-функциональные сервисы могут включать:
- Cервис маппинга: управляет маппингами между полями источников и концептами XBRL; держит версию маппинга и продукты трансформаций.
- Cервис Taxonomy: инкапсулирует логику загрузки и обновления таксономий, обеспечивает проверки форматов и версий.
- Cервис проверки качества: выполняет линейку тестов на полноту, согласованность и корректность контекстов XBRL.
- Сервис формирования инстансов: отвечает за генерацию XBRL-документов (инстансов) на основе результатов трансформаций и маппинга.
- Сервис оркестрации: управляет рабочими потоками, зависимостями и расписанием выполнения задач, управляет очередями и мониторингом.
Ключевые протоколы и форматы взаимодействия в такой архитектуре включают REST и gRPC для синхронного взаимодействия между сервисами, а также события и сообщения через Kafka для асинхронной обработки. Для обмена структурированными данными могут применяться JSON или Avro-схемы, где JSON удобен для внешних потребителей, а Avro обеспечивает более компактную и типизированную передачу внутри инфраструктуры.
Ниже приведена упрощённая схема контрактного взаимодействия между сервисами:
- Маппинг-сервис предоставляет API для запроса маппинга и возвращает "mappingId" и набор концептов.
- Taxonomy-сервис возвращает версию таксономии и валидаторы для конкретной версии.
- Генератор инстансов вызывает Маппинг и Taxonomy, получает результаты и формирует XBRL-инстанс, отправляя событие в очередь для дальнейшей проверки.
Такой подход поддерживает устойчивость к изменениям в Taxonomy и изменяющимся требованиям регуляторов, позволяя переработать одну часть цепочки без нарушений остального контура.
Проверки, качество данных и валидация XBRL-отчетности
Качество данных и валидность XBRL-отчётности требуют системного и многоступенчатого подхода. Валидационные шаги следует строить на нескольких уровнях:
- Контекст и полнота: проверки наличия контекстов для каждого факта, соответствие периодов и единиц измерения.
- Маппинг и концепты: валидация соответствия полей источников концептам Taxonomy, минимизация ошибок «незаданных» полей и несоответствий.
- Валидаторы Taxonomy: использование валидаторов XBRL для проверки соответствия инстансов таксономии и форматов XML/XBRL; здесь может быть использован открытый валидатор, например Arelle, интегрированный в пайплайн.
- Инстансная целостность: проверки целостности между фактами и другими элементами инстанса (например, контекстами и единицами измерения), контроль корректной числовой арифметики.
- Граф аудита: трассируемость происхождения каждого факта, прозрачность этапов обработки, регистрация изменений и возможность отката.
- Комплаенс и регуляторные требования: контроль по версиям Taxonomy и соответствующим наборам правил гласят, какие концепты допустимы в той или иной версии таксономии, чтобы снизить риск несоответствий.
Этапы тестирования можно разделить на:
- Юнит-тесты трансформаций и правил маппинга для отдельных концептов.
- Интеграционные тесты: проверяют корректность работы цепочки от источника до формирования XBRL-инстанса, включая внешние сервисы и зависимости.
- Непрерывная валидация на стадии генерации инстанса: запуск валидаторов на созданных XBRL-документах с возвратом ошибок и предупреждений.
- Регрессионное тестирование: проверка того, что новые версии Taxonomy и маппингов не ломают существующую отчетность.
Постоянное мониторирование процессов в реальном времени и периодический аудит обеспечивают раннее обнаружение противоречий и эффектов регуляторной динамики. В части инфраструктуры стоит настроить показатели производительности и задержек данных на каждом шаге, чтобы иметь возможность оперативно реагировать на узкие места и планировать масштабирование.
Производительность, безопасность и операционное управление
Эффективная архитектура должна обладать понятной стратегией мониторинга, планирования обновлений Taxonomy и контроля за безопасностью. Вопросы, относящиеся к продуктивной эксплуатации, включают:
- Мониторинг и телеметрия: сбор метрик времени выполнения, полноты загрузок, задержек на стадии маппинга и валидации; использование распределённых трассировок для диагностики узких мест.
- Планирование изменений: управление версиями Taxonomy и маппингов, предварительная проверка в тестовой среде, затем постепенный переход в продуктивную среду.
- Безопасность и соответствие: разграничение доступа к данным и контурами в рамках микросервисной архитектуры, безопасное хранение секретов, журналирование доступа к документам XBRL.
- Управление ресурсами: горизонтальное масштабирование вычислительных компонентов, кэширование результатов запросов к virtualization слою, настройка очередей для асинхронной обработки.
- Операционные процедуры: регламенты отката, резервное копирование критических данных и возможность быстрого восстановления цепи от источников до инстансов.
Эти принципы заложены в архитектуре и облегчают переход от пилотного внедрения к промышленной эксплуатации. В реальной реализации целесообразно соединить сбор метрик с пайплайнами непрерывной интеграции и доставки (CI/CD) для кода трансформаций, проверок и сервисов, чтобы изменения проходили через автоматизированные тестовые сценарии и быстро внедрялись в продуктив.
Key takeaways
- Выбор между ETL и ELT определяется характером данных, частотой обновления Taxonomy и доступной инфраструктурой. ELT чаще оказывается эффективнее при больших объёмах и необходимости быстрой адаптации к изменениям таксономий.
- Data virtualization снижает избыточное копирование данных и ускоряет доступ к разнотипным источникам, но требует чёткого управления семантикой и версионированием контрактов.
- Микросервисная архитектура для интеграции XBRL обеспечивает гибкость, повторное использование логики и устойчивость к изменениям, однако требует дисциплины в контрактной работе и мониторинге.
- Валидаторы XBRL, линейка тестов и аудит данных должны быть встроены в конвейер как обязательный элемент, чтобы обеспечить соответствие требованиям Taxonomy и регуляторным актам.
- Контроль версий Taxonomy и маппингов, а также строгие политики доступа и аудита - основа надёжного и прозрачного процесса формирования XBRL-инстансов.
- Производительность и масштабируемость достигаются за счёт грамотного проектирования потоков, внедрения кэширования там, где это возможно, и рационального распределения задач между сервисами.
- Взаимоувязка технических решений с бизнес-целями: архитектура должна позволять быстро адаптироваться к изменениям регуляторной среды и бизнес-процессов без потери качества и аудируемости.
FAQ
- В чём основная разница между ETL и ELT в контексте XBRL-отчётности?
- ETL переносит трансформации до загрузки данных в целевые структуры, что обеспечивает раннюю валидацию и более детальный контроль на входе, но может замедлять адаптацию к изменениям Taxonomy. ELT перемещает большую часть вычислений в целевую среду (DWH), что улучшает гибкость и масштабируемость, особенно при частых обновлениях таксономий, но требует надёжной инфраструктуры и эффективного управления версиями маппинга и трансформаций внутри DWH.
- Какие преимущества даёт data virtualization в рамках формирования XBRL?
- Обеспечивает единое представление разнотипных источников без необходимости копирования больших объёмов данных, ускоряет доступ к данным для маппинга и валидации, облегчает согласование между источниками и Taxonomy. Однако требует тщательного управления семантикой и контрактами между сервисами.
- Какие сервисы стоит выделить в микросервисной архитектуре интеграции DWH и XBRL?
- Сервис маппинга, сервис Taxonomy, сервис валидации, сервис генерации инстансов XBRL, сервис оркестрации. Каждый сервис имеет чётко определённый контракт и версионирование, что упрощает обновления и тестирование.
- Какие инструменты можно использовать для валидирования XBRL-инстансов?
- Открытые валидаторы, например Arelle, в связке с собственными валидаторами и тестами маппинга. Комбинация этих инструментов обеспечивает проверку соответствия инстансов таксономиям, форматов XML и формулам XBRL.
- Как обеспечить трассируемость и аудит на уровне архитектуры?
- Нужно внедрить глубинную трассировку lineage на каждом этапе цепочки: источник данных - маппинг - промежуточные факты - инстанс XBRL. Логи и события должны сохраняться в безопасном хранилище, доступ к которым регулируется политиками аудит- контроля.
- Какие риски связаны с переходом на ELT?
- Необходимо обеспечить корректную настройку pushdown-процессов, чтобы не возникало несогласованности правил трансформаций между источниками и Taxonomy. Требуется тщательное управление версиями маппинга и Taxonomy, а также мониторинг задержек обработки.
- Какой подход лучше для контроля качества на этапах загрузки и трансформаций?
- Комбинация: ETL-этап для критических трансформаций и валидаций на входе с сильной логикой тестирования и аудита, плюс ELT-подход внутри DWH для ускорения обработки и адаптации к обновлениям таксономий. Валидационные пайплайны должны быть интегрированы в CI/CD и мониторинг.
- Какие требования к безопасности особенно критичны в таких системах?
- Контроль доступа к данным на основе ролей, безопасное хранение секретов, шифрование в движении и в покое, аудит доступа к документам XBRL и журналам событий, а также соответствие регуляторным требованиям по хранению и обработке финансовых данных.
- Какие факторы влияют на выбор инструментов virtualization и валидаторов?
- Масштабируемость, поддержка нужных API, совместимость с используемой DWH и Taxonomy, а также стоимость лицензирования. Важен способ интеграции с текущей инфраструктурой и возможность ускорения запросов через pushdown-оптимизации.
- Как оценивать успех внедрения архитектуры DWH-XBRL?
- Метрики производительности (время от источника до инстанса), полнота и точность маппинга, доля автоматизированной валидации, уровень аудита и трассируемости, а также время реакции на обновления Taxonomy и регуляторных требований. Регулярный аудит и мониторинг позволяют поддерживать высокий уровень качества и соответствия.
Глава представлена как систематизированный подход к архитектурной реализации интеграции DWH и XBRL с акцентом на технические паттерны, протоколы и инструменты. Приведённые концепции применимы к разным контекстам - от крупных регуляторных проектов до независимых финансовых подразделений - и ориентированы на обеспечение надёжности, адаптивности и прозрачности процессов формирования XBRL-отчётности из данных DWH.


