Эволюция стека данных: история о том, как мы обрабатываем постоянно растущие объемы данных
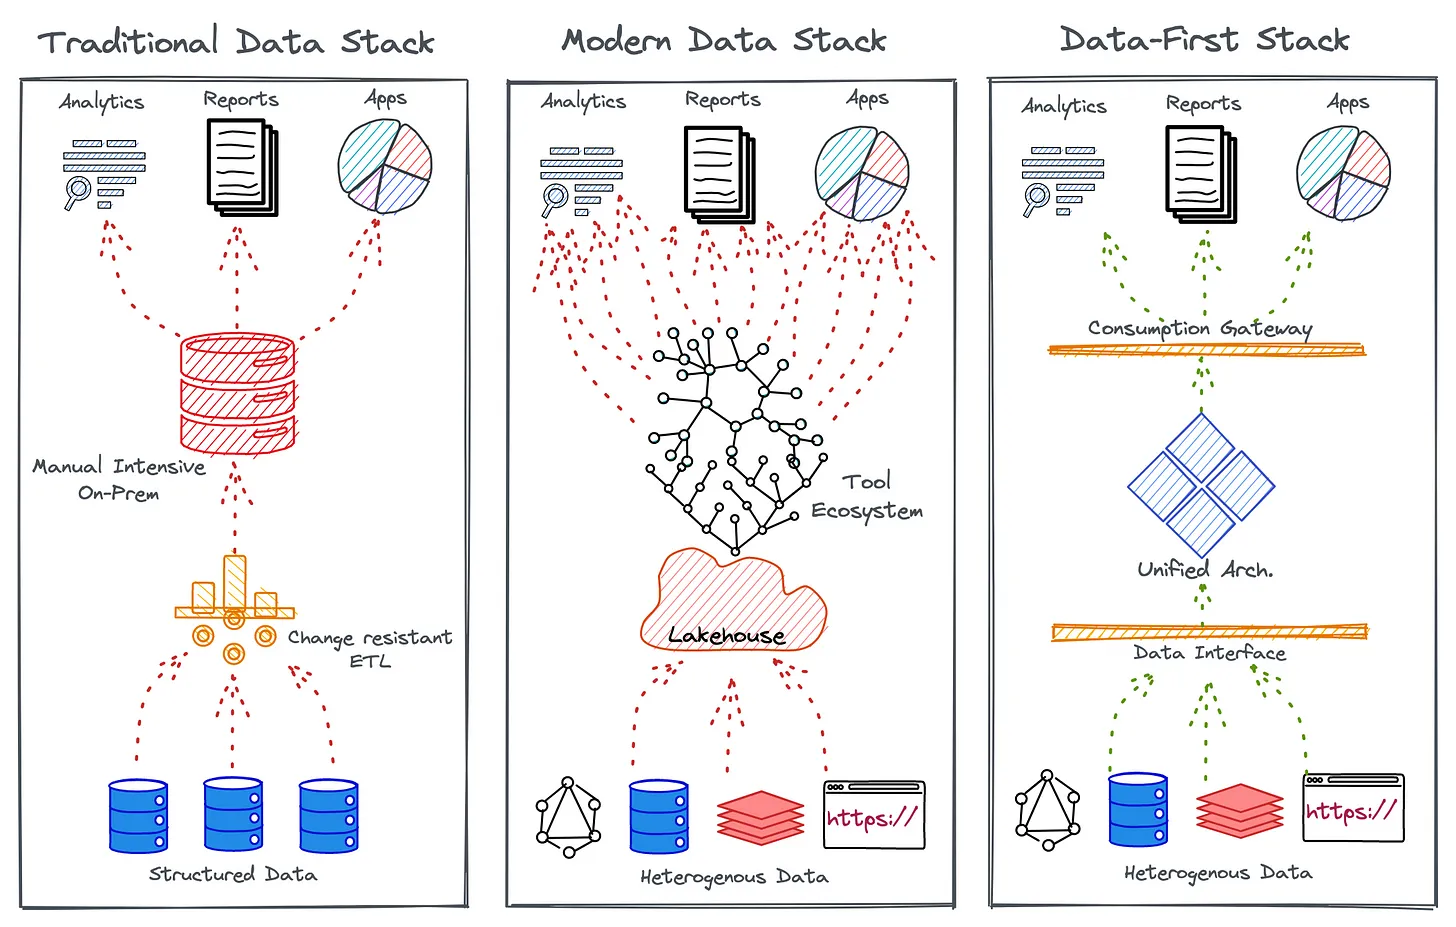
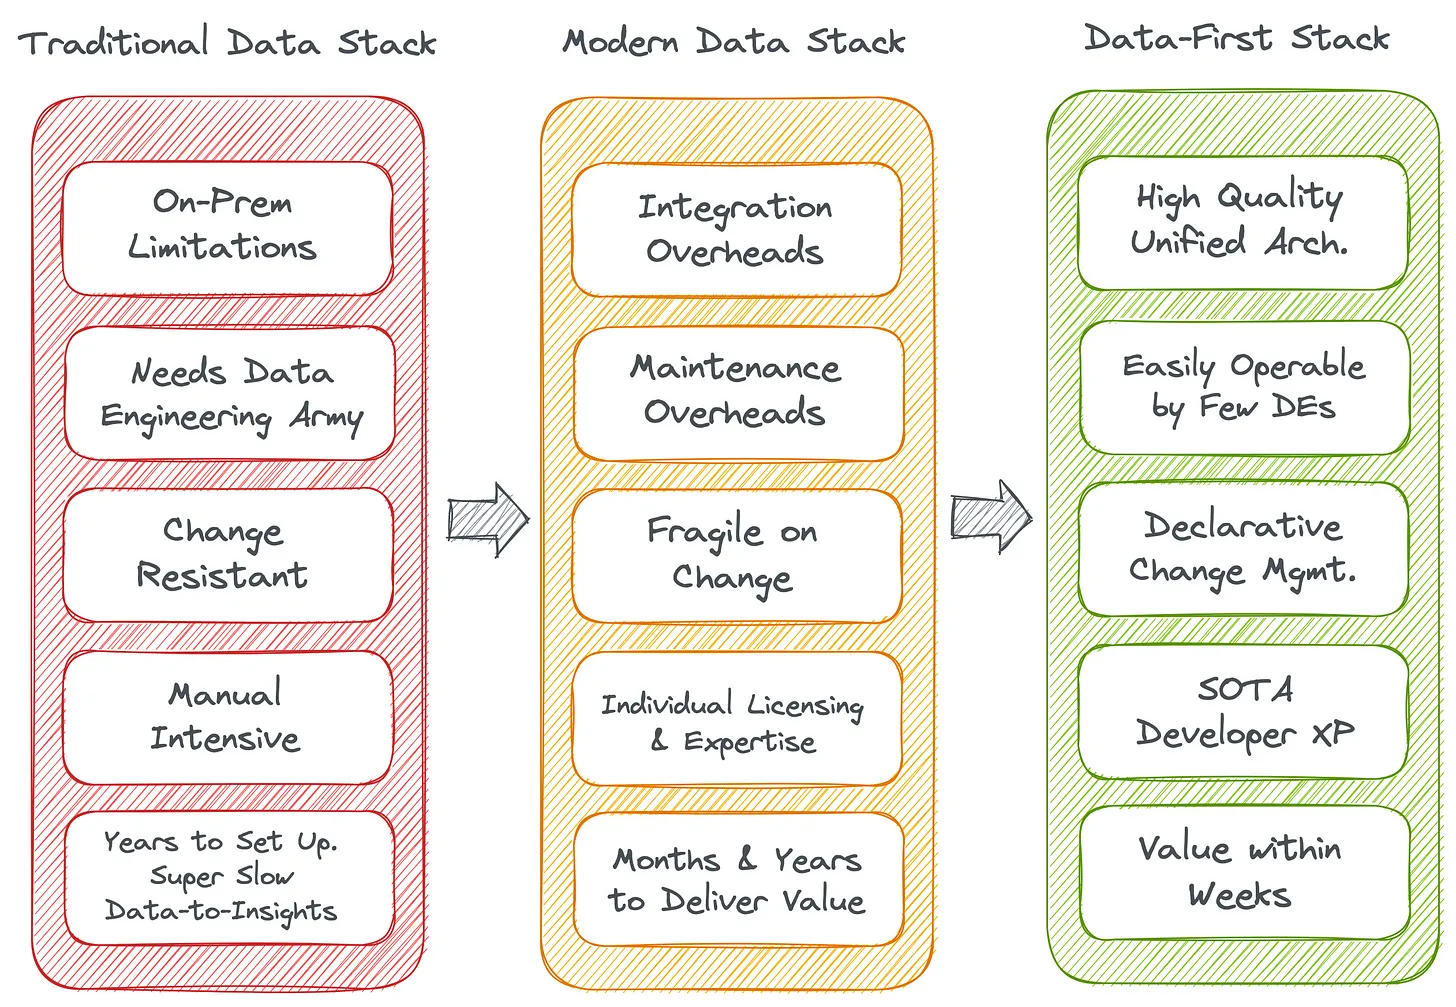
Традиционный стек данных -> Современный стек данных -> Стек «Сначала данные»
Если Вы когда-либо были связаны с данными, то готов поспорить, что Вы уже успели испытать на себе все «прелести» хаотичной экосистемы данных. Нет и тени сомнения в том факте, что мир данных претерпел значительнейшие изменения, проделав для этого достаточно долгий путь.
Сегодня практически невозможно представить себе то, чтобы работа с данными проводилась исключительно вручную, и это касается не только крупных, но и малых предприятий. Каждый клик, каждый просмотр, каждое событие имеет значение для бизнеса и потенциально несет в себе прибыль только в том случае, если все паттерны настроены правильным образом.
Представьте себе, что количество этих событий умножено в несколько раз и в итоге составляет миллион или даже миллиард событий... Как в таком случае Вы будете обрабатывать этот объем и при этом сможете гарантировать, что данные не просто занимают дорогостоящее место, но и представляют собой ценность для бизнеса?
Эволюция стека данных
Стек данных постоянно эволюционирует ввиду необходимости размещения постоянно растущего объема данных. На самом деле, вырос не объем данных, они были всегда. Скорее увеличилось количество технологий, с помощью которых мы можем получить те или иные данные. Например, современные устройства IoT в состоянии обработать дыхание и движения людей, чтобы оптимизировать кондиционирование воздуха в помещении.
Однако, если способности получать и читать данные заметно прогрессировали, то способности обрабатывать, управлять и понимать эти самые данные развились в значительно меньшей степени. Другими словами, у нас есть глаза, уши, кожа, язык и нос, но нам все еще не хватает зрелого мозга, который смог бы понять и оптимизировать все вводные данные, поступающие по этим каналам восприятия.
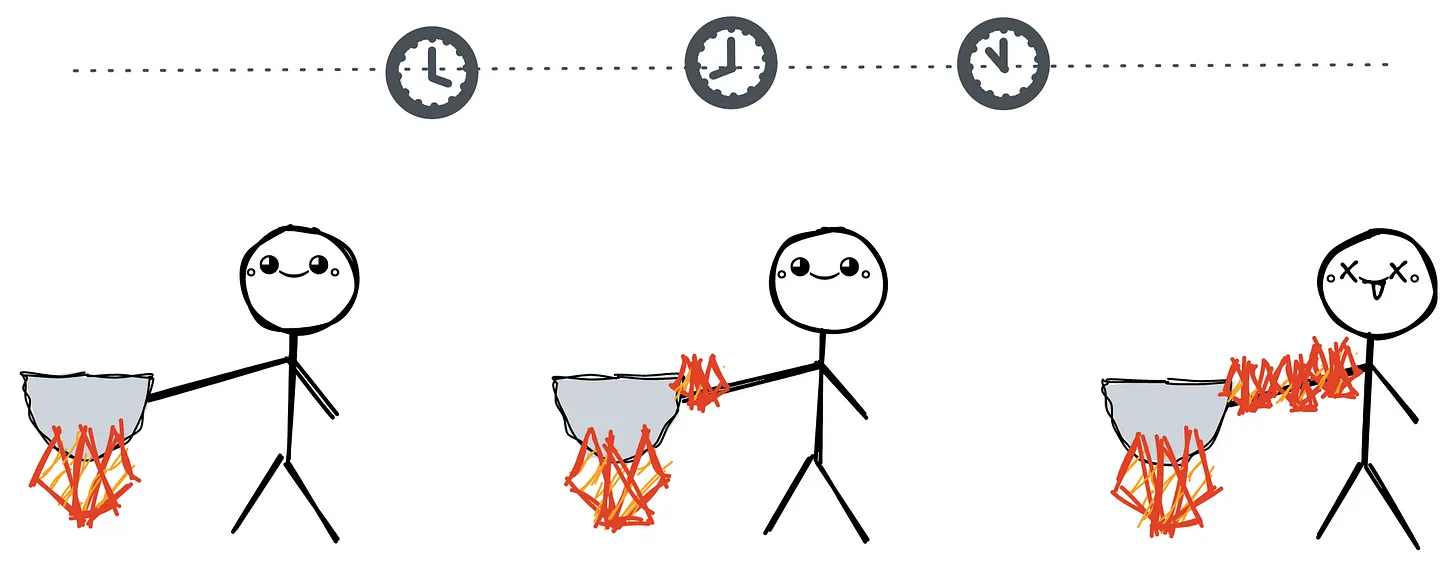
Если бы общепринятый стек данных был человеком...
Первые шаги: традиционный стек данных
Данные существовали всегда, и даже в будущем в них совершенно точно не будет недостатка. Мы, как индустрия, хорошо усвоили тот факт, что эти самые данные можно и нужно использовать для оптимизации отдачи от используемых ресурсов.
Ключевой момент, на который здесь следует обратить внимание, заключается в том, что основной целью использования данных было и будет улучшение бизнес-опыта и увеличение прибыли.
Первыми шагами на пути к достижению операционализации данных стал традиционный стек данных. Конечно, на тот момент это был не «традиционный» стек данных, это был просто стек данных. Это несколько меняет перспективу, не так ли? Ведь через десятилетие или два преобладающий сегодня вид стека данных также можно будет с легкостью назвать традиционным и даже устаревшим.
Что такое традиционный стек данных? И почему он устарел?
Традиционный стек данных (англ. traditional data stack, TDS) — это еще одно название локальных систем данных. Раньше организации работали с собственной инфраструктурой и оборудованием, что требовало не только интенсивного ручного труда, но и высокой стоимости обслуживания оборудования, было неудобно с точки зрения масштабируемости (необходимости предоставления новой инфраструктуры или аппаратного обеспечения каждый раз, когда стек нужно было масштабировать), чрезвычайно сложного анализа первопричин (RCA) или его отсутствия и т.д.
Поскольку компоненты TDS, будь то хранилища или кластеры больших данных, тесно связаны друг с другом, крайне сложно отделить логические требования от необработанных физических данных, что значительно замедляет бизнес-процессы, восстановление и возможности RCA.
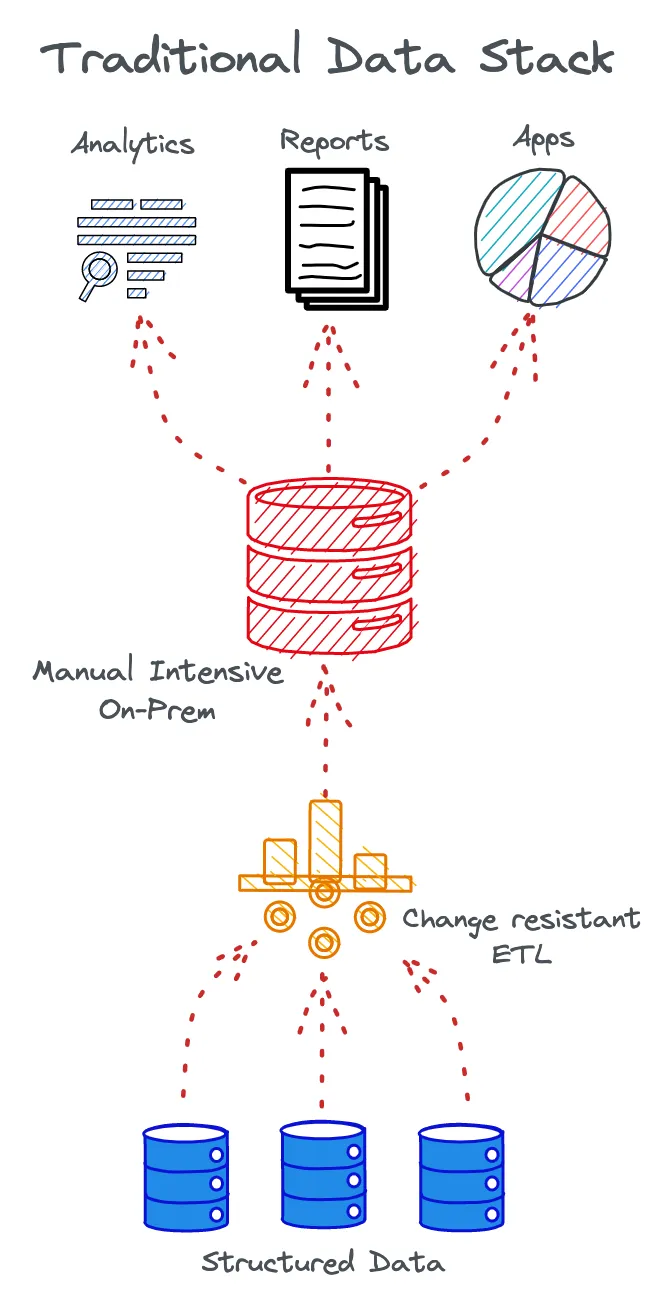
Интенсивность ручного труда и тесная взаимосвязь также являются причиной высокой хрупкости TDS и конвейеров данных, которые он поддерживает. Задания преобразования выполняются крайне медленно не только из-за архаичной технологии, но и из-за нестабильных конвейеров, которые ломаются при столкновении с динамическими данными или событиями, а, как мы все хорошо знаем, данные меняются постоянно.
И, собственно говоря, основная проблема. Главной целью стека данных является облегчение процесса принятия бизнес-решений. Затраты на поддержку и масштабирование TDS значительно снижают рентабельность инвестиций. Даже если мы предположим, что ценность, создаваемая стеком, велика и поступает своевременно, затраты на его обеспечение съедают более половины этой ценности.
В результате TDS далеко не самый лучший вариант, когда дело касается эффективности процессов в контексте качества, объема, своевременности и ROI, являющихся ключевыми показателями для любого бизнеса. Но в свое время хотя бы что-то было лучше, чем совсем ничего, и это что-то позволило нам увидеть проблемы гораздо глубже тех, что связаны с хранением данных в файлах и папках, количество которых увеличивается в геометрической прогрессии и которыми в итоге никто не пользуется.
Заметный шаг вперед: современный стек данных
Что есть, то есть. Мы не можем отрицать существенный скачок в развитии, который стал возможен благодаря современному стеку данных (англ. Modern Data Stack ,MDS). Основным его достижением вполне можно считать переход к облачным решениям, благодаря которым данные стали не только доступными, но и легко восстановимыми.
MDS - это комплекс многоточечных решений, позволяющих обеспечить активный поток от физических данных к важной бизнес-аналитике. Мы все видели ажиотаж вокруг MDS и то, как он всецело завладел вниманием сообщества данных к своему потенциалу и возможностям.
Но что на самом деле произошло, так это то, что MDS стала разрозненной корзиной решений, нацеленных на исправление проблем TDS с перегруженными конвейерами данных, сбрасывающей все данные в центральное озеро, которое в конечном итоге превратилось в неуправляемое болото данных в разных отраслях.
Болота данных ничем не лучше бесполезных многочисленных файлов. Они наполнены богатыми, полезными, но по сути такими же «дремлющими» данными, которые предприятия попросту не могут использовать ввиду их изолированной и ненадежной семантики.
Семантическая ненадежность проистекает из хаотического беспорядка MDS, где так много инструментов, интеграций и нестабильных конвейеров, что истинная и чистая семантика попросту теряется среди них. Для понимания семантики низкого уровня требуется следующий уровень семантики, что еще больше усложняет проблему.

Для неопытных конечных пользователей в итоге наступил самый настоящий хаос, поскольку экосистемы данных постепенно превратились в сложные разрозненные системы с постоянно растущим непрерывным потоком точечных решений. Не удивительно, что вся эта картина получила название «Сумасшедшего ландшафта» (MAD (ML, AI & Data) landscape). Инфографика, составленная Мэтом Тарком (Matt Tuck) отлично отображает суть проблемы MDS; слова тут не нужны (одно изображение стоит тысячи слов!)
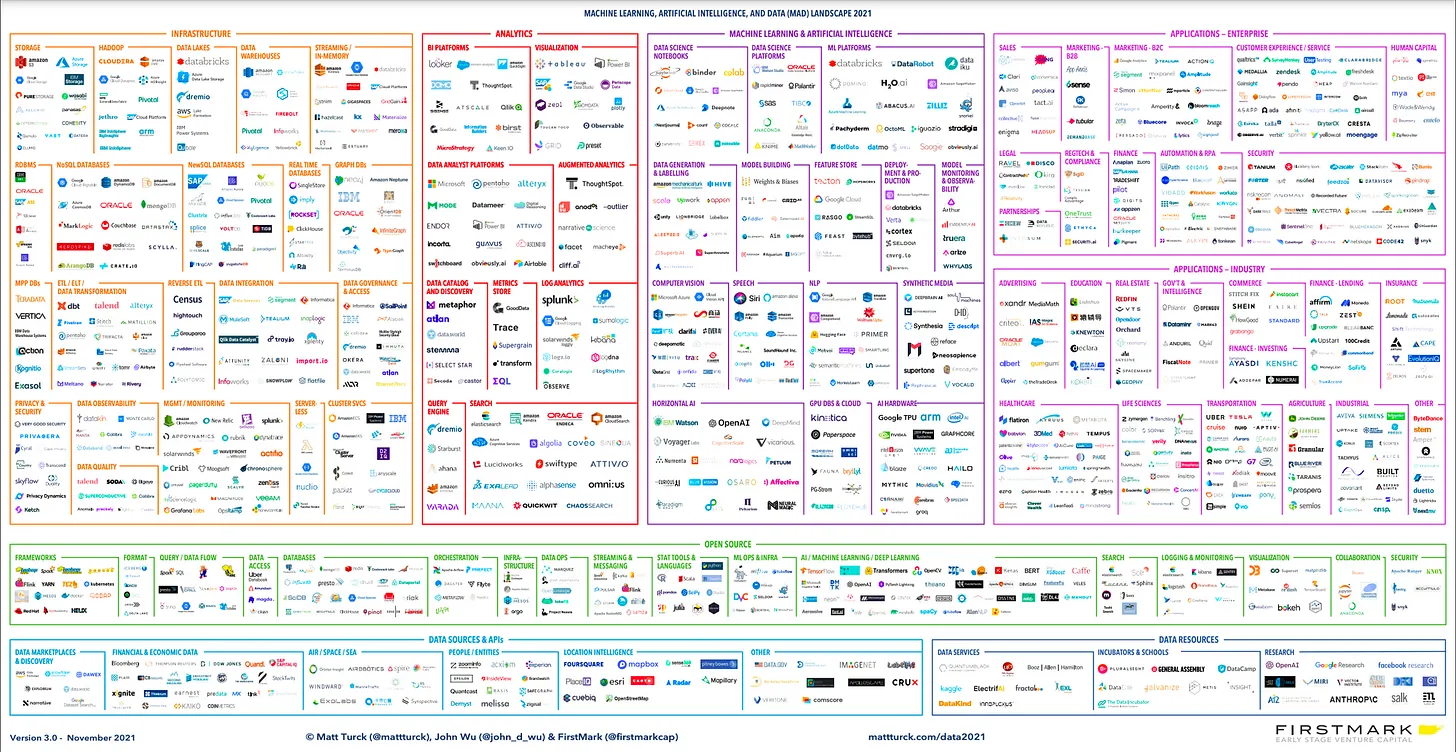
Безумие проявляется в дилемме выбора, издержках на интеграцию, обслуживание, экспертизу и т.д. Хаотичная экосистема бесчисленных точечных решений в конечном итоге создает data silos, а не решает их проблему.
Решение: стек «Сначала данные»
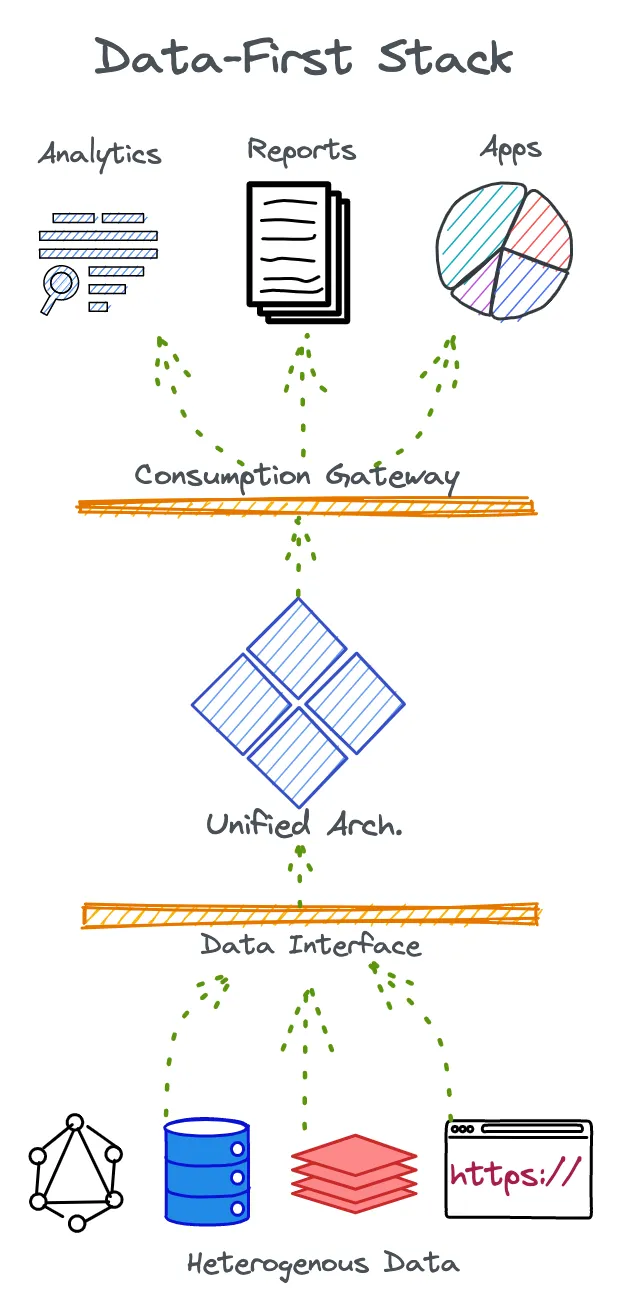
Антипод MDS
Появление современного стека данных (MDS) позволило нам преодолеть трудности, связанные с локальными системами данных и интенсивным ручным трудом. Однако MDS оказался самой настоящей палкой о двух концах, которая показала нам проблемы, о которых мы даже и не догадывались.
Стек «Сначала данные» (англ. Data-First Stack, DFS) – знаковое событие, вдохновленное движением «сначала данные», проводимым такими крупными компаниями, как Uber, Google и Airbnb в течение последних 10 лет. Что же означает понятие «сначала данные»? Давайте разбираться.
«Сначала данные», как это следует из самого названия, ставит на первое место данные и решения, основанные на данных, отодвигая при этом на второй план все остальное либо с помощью абстракций, либо с помощью интеллектуальных архитектур проектирования. Это будет проще понять, если мы посмотрим на ситуацию с противоположной стороны – «данные потом».
Существующие практики, в том числе MDS, являются как раз реализацией парадигмы “данные потом”, где большое количество усилий, ресурсов и времени тратится на управление, обработку и поддержание инфраструктуры данных. Данные и приложения данных при этом буквально теряются из поля зрения команд, работающих с данными, создавая такими образом серьезные трудности для производителей и потребителей данных.
ROI
На построение стека «сначала данные» у организаций ушли годы в виду текущего состояния технологий, ограниченных инноваций, и, главным образом, нашего скудного понимания Вселенной данных.
Сегодня предприятия, хорошо разбирающиеся в данных, значительно обгоняют своих конкурентов, которые не могут этим похвастаться. Многие прогрессивные организации поняли это давным-давно и успели реализовать множество крупных проектов для того, чтобы стать компаниями поколения «сначала данные». Однако повторение их опыта не самая лучшая идея, поскольку их стеки данных приспособлены к их внутренней архитектуре данных, которая индивидуальна в каждом конкретном случае.
Стек «сначала данные» действительно является таковым только в том случае, если он построен в соответствии с Вашей внутренней инфраструктурой.
Вопреки распространенному мнению, что для создания подобного стека требуются годы, благодаря новым инструментам хранения и вычислений, а также инновационным технологиям, появившимся за последние пару лет, это можно сделать в течение всего лишь нескольких недель.
Беспрерывная работа
Переход на DFS достаточно прост, поскольку не подразумевает замену существующих инструментов или крупных инвестиций в данные, которые были осуществлены ранее. Он упрощает существующие архитектуры проектирования, предоставляя унифицированную систему управления сложными подсистемами. Со временем эти подсистемы могут быть заменены собственными строительными блоками DFS в зависимости от предпочтений конечного пользователя.
Факторы, определяющие стек «Сначала данные»
Высокое качество внутренней унифицированной архитектуры
Приведу слова Мартина Фаулера (Martin Fowler): “Эта ситуация – нечто совершенно противоположное тому, к чему мы все привыкли. В нашем сознании четко сформировалась связь "высокого качества" с высокой ценой. Но когда мы говорим об архитектуре данных, то подразумеваем нечто иное. Высокое качество в этом случае неизбежно ведет к более быстрому появлению новых «фишек», поскольку нам не приходится разбираться со всяким «хламом»”.
Унифицированный подход безжалостно отбивается от всех движущихся элементов, которые стремятся подключиться к экосистеме данных. Больше инструментов приносит больше «хлама» и лишь только усложняет проблему. Унифицированный подход включает в себя функциональные возможности, обеспечивающие единую систему управления.
Ключом к созданию по-настоящему унифицированной архитектуры данных является избавление от «хлама» и использование минимального набора строительных блоков. Эти блоки могут быть объединены в любой последовательности для создания более крупных и точных решений.
Благодаря унифицированной архитектуре данных функционирование специфических приложений для работы с данными становится возможным всего за несколько шагов реорганизации. Конечная цель состоит в том, чтобы получить самостоятельные слои, отвлекающие конечных пользователей от тонкостей настройки разрозненных и изолированных подсистем, чтобы они могли сосредоточиться на самом главном — данных.
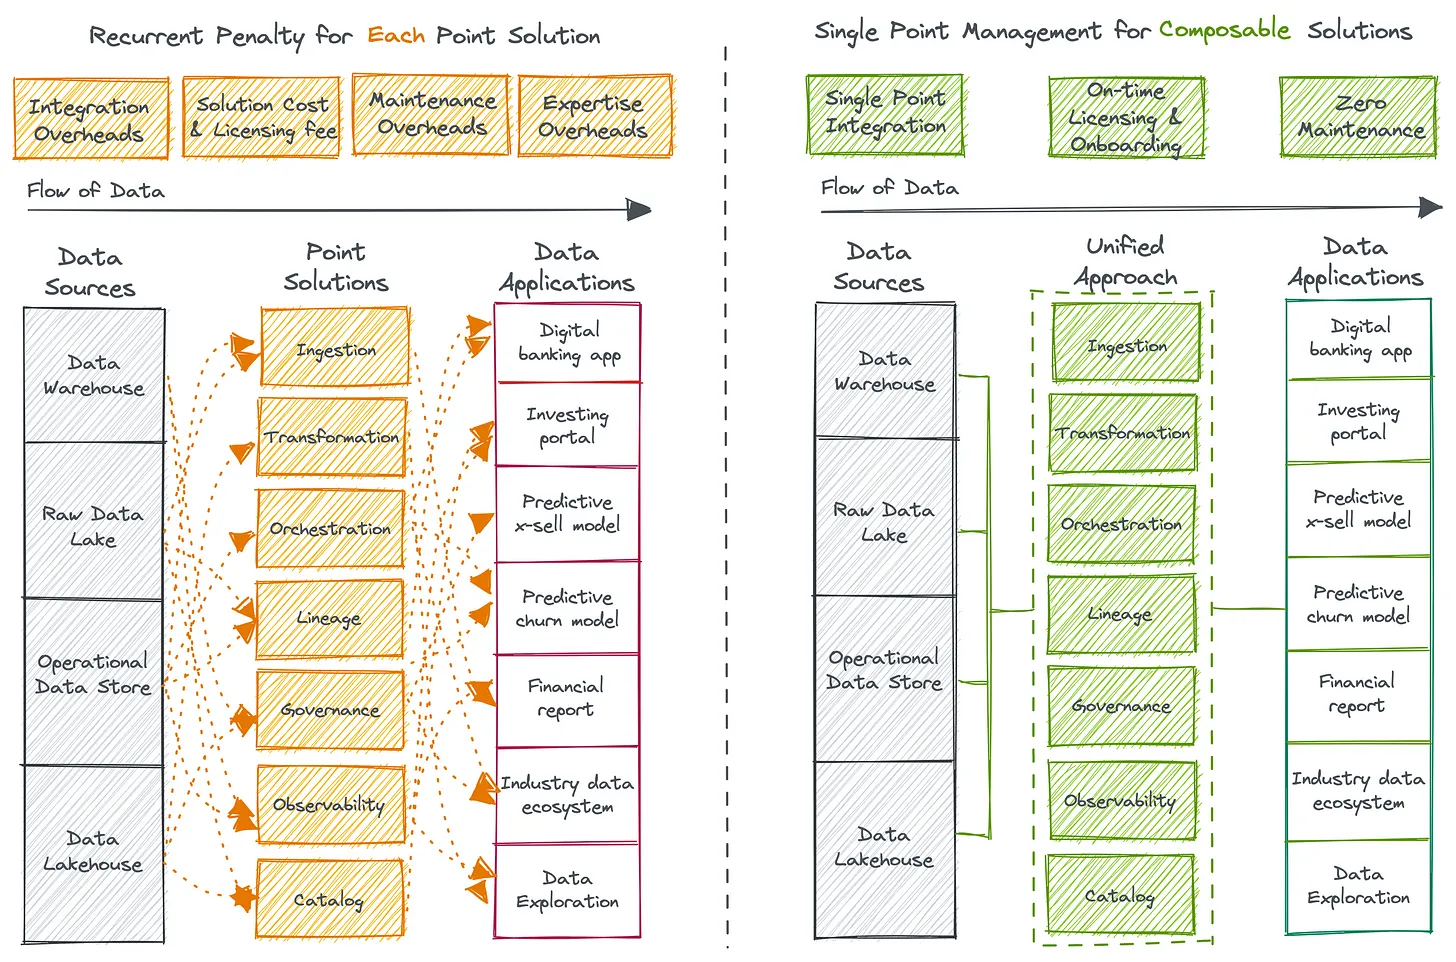
Декларативная управляемость
Настоящий стек «Сначала данные» полностью сфокусирован на данных и приложениях по работе с данными, он «не растрачивает свои силы» на такие операции, как интеграция, оркестрация данных и т.д. Кроме того, в целях расширения возможностей бизнеса команды специалистов по обработке данных тратят больше времени на исправление конвейеров, нежели чем на создание новых.
Декларативное управление качеством данных, безопасностью и семантикой считалось невозможным вплоть до реализации революционной идеи контрактов данных. Самое приятное это то, что эти контракты никоим образом не препятствуют работе существующей инфраструктуры.
Краткая справка по контрактам данных
Контракты данных — это ожидания от данных, которые могут выражаться в значении для бизнеса, качестве данных или их безопасности. Это соглашения между производителями данных и потребителями данных, которые документируют и обеспечивают выполнение ожиданий от данных.
Платформа разработки данных, поддерживающая идеологию унифицированной архитектуры, приветствующую контрактные рукопожатия, — это святой Грааль для декларативной экосистемы данных и, следовательно, основной инструмент построения стека «Сначала данные».
Передовой опыт разработчиков данных
Основными конечными пользователями стека «Сначала данные» являются разработчики данных. Работая с данными и создавая приложения данных, они, по сути, меняют правила игры в области оптимизации ресурсов и соблюдения бизнес-графиков. Стек «Сначала данные» расширяет их возможности, предоставляя им полную свободу действий.
Контракты играют ключевую роль и в обеспечении передового опыта разработчиков данных. Как выразился Дэвид Джаятиллейк (David Jayatillake), «нам нужно положить конец катастрофе Data Engineering без контрактов данных как индустрии». Так куда же контракты данных вписываются наиболее оптимальным образом? И почему инженеры данных должны оставлять тысячи запросов на рассмотрение влияния контрактов данных на их повседневную работу?
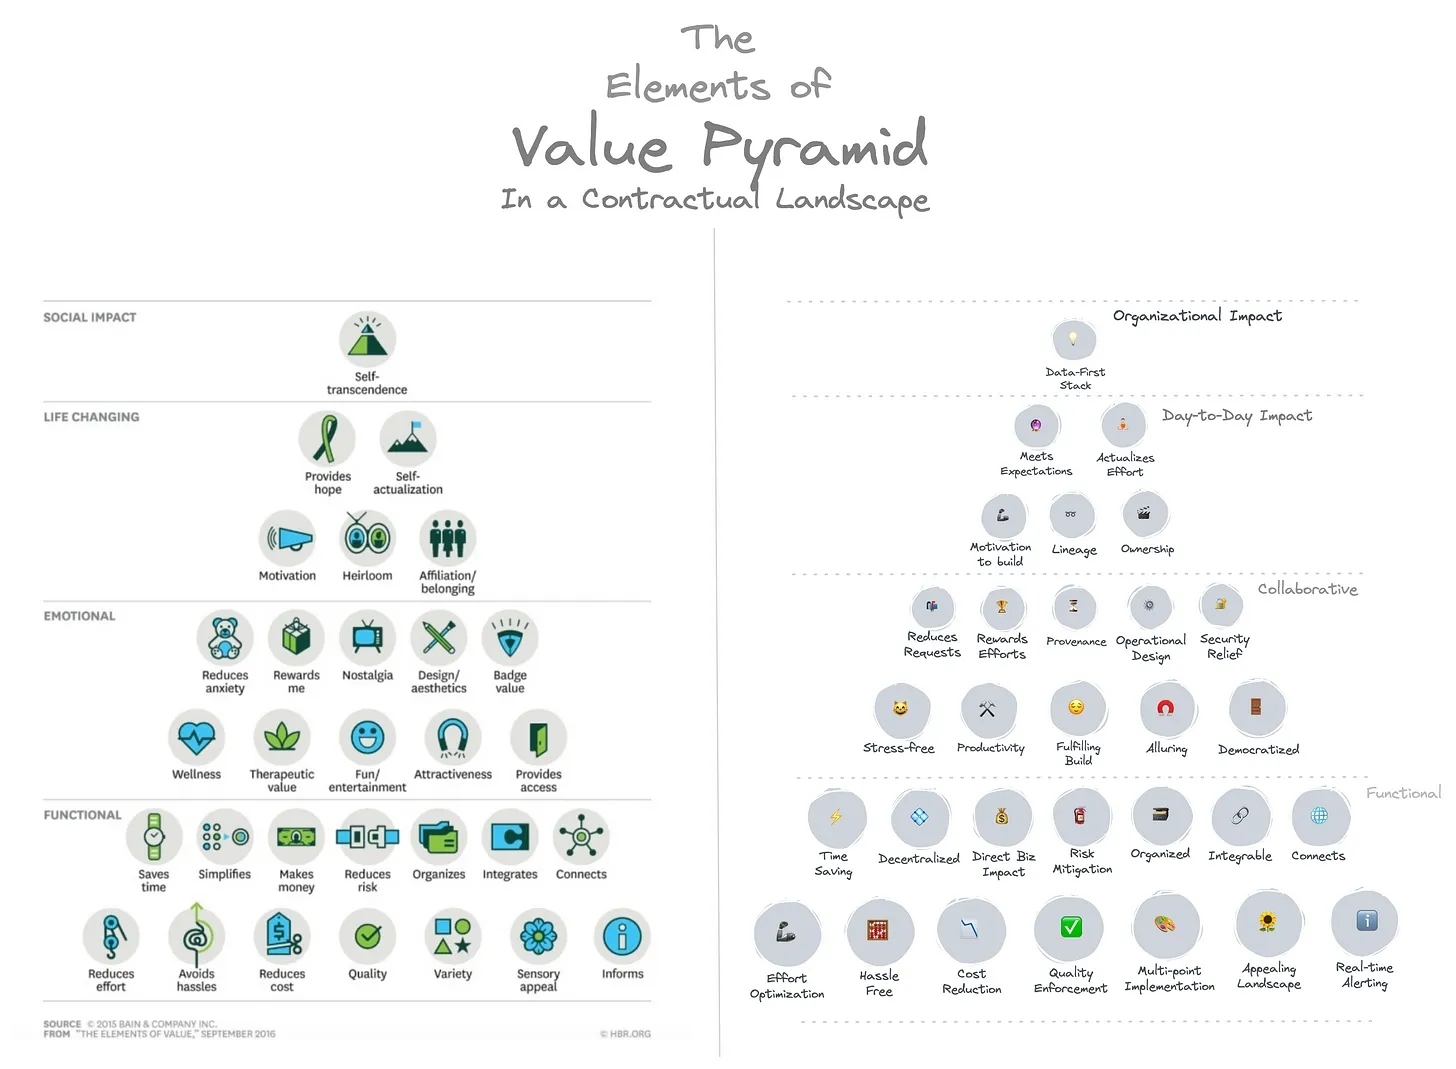
Контракты данных идеальным образом вписываются в Пирамиду Ценностей (опубликованную Harvard Business Review в 2016 г.), которая:
- Улучшает функциональнее способности экосистемы данных;
- Улучшает опыт взаимодействия;
- Улучшает опыт работы дата - инженеров, а также производителей и потребителей данных;
- Включает в себя стек «Сначала данные», где пользователи смогут сосредоточиться на основных данных и приложениях данных, а не зацикливаться на нюансах интеграции и обслуживания.
Срок извлечения реальной ценности из данных – несколько недель, а не лет
Первоначальная настройка проходит медленно, но как только она завершена, ценность для бизнеса становится очевидной практически сразу. Настоящий стек «Сначала данные» полностью соответствует своему названию: он ставит данные и необходимые метрики на первое место и ориентирует все процессы непосредственно на получение целевых бизнес-результатов. По сути, принцип «сначала данные» является синонимом «сначала результаты».
Результаты стека «Сначала данные»
Конечной целью стека «Сначала данные» является создание продуктов данных. Несмотря на то, что в идеале главной задачей любого стека данных, любой команды дата-специалистов или любой инициативы в области данных является создания ценных данных, которые действительно смогут улучшить бизнес-показатели, она таинственным образом попросту терялась под подводными камнями всех распространенных до сегодняшнего дня видов стеков данных.
Стек «Сначала данные» избавляется от всех отвлекающих факторов, чтобы сосредоточиться на данных и приложениях для работы с данными. После того, как данные пройдут через все компоненты этого стека, на выходе мы получим продукт данных, который, проще говоря, представляет собой единицу данных, последовательным и надежным образом увеличивающий ценность для бизнеса. У продукта данных есть несколько отличительных качеств или атрибутов, отличающих его от общих данных.
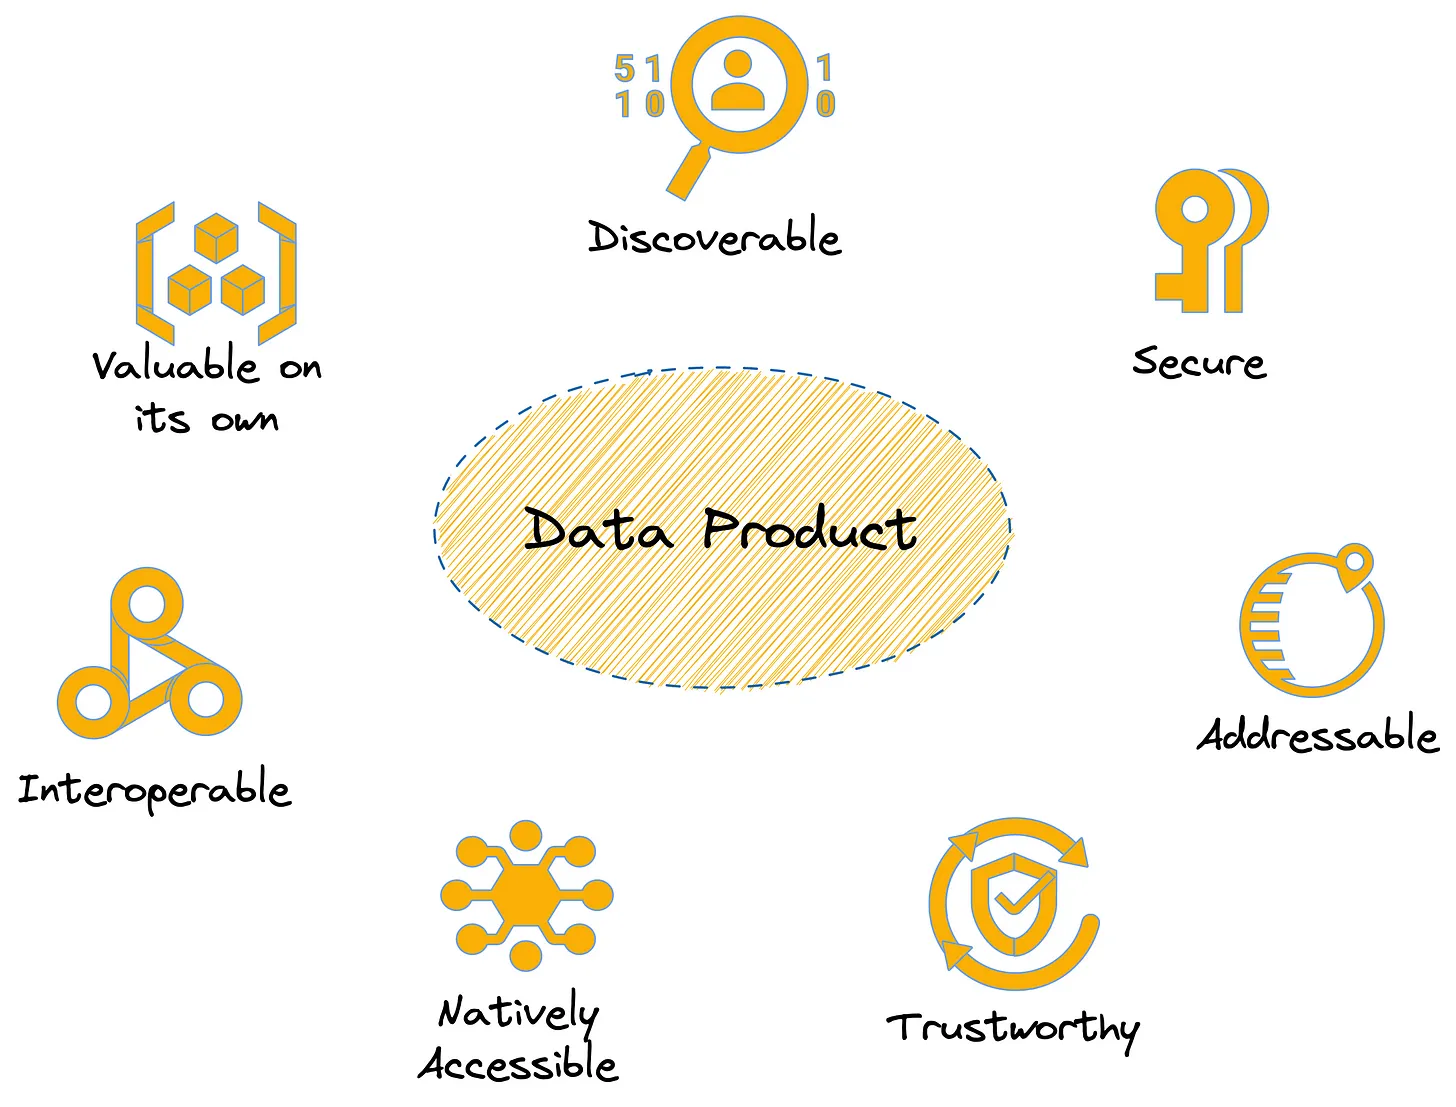
Продукт данных, если он отвечает всем вышеперечисленным требованиям, запросто может быть обычной или электронной таблицей, базой данных и т.д.… ну, Вы поняли мою идею
Резюме