

Новые кодировки для того, чтобы увеличить производительность ClickHouse
Современные аналитические базы данных не смогли бы существовать без эффективной компрессии данных. Хранение данных становится дешевле, но размеры данных растут гораздо быстрее. Закон Мура о Больших Данных опережает аналогию в аппаратном обеспечении. В этой статье мы опишем и протестируем новейшие кодировки ClickHouse, которые особенно актуальны для временных рядов. И мы гордимся тем, что Altinity добавили некоторые из них в ClickHouse.
Данная статья представляет собой анонс новых кодировок для ClickHouse 19.11. на момент написания статьи данная версия еще недоступна. Для тестирования новых кодировок ClickHouse может быть настроен из источника либо можно попробовать тестовую сборку.
Кодировки и обзор компрессии
Кодирование и сжатие используются для одной и той же цели - для хранения данных более компактным способом. Однако данные они преобразуют по-разному. Кодирование отображает исходные данные в другую (закодированную) форму, элемент за элементом. Его можно рассматривать как единое математическое отображение. Например, кодирование словаря отображает строки в индексы словаря. Кодирование учитывает кодируемый тип данных. Компрессия же предполагает использование некоего общего алгоритма, который сжимает байты, а не типы данных.
В течение многих лет ClickHouse поддерживал два алгоритма компрессии данных: LZ4 (по умолчанию) и ZSTD. Эти алгоритмы иногда имеют логику для применения кодировки внутри, но они не знают о типах данных ClickHouse. Знание типа данных и характера данных позволяет нам более эффективно кодировать данные. В течение последних нескольких месяцев синтаксис ClickHouse был расширен, что позволило включить кодировки уровня столбцов, новые кодировки были добавлены в ClickHouse:
- Delta. Delta-кодирование сохраняет разницу между последовательными значениями. Разница, как правило, имеет меньший размер байта и кардинальность, особенно для последовательностей. Она может быть эффективно сжата при помощи LZ4 или ZSTD;
- DoubleDelta. С помощью данной кодировки ClickHouse сохраняет разницу между последовательными дельтами. Он обеспечивает еще лучшие результаты для медленно изменяющихся последовательностей. Чтобы использовать аналогию из физики, Delta кодирует скорость, а DoubleDelta – ускорение;
- Gorilla. Данная кодировка родилась под вдохновением от недавней статьи, опубликованной на Facebook [http://www.vldb.org/pvldb/vol8/p1816-teller.pdf], и никто больше не помнит академического названия данного алгоритма. Оно очень эффективно для значений, которые меняются не часто. Он применим как к плавающим, так и к целочисленным типам данных;
- T64. Эта кодировка уникальна для ClickHouse, она вычисляет максимальные и минимальные значения для кодированного диапазона, а затем удаляет более высокие биты, транспонируя 64-битную матрицу (откуда и происходит имя T64). В итоге мы получаем более компактное битовое представление тех же данных. Кодировка является универсальной для целых типов данных и не требует каких-либо особых свойств от данных, кроме локальности значений.
Кодировки могут быть заданы как часть определения столбца, используя ключевое слово 'Codec'. Пример ниже определяет кодировку DoubleDelta для столбца. Обратите внимание, что он отключает сжатие по умолчанию.
ts DateTime Codec(DoubleDelta) – закодировано, но компрессия при этом отсутствует
Для того, чтобы обеспечить и кодирование и сжатие, кодеки могут быть цепными, как показано ниже:
ts DateTime Codec(DoubleDelta, LZ4) – закодировано, компрессия применена
Кодировки Delta, DoubleDelta и Gorilla можно найти во многих базах данных временных рядов. Delta и DoubleDelta традиционно используются для отметок времени, а кодировка Gorilla - для значений. Хорошим примером являются InfluxDB и Prometheus. ClickHouse хорошо конкурирует с InfluxDB с точки зрения производительности, но проигрывает ему, когда речь идет об эффективности сжатия. Использование новых кодировок исправит этот зазор. Давайте протестируем их!

Методология тестирования
Будем исследовать кодировки, используя следующие критерии:
- Эффективность кодирования без сжатия для различных типов данных;
- Эффективность кодирования с применением сжатия LZ4 и ZSTD;
- Эффективность сжатия LZ4 и ZSTD применительно к закодированным данным.
Мы использовали 4 разных наборов данных, содержащих 1,000,000 рядов:
- Монотонная последовательность чисел с постоянными приращениями
(codec_test1_seq). Образец данных: 0,1000,2000,3000,4000,5000,6000,7000,8000,9000, …
- Монотонная последовательность чисел со случайным приращением (codec_test2_mon). Образец данных: 22,1072,2034,3076,4007,5094,6061,7074,8061,9058, …
- Постоянная последовательность со случайными скачками (codec_test3_var). Образец данных: 1825,1000,1000,1000,1000,1000,1000,1703,1000,1000, …
- Случайный набор значений ниже 1B (codec_test4_rand). Образец данных: 608745218, 167444263, 620949842, 956686395, 66062863, …
Первые три набора данных типичны для приложений временных рядов. Рандомизированное множество является наихудшим сценарием. Каждая таблица наборов данных имеет несколько столбцов, которые представляют различные комбинации типа данных, кодирования и сжатия. Мы также храним незашифрованный столбец в качестве ссылки. Это позволяет нам сравнивать различные комбинации внутри наборов данных и между наборами данных. Подводя итог, мы протестируем следующие комбинации:
- Типы данных Int32, Int64 *;
- Кодировки None, Delta, DoubleDelta, Gorilla, T64;
- Компрессия None, LZ4, ZSTD **
- Изначально мы планировали протестировать Float32 и Float64 с кодировкой Gorilla, но удалили его, чтобы сделать статью более компактной. Вы можете найти типы плавающих данных и комбинации в скриптах в Приложении.
** Можно настроить уровень сжатия, но мы использовали уровни по умолчанию.
Эффективность сжатия и кодирования можно увидеть из таблицы ClickHouse system.columns, которая показывает сжатый и несжатый размер для каждого столбца, а также кодировки и сжатия, которые были применены к столбцу.
Если кому-то интересны подробные примеры SQL, обратитесь к Приложению в конце данной статьи.
Результаты эффективности кодирования и сжатия: целые типы
Если посмотреть на результаты ниже, учитывайте размер исходных данных: незашифрованный и несжатый. Это 4000,000 байт для Int32 и 8000000 для Int64. Мы также включаем необусловленный размер данных в качестве ссылки.
Сначала давайте посмотрим на несжатые данные.
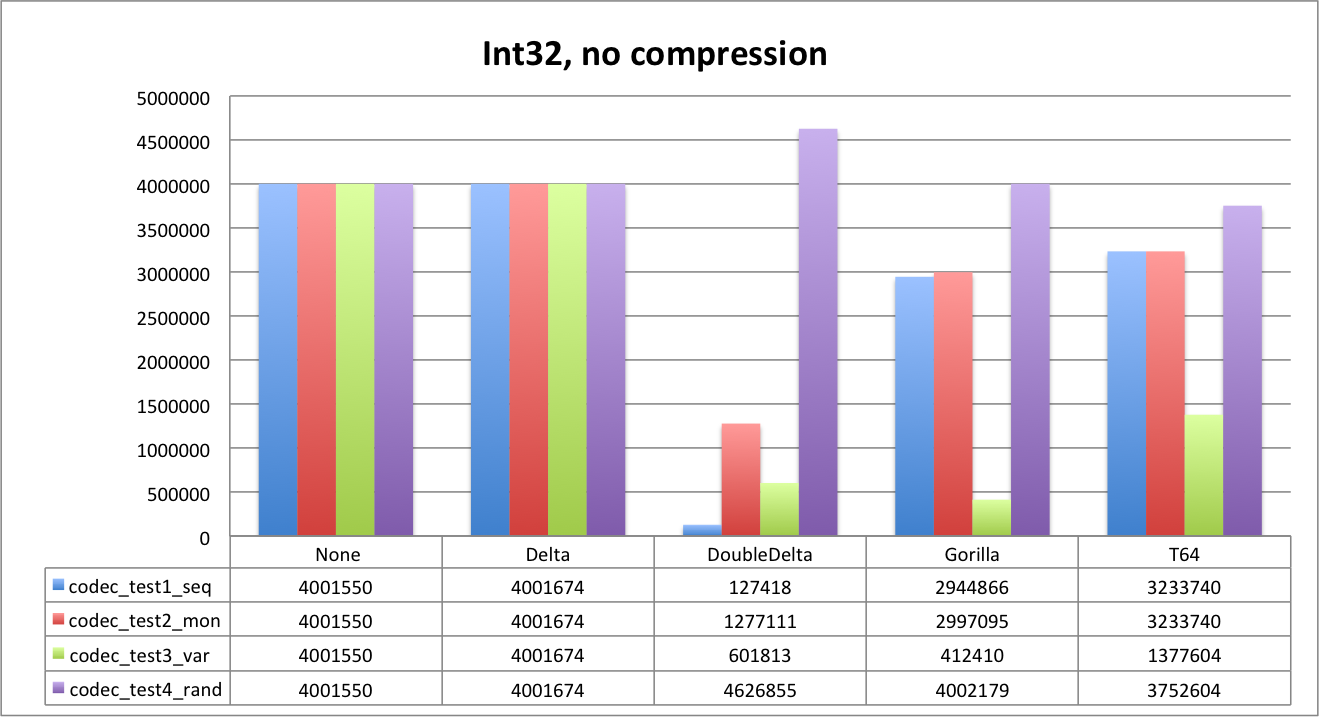
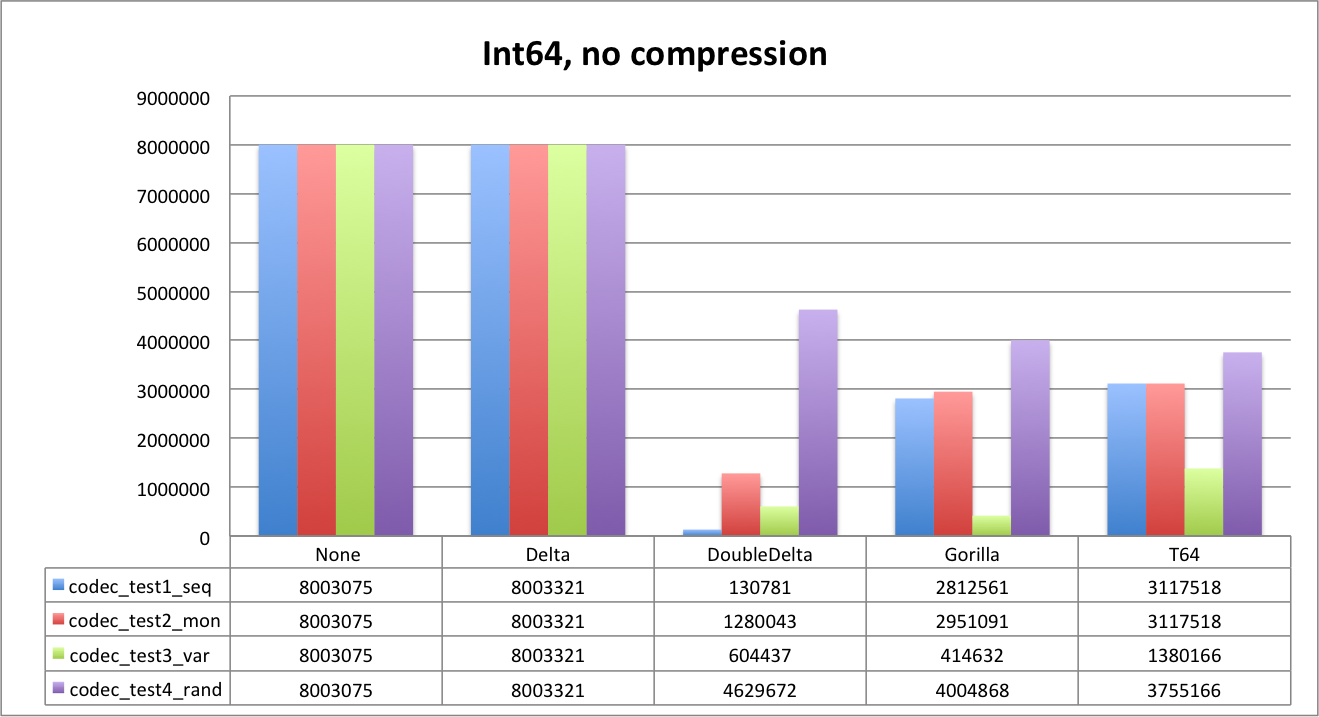
Как Вы можете видеть, Delta вообще не сжимает данные, так как по умолчанию размер дельты совпадает с типом данных. Чуть позже мы увидим, что она будет лучше работать с LZ4. DoubleDelta лучше всего подходит для однородных последовательностей и монотонных, но не для случайных данных.
Также очень интересно посмотреть, как работают Gorilla и T64. Случайные данные – это самый лучший пример. Так как мы создали случайные значения ниже 1B, данные подходят для 30 бит. T64 способен обнаружить его и снять дополнительные биты идеально. Вы можете ясно видеть это и для Int32, и для Int64 - размер данных примерно одинаков и близок к 375000000 байт (1,000*30/8).
Gorilla немного хуже на случайных наборах данных (32 бита), но это фантастика для 'var' набора данных. Эталонный тип данных является основным примером использования для такой кодировки, хотя мы были удивлены производительностью Gorilla для целочисленных типов данных в целом.
Далее обратим внимание на компрессию LZ4.
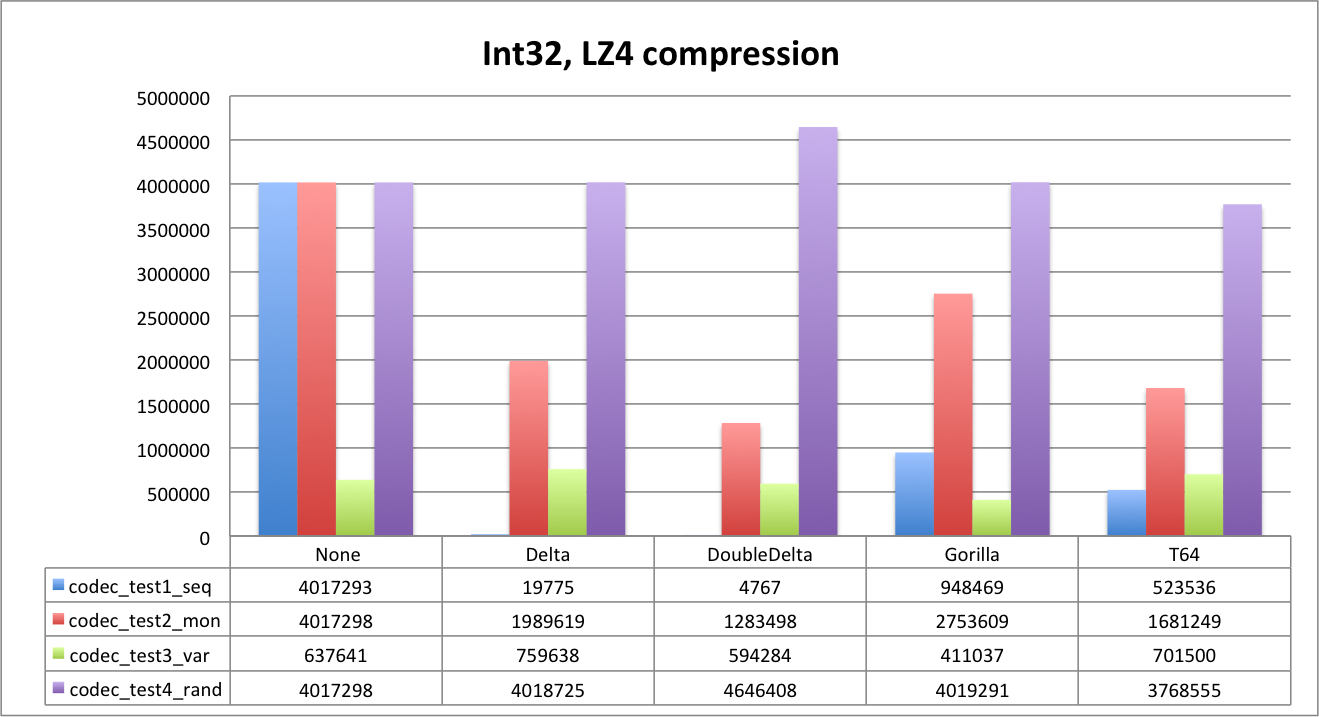
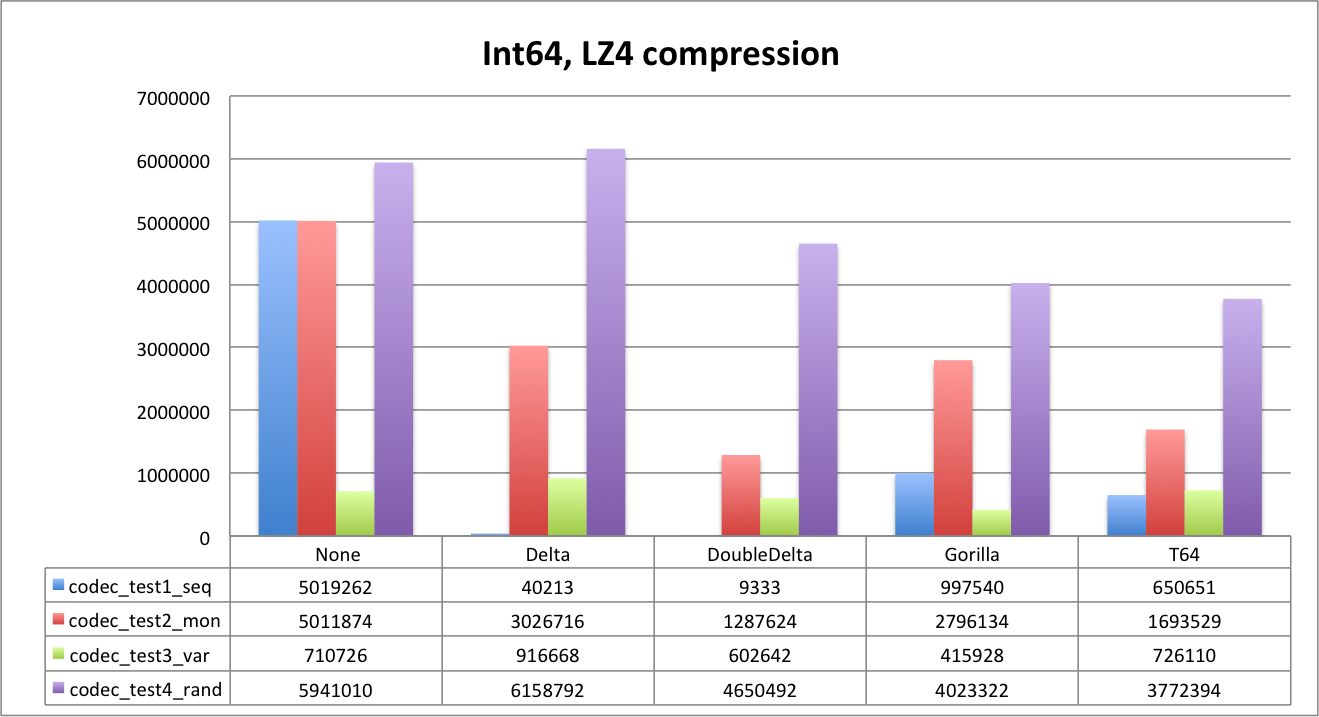
С сжатием LZ4 Delta-кодирование хорошо для всего, кроме случайного набора данных. DoubleDelta, очевидно, является лучшим для случаев временных рядов.
Теперь обратим внимание на ZSTD.
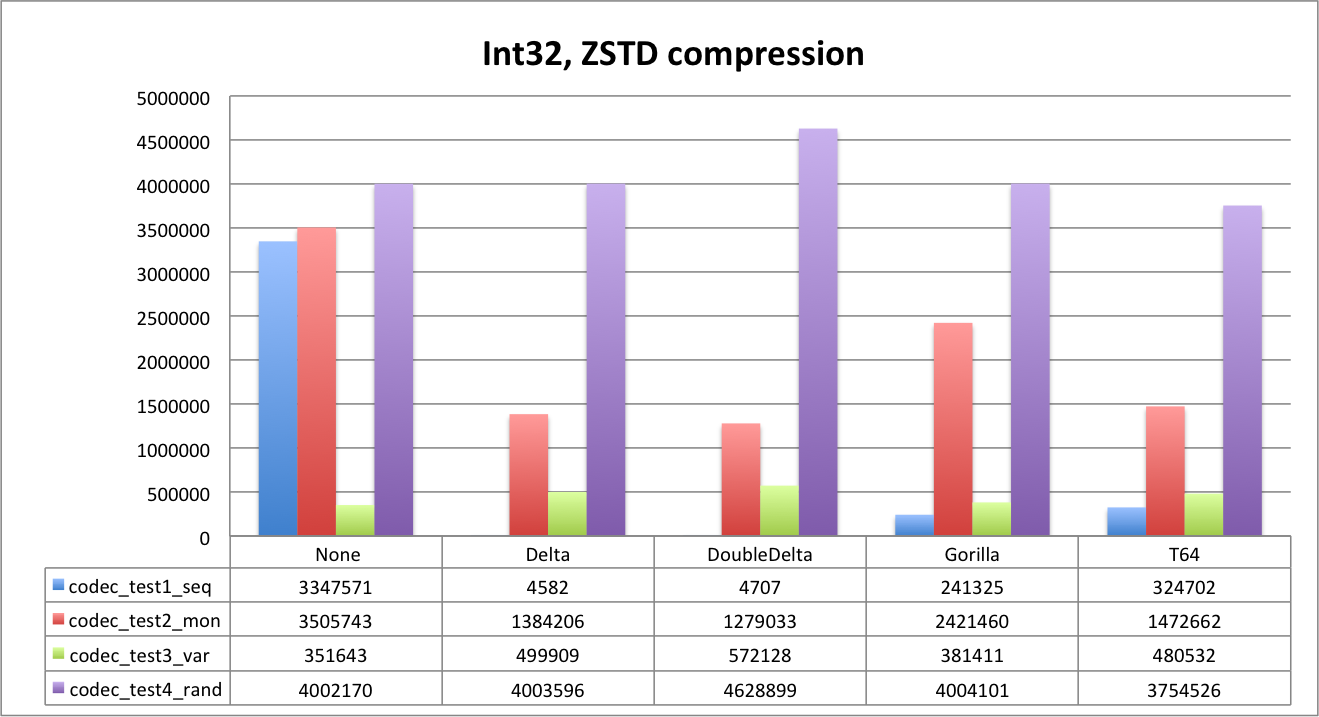
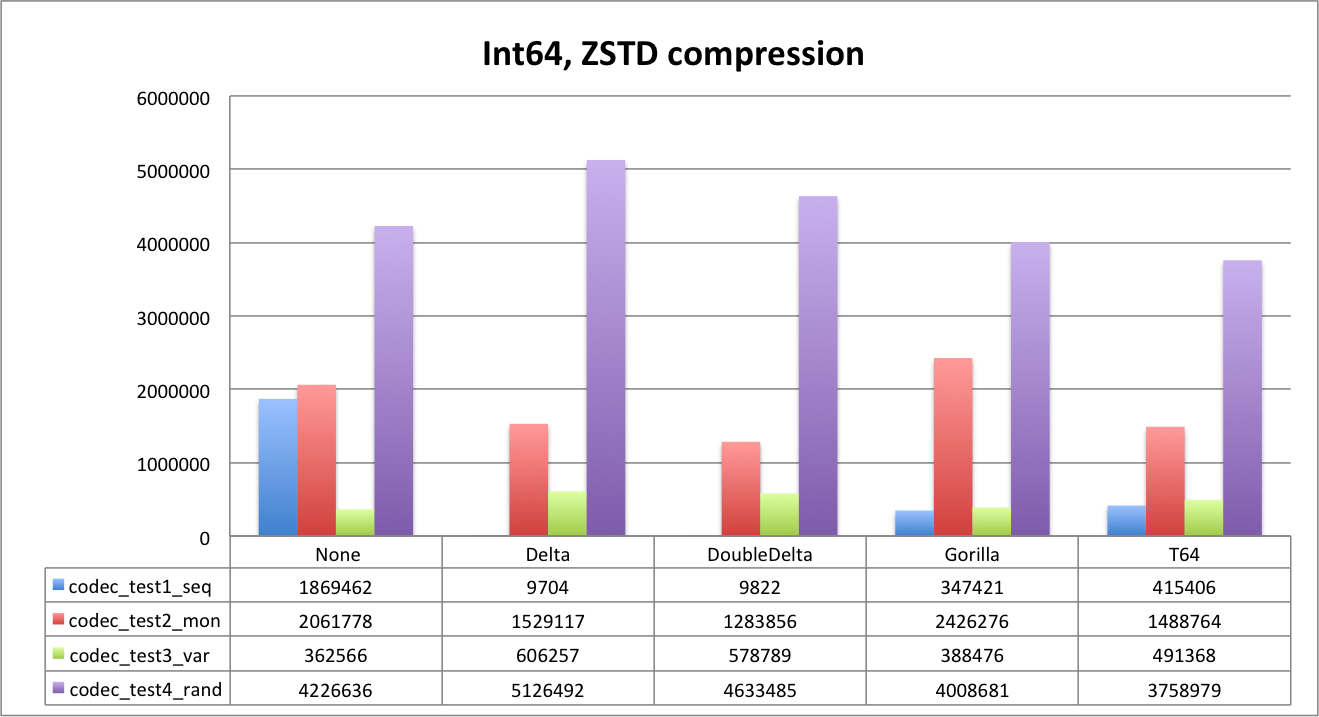
Интересно, что ZSTD может сжимать Delta для последовательностей более эффективно, чем DoubleDelta. Коэффициент сжатия для последовательностей впечатляет 1:800+ как с дельта-кодировкой, так и с ZSTD. T64 является лучшим для случайных данных снова.
Давайте посмотрим на это под другим углом. Для отчета ниже мы объединили все наборы данных временных рядов, чтобы сравнить эффект сжатия и кодирования вместе.
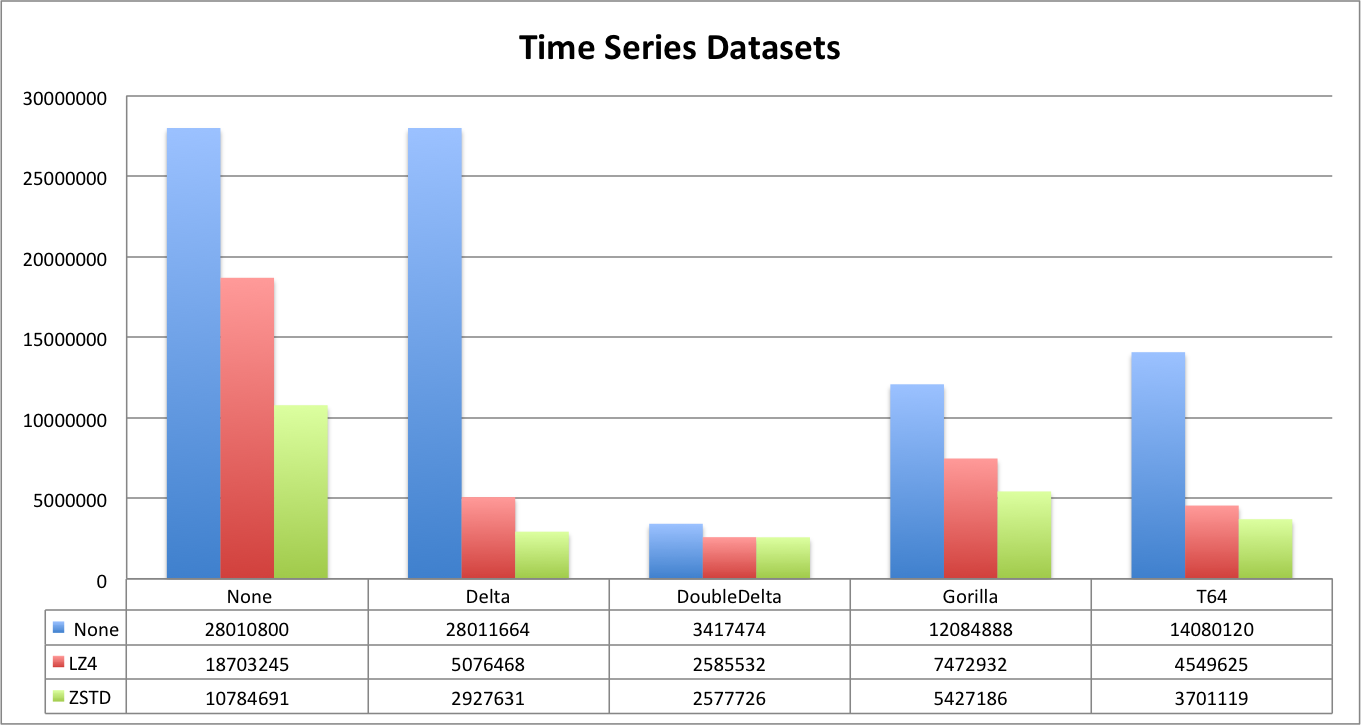
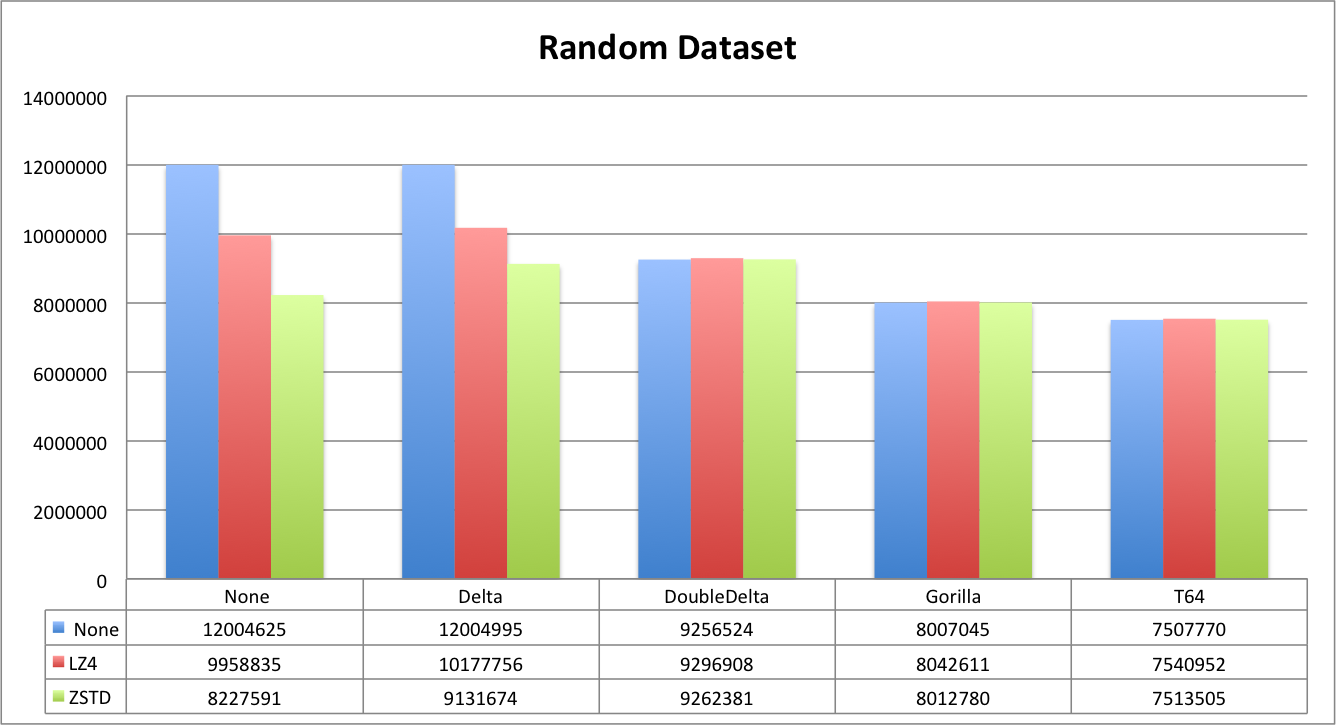
Подводя итог, можно сказать, что Delta и DoubleDelta хорошо работают с конкретными временными рядами данных. DoubleDelta очень эффективен с LZ4, поэтому добавление ZSTD не улучшает его. T64 и Gorilla - отличные кодеки общего назначения, которые можно рекомендовать для всех случаев, когда шаблон данных не известен. Gorilla лучше для временных рядов, но T64 более 'сжатие-дружественный'. Даже если Gorilla может быть более эффективным первоначально, сжатие более эффективно с T64. Но разница не так много. Обратите внимание, что горилла может кодировать поплавки с той же эффективностью, так что для плавающих значений это не так уж сложно.
Заключение
Кодеки ClickHouse помогают намного улучшить общее сжатие, уменьшить хранение и увеличить производительность за счет меньшего I/O. Важно понять характер данных и выбрать правильный кодек. Delta-кодировка лучше всего хранит временные столбцы, DoubleDelta должна очень хорошо сжиматься для увеличения счетчиков, а Gorilla лучше всего подходит для датчиков. T64 может использоваться для целочисленных данных при условии, что Вы не храните случайные хеши. Использование кодов также позволяет придерживаться с быстрым LZ4 и уменьшить нагрузку на процессор при декомпрессии данных.
Однако многое еще предстоит сделать. В частности, похоже, что DoubleDelta может быть улучшена для Int32, новая версия кодека T64 была добавлена на прошлой неделе, и есть статья от VictoriaMetrics, которая претендует на значительное улучшение с помощью модифицированного алгоритма Gorilla [https:///medi.com/faun/victoriametrics-achieving-better- bettion-for-time-data--than-gorilla-317bc1f95932]. Мы ожидаем, что еще более эффективные кодеки будут доступны в ClickHouse в течение следующих нескольких месяцев.
Можно пожаловаться, что в этой статье не хватает тестов производительности. Испытания производительности синтетических данных могут ввести в заблуждение. Мы протестируем реальный эффект с помощью тестов TSBS. Оставайтесь с нами.
Приложение: подготовка тестовых данных
Ниже приведены скрипты для повторения наших критериев:
DROP TABLE IF EXISTS codec_test1_seq;
CREATE TABLE codec_test1_seq (
 n Int32,

 /* No compression */
 n32               Int32 default n Codec(NONE),
 n32_delta         Int32 default n Codec(Delta),
 n32_doubledelta   Int32 default n Codec(DoubleDelta),
 n32_t64           Int32 default n Codec(T64),
 n32_gorilla       Int32 default n Codec(Gorilla),
 n64               Int64 default n Codec(NONE),
 n64_delta         Int64 default n Codec(Delta),
 n64_doubledelta   Int64 default n Codec(DoubleDelta),
 n64_t64           Int64 default n Codec(T64),
 n64_gorilla       Int64 default n Codec(Gorilla),
 f32               Float32 default n Codec(NONE),
 f64               Float64 default n Codec(NONE),
 f32_gorilla       Float32 default n Codec(Gorilla),
 f64_gorilla       Float64 default n Codec(Gorilla),

 /* LZ4 compression */
 l_n32             Int32 default n Codec(LZ4),
 l_n32_delta       Int32 default n Codec(Delta, LZ4),
 l_n32_doubledelta Int32 default n Codec(DoubleDelta, LZ4),
 l_n32_t64         Int32 default n Codec(T64, LZ4),
 l_n32_gorilla     Int32 default n Codec(Gorilla, LZ4),
 l_n64             Int64 default n Codec(LZ4),
 l_n64_delta       Int64 default n Codec(Delta, LZ4),
 l_n64_doubledelta Int64 default n Codec(DoubleDelta, LZ4),
 l_n64_t64         Int64 default n Codec(T64, LZ4),
 l_n64_gorilla     Int64 default n Codec(Gorilla, LZ4),
 l_f32             Float32 default n Codec(LZ4),
 l_f64             Float64 default n Codec(LZ4),
 l_f32_gorilla     Float32 default n Codec(Gorilla, LZ4),
 l_f64_gorilla     Float64 default n Codec(Gorilla, LZ4),

 /* ZSTD compression */
 z_n32             Int32 default n Codec(ZSTD),
 z_n32_delta       Int32 default n Codec(Delta, ZSTD),
 z_n32_doubledelta Int32 default n Codec(DoubleDelta, ZSTD),
 z_n32_t64         Int32 default n Codec(T64, ZSTD),
 z_n32_gorilla     Int32 default n Codec(Gorilla, ZSTD),
 z_n64             Int64 default n Codec(ZSTD),
 z_n64_delta       Int64 default n Codec(Delta, ZSTD),
 z_n64_doubledelta Int64 default n Codec(DoubleDelta, ZSTD),
 z_n64_t64         Int64 default n Codec(T64, ZSTD),
 z_n64_gorilla     Int64 default n Codec(Gorilla, ZSTD),
 z_f32             Float32 default n Codec(ZSTD),
 z_f64             Float64 default n Codec(ZSTD),
 z_f32_gorilla     Float32 default n Codec(Gorilla, ZSTD),
 z_f64_gorilla     Float64 default n Codec(Gorilla, ZSTD)
) Engine = MergeTree
PARTITION BY tuple() ORDER BY tuple();

DROP TABLE IF EXISTS codec_test2_mon;
CREATE TABLE codec_test2_mon AS codec_test1_seq;

DROP TABLE IF EXISTS codec_test3_var;
CREATE TABLE codec_test3_var AS codec_test1_seq;

DROP TABLE IF EXISTS codec_test4_rand;
CREATE TABLE codec_test4_rand AS codec_test1_seq;

insert into codec_test1_seq (n)
select number*1000 from numbers(1000000) settings max_block_size=1000000;

insert into codec_test2_mon (n)
select number*1000+(rand()%100) from numbers(1000000) settings max_block_size=1000000;

insert into codec_test3_var (n)
select 1000 + (rand(1)%1000) * (rand(2)%10 = 0) from numbers(1000000) settings max_block_size=1000000;

insert into codec_test4_rand (n)
select rand()%(1000000*1000) from numbers(1000000) settings max_block_size=1000000;

/* sample rows */
select table, groupArray(n) samples from (
select 'codec_test1_seq' table, n from codec_test1_seq limit 10
union all
select 'codec_test2_mon' table, n from codec_test2_mon limit 10
union all
select 'codec_test3_var' table, n from codec_test3_var limit 10
union all
select 'codec_test4_rand' table, n from codec_test4_rand limit 10
)
group by table order by table;

/* validation. It is complicated because of mix of Int and Float types */
select arrayDistinct(avgForEach(CAST(replaceOne(replaceOne(toString(tuple(*)), '(', '['), ')', ']'), 'Array(Int64)'))) avg from codec_test1_seq
union all
select arrayDistinct(avgForEach(CAST(replaceOne(replaceOne(toString(tuple(*)), '(', '['), ')', ']'), 'Array(Int64)'))) avg from codec_test2_mon
union all
select arrayDistinct(avgForEach(CAST(replaceOne(replaceOne(toString(tuple(*)), '(', '['), ')', ']'), 'Array(Int64)'))) avg from codec_test3_var
union all
select arrayDistinct(avgForEach(CAST(replaceOne(replaceOne(toString(tuple(*)), '(', '['), ')', ']'), 'Array(Int64)'))) avg from codec_test4_rand;

/* Encoding benchmarks results */
select multiIf(table like '%rand', 'Random', 'Time-Series') dataset_type,
       table, type as data_type,
       multiIf(compression_codec like '%ZSTD%', 'ZSTD', compression_codec like '%LZ4%', 'LZ4', ' None') compression,
       multiIf(compression_codec like '%DoubleDelta%', 'DoubleDelta',
               compression_codec like '%Delta%', 'Delta',
               compression_codec like '%T64%', 'T64',
               compression_codec like '%Gorilla%', 'Gorilla',
               ' None') encoding,
compression_codec codec,
sum(data_uncompressed_bytes) uncompressed,
sum(data_compressed_bytes) compressed,
round(uncompressed/compressed,1) ratio
from system.columns
where table like 'codec_test%' and name != 'n'
group by dataset_type, table, data_type, compression, encoding, codec
order by dataset_type, table, data_type, compression, encoding, codec
FORMAT CSVWithNames;


