

Оптимизация производительности и расхода ресурсов
Dagster как платформа оркестрации данных предоставляет богатый набор инструментов для контроля за выполнением задач, управления ресурсами и планированием графов. Глава посвящена практическим подходам к повышению пропускной способности обработок и снижению затрат на инфраструктуру без потери надёжности и воспроизводимости. Рассматриваются архитектурные принципы, конфигурационные решения, методы оптимизации планирования и зависимостей, механизмы мониторинга и реальные сценарии применения в корпоративной среде.
Оптимизация в Dagster начинается с концепции разделения обязанностей: вычисления, хранение и управление зависимостями должны быть отделены друг от друга и настраиваемы независимо. Это позволяет масштабировать компоненты в разные стороны, внедрять более экономичные режимы выполнения и быстро адаптироваться к изменению объёма данных. В рамках курса мы опираемся на Hybrid-подход: сочетание архитектических, продуктовых и методологических практик, что обеспечивает как точность и предсказуемость исполнения, так и удобство внедрения в организациях с различными процессами разработки и операционной деятельностью.
Краткое содержание главы
- Архитектура и принципы оптимизации: как разделение вычислений, хранения и управления зависимостями влияет на производительность.
- Управление ресурсами и конфигурациями: выбор исполнителей, IO‑менеджеров, конфигураций и стратегий балансирования нагрузки.
- Планирование графов и зависимостей: методы сокращения времени выполнения и повторного вычисления без потери корректности.
- Мониторинг, профилирование и автоматизация поддержки: как измерять, диагностировать и автоматизировать проблему в продакшене.
- Практические сценарии: типовые кейсы и рецепты оптимизации на примерах в Dagster.
Архитектурные принципы оптимизации
Эффективная оптимизация начинается с проектирования графа выполнения и распределения ответственности между компонентами Dagster. К базовым принципам относятся:
-
Разделение вычислений и хранения: отделение операций от механизма хранения промежуточных данных позволяет применить разные стратегии масштабирования. Например, локальные кэши и IO‑менеджеры могут работать совместно с удалённым хранилищем, минимизируя накладные расходы на перенос данных и повторные вычисления.
-
Декомпозиция задач и параллелизм: графовая структура Dagster позволяет распараллеливаниям осуществляться на уровне операций и секций графа. Включение параллельного исполнения для независимых узлов снижает общее время обработки, но требует корректной синхронизации и управления ресурсами.
-
Кэширование и материалицации: сохранение результатов промежуточных шагов (materializations) позволяет повторно использовать данные без повторного выполнения вычислений при повторных прогонках или Backfill. Внедрение эффективного IO‑менеджера и политики кэширования уменьшает стоимость вычислительных циклов и сетевых операций.
-
Управление зависимостями и локализацией данных: минимизация ненужной передачи данных между узлами и использование локальных ресурсных пулов сокращает задержку и увеличивает устойчивость к перегрузкам. Встроенные механизмы, такие как partitioning и asset-based подход, позволяют разумно ограничивать обработку данным сегментам.
-
Наблюдаемость и обратная связь: полевая эксплуатация с использованием метрик задержек, пропускной способности и загрузки ресурсов помогает управлять поведением графа в реальном времени и заранее предупреждать деградации.
-
Встраиваемость в инфраструктуру: совместимость с Kubernetes, Docker и облачными сервисами задаёт рамки масштабирования и экономии затрат. Выбор исполнительных механизмов (executors) должен соответствовать характеру рабочих нагрузок и требованию к предсказуемости задержек.
Внутренний механизм: как Dagster реализует эти принципы
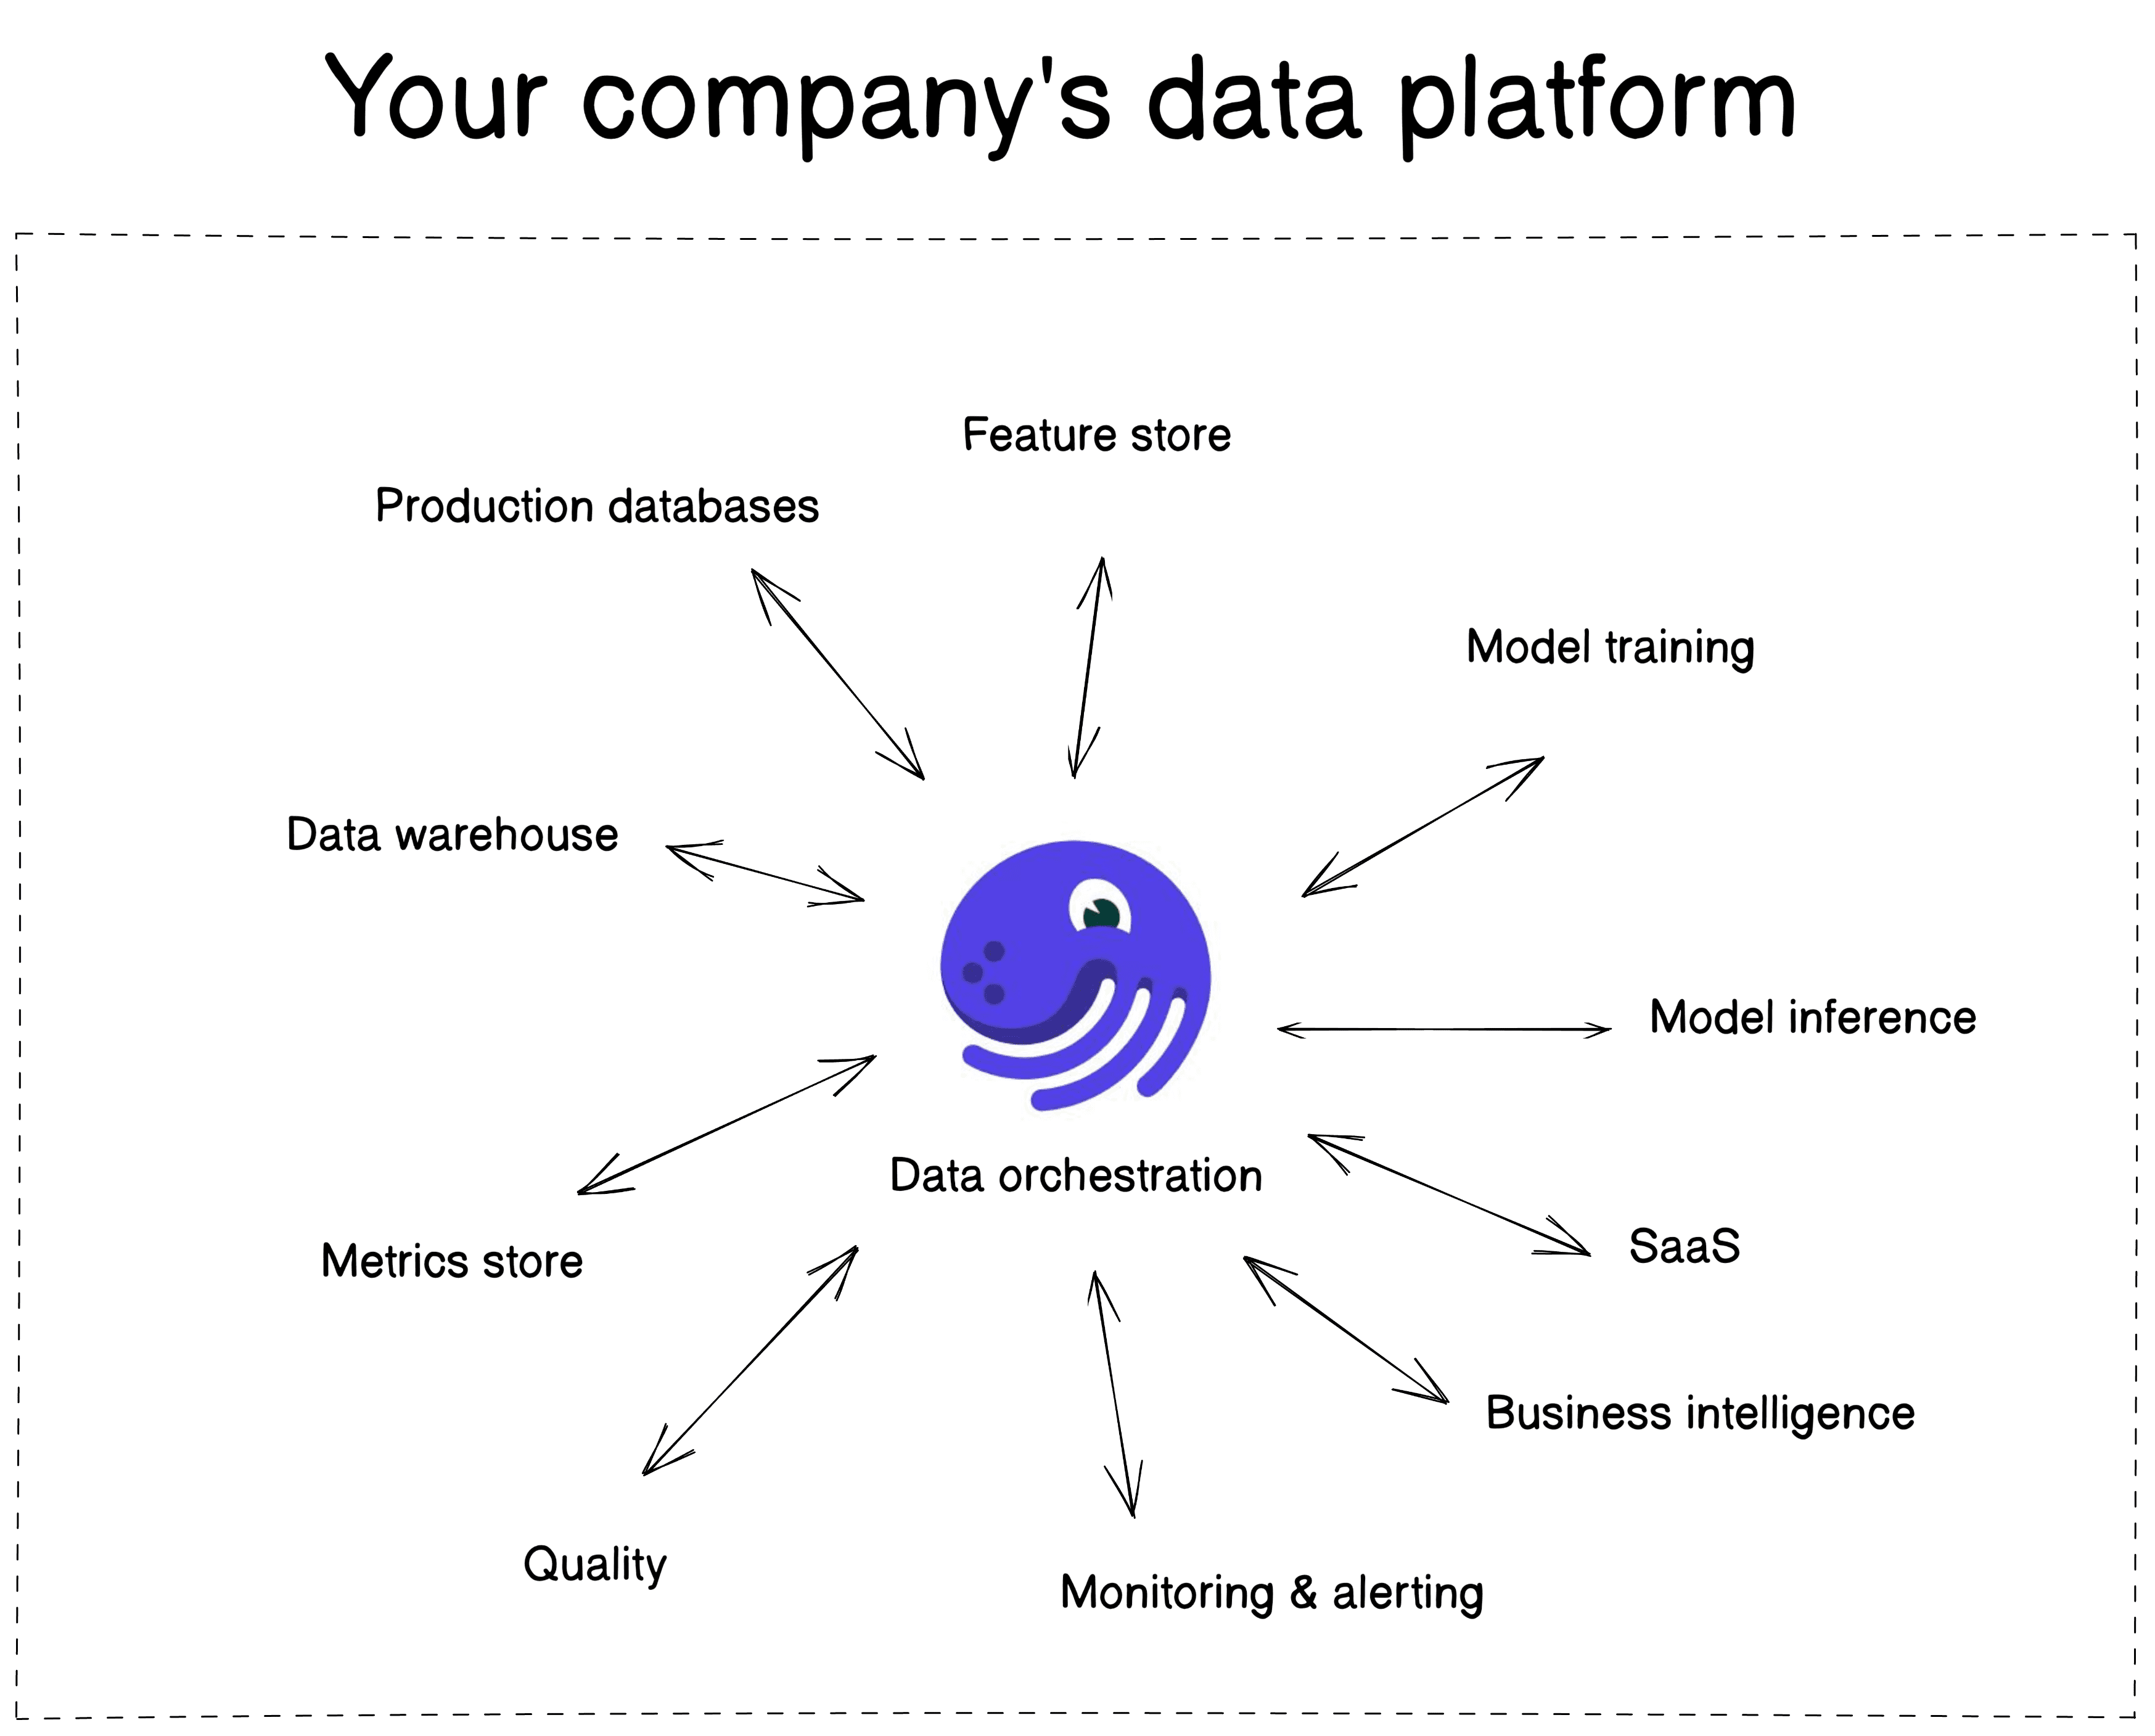
Dagster строит исполнение вокруг графов, где узлы представляют собой операции, а связи - зависимости по входам-выходам. Параллельность достигается за счёт распараллеливания независимых узлов и возможности масштабирования вычислительного окружения. IO‑менеджеры и ресурс‑объекты служат точками интеграции с внешними системами и хранилищами, отделяя логику обработки от специфики инфраструктуры. Мониторы и логирование позволяют отслеживать работу графов и быстро реагировать на отклонения.
В контексте производительности важны:
- выбор исполнителя (например, локальный multiprocessing, Celery или Kubernetes-based execution) в зависимости от требования к латентности и объёма нагрузки;
- настройка параллельной обработки и ограничение количества одновременных задач на уровень пулов ресурсов;
- стратегия кэширования и порогов материализаций, чтобы повторные запуски обходились без повторных вычислений;
- проектирование графов так, чтобы минимизировать цикличность и избегать избыточного повторного выполнения.
Технические решения должны быть согласованы между командами: архитектура данных, команды разработки и команда Infra должны выстроить единые политики контроля константных параметров (например, максимальное количество одновременных задач, лимиты памяти и CPU, политики кэширования) и единый подход к мониторингу.
Конфигурация и управление ресурсами Dagster
Управление ресурсами и конфигурациями - центральный механизм оптимизации. Эффективная конфигурация включает выбор исполнителей, IO‑менеджеров, ресурсных объектов и стратегий кэширования. В Dagster выделяют несколько ключевых смысловых слоёв:
-
Executor (исполнитель): определяет, как выполняются задачи графа. Различают локальные и распределённые варианты - в зависимости от характера нагрузки можно выбрать multiprocessing, Celery, KubernetesRunLauncher и другие конфигурации. Правильный выбор влияет на задержку начала выполнения, устойчивость к сбоям и стоимость инфраструктуры.
-
Resources (ресурсы): объекты, которые предоставляют внешние сервисы, например базы данных, очереди сообщений, хранилища. Ресурсы должны быть максимально детерминированы и переиспользоваться между операциями для снижения накладных расходов на инициализацию и повторные подключения.
-
IO Manager (управление вводом-выводом): абстракция доступа к внешним хранилищам данных. Правильный IO Manager улучшает локализацию данных, снижает накладные расходы на копирование и сериализацию, обеспечивает устойчивость к сбоям и оптимизирует чтение/запись.
-
Run config (конфигурация прогона): задаёт параметры для конкретного прогона, включая параметры источников данных, режимы выполнения и ограничители ресурсов. Грамотно организованная конфигурация позволяет быстро подбирать оптимальные режимы под текущую нагрузку без изменений в коде.
-
Caching и materialization: использование кэширования результатов и сохранение ключевых промежуточных состояний в стабильном хранилище позволяет значительно снизить повторные вычисления и ускорить повторные прогоны.
Ниже приведён пример упрощённой конфигурации run config и ресурсов, иллюстрирующий, как можно настроить параллелизм и доступ к БД.
{
  "execution": {
    "multiprocess": {
      "config": {
        "max_concurrent": 4
      }
    }
  },
  "resources": {
    "postgres": {
      "config": {
        "conn_str": "postgresql://user:pass@db.internal:5432/schema"
      }
    }
  },
  "io_manager": {
    "config": {
      "base_dir": "/data/dagster/io"
    }
  }
}
Такая конфигурация позволяет ограничить параллелизм и стабилизировать интенсивность обращения к БД, что особенно важно при высокой частоте прогонов и большом объёме данных. В реальных условиях необходимо дополнительно рассмотреть вопросы сетевой безопасности, мониторинга подключений и политики повторной попытки при сбоях.
Баланс между производительностью и стоимостью достигается через осмысленный выбор исполнителей и конфигураций ресурсов. При этом следует учитывать характер задач: для CPU‑интенсивных ETL‑процессов предпочтение часто отдаётся распределённому исполнителю с большим горизонтом масштабирования; для пакетной обработки небольших партий оптимальны локальные или встроенные исполнители, чтобы минимизировать накладные расходы на оркестрацию и сетевые задержки.
Оптимизация планирования и зависимостей
Оптимизация планирования осуществляется на уровне графов и зависимостей между операциями. В Dagster эффективная работа достигается за счёт нескольких факторов:
-
Разделение графа на независимые подграфы: параллелизм возрастает, если можно распараллелить узлы, не зависящие друг от друга. Вложение независимых операций в отдельные группы позволяет более эффективно распределять ресурсы и снижать задержку.
-
Управление fan-out и fan-in: чрезмерное распараллеливание без учёта ресурсов может привести к контекстной перегрузке. Необходимо подбирать баланс между количеством одновременно выполняемых задач и доступными CPU/памятью, а также учитывать влияние на сеть и хранилища.
-
Кэширование и материализации на уровне графов: хранение результатов между прогонами, если данные не изменяются, позволяет существенно сократить время обработки повторных прогона и backfill-операций.
-
Partitioning и time-based стратегии: разделение данных по временным фреймам (дни, часы) упрощает инкрементную обработку и ускоряет повторное выполнение за счёт обработки только актуальных сегментов данных.
-
Динамические графы и устойчивость к изменениям: возможность создавать или модифицировать подграфы во время выполнения (dynamic graphs) полезна для адаптивной обработки данных, однако требует контроля над гарантией повторяемости и детерминированности прогонов.
-
Backfill и детерминированность: при необходимости восполнения недостающих данных следует заранее планировать backfill‑периоды и обеспечить идентичность схемы зависимостей между прогоном и данными. Это уменьшает риск непредсказуемой переработки и ошибок в данных.
Примеры сценариев оптимизации зависимостей
-
Инкрементная загрузка данных: для источников, которые обновляются регулярно, разумно вычислять только новые данные и повторно использовать результаты ранее обработанных сегментов. Это потребует конфигурации partition sets и соответствующей логики в операциях.
-
Многоступенчатые трансформации: если часть операций потребляет результаты другой части, перемещение часто используемых промежуточных данных в материалицации может снизить повторные вычисления и увеличить устойчивость к задержкам на входах.
-
Распределение transforms между локальными и внешними вычислительными кластерами: часть тяжёлых задач можно вынести на кластер, например, Spark или Dask, сократив нагрузку на основной вычислительный поток dagster‑workflow.
Возможности Dagster для планирования и зависимостей дополняются механизмами мониторинга и телеметрии, что позволяет оперативно корректировать конфигурацию графов и ресурсы на основании фактических метрик выполнения.
Мониторинг, профилирование и автоматизация обслуживания
Оптимизация невозможна без объективной картины того, что происходит в продакшене. Важны три слоя наблюдаемости:
-
Метрики производительности: пропускная способность, задержки на уровне отдельных узлов, время до первого результата, очереди задач и загрузка ресурсов. Эти метрики позволяют определить узкие места и корректировать конфигурацию.
-
Трассировка и логирование: детальная трассировка исполнения, аннотирование ошибок, сбор контекстной информации о входных данных и параметрах конфигурации. Систематическое логирование упрощает последующий анализ и ревизии.
-
Мониторинг и алертинг: интеграция с Prometheus/OpenTelemetry для сбора метрик, алерты по порогам задержек, долгим задачам и перегрузке сервисов.
Dagster предоставляет встроенную панель Dagit, где можно проследить исполнение графов, зависимости, параметры прогонов и текущее состояние очередей. В условиях крупных корпоративных окружений целесообразна интеграция Dagster с внешними системами мониторинга и журналирования, чтобы обеспечить единый контур observability.
Практически важна настройка трассировок в рамках облачных или локальных кластеров:
- включение OpenTelemetry или аналогичных стэков для распределённых вызовов;
- экспорт телеметрии в центральный backend;
- сбор и агрегацию метрик по всем окружениям (dev/stage/prod) для сравнения и выявления деградаций.
Автоматизация обслуживания включает:
- автоматическую перезагрузку и повторные попытки при сбоях, с разумной политикой экспоненциальной задержки;
- автоматизированное масштабирование исполнителей в зависимости от текущей загрузки и ожидаемой продолжительности задач;
- регулярную ревизию конфигураций ресурсов и IO‑менеджеров на основе изменений нагрузки и данных.
Практические сценарии и кейсы производительности
Реальная оптимизация чаще всего выходит за рамки одного аспекта и требует сочетания архитектурных решений и операционных практик. Рассмотрим типичные кейсы:
-
Кейc 1: Ингресс больших данных с умеренной задержкой. Решение: применяем параллелизм на уровне графа, ограничиваем одновременные прогоны через executor, используем эффективный IO‑Manager и кэшируем промежуточные результаты. Важно ограничить подключения к источникам и настроить backpressure для внешних сервисов.
-
Кейc 2: Тяжёлые трансформации в внешнем кластере. Решение: вынуждаем части вычислений на Kubernetes/Dask/Spark cluster через соответствующий RunLauncher, чтобы не перегружать локальный воркер. При этом сохраняем воспроизводимость за счёт детерминированной конфигурации, использование partitioning и контроль версий промежуточных материалов.
-
Кейc 3: Динамические графы и рост числа зависимостей. Решение: использовать динамические графы для адаптивной обработки, но заранее определить политики контроля версий и повторяемости прогонов, чтобы не увеличить время на дебаг. В этом случае особенно важна кэшируемость результатов и мониторинг задержек по каждому узлу.
Эти сценарии демонстрируют, что добиться баланса между скоростью выполнения и стоимостью инфраструктуры можно только через системный подход: выбрать правильный набор инструментов, грамотно конфигурировать ресурсы и обеспечить прозрачную observability.
Key takeaways
- Оптимизация Dagster строится на принципах разделения вычислений, хранения и зависимостей, что позволяет гибко масштабировать компоненты.
- Правильный выбор executors и конфигураций ресурсов существенно влияет на латентность, устойчивость и стоимость инфраструктуры.
- Эффективное кэширование и материализация промежуточных данных уменьшают повторные вычисления и ускоряют прогоны.
- Планирование зависимостей и partitioning позволяют инкрементно обрабатывать данные и уменьшать переработку.
- Мониторинг, трассировка и алертинг являются критическими для поддержания производительности в продакшене.
- Интеграция Dagster с внешними системами хранения и вычисления требует внимания к совместимости и архитектурной согласованности.
- Применение кейсов и практических сценариев помогает определить оптимальный баланс между скоростью выполнения и затратами.
FAQ
- Какие основные параметры влияют на производительность Dagster?
Производительность зависит от типа исполнителя, уровня параллелизма, конфигурации IO‑менеджера, политики кэширования, а также качества конфигураций ресурсов и планирования графа. Правильная настройка этих параметров позволяет снизить задержку прогонов, увеличить пропускную способность и уменьшить стоимость инфраструктуры.
- Как выбрать подходящий исполнитель для моего кейса?
Если задача требует минимальной задержки и работа идёт локально на одном узле, можно начать с локального multiprocessing. Для больших объемов данных и распределённых источников лучше рассмотреть Celery или KubernetesRunLauncher. Важно оценивать не только латентность, но и устойчивость к сбоям, сетевые затраты и сложность поддержания инфраструктуры.
- Что такое IO‑Manager и зачем он нужен в оптимизации?
IO‑Manager абстрагирует доступ к внешним хранилищам и промежуточным данным. Он играет ключевую роль в производительности за счёт эффективной сериализации, копирования и хранения данных. Хороший IO‑Manager минимизирует лишние передачи данных и обеспечивает повторное использование материалов, что сокращает общее время прогона.
- Какие практики кэширования наиболее эффективны в Dagster?
Эффективное кэширование строится на сохранении результатов промежуточных операций (materializations) и повторном использовании их при повторных прогонках, когда входные данные не изменились. Важно корректно управлять зависимостями и версиями данных, чтобы кэш не приводил к Stale data. Внедрение политики времени жизни кэша и явное управление ситуациями изменения источников данных помогает избежать ошибок.
- Как минимизировать время загрузки новых данных без потери воспроизводимости?
Используйте partitioning и инкрементную обработку, чтобы обрабатывать только новые данные. При этом сохраняйте детерминированность прогонов: фиксируйте версии данных и конфигурации, применяйте одинаковые параметры запуска и материалов для повторяемости.
- Какие метрики критичны для мониторинга производительности?
Ключевые метрики: время выполнения отдельных узлов, задержка от входа до выхода, очереди задач, загрузка CPU/памяти, количество активных прогонов, частота ошибок и повторных попыток. Важно объединить их в единый дашборд и устанавливать оповещения на пороги, чтобы своевременно обнаруживать деградацию.
- Как внедрять оптимизацию без риска нарушения существующих пайплайнов?
Начинайте с постепенных изменений: локальная настройка конфигураций на dev/stage, A/B‑пилоты между старой и новой конфигурацией, дублированные прогуи и детальное тестирование на репозитории. Внесение изменений в понятной и версионируемой форме снижает риск сбоев в продакшене.
- Какие типичные ошибки при оптимизации стоит избегать?
Слишком агрессивный параллелизм без учёта ограничений инфраструктуры может привести к перегрузке. Неправильная конфигурация кэширования может привести к устаревшим данным. Игнорирование мониторинга и алертинга часто приводит к «слепым» зонам, когда проблемы накапливаются незамеченными.
- Какие практические шаги для внедрения оптимизации в команду?
Начните с аудита текущих прогонов: показатели времени, загрузки и повторной обработки. Определите узкие места, затем постепенно внедряйте улучшения: настройку executor, ресурсных объектов и partitioning. Включите в процесс код-ревью и контроль версионирования конфигураций, создайте единые правила наблюдения и алертинга.
- Как обеспечить воспроизводимость при изменении конфигураций и инфраструктуры?
Используйте детерминированные версии данных и конфигураций, фиксируйте параметры прогона, применяйте контроль версий к конфигурационным файлам и кода. При переходе на новые инфраструктурные компоненты выполняйте параллельные прогонные тесты и регресс‑проверки на staging, прежде чем выпускать обновления в prod.


