

Технологическая платформа для self-service: принципы, сервисы и уровни абстракций
Сам процесс цифровой трансформации через Data Mesh требует не только децентрализации данных, но и единой, но гибкой технологической платформы, которая позволяет доменным командам быстро находить, осваивать и создавать data products. Технологическая платформа для self-service выступает связующим звеном между автономией команд и централизованной управляемостью, обеспечивая стандартизированные механизмы публикации, потребления и монетизации данных, а также интеграцию инфраструктурных сервисов, необходимых для эффективной работы в рамках принципов Data Mesh.
В данной главе рассматриваются принципы проектирования и эксплуатации self-service платформы, её архитектурные слои, набор сервисов и уровни абстракций, которые позволяют доменным командам быстро переходить от идеи к работающему data product. Акцент сделан на практических решениях, которые можно реализовать в рамках реальных организационных условий: от концепций до конкретных паттернов интеграции и примеров реализации.
-
Определение роли self-service платформы в Data Mesh и принципы её построения
-
Архитектура слоёв, абстракций и ключевых сервисов
-
Интеграционные паттерны, протоколы и безопасная совместимость между доменами
-
Практические подходы к реализации и эксплуатации, включая минимальный набор API и инструментов
-
Концептуальные основополагающие принципы self-service платформы и роль платформенной команды
-
Архитектурные слои, уровни абстракций и принципы совместного использования сервисов
-
Сервисы платформы: каталог, котроль качества и политики доступа, оркестрация и мониторинг
-
Реализация и операционная практика: минимальная жизнеспособная платформа, шаблоны data product и контракты данных
Концепции и цели технологической платформы self-service
Главная цель self-service платформы - снизить порог входа для доменных команд и одновременно повысить стандартизацию и управляемость data products. Это достигается за счет предоставления унифицированного набора сервисов и инструментов, которые позволяют:
- обнаруживать и исследовать данные: через каталог данных, метаданные, lineage и контракты;
- разрабатывать data products: через шаблоны, конвейеры и средства публикации;
- потреблять данные: через безопасный доступ, согласованные API и локальные режимы исполнения;
- обеспечивать качество, безопасность и соответствие требованиям: через политики, верификацию схем, контроль доступа и мониторинг.
Важнейшая логика - поддерживать баланс между автономией команд и обязательной совместной скоростью. Платформа должна быть достаточно гибкой, чтобы поддерживать разнообразие доменов, но достаточно предсказуемой и воспроизводимой, чтобы соответствовать требованиям корпоративной политики и аудита. В контексте Data Mesh платформа выступает как продукт для внутренних потребителей, управляемый платформенной командой, но с открытыми контрактами и четко определённой ответственностью доменов за данные.
Особую роль здесь играет концепция самоподдерживаемого окружения: команды получают инструменты и инфраструктуру, которые можно конфигурировать и расширять без обращения к централизованной командной группе каждый раз. Однако платформа также должна предоставлять механизмы для централизованного контроля: совместное развитие стандартов, управление версиями схем, политики доступа и мониторинг.
Архитектура: слои, принципы и уровни абстракций
Архитектура технологической платформы self-service строится песочницей слоёв, где каждый уровень добавляет функциональность и абстракцию, но сохраняет совместимость с нижними уровнями. Основные слои условно можно представить так:
- Инфраструктурный слой: базовая облачная инфраструктура, драйверы хранения, вычислительная мощность, сетевые политики и управление данными на уровне хранения. Этот слой отвечает за ресурсную доступность, надёжность и безопасность инфраструктуры.
- Платформенный слой: набор сервисов, которые предоставляют общие возможности для доменов (каталог данных, управление качеством данных, политики доступа, метаданные, оркестрация конвейеров, мониторинг и алерты). Этот слой обеспечивает стандартизированную функциональность и единый интерфейс доступа к данным.
- Приложение/доменный слой: конкретные data products и сервисы доменов. На этом уровне домены сами разрабатывают и публикуют data products, пользуясь сервисами платформы - без необходимости повторно реализовывать инфраструктурную логику.
- Уровень взаимодействия и UX: интерфейсы API, пользовательские порталы, CLI-утилиты и интеграции с инструментами аналитики и BI. Этот уровень обеспечивает удобство использования и ускоряет процесс саморасправления (self-service).
Уровни абстракций также можно рассматривать через призму контрактов и политики: контракты данных, версии схем, требования к качеству, требования к безопасности и доступу. Контракты должны быть версионируемыми и взаимно согласованными между доменами и платформой. В идеале платформа должна поддерживать декларативный подход: политики и контракты описываются в виде кода, который затем применяется и проверяется на этапе публикации data product.
На практике целесообразно внедрять слои так, чтобы доменные команды могли приступать к работе в рамках минимально необходимого набора сервисов, но при этом хранить возможность расширения и эволюции платформы. Примером может служить внедрение отдельных компонентов пошагово: каталога данных, затем контрактной проверки, затем механизмов публикации и автоматической проверки качества.
Связь между слоями обеспечивают общие протоколы и стандарты обмена данными. Рекомендованы следующие принципы:
- контрактное программирование: схемы и контракты данных являются первым классом, а не дополнительным слоем;
- инфраструктура как код: все конфигурации и политики оформляются в виде кода и разворачиваются через CI/CD;
- совместная эволюция: изменения в платфоре должны проходить через регрессионное тестирование и планируемый выпуск;
- observability by design: сбор метрик, трассировок и журналов оборачивается в стандартные сервисы и коридоры алертов;
- безопасность по умолчанию: принципы минимального доступа, RBAC/ABAC и контекстуальные политики применяются на всех уровнях.
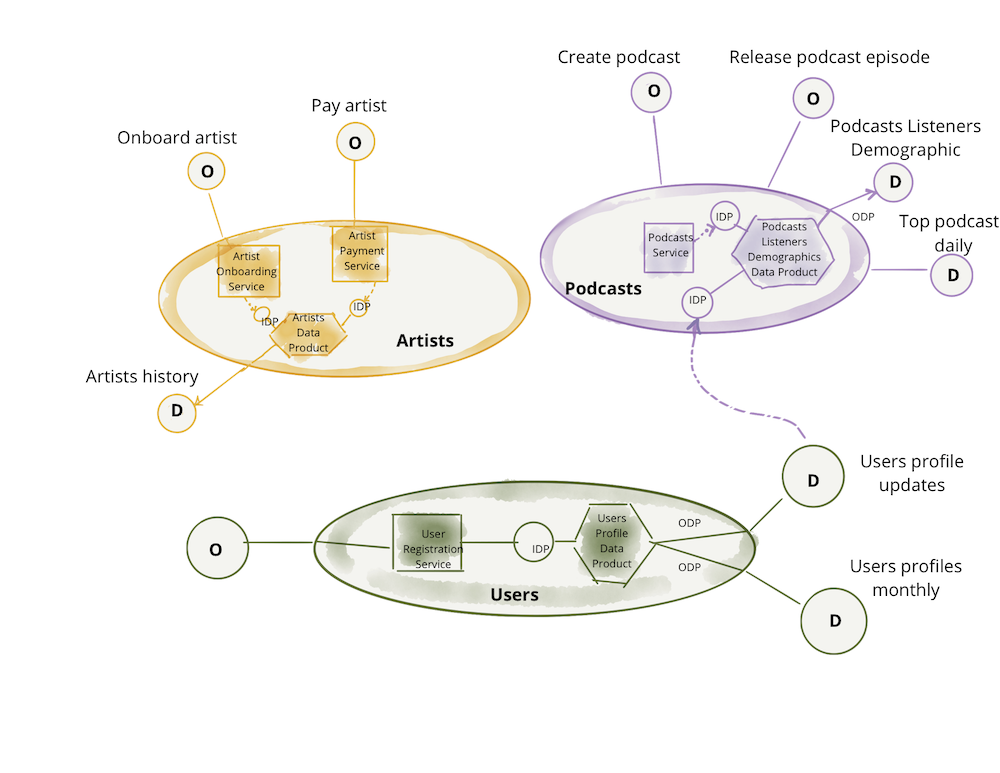
Сервисы платформы: каталог, качество, доступ и оркестрация
Самый заметный набор сервисов self-service платформы включает следующие элементы. В рамках каждого элемента приводятся функциональные цели, а не перечень инструментов: можно выбирать разные реализации в зависимости от контекста организации.
-
Каталог данных и данные о продуктах (data catalog): основной интерфейс к данным и data products. Каталог объединяет метаданные о источниках, схемах, lineage, ownership и SLA, обеспечивает поиск и фильтрацию, а также отображение зависимостей между продуктами. Для доменов критично наличие понятного описания контрактов данных и доступности версий.
-
Контракты данных и управление схемами: сервис верификации форматов данных, совместимости и эволюции схем. Поддерживает схемы в стандартах JSON Schema, Avro, Protobuf; регистр версий и миграцию схем. Важной частью является регуляторная и бизнес-логика валидации данных на входе в pipeline и на выходе к потребителям.
-
Политики доступа и безопасность: управление доступом к данным на уровне data product'ов, источников и операций. Реализация должна поддерживать RBAC и ABAC, а также контекстуальные политики, например на основе роли пользователя, домена и типа запроса. Необходимо интегрировать явные сценарии аудита и журналирования доступа.
-
Оркестрация и конвейеры данных: управление жизненным циклом pipelines - от ingestion до публикации data product. Включает планирование, выполнение и мониторинг задач, обработку ошибок, повторные попытки и задержки. Важно обеспечить повторяемость и прозрачность исполнения, включая схему ошибок и методологии восстановления.
-
Управление качеством данных: профилирование, проверка качества, постановка порогов и мониторинг соответствия SLA. Сервис должен автоматически обнаруживать отклонения и генерировать уведомления для домена-владельца продукта, а также предлагать корректирующие действия.
-
Мониторинг и наблюдаемость: сбор метрик, трассировок и журналов, а также визуализация зависимостей между данными и конвейерами. Включает алерты по аномалиям качества, задержкам обработки и отклонениям от контрактов. Все данные о метриках должны быть доступными для доменных команд и платформы.
-
Поиск и обнаружение данных: эффективный поиск по метаданным, визуализация lineage и контекст источников. Часто реализуется через специализированные движки и интеграцию с каталогами, что позволяет быстро локализовать данные и понять влияние изменений.
-
Инструменты разработчика и UX self-service: CLI, UI-портал и API-first подход. Удобный доступ к каталогу, к публикации data products, к управлению контрактами и к мониторингу. Важна консистентность UX между различными сервисами и простая интеграция с внешними инструментами аналитики и BI.
-
Примеры реализуемых решений: в рамках современной экосистемы наиболее часто встречаются DataHub или Amundsen как каталоги, а в рамках российского рынка - Yandex DataSphere. Эти примеры иллюстрируют реальные сценарии интеграции каталогов, контрактов и оркестрации в Data Mesh. При выборе инструментов следует учитывать совместимость с существующей инфраструктурой и организационные потребности.
Интеграционные паттерны и протоколы
Эффективная self-service платформа требует согласованных паттернов интеграции и протоколов взаимодействия между доменными сервисами и платформой. Важные направления включают:
-
Доменная автономия с формальными контрактами: data contracts должны быть версионируемыми и внедряться через политики контроля качества. Домены публикуют data products по установленным шаблонам, а платформа проверяет соответствие контрактам на этапе публикации.
-
Паттерны передачи данных: выбор между пакетной обработкой и стримингом в зависимости от требования к задержкам и объему. Для стриминга часто применяются протоколы и технологии с высокой пропускной способностью, такие как Apache Kafka. Для пакетной обработки - ориентиры на расписания и конвейеры с гарантированной выпускной задержкой.
-
Форматы и обмен схемами: использование стандартных форматов схем (Avro, Protobuf, JSON Schema) и управление версиями. Это обеспечивает совместимость между доменами и упрощает миграцию и эволюцию данных.
-
Безопасность и контроль доступа: интеграция с системами аутентификации и авторизации, протоколы OAuth2/OpenID Connect, JWT-токены для межсервисного взаимодействия, а также политика доступа как код (policy-as-code).
-
Метаданные и lineage: обмен данными о происхождении, зависимостях и обновлениях между каталогами, конвейерами и системами мониторинга. Это обеспечивает прозрачность для аудита и аналитиков.
-
Интеграции с инструментами анализа: обеспечение совместимости API и интерфейсов для популярных BI-инструментов и дата-аналитики. Важно предоставить единый уровень абстракций, чтобы домены могли потреблять данные одинаково вне зависимости от конкретной инфраструктуры.
-
Пример паттерна (на уровне архитектуры): домен публикует data product через сервис публикации, который валидирует контракт и регистрирует продукт в каталоге. Каталог генерирует lineage и предоставляет API для потребителей. Платформа отслеживает выполнение конвейеров и качество данных, отправляя уведомления в случае нарушений.
Реализация и практические подходы
Для успешной реализации self-service платформы в условиях Data Mesh необходимы последовательные шаги, ориентированные на устойчивое внедрение, а не на разовый проект. Рекомендованы следующие принципы:
-
Планируйте платформу как продукт: определите целевые сценарии использования для доменных команд, сформируйте команду платформы, задокументируйте требования и набор сервисов, которые будут разворачиваться в рамках дорожной карты.
-
Начните с минимального жизнеспособного продукта (MVP): выберите один-два домена и реализуйте круговую цепочку от публикации data product до потребления. Постепенно расширяйте функциональность через итерации, сохраняя совместимость контрактов и прозрачность мониторинга.
-
Контракты и версия схем как основа эволюции: версия контракта должна быть явной и сопровождаемой миграцией. Потребители должны иметь возможность указывать требуемую версию контракта и видеть потенциальные расхождения при обновлениях.
-
Шаблоны data product и готовые сценарии: предоставляйте стандартизированные шаблоны для описания домена, собственника, целей SLA и ограничений доступа. Это ускоряет повторное использование и снижает риск ошибок.
-
Инфраструктура как код и политика как код: все конфигурации, политики, схемы и параметры конвейеров оформляйте в коде и храните в системе контроля версий. Это упрощает аудит и регрессий тестирование.
-
UX и разработчикам - единый фронтенд: создайте единый портал self-service, который агрегирует доступ к каталогу, инструментам конвейеров и мониторинг. Поддерживайте API-first подход и обеспечьте удобную CLI.
-
Управление качеством и автоматизация тестирования: задайте пороги качества данных, регламентируйте тесты на входе и выходе, а также предусмотрите автоматическую регрессию по изменениям контрактов и схем.
-
Соглашение по SLA и ответственность домена: каждая data product имеет владельца и договор об уровне обслуживания, включая качество, доступность и обновления. Это помогает управлять ответственностью в распределённой системе.
{
  "openapi": "3.0.0",
  "info": { "title": "Data Mesh Self-Service Catalog", "version": "1.0.0" },
  "paths": {
    "/catalog/data-products": {
      "get": { "summary": "List data products", "responses": { "200": { "description": "A list of data products" } } }
    },
    "/catalog/data-products/{id}": {
      "get": { "summary": "Get data product details" }
    },
    "/provisioning/produce": {
      "post": {
        "summary": "Publish new data product",
        "requestBody": { "required": true, "content": { "application/json": { "schema": { "$ref": "#/components/schemas/DataProductDraft" } } } },
        "responses": { "201": { "description": "Created" } }
      }
    }
  },
  "components": {
    "schemas": {
      "DataProductDraft": {
        "type": "object",
        "properties": {
          "name": { "type": "string" },
          "domain": { "type": "string" },
          "description": { "type": "string" },
          "schema": { "type": "string" },
          "owner": { "type": "string" }
        },
        "required": ["name", "domain", "schema", "owner"]
      }
    }
  }
}
Путь к устойчивой реализации лежит через поэтапное внедрение архитектурной дисциплины, заботу о качестве данных и активное участие доменных команд в управлении данными. В качестве примера можно рассмотреть опорную интеграцию каталога данных с системой управления доступом и конвейером публикации: домен публикует data product, платформа валидирует контракт и регистрирует продукт в каталоге, далее потребитель видит продукт и может обратиться к данным через единый API. Такой подход позволяет быстро масштабировать федеративную архитектуру, сохраняя прозрачность и управляемость.
Примеры архитектурных решений и их влияние на внедрение
-
Каталог данных DataHub или Amundsen как инструмент для хранения и экспорта метаданных, lineage и рабочих контрактов. Эти решения показывают, как можно организовать поиск, представление метаданных и зависимостей между источниками и потребителями. У российских реалий хороший пример - интеграция с Yandex DataSphere в рамках локальных проектов, что позволяет сочетать локальные требования к данным и доступность инструментов.
-
Оркестрация конвейеров и обработка потоков: выбор между Dagster или Apache Airflow для управления конвейерами, интегрированными с каталогом и системой контроля качества. Это обеспечивает прозрачность выполнения, повторяемость процессов и ускоряет внедрение новых data products.
-
Контроль версий схем и контрактов: использование схем Avro/Protobuf и версионирование контрактов через систему контроля версий. Такой подход упрощает миграцию и поддерживает совместимость между доменами.
-
Безопасность и аудит: внедрение политики доступа как код с использованием IAM-ролей и ABAC-подходов. Логирование доступа и действий над данными обеспечивает необходимый уровень аудита и соответствие требованиям.
Key takeaways
- Self-service платформа в Data Mesh должна сочетать автономию доменов и централизованные механизмы управления данными, чтобы обеспечить прозрачность, качество и безопасность на уровне всей организации.
- Архитектура по слоям обеспечивает гибкость и эволюцию: инфраструктура, платформенный слой, доменные продукты и UX/API-интерфейсы.
- Контракты данных, версии схем и политики доступа должны быть первоклассными конструкциями, интегрированными в процесс публикации data products.
- Каталог данных, управление качеством, безопасность и оркестрация конвейеров - ключевые сервисы платформы; их грамотная интеграция обеспечивает эффективное self-service и соблюдение норм.
- Реализация должна быть ориентирована на MVP с постепенным расширением: начинайте с минимального набора сервисов и доменов, затем эволюируйте платформу в соответствии с потребностями.
- Примеры инструментов, таких как DataHub/Amundsen и Yandex DataSphere, иллюстрируют реальный опыт внедрения и должны рассматриваться как ориентиры, а не универсальные решения.
- Важной частью является архитектура контрактов и схем, которая обеспечивает совместимость и безопасное развитие data products в федеративной среде.
FAQ
- Какие главные принципы лежат в основе технологии self-service платформы в Data Mesh?
- Основные принципы включают контрактность данных, версионирование схем, политики доступа как код, автоматизацию развёртывания и мониторинг, а также ориентированность на data products. Важна совместная ответственность доменов и платформы за качество и доступность данных, а также обеспечение developer experience для доменных команд.
- Какую роль играет каталог данных в self-service платформе?
- Каталог данных обеспечивает discoverability, контракты и lineage. Он служит единым источником истины для метаданных, способствует быстрому поиску data products, отображает зависимость между источниками и потребителями и поддерживает аудит данных.
- Какие паттерны передачи данных применяются в Data Mesh?
- Обычно применяются пакетные и стриминговые паттерны. Стриминг (например, через Kafka) подходит для низкой задержки и потока событий, тогда как пакетная обработка хороша для крупных массивов данных и встроенных конвейеров. Разделение задач между этими паттернами должно соответствовать требованиям к задержке и консистентности.
- Как управлять схемой и контрактом данных в разнообразной среде доменов?
- Контракты должны быть версиями и совместимыми с эволюцией схем. Верификация контрактов должна происходить на этапе публикации data product. Модель "contract-first" помогает снизить риски несовместимости и упрощает миграции.
- Какие инструменты подходят для реализации каталога и управления качеством?
- В качестве каталогов популярны DataHub и Amundsen; они обеспечивают метаданные, поиск и lineage. Для управления качеством данных применяются профилирование, набор правил качества и мониторинг, а также интеграция с конвейерами данных для автоматического тестирования и уведомления.
- Какие принципы безопасности критически важны для self-service платформы?
- Основы: минимальные привилегии, RBAC/ABAC, контекстуальные политики и аудит доступа. Важно обеспечить безопасное взаимодействие между доменными сервисами, защиту данных в покое и в транзитe, а также возможность мониторинга и аудита доступа к данным.
- Какие шаги следует предпринять для начала внедрения платформы в организации?
- Начните с определения целевых сценариев использования и создания MVP-платформы на нескольких доменах. Определите шаблоны data product, контрактные требования и базовый каталог. Постепенно добавляйте сервисы управления качеством, политики доступа и оркестрацию, параллельно развивая документацию и наставничество для доменных команд.
- Как обеспечить эволюцию платформы без нарушения существующих data products?
- Используйте версионирование контрактов, безопасную миграцию схем и регрессионное тестирование. Планируйте выпуск обновлений в виде управляемых релизов и поддерживайте обратную совместимость там, где возможно. Важна прозрачная коммуникация изменений и чёткие процессы отката.
- Какие риски сопутствуют внедрению self-service платформы и как их минимизировать?
- Риски включают фрагментацию данных, несоответствие контрактов, несоответствие требованиям безопасности и перерасход ресурсов на развёртывание. Минимизация достигается через контроль контракта, мониторинг качества, ограничения по доступу и последовательное расширение функциональности в рамках плана внедрения.
- Как связать архитектуру self-service с бизнес-целями организации?
- Архитектура должна поддерживать бизнес-цели через ускорение доставки data products, улучшение качества данных и прозрачность использования данных. Важно обеспечить соответствие data products SLA, понятную ответственность доменов и возможность быстрого анализа воздействия изменений на бизнес-показатели.


