

Архитектура и практики обеспечения отказоустойчивости и наблюдаемости
Децентрализованная архитектура данных Data Mesh требует принципиально иных подходов к отказоустойчивости и наблюдаемости, чем централизованные хранилища и монолитные конвейеры. В условиях, когда ответственность за данные лежит на доменах и каждый домен разворачивает свои data products, архитектурные решения должны обеспечивать изоляцию сбоев, предсказуемость поведения системы и детальную видимость взаимодействий между доменами. Настоящая глава формирует практический взгляд на архитектуру отказоустойчивости и наблюдаемости в контексте Data Mesh: как проектировать границы отказов, какие паттерны применять для устойчивого поведения потоков данных, как строить системную и доменную наблюдаемость, и какие технические решения позволяют реализовать Self‑Service платформы без потери управляемости и контроля.
Кратко содержание главы:
- Архитектура отказоустойчивости в Data Mesh: принципы изоляции, границы ответственности и инфраструктурные паттерны.
- Паттерны устойчивости и обработки сбоев: повторные попытки, защита от Poison Message, дедупликация и устойчивые транзакции.
- Наблюдаемость: SLO/SLI, трассировка и логи, корреляция доменных событий и конвейеров данных.
- Инструменты и протоколы: событийно-ориентированная архитектура, протоколы взаимодействия и контрактная эволюция схем.
- Реализация на примере прототипа: паттерны в действии и минимальные примеры кода для иллюстраций.
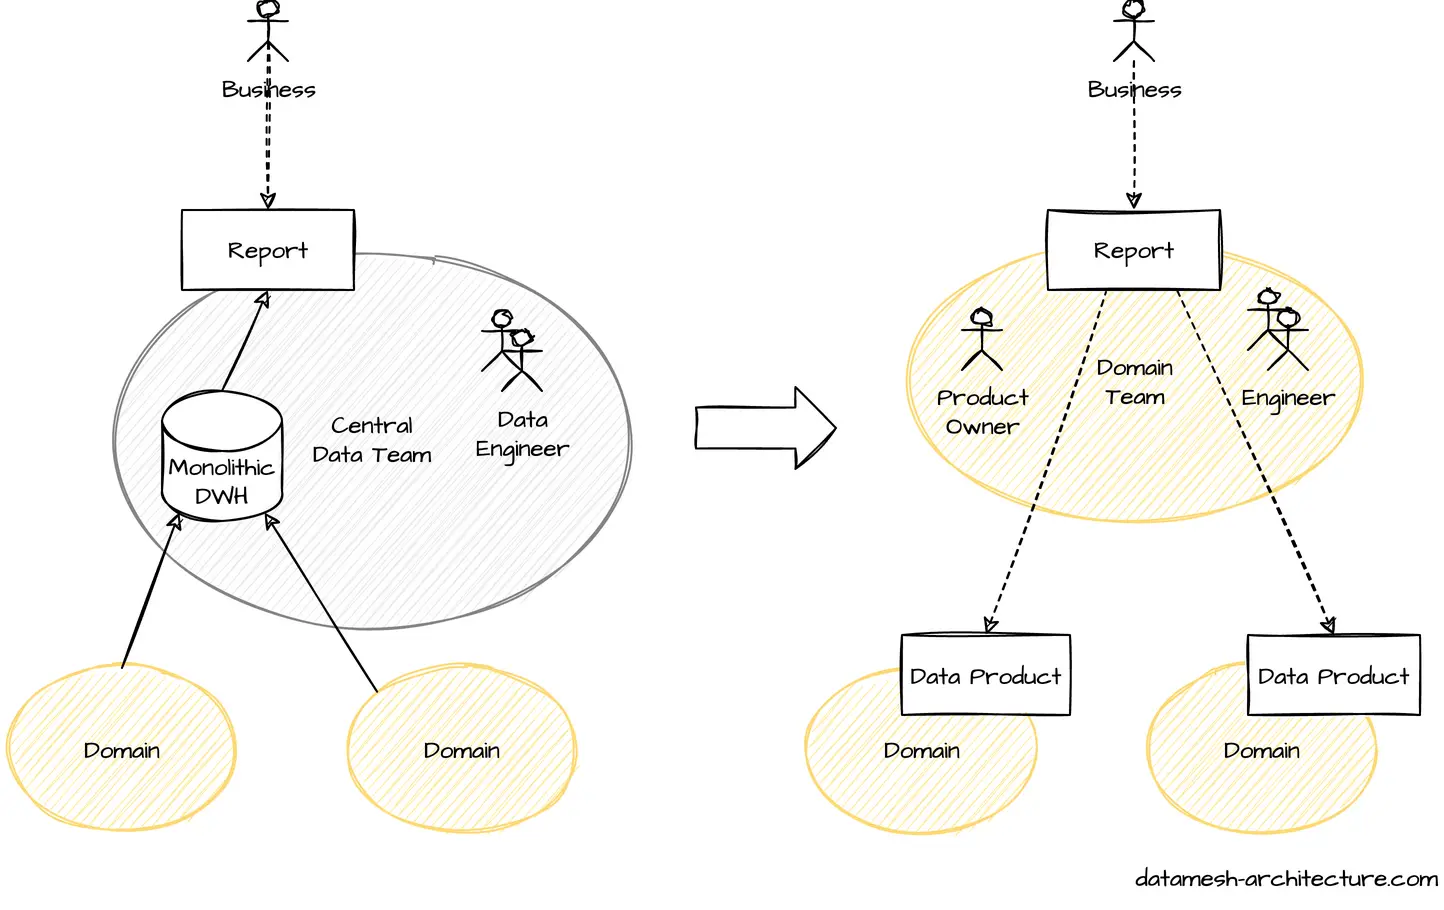
Архитектура отказоустойчивости в Data Mesh
В Data Mesh отказоустойчивость строится вокруг децентрализованных data products и их контрактов. Это требует концептуального перехода от монолитной, глобально управляемой устойчивости к локализованной, доменной устойчивости и предсказуемости поведения в условиях частых изменений и деградаций отдельных доменов.
-
Изоляция сбоев как базовый принцип. Каждый data product должен уметь продолжать работу в случае ухудшения доступности соседних доменов. Границы между доменами оформляются как «пары контрактов»: контракт согласованных форматов данных и контракт ожидаемого поведения. В рамках строгой изоляции используются паттерны bulkhead и ограничение зависимостей, чтобы падение одного домена не тянуло за собой всю систему.
-
Контракты данных и эволюция схем. Контракты должны быть версионированы, а эволюция схем - управляемой и обратимо сопровождаться траекториями миграции. Для этого применяются среды реестра схем и политики совместимости, позволяющие доменам разворачивать новые версии без полной остановки потребителей.
-
Мультирегиональность и консистентность. В условиях глобальных бизнес-потребностей нужен подход к репликации и восстановлению данных между регионами. При этом следует разграничивать уровни консистентности: для некоторых data products достаточно eventual consistency с гарантиями задержек и датами обновления, для критичных случаев - поддерживать более строгие договоренности через квазиреляционные схемы синхронизации.
-
Архитектура взаимодействий между доменами. В Data Mesh домены взаимодействуют через четко определенные интерфейсы и потоки данных, которые должны быть устойчивы к задержкам и временным outages. Публикуемые события, очереди и конвейеры должны поддерживать idempotentность и детерминированность обработки.
-
Инфраструктурная подложка. Поддержку отказоустойчивости обеспечивают логическая изоляция, деградационные режимы и автоматическое откатывающиеся обновления, а также инфраструктура непрерывного мониторинга и автоматического восстановления. Важным становится план тестирования устойчивости: регулярные проверки, сценарии деградации, Chaos Engineering и проверка согласованности после сбоев.
-
Ключевые концепции. Обеспечение устойчивости опирается на принципы: точка ответственности за данные в домене; контракт между производителем и потребителем; автономность доменных команд; возможность деградации и безопасного отката; и видимость состояния всей системы через унифицированную наблюдаемость.
Модели взаимодействия и устойчивости
-
Брайк-изоляция доменов. Каждому data product выделяется собственный слой обслуживания, собственная схема обработки и свой набор зависимостей, что минимизирует каскадные сбои.
-
Границы ответственности и контрактная архитектура. Контракты должны прописывать ответственность, форматы, сроки обновления и ограничения по времени жизни данных, что позволяет потребителям строить устойчивые коннекторы и обработку событий.
-
Поддержка отказоустойчивых паттернов в конвейерах. В периферийных конвейерах применяются очереди, очередные буфера, и повторная обработка, чтобы минимизировать потери данных в случае временных сбоев.
-
Резервирование и репликация. Репликация по регионам и резервирование транспортных путей позволяют переживать локальные перебои. Важно отделять логику репликации от бизнес-логики обработки, чтобы избежать непреднамеренного влияния на data products.
Паттерны обеспечения непрерывности и изоляции сбоев
Эти паттерны реализуют практическую часть архитектуры отказоустойчивости и обеспечивают предсказуемость поведения системы в условиях ошибок.
-
Circuit breaker и ограничение нагрузки. Применение цепочек circuito breaker предотвращает цепную реакцию сбоев и ускоряет восстановление. В случае превышения порога сбоев система переходит в состояние OPEN и временно блокирует вызовы к зависимым сервисам.
-
Повторные попытки с адаптивной задержкой и джиттером. Повторы должны происходить с экспоненциальной задержкой и случайным разбросом, чтобы избежать эффекта синхронных повторных запросов и перегрузки даже в случае частых сбоев.
-
Idempotentность и дедупликация. Производители и потребители должны обрабатывать повторные события безопасно. Встроенная идентификация сообщений через уникальные ключи и хранение выдаваемых пар данных обеспечивает повторную обработку без изменений результата.
-
Обработка Poison Messages. Система должна детектировать «ядовитые» сообщения и отделять их от обычной очереди для анализа и перезапуска конвейера без влияния на остальное движение данных.
-
Фелкование и деградационные режимы. В моменты перегрузки система может возвращаться к упрощенным режимам обработки, например, перераспределение ресурсов на наиболее критичные data products или использование кэширования для снижения задержек.
-
Эволюция и версионирование конвейеров. При изменении форматов данных и контрактов важно поддерживать параллельные версии конвейеров и плавный переход между ними, чтобы потребители не прерывались.
-
Защита от задержек и backpressure. Встроенные механизмы backpressure и ограничения пропускной способности помогают предотвратить лавинообразное переполнение систем и обеспечить устойчивость в периоды пиков.
-
Данные как поток: устойчивые конвейеры потоковой обработки. Использование очередей и потоков позволяет гибко масштабировать обработку и локализовать влияние сбоев.
-
Варианты консистентности. В зависимости от потребностей data product может требоваться различная степень консистентности: от eventual до более строгой. Решение принимается на уровне домена и отражается в контракте.
Наблюдаемость: метрики, трассировка и логи
Наблюдаемость служит связующим звеном между архитектурной устойчивостью и операционной дисциплиной. В Data Mesh она должна обеспечивать видимость на уровне доменов и конфигураций, чтобы можно было быстро выявлять и исправлять проблемы.
-
Системная и доменная наблюдаемость. В рамках Data Mesh наблюдаемость должна охватывать как инфраструктурные аспекты (состояние очередей, задержки передачи, пропускная способность), так и поведение data products (скорость генерации, качество данных, соответствие контрактам).
-
Метрики, SLIs и SLOs. Определение конкретных SLI для каждого data product позволяет установить прозрачные ожидания по времени обработки, точности данных и задержкам. Согласование SLO между доменами обеспечивает предсказуемость взаимодействий.
-
Корреляция событий и трассировка. В кросс-доменных сценариях крайне важно иметь единый контекст. Использование идентификаторов корреляции позволяет проследить путь данных от источника до потребителя, пройдя через конвейеры и сервисы, что существенно упрощает диагностику.
-
Наблюдаемость потоков и данных. Помимо métric и трассировки, необходима видимость по данным: версии схем, миграции, качество данных и своевременное уведомление об изменениях контракта. Это помогает выявлять несогласованность между доменами.
-
Инструменты и сбор телеметрии. В данных условиях применяются открытые и совместимые подходы. На практике это обычно включает сбор телеметрии через единый слой (observability plane), который агрегирует метрики, трассировки и логи.
-
Стратегия журналирования и корреляции. Логи должны содержать контекст домена, data product и идентификатор данных. Корреляция по ID позволяет связать события в конвейере и быстро выявлять узкие места.
-
Эволюция наблюдаемости. По мере развития Data Mesh меняются и требования к наблюдаемости: добавляются новые data products, новые схемы и новые интерфейсы. Наблюдаемость должна адаптироваться без рискованных изменений в потребляемых конвейерах.
Архитектура наблюдаемости
-
Аггрегирующая платформа наблюдаемости. Центральная платформа, которая агрегирует данные по всем доменам, но хранит и предоставляет их в контексте конкретных data products и их контрактов.
-
Стандартизованные контексты. Введение единых контекстов: данные о версии схемы, статусе конвейера, времени задержки, индикаторах качества. Это упрощает сравнение между доменами и ускоряет диагностику.
-
Верификация совместимости контрактов через мониторинг. Наблюдаемость должна позволять автоматически отслеживать соответствие текущих данных контрактам и фиксировать отклонения.
-
Визуализация и предупреждения. Дашборды, графики и алерты должны отображать не просто состояния инфраструктуры, но и поведение data products в контексте бизнес‑целей.
Инструменты и протоколы: от событий к потокам
Эффективная архитектура Data Mesh требует междоменного взаимодействия через понятные протоколы и форматы данных. Важно сочетать контрактную эволюцию, устойчивые механизмы доставки и соответствующую осведомленность по данным.
-
Событийная архитектура и консистентность. В Data Mesh домены публикуют события и данные через устойчивые конвейеры. Вопрос консистентности решается через контракт и управляемую эволюцию форматов, а критичные данные - через явные согласованные режимы обновления.
-
Контракты данных и схемы. Эволюция схем должна быть безопасной и контролируемой с помощью реестра схем и политик совместимости. Это позволяет доменам разворачивать новые версии без прерывания потребителей.
-
Протоколы взаимодействия. В рамках Data Mesh для междоменных вызовов применяются современные протоколы и принципы взаимообмена данными: gRPC, REST или асинхронная доставка через очереди. При этом важно сохранять совместимость контрактов и обеспечивать устойчивость к задержкам.
-
Форматы и сериализация. Ориентир на унифицированные форматы, такие как Avro или JSON Schema, помогает обеспечить структурированную валидацию и упрощает мониторинг соответствия данных контрактам.
-
Инструменты: выбор и ограничения. В рамках ограничений можно использовать 1-2 конкретных примера инструментов для открытой экосистемы: Apache Kafka как платформа потоков и OpenTelemetry как стандарт телеметрии. Эти две опоры позволяют выстроить устойчивую и наблюдаемую инфраструктуру без перегружения списком решений.
Реализация на примере прототипа
Для иллюстрации практических подходов рассмотрим упрощённый прототип взаимодействия между доменными data products с упором на отказоустойчивость и наблюдаемость. Предположим, что домен платежей публикует события платежных операций в Kafka, второй домен - уведомления - подписывается на эти события и формирует итоговую логику обработки. Контракты данных определяются через схему платежа и схема события статуса, которые поддерживаются через реестр схем.
-
Архитектура реализации. Включаем в прототип следующие элементы: публикация событий в Kafka, потребление с поддержкой повторной обработки, обработку ошибок и корреляцию по идентификатору платежа, сбор телеметрии через OpenTelemetry.
-
Принципы контроля ошибок и повторной обработки. Реализация паттерна circuit breaker и политики повторных попыток обеспечивает устойчивость к временным сбоям соседних доменов и внешних сервисов.
class CircuitBreaker: def __init__(self, failure_threshold=5, recovery_timeout=60): self.failure_threshold = failure_threshold self.recovery_timeout = recovery_timeout self.failures = 0 self.state = "CLOSED" self.last_failure_time = None def call(self, func, *args, **kwargs): import time if self.state == "OPEN": if time.time() - self.last_failure_time = self.failure_threshold: self.state = "OPEN" self.last_failure_time = time.time() -
Пример трассировки и корреляции. В проекте на стороне потребителя каждого data product вводится контекстный идентификатор correlation_id. Этот идентификатор прокидывается через все конвейеры, включая обработку в домене уведомлений и агрегацию в аналитических источниках. В OpenTelemetry настраиваются трасы, связывающие событие публикации, доставку и конечную обработку, что позволяет проследить путь данных между доменами.
-
Контроль качества и наблюдаемость. Установлены SLI по времени задержки (end-to-end latency) и по доле успешной обработки. Встроенная проверка соответствия текущих данных контрактам выполняется через проверку версии схем и валидацию полезной нагрузки на входах конвейеров.
-
Практическая эволюция. Прототип поддерживает параллельные версии обработчиков и миграцию схем без остановок. По мере роста Data Mesh добавляются новые data products и новые домены, но архитектура остаётся управляемой через контрактную эволюцию и централизованное планирование изменений в Observability Plane.
Примеры кода и конфигураций в реальных проектах обычно адаптируются под конкретные требования организации. В приведённом примере код иллюстрирует основной подход: изоляция через Circuit Breaker, контролируемые повторы, корреляция событий и базовую трассировку. В реальных условиях необходимо дополнять решение механизмами мониторинга, логирования и безопасной миграции контрактов.
Key takeaways
-
В Data Mesh отказоустойчивость строится вокруг изоляции доменных data products и контрактной архитектуры, что снижает риск каскадных сбоев.
-
Паттерны устойчивости ( circuit breaker, экспоненциальные повторы с джиттером, идемпотентность, дедупликация) позволяют сохранять функциональность при временных сбоях и перегрузках.
-
Наблюдаемость должна охватывать как инфраструктуру, так и бизнес‑поведение data products: SLO/SLI, корреляция событий и трассировка кросс-доменных конвейеров.
-
Контракты данных и эволюция схем - критически важные элементы: версионирование и реестр схем позволяют безопасно разворачивать новые версии без простоя.
-
Инструменты и протоколы для Data Mesh выбираются с учётом принципов открытости и совместимости: акцент на Kafka и OpenTelemetry даёт устойчивую базу для наблюдаемости и обмена данными между доменами.
-
Реализация устойчивости требует сочетания архитектурных паттернов и операционных практик: Chaos Engineering, регулярные проверки устойчивости и автономность доменных команд.
-
Важно сохранять баланс между автономией доменов и централизованной управляемостью: единые контракты, единый Observability Plane и прозрачное управление изменениями помогают сохранить предсказуемость.
FAQ
- Что такое отказоустойчивость в контексте Data Mesh и зачем она нужна?
Отказоустойчивость в Data Mesh - это способность системы продолжать функционировать и предоставлять данные доменам-потребителям даже при локальных сбоях в других доменах или инфраструктуре. Она становится критически важной из-за децентрализованной природы архитектуры: каждый домен отвечает за свои data products, и сбой одного домена может коснуться множества потребителей. Благодаря изоляции сбоев, контрактам и устойчивым конвейерам можно минимизировать влияние проблемы и обеспечивать предсказуемость поведения всей системы.
- Как определить SLO/SLI для разных data products?
SLO/SLI следует устанавливать на основе бизнес‑ценности data product и его критичности. Важные параметры: задержка обработки в конце‑то‑конца, точность/качество данных, доля успешной обработки, время простоя. В каждом домене эти параметры согласуются с стейкхолдерами и документируются в контракте data product. Для междоменных сценариев можно применять агрегацию SLI на уровне Observability Plane, чтобы обеспечить консистентную картину по всей системе.
- Как организовать корреляцию событий между доменами?
Используйте единый контекст обработки: каждый publishes unique correlation_id, который прокидывается в каждом событии и каждом конвертере/обработчике конвейера. Это позволяет трассировать путь данных от источника до потребителя и сопоставлять задержки и качество на разных этапах. Инструменты трассировки (например, OpenTelemetry) помогают визуализировать и анализировать эти пути.
- Какие паттерны помогают предотвратить перерасход ресурсов при сбоях?
Circuit breaker предотвращает каскадные сбои, а backpressure ограничивает скорость подачи данных в конвейеры. Повторы и дедупликация снижают риск потери данных при временных сбоях. Важна также сегментация очередей и изоляция доменных потоков обработки, чтобы сбой одного контура не парализовал другой.
- Как обеспечить устойчивость потоковой передачи данных между доменами?
Используйте устойчивые очереди и конвейеры, которые поддерживают повторную доставку и детерминированную обработку. В рамках Data Mesh критично держать контракт целостности данных и эволюцию схем под контролем. Репликация между регионами и резервирование путей должны быть встроены в инфраструктуру, а не в бизнес‑логике конвейера.
- Какие инструменты предпочтительны для наблюдаемости в Data Mesh?
Рекомендуются открытые решения, которые хорошо интегрируются в децентрализованную среду: Kafka как платформа потоков и OpenTelemetry как стандарт телеметрии. Эти инструменты позволяют строить единое пространство наблюдаемости, где можно отслеживать данные на уровне домена и конвейера, а также синхронизировать контексты между различными частями системы.
- Какой подход к тестированию устойчивости эффективен в Data Mesh?
Эффективны регулярные тесты устойчивости и Chaos Engineering, которые моделируют временные сбои и деградации. В таком тестировании следует охватывать сценарии междоменных зависимостей: задержки в обмене сообщениями, падение одного домена, перегрузка инфраструктуры. Результаты тестирования должны приводить к улучшениям в контрактах, архитектуре конвейеров и планах восстановления.
- Нужно ли поддерживать строгую консистентность между доменами?
Не всегда. В Data Mesh выбор уровня консистентности зависит от критичности data product и требований потребителей. Для некоторых продуктов достаточна eventual consistency с предсказуемыми задержками, для других - требуется более строгая синхронизация. В любом случае контракт и план миграции схем должны учитываться заранее.
- Как управлять версионированием схем и контрактов?
Версионирование схем следует реализовать через реестр схем и политики совместимости, позволяющие доменам выпускать новые версии без нарушения потребителей. Автоматизированные проверки соответствия контрактам на этапе развёртывания помогают снизить риск несовместимости и регрессий.
- Какие ошибки чаще всего встречаются в реализации устойчивости Data Mesh?
Наиболее частые ошибки: недостаточное отделение доменных границ, избыточная централизация критических функций, игнорирование контрактной эволюции, отсутствие планов на случай сбоев, неполная корреляция контекстов между доменами. Эти проблемы приводят к каскадным сбоям, трудной диагностике и непредсказуемому поведению системы.
- Как внедрять устойчивость без потери скорости разработки?
Важно начинать с минимально необходимого набора паттернов: контрактная архитектура, базовая наблюдаемость по каждому data product, простые паттерны обработки сбоев и повторной обработки. По мере роста можно расширять набор паттернов, добавлять более сложные механизмы контроля и тестирования. Принципиально - внедрять постепенно, на отдельных data products с последующим масштабированием.
- Какие практики особенно полезны для международного или многорегионального Data Mesh?
Необходимо поддерживать мультирегиональные конвейеры, устойчивую репликацию и согласованные контракты между доменами в разных регионах. Вводится централизованный Observability Plane для мониторинга и управления изменениями. Автоматизированные тесты устойчивости в разных регионах помогают выявлять регрессионные проблемы и обеспечивают предсказуемость поведения системы.
- Как обеспечить безопасность и соответствие при обеспечении устойчивости?
В рамках устойчивости важно сохранять конфиденциальность и целостность данных. Контракты и схемы должны поддерживать требования к доступу и аудиту. Ведение журналов и трассировка должны не размещать конфиденциальную информацию в открытых местах, а поддерживать безопасные политики доступа и шифрование данных в пути и на хранении.
- Какие шаги следует предпринять при начале перехода к Data Mesh с точки зрения отказоустойчивости?
- Определить домены и data products с ясной ответственностью за данные и контрактами.
- Разработать базовый Observability Plane и определение SLO/SLI для каждого data product.
- Внедрить минимально необходимый набор паттернов устойчивости: circuit breaker, повторные попытки, дедупликацию.
- Организовать протокол корреляции между доменами и трассировку через конвейеры.
- Запустить Chaos Engineering планы и регулярные проверки устойчивости.
- Постепенно расширять набор инструментов и контрактов, ориентируясь на бизнес‑цели и требования стейкхолдеров.
Глава представлена в техническом ключе и ориентирована на архитекторов и инженеров, которые проектируют и эксплуатируют Data Mesh‑платформы с акцентом на устойчивость и наблюдаемость данных. В следующих главах будет рассмотрено углубление в конкретные кейсы реализации data products, сценарии внедрения self-service платформ и методики управления доменной ответственностью за данные в условиях динамических требований бизнеса.


