

Введение в CDC и Debezium: контекст и цели
CDC (Change Data Capture) стал ключевым подходом к построению современных пайплайнов данных: он позволяет отслеживать и распространять изменения из источников данных в режиме реального времени. Debezium выступает как один из наиболее зрелых open-source инструментов для реализации CDC, предоставляя готовые коннекторы к популярным системам управления базами данных и тесную интеграцию с экосистемой Kafka. Цель данной главы - вывести на поверхность фундаментальные концепции CDC, концепцию Debezium как платформы и объяснить, зачем и в каких условиях разумно строить потоковые пайплайны на основе CDC.
CDC позволяет перейти от пакетной обработки к непрерывной синхронизации данных между источниками и потребителями. Этот переход влечет за собой переосмысление архитектуры данных: с одной стороны возникают новые требования к согласованности и задержкам, с другой - открываются возможности для синхронной аналитики, кэширования в реальном времени и распределенной обработки событий. Debezium, в свою очередь, снимает большинство трудностей реализации CDC с плеч разработчика: он абстрагирует детали чтения журналов изменений, нормализации форматов событий и интеграции с Kafka, оставляя за командой лишь определение источников, политики отображения и дедупликации.
В рамках курса мы фокусируемся на трех взаимосвязанных горизонтах: архитектурной постановке CDC-пайплайнов, практиках интеграции с потоковыми системами (прежде всего с Apache Kafka и сопутствующими компонентами) и организационных аспектах внедрения. Важно подчеркнуть, что CDC - это не панацея: она требует дисциплины в вопросах согласованности изменений схем, управления транзакциями и мониторинга. Однако при грамотной настройке CDC-пайплайны обеспечивают отношение latency/Accuracy на уровне, недостижимом для традиционных ETL-подходов.
Далее мы выстроим концептуальную рамку, затем перейдем к архитектурным деталям Debezium и наконец - к ключевым практикам внедрения и стратегиям интеграции с Kafka и streaming-платформами.
- Что вы получите в рамках главы:
- понятие CDC и его архитектурные принципы;
- роль Debezium как движка CDC и набор коннекторов;
- принципы взаимодействия с Kafka, чёткие паттерны именования топиков и обработки схожих изменений;
- подходы к согласованности, версионированию схем и мониторингу;
- базовую карту внедрения: от постановки целей до первых конфигураций.
Что такое CDC и зачем Debezium
CDC можно рассматривать как механизм непрерывного извлечения изменений из исходной базы данных и их распространения в другие системы в виде событий. В основном различают два подхода: триггерный (логика фиксации изменений в приложении) иовый подход (log-based, основанный на журнале транзакций базы данных). Лог-based CDC - предпочтительный выбор в современных пайплайнах, поскольку он минимизирует нагрузку на транзакционные операции приложения, сохраняет порядок изменений и обеспечивает полноту истории транзакций. Ключевые характеристики CDC включают в себя:
- детерминированный порядок изменений, сохранение порядка операций в рамках транзакции и across транзакций;
- поддержка как отдельных операций (INSERT/UPDATE/DELETE), так и комплексных изменений, отражаемых через серии событий;
- возможность построения как потоков изменений в реальном времени, так и исторических снимков для инициализации целей;
- управление версиями схем и согласованностью версий потребителей.
Debezium как платформа для CDC предлагает набор коннекторов к различным СУБД (MySQL, PostgreSQL, Oracle, MongoDB, SQL Server и др.), единый механизм распространения изменений через Kafka и унифицированный подход к обработке envelope-сообщений. В контексте архитектурной постановки Debezium становится связующим звеном между источниками изменений и потоковой обработкой. Он захватывает журнал изменений на стороне базы данных, преобразует каждое изменение в единое событие, которое можно подписаться через Kafka, и обеспечивает схему и метаданные, необходимые downstream-потребителям.
Важно понимать, чем Debezium отличается от собственно реализации CDC внутри прикладного кода. Во-первых, Debezium снимает необходимость повторной реализации чтения журналов изменений для каждого источника данных. Во-вторых, он централизует аспекты соответствия и мониторинга: настройки коннекторов, обработка ошибок, сохранение истории схем и управление версиями. В-третьих, Debezium усиливает совместную работу между командами данных и разработчиками инфраструктуры за счет единообразной модели событий и унифицированной интеграции с Kafka.
Применение CDC через Debezium открывает доступ к ряду сценариев:
- синхронизация оперативных систем в реальном времени: аналитика в режиме ближе к реальному времени, поддержка панели мониторинга, обновления в кэшах;
- «истории изменений» для аудита и регламентированной аналитики;
- кросс-системное реплицирование: глобальная консолидация изменений между регионами, синхронизация реестров и справочников;
- поддержка паттернов архитектуры «data lake» и «data mesh» через единый поток изменений, который может быть потреблен различными аналитическими и обработчиками данных.
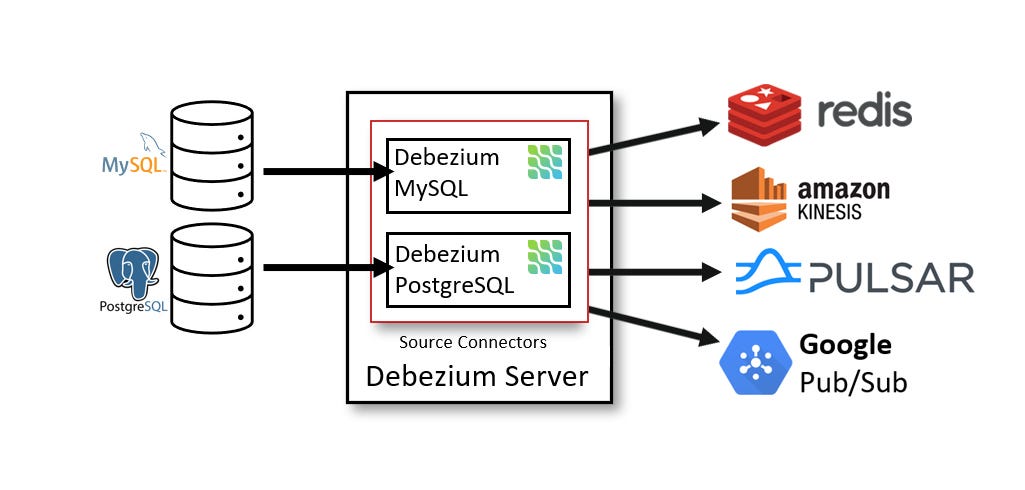
Архитектура Debezium и данные Envelope
Debezium реализует CDC через концепцию коннекторов, которые работают поверх движка (а в некоторых случаях внутри приложения) и публикуют события в Kafka. Каждый коннектор подключается к конкретной СУБД и опрашивает/читается журнал изменений, преобразуя каждое изменение в «событие» с унифицированным envelope-форматом. Это позволяет downstream-системам работать с согласованной структурой и семантикой.
Ключевые элементы архитектуры Debezium:
- коннекторы: готовые реализации для разных источников баз данных, каждый из которых инкапсулирует логику чтения журнала изменений и конвертации в единый формат событий;
- движок CDC: внутри коннектора реализуются паттерны минимизации задержек, параллелизма и коррекции ошибок чтения журнала;
- топология доставки: Debezium публикует события в Kafka (или через Kafka Connect) в виде топиков, организованных по именованию, обычно в формате {server}.{database}.{table};
- envelope-сообщения: стандартный формат событий Debezium содержит такие поля как op (operation: c/latest), before и after (состояния до и после изменений), ts_ms (таймштамп события), source (модель метаданных о месте происхождения) и др.;
- история схем: Debezium хранит историю изменений схем и DDL-операций в специальной топике, обычно называемом database.history.kafka.topic или через конфигурацию storage.history;
- конфигурационная и безопасность инфраструктуры: роли доступа, шифрование, политики ретрансляции и мониторинг.
Схема обмена сообщениями на практике обычно выглядит так: источники изменений (журнал транзакций) → Debezium Connector → Kafka (в виде топиков) → downstream-потребители (Apache Flink, Spark Structured Streaming, снипперы приложений) или Data Lake/PaaS-решения. Такой конвейер позволяет снизить задержку, сохранить линейную трассируемость изменений и централизовать обработку ошибок.
Важной частью является формат сообщений. Envelopes Debezium традиционно оформляются как JSON-объекты (или Avro/Protobuf через Schema Registry). В каждом событии присутствуют следующие ключевые поля:
- op: тип операции (c - create/insert, u - update, d - delete, r - read);
- before: состояние строки до изменения (для insert может быть пустым);
- after: состояние строки после изменения;
- source: набор полей, указывающих на источник изменений (таблица, база, файловая позиция, время и пр.);
- ts_ms: временная метка изменения.
Поддержка схемы и эволюции - необходимая часть архитектуры. Изменения в колонках требуют отражения в downstream-потребителях. Debezium способен публиковать события schema changes, если включены соответствующие опции (например, include.schema.changes). В случаях работы с несколькими коннекторами и регионами критична единая стратегия именования топиков и согласованность версий схем.
{
  "name": "inventory-connector",
  "config": {
    "connector.class": "io.debezium.connector.mysql.MySqlConnector",
    "tasks.max": "1",
    "databaseHostname": "db.example",
    "databasePort": "3306",
    "databaseUser": "debezium",
    "databasePassword": "dbz",
    "databaseWhitelist": "inventory",
    "table.whitelist": "inventory.products,inventory.orders",
    "include.schema.changes": "true",
    "database.history.kafka.bootstrap.servers": "kafka:9092",
    "database.history.kafka.topic": "dbhistory.inventory"
  }
}
Это упрощенный пример конфигурации Debezium-коннектора для MySQL. В реальной экспозиции он дополняется настройками безопасности (TLS, Kerberos/ SASL), параметрами параллелизма, политиками обработки ошибок и деталями интеграции с вашей инфраструктурой мониторинга.
Интеграция с Kafka и дизайн потоков
Одной из сильных сторон Debezium является тесная интеграция с Apache Kafka. Она позволяет построить масштабируемые, отказоустойчивые пайплайны поверх потоковой обработки. В контексте Debezium важны следующие принципы и практики:
- именование топиков: по умолчанию топики следуют образцу {dbz_server}.{database}.{table}. Это обеспечивает прозрачную трассируемость источника и упрощает маршрутизацию изменений на downstream-потребителей;
- выбор формата сообщений: JSON предпочтителен для простоты, но для больших объемов и требований к схемам часто применяется Avro через Schema Registry. Это обеспечивает явное управление схемами и совместимость версий;
- управление схемой: Debezium хранит историю схем в dedicated topic. В продакшн-среде целесообразна интеграция с Schema Registry для централизации версионирования и совместимости;
- транзакционная семантика: Kafka поддерживает транзакционные записи, что делает возможным атомарное размещение изменений из нескольких коннекторов в один поток. Это полезно при моделировании сложных бизнес-операций, где несколько таблиц должны отражаться как единое изменение;
- обработка задержек и повторной обработки: задержки сети и деплоймента могут повлиять на consumption. В реальных пайплайнах применяют схемы ретрансляции, idempotent-потребителей и повторно воспроизводимую обработку;
При выборе архитектуры важно учитывать тип потребителей: аналитика в реальном времени (Flink, Spark), загрузка в Data Lake, оркериация бизнес-процессов. В зависимости от целевой архитектуры выбираются оптимизации по задержкам, размеру батчей и стратегиям перераспределения нагрузки между коннекторами.
- Архитектура в реальном времени требует продуманной схемы обработки ошибок: повторная обработка, дедупликация и правильная обработка повторных событий. Для аудита и контроля можно применить отдельные вспомогательные топики, где сохраняются копии исходных событий и статусы их обработки.
- Для обеспечения согласованности между источниками данных и потребителями применяются транзакционные границы и механизмы компенсирующих действий (например, схему компенсирующих операций на уровне бизнес-логики downstream-потребителя).
Управление изменениями схемы и согласованность
Изменения схемы в исходных базах данных - обычное дело. Debezium поддерживает отражение таких изменений через свои механизмы и топики истории. Важно выстроить политику, которая минимизирует риск несовместимости в downstream-потребителях:
- включение включение изменений схемы: опция include.schema.changes позволяет публиковать уведомления о DDL-операциях. Это необходимо для того, чтобы downstream-системы могли адаптировать свой парсинг и десериализацию;
- хранение истории схем: база истории (database.history.kafka.topic) должна быть доступна и устойчиво реплицироваться. В продакшне стоит рассмотреть репликацию истории и обеспечение её долговременной сохранности;
- версияция схем: рекомендуется использовать Schema Registry и Avro-схемы. Это упрощает эволюцию таблиц и обеспечивает совместимость старых и новых потребителей;
- обработка изменений таблиц: при добавлении столбцов не всегда требуется изменение downstream-логики, но лучше планировать адаптацию на этапах разработки, тестирования и выпуска новой версии пайплайна;
- стратегия отказоустойчивости: настройка ретраев, временных задержек и ограничение числа повторов обеспечивают устойчивость даже при нестабильном окружении.
В рамках архитектурной практики следует заранее определить пороги ошибок и процедуры реагирования на них: автоматическое отключение коннектора и уведомления для команды SRE, изоляционные топики для ошибок и процессы повторного анализа изменений. Такой подход обеспечивает предсказуемость поведения системы и уменьшает риск потери изменений.
Практические шаги внедрения и паттерны
Внедрение Debezium в реальную экосистему требует последовательности шагов и обоснованного выбора компонентов. Ниже приведены общие принципы и типовые паттерны:
- начальная карта источников: определить критичные для бизнеса таблицы и базы, которые должны попасть в CDC-пайплайн в первую очередь. Это позволяет минимизировать риск и оценить требования к задержке;
- выбор режима снятия изменений: Debezium поддерживает snapshot и streaming режимы. Для старта полезно запустить начальный снимок, чтобы потребители имели полный контекст, затем включить поток изменений;
- проектирование схемопреобразований: определить соответствие между структурами исходных таблиц и темами Kafka. Уточнить необходимость объединения полей, преобразования типов и обогащения событий;
- безопасность и доступ: реализовать аудит доступа к конфигурациям коннекторов и топикам, настроить шифрование транспортного уровня, а также обеспечить безопасный доступ к Schema Registry;
- мониторинг и операционная устойчивость: настроить сбор метрик, журналирование ошибок, алертинг по задержкам и пропаданию коннекторов. Важна четкая процедура восстановления после сбоев и регламент обновления коннекторов;
- тестирование и постепенный выпуск: начать с одного источника, проверить нагрузку и согласованность, затем постепенно расширять спектр источников. Важна возможность повторной и безопасной деактивации коннекторов без потери данных.
Типовые сценарии внедрения включают:
- реальное временное обновление каталогов и справочников: синхронизация изменений между базой данных и данными слоем аналитики;
- кросс-региональная репликация и консолидация: перенос изменений в отдельные кластеры Kafka другого региона для локализации задержек;
- поддержка аудита и регуляторной отчетности: фиксирование событий изменений с их всеми контекстами для последующего анализа.
Ключевую роль в паттернах играет Outbox-подход: изменение бизнес-состояний записывается в отдельной Outbox-таблице в рамках той же транзакции, что и изменение бизнес-данных. Debezium может затем считывать эти изменения и публиковать их как событие в потоке. Такой подход обеспечивает атомарность и снижает риск расхождения между бизнес-логикой и данными.
Key takeaways
- Change Data Capture позволяет отслеживать изменения в источниках данных и распространять их в режиме реального времени через унифицированный envelope-сообщения.
- Debezium выступает как платформа CDC с набором коннекторов, интеграцией с Kafka и единообразной моделью событий для downstream-потребителей.
- Архитектура Debezium упрощает внедрение CDC: читается журнал изменений, формируются события, публикуются в Kafka и затем обрабатываются потребителями.
- Управление схемами и их эволюцией является критически важной частью проекта: хранение истории схем, использование Schema Registry, поддержка DDL-изменений в потоках.
- Надежность и мониторинг - неотъемлемые части инфраструктуры CDC: транзакционные возможности Kafka, повторная обработка, дедупликация и детальная телеметрия.
- Внедрение следует рассматривать как серию шагов: определить источники, запустить snapshot, затем включить поток изменений и обеспечить необходимый уровень мониторинга и безопасности.
- Паттерны повышения устойчивости включают Outbox-архитектуру, единый процесс развёртывания коннекторов и корректную миграцию схем.
FAQ
- Что такое Debezium и зачем он нужен в CDC-пайплайнах?
Debezium - это набор коннекторов и инфраструктуры, которые читают журналы изменений баз данных и публикуют их в Kafka в виде единообразных событий. Он снимает соразмерную часть сложности реализации CDC, обеспечивает согласованность между источниками и потребителями и упрощает создание потоков данных в реальном времени.
- Какие базы данных поддерживаются Debezium?
Среди наиболее востребованных поддерживаются MySQL, PostgreSQL, MongoDB, SQL Server и Oracle, а также ряд менее распространённых СУБД. Поддержка конкретной СУБД зависит от существующих коннекторов и версии Debezium.
- Как организованы события Debezium и что в них содержится?
События Debezium обычно оформляются как envelope-сообщения с полями op, before, after, source и ts_ms. Это обеспечивает прозрачную реконструкцию изменений и позволяет downstream-потребителям сохранять контекст операции.
- Нужно ли использовать Schema Registry?
Использование Schema Registry упрощает управление схемами и версионирование. Это особенно полезно в сценариях, где используются Avro-сообщения и требуется строгая совместимость между версионированными сервисами.
- Как обеспечить устойчивость к сбоям в CDC-пайплайне?
Рассматривайте и включайте такие практики, как транзакционная доставка через Kafka, повторная обработка потребителя, дедупликация и мониторинг. Важно иметь процессы восстановления после сбоев и возможность безопасной остановки/перезапуска коннекторов.
- Какие паттерны управления изменениями схем стоит учитывать?
Необходимо настроить хранение истории схем, обработку DDL-событий и план миграций схем через схемное хранилище. В идеале - унифицировать эволюцию схем через Schema Registry и заранее тестировать изменения в интерактивной среде.
- Какие риски связаны с использованием CDC и как их минимизировать?
Основные риски - задержки, несовместности схем, дублирование событий и сложность мониторинга. Их минимизируют через правильную конфигурацию задержек, стратегии обработки изменений схем, продуманное тестирование и комплексный мониторинг.
- Как начать пилотный проект по Debezium?
Начните с одного критического источника данных, запустите snapshot, настройте топики и потребителей, включите ограниченное тестирование и постепенно расширяйте спектр источников. В конце этапа пилота оцените задержку, точность и влияние на производительность.
- Как Debezium взаимодействует с потоковой обработкой (Flink, Spark)?
Debezium публикует события в Kafka, где их потребляют_STREAM-обработчики, например Flink или Spark Structured Streaming. Это обеспечивает возможность реального времени аналитики, фильтрации, агрегации и обогащения данных.
- Какие предпочтения по формату данных в Kafka?
JSON прост и прозрачен, но Avro с Schema Registry обеспечивает лучший контроль версий, экономию пропускной способности и меньшую вероятность ошибок десериализации в крупных пайплайнах.
Глава завершается обзором основ, которые помогут проектной команде выстроить прочную архитектуру CDC-пайплайна на основе Debezium и интеграцию с Kafka и сопутствующими системами. В следующих главах мы подробно разберем конкретные коннекторы Debezium, примеры конфигураций, паттерны обработки событий и практические кейсы внедрения в корпоративной среде.


