

Индексация и другие механизмы ускорения запросов в Greenplum
Greenplum - распределенная система аналитического назначения, где эффективность запросов тесно связана не только с концепцией индексов, но и с правильной стратегией хранения данных, распределения нагрузки и использования дополнительных механизмов ускорения. В данной главе фокус смещается на архитектуру индексации в условиях MPP, сопутствующие подходы к уменьшению объема переносимых данных и на практические способы реализации ускорения запросов в реальных ETL и витринах данных.
Индексация в Greenplum - это один из инструментов ускорения, который работает в условиях распределенной архитектуры. Однако следует помнить, что глобального индекса на уровне всей базы данных нет, и эффективность индексов зависит от того, как данные распределены по сегментам, как формируются планы выполнения запросов и как реализованы другие механизмы ускорения: партиционирование, хранение AO/CO, материализованные представления и статистика. Правильное сочетание этих элементов позволяет минимизировать межсетевые переносы, снизить I/O и ускорить частые аналитические сценарии.
- В рамках данной главы мы рассмотрим архитектурные принципы работы индексов в Greenplum, типы индексов с учетом ограничений MPP, практические правила применения и согласованные подходы к сочетанию индексов с партиционированием и распределением.
- Далее перейдем к более насыщенным механизмам ускорения запроса: AO/CO хранение, zone maps, материализованные представления, прогнозирование и настройка параметров планировщика.
- В заключение будут рекомендации и практические кейсы по внедрению и мониторингу.
Краткое содержание главы
- Архитектура индексации в Greenplum: локальные индексы на сегментах, влияние распределения данных и планировщика.
- Типы индексов, их применимость и ограничения в контексте MPP.
- Партиционирование, распределение и предикатное исключение как альтернативы и дополнение к индексам.
- AO/CO хранение, сжатие и zone maps как ускорители сканирования.
- Практические рекомендации по внедрению, мониторингу и выбору стратегий ускорения.
- Кейсы и методика оценки эффективности изменений.
Архитектура индексации в Greenplum
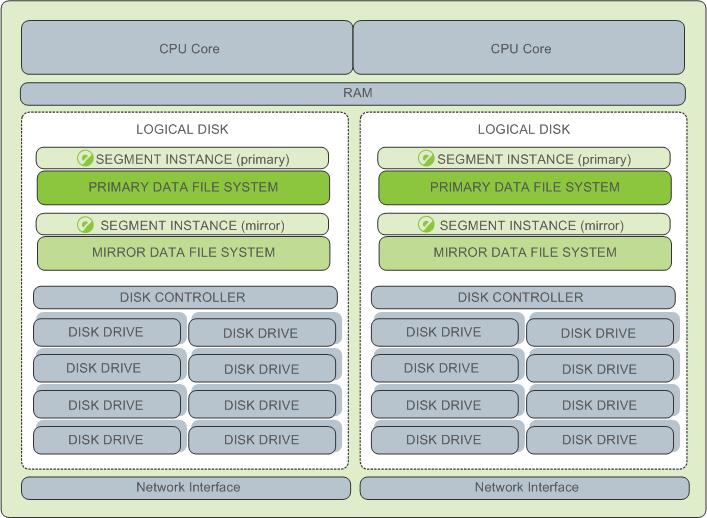
Greenplum реализует архитектуру, при которой данные физически размещаются на сегментах, и любой индекс обслуживает только локальные данные конкретного сегмента. Этим обеспечиваются параллельность и масштабируемость, но и создаются ограничения: отсутствует глобальный индекс, а эффективная оптимизация запросов во многом зависит от распределения данных и способности планировщика push-предикатов к сегментам.
Ключевые принципы:
- Индекс - это локальная структура, создаваемая на уровне сегментов. При выполнении запроса планировщик решает, где и какие индексные сканирования использовать, но не может «перелопачивать» весь набор сегментов одним глобальным индексом.
- Предикатное пропускание и фильтрация на уровне сегментов позволяют исключить неинтересные данные на ранних этапах выполнения, минимизируя циркуляцию между сегментами.
- Эффективность индексов в GP возрастает, когда фильтры в запросах соотносятся с данными, локально хранимыми в конкретном сегменте, и когда данные хорошо распределены вокруг ключевых столбцов.
С точки зрения проектирования важно определить, какие запросы являются узкими местами, и где индексы принесут наибольшую выгоду. Часто основным фактором ускорения становится не столько создание большого набора индексов, сколько правильная организация хранения и распределения данных под рабочую нагрузку.
-- Пример концептуального использования локального индекса на сегменте (схематично)
CREATE TABLE sales (
  id BIGINT,
  region_id INT,
  sale_date DATE,
  amount NUMERIC(12,2)
) DISTRIBUTED BY (region_id);

-- Создание индекса на уровне сегментов (локальный индекс)
CREATE INDEX idx_sales_region ON sales(region_id);
Как только базовые принципы понятны, становится ясно, что важнее чем множество разных индексов - грамотная архитектура распределения и возможность планировщика эффективно использовать локальные индексы в рамках выполнения сложных аналитических запросов.
Типы индексов, их применимость и ограничения
Greenplum поддерживает стандартные механизмы индексации, принятые в PostgreSQL, но применение в рамках MPP имеет особенности. В большинстве сценариев практикуют использование B-Tree индексов как основного типа, применимого к столбцам с равномерной дискретной или диапазонной выборкой. Однако стоит помнить об ограничениях:
- Индексная структура локальна. Эффективность зависит от того, насколько запросы «помещаются» в сегменты и как данные распределены по ключам.
- Не существует глобального индекса на уровне всей базы. При больших сэмплах и сложных фильтрах вероятность того, что часть сегментов будет задействована без фильтра на ключ распределения, выше.
- Другие типы индексов (GiST, GIN) применимы, но их эффективность в GP связана с конкретной нагрузкой и функциональностью, которую поддерживает текущая версия. Их применение требует внимательного тестирования и мониторинга.
- В условиях больших обновлений и частого DML обновления сохранение индексной структуры может обременять систему. Вопрос о рентабельности обновления индексов следует рассматривать совместно с задачами по загрузке, обновлению витрин и поддержанию статистики.
При проектировании индексов полезно учитывать совместимость индекса с распределением и партиционированием. Например, если запросы чаще фильтруют по region_id, размещение по region_id может уменьшать необходимость перемещать данные между сегментами и усиливать возможность быстрого поиска через локальные индексы.
-- Пример создания индекса на столбец, который часто используется в фильтрах
CREATE INDEX idx_sales_region ON sales(region_id);
Для сложных сценариев запросов можно рассмотреть комбинированное использование индексов и партиционирования, где каждый диапазон или подмножество данных имеет свой локальный индекс, что в сумме снижает стоимость сканирования и фильтрации.
Партиционирование, распределение и предикатное исключение
Эффективность запросов в Greenplum сильно зависит от того, как данные распределены между сегментами и как реализовано партиционирование. Правильная модель распределения и проектирование партиций позволяют планировщику выполнить части запроса на отдельных сегментах, сводя к минимуму межсегментные переносы.
- Распределение данных по ключу (DISTRIBUTED BY) должно соответствовать характеру фильтров в наиболее частых запросах. Если почти все выборки по конкретному региону происходят с одного сегмента, вероятность того, что выполняется локальный скан и локальный индекс, возрастает.
- Партиционирование по диапазону дат или по списку значений улучшает возможность применения partition pruning. При выполнении запроса с фильтром по диапазону дат, планировщик может исключить целые разделы, что существенно снижает объем сканируемых данных.
- Предикатное исключение (constraint exclusion) усиливает prune-эффект за счет распознавания связей между фильтрами и разделами. Это особенно важно, если у таблиц много разделов и запросы касаются узкого временного окна или конкретного набора категорий.
-- Пример таблицы с партиционированием по дате продаж
CREATE TABLE sales (
  id BIGINT,
  region_id INT,
  sale_date DATE,
  amount NUMERIC(12,2)
) PARTITION BY RANGE (sale_date);

-- Создание партиций
CREATE TABLE sales_2024_q1 PARTITION OF sales
  FOR VALUES FROM ('2024-01-01') TO ('2024-04-01');
При проектировании следует учитывать баланс между количеством разделов и накладными расходами на их обслуживание. Чрезмерно мелкие разделы приводят к большему количеству мелких операций и дополнительных вызовов планировщика, тогда как слишком крупные разделы уменьшают возможности prune и приводят к большему объему сканирования. В идеальном случае достигается компромисс, который минимизирует объём переноса данных и максимизирует использование локальных индексов.
AO/CO хранение, zone maps и другие ускорители сканирования
Greenplum поддерживает различные форматы хранения данных, включая Append-Only (AO) и AO с колоночной ориентацией (AOCO). Эти форматы существенно влияют на производительность аналитических запросов за счет снижения объема IO и улучшения сжатия. В AO/CO хранении данные записываются колонно-ориентированно, что позволяет планировщику пропускать целые участки столбцов, если они не содержат релевантные значения для заданного диапазона.
- AOCO существенно ускоряет сканы больших таблиц, особенно в случае агрегатов и аналитических функций, где наборы данных обрабатываются в рамках больших последовательностей столбцов.
- Zone maps усиливают pruning на этапе чтения: если статистика по блокам показывает, что в них отпадают значимые значения, можно пропустить чтение соответствующих блоков.
- Комбинация AOCO с правильной схемой распределения и партиционированием приводит к заметному снижению IO и ускорению ответов на аналитические запросы.
Важно отметить, что переход на AO/CO хранение может повлечь за собой изменения в плане обновления статистики и в обходных путях обновления витрин, поэтому миграционные решения требуют внимания к совместимости сериализации и форматов хранения.
-- Пример создания таблицы в AOCO формате (упрощенно)
CREATE TABLE events (
  event_id BIGINT,
  event_ts TIMESTAMP,
  user_id BIGINT,
  details TEXT
) WITH (appendonly = true, orientation = 'column');
Материализованные представления являются эффективным инструментом для ускорения повторяющихся аналитических запросов, особенно тех, где сложные агрегаты и соединения повторяются в рабочих процессах ETL и витринах. Их особенность состоит в том, что результат вычислений сохраняется отдельно и может обновляться по расписанию или в рамках инкрементной загрузки. В Greenplum они помогают закрывать «горячие» пути доступа к данным без повторного вычисления в рамках каждого запроса.
- При использовании материализованных представлений следует определить стратегию обновления: непрерывное обновление после входящих загрузок или периодический экспорт обновления. Выбор зависит от требований к свежести данных и нагрузки на систему.
- В качестве дополнения к MV стоит рассмотреть создание дополнительных агрегационных уровней, чтобы ускорить частые запросы на ключевых витринах.
-- Пример создания материализованного представления
## CREATE MATERIALIZED VIEW mv_sales_by_region AS
SELECT region_id, SUM(amount) AS total_amount
FROM sales
GROUP BY region_id
WITH (compose = true);
Кроме того, эффективное планирование запросов в Greenplum зависит от точности статистики. Регулярный анализ таблиц (ANALYZE) и поддержание статистики в актуальном состоянии помогают планировщику выбирать наиболее эффективную стратегию доступа к данным - индексированное сканирование, сканирование без индексов, объединение по определенным ключам и т. д.
Практические рекомендации по внедрению и мониторингу
-
Начинайте с анализа рабочих нагрузок. Соберите профили частых запросов и определите узкие места: где происходят наиболее дорогие сканирования, какие фильтры применяются и какие столбцы чаще участвуют в условиях поиска.
-
Определите ключи распределения, соответствующие реальному поведению запросов. Если фильтры по определенным столбцам часто исключают большую часть данных, распределение по этим столбцам может снизить межсегментные передачи.
-
Рассмотрите партиционирование по времени или по критически важным группировкам, чтобы повысить эффект prune и избежать перерасхода CPU на обработку больших объемов ненужных данных.
-
Впаритесь с AO/CO хранением для больших витрин. Оцените экономию IO и влияние на задержку обновления витрин. В качестве пилотного проекта можно выбрать одну крупную витрину и проверить прирост производительности.
-
Применяйте материализованные представления для стабильных агрегаций и предикатных сценариев. Определите сроки обновления MV в зависимости от требований к актуальности данных.
-
Контролируйте статистику. Регулярно выполняйте ANALYZE во всех крупных таблицах и поддерживайте корректность статистик для планировщика.
-
Используйте EXPLAIN ANALYZE для оценки изменений. Прогоняйте тестовые наборы запросов до и после введения индексов, партиционирования и MV, сравнивая планы выполнения и фактические времена отклика.
-
Мониторинг и регламент изменений. Введите регламент на тестирование изменений в стенде, проверку их влияния на производительность и регрессию в целом.
-- Пример анализа плана выполнения
EXPLAIN ANALYZE
SELECT region_id, SUM(amount)
## FROM sales
WHERE sale_date >= '2024-01-01' AND sale_date
Кейсы и методика реализации
-
Кейс 1: ускорение витрины по региональным агрегациям. Разрабатываем партиционирование по месяцу, создаем локальные индексы на столбцах region_id и date, применяем AOCO хранение для витрины. Мониторим эффект на задержку и пропускную способность.
-
Кейс 2: ускорение большого фактового набора. Разбираемся в распределении по ключу, применяем MV для дорогих агрегаций и добавляем партиции по временным промежуткам. Руководствуемся принципами prune и локального сканирования.
-
Кейс 3: обновление витрин в реальном времени. Включаем инкрементные MV и минимизируем обновления полных сканов за счет ограничения обновления только изменившихся сегментов.
Key takeaways
- В Greenplum индексация - локальная задача: каждый индекс обслуживает данные конкретного сегмента, без глобального индекса.
- Эффективность индексов тесно связана с распределением данных и партиционированием; грамотное распределение и prune могут превзойти пользу множества индексов.
- AO/CO хранение и zone maps существенно ускоряют сканы аналитических нагрузок за счет снижения IO и применения сжатия.
- Материализованные представления и регулярная актуализация статистики помогают ускорить повторяющиеся аналитические сценарии.
- Внедрение индексов должно сопровождаться измерениями и тестированием: EXPLAIN ANALYZE, тестовые наборы и регламенты обновления витрин.
- Мониторинг влияния изменений на план выполнения и латентность запросов - обязательная часть цикла оптимизации.
- Взаимодействие механизмов: правильное распределение + партиционирование + локальные индексы + AO/CO хранение + MV образуют синергию, позволяющую достигать значительного срока отклика в больших аналитических нагрузках.
FAQ
- Какие индексы поддерживает Greenplum и как они работают в условиях распределенной базы?
- Greenplum поддерживает стандартные индексы PostgreSQL, в основном B-tree. В условиях MPP индексы реализованы как локальные структуры на сегментах. Эффективность индексного ускорения зависит от соответствия фильтров запросов распределению данных и от способности планировщика использовать локальные индексы в рамках разделов. Глобальных индексов нет, поэтому выигрыш от индексов - в снижении сканирования данных именно на сегментах, а не во всей базе.
- Что эффективнее - индексы или партиционирование?**
- Это зависит от рабочей нагрузки. Индексы полезны на узких ключевых столбцах внутри сегментов, но при больших диапазонах фильтров партиционирование обеспечивает prune целых подразделов и существенное снижение объема данных. Часто на практике оба механизма применяются вместе: распределение для минимизации shuffled данных, партиционирование для prune, индексы - для ускорения локального доступа.
- Какие ограничения накладывают индексы в GP?
- Индексная структура локальна, глобального индекса нет. Данные должны быть разумно распределены по сегментам, чтобы индексы приносили пользу. Обновления и удаления могут приводить к фрагментации и цене поддержания индексов, поэтому целесообразно тестировать влияние на DML-операции и общую производительность.
- Как AO/CO хранение влияет на производительность?
- AO/CO хранение оптимизировано для аналитических нагрузок: колоночное представление позволяет эффективнее сжимать и сканировать данные, zone maps помогают пропускать блочные участки, что значительно уменьшает IO. Это особенно полезно для больших витрин и частых сканов столбцов.
- Когда стоит использовать материализованные представления?
- MV - для случаев, когда повторяющиеся запросы требуют одни и те же вычисления (агрегации, сводные таблицы). MV устраняет повторные вычисления и обеспечивает ускорение чтения витрин. Необходима стратегия обновления MV: периодическая, по расписанию, или инкрементная (если поддерживается версией и инфраструктурой).
- Как проверить эффект применения индексов и партиционирования?
- Используйте EXPLAIN ANALYZE для оценки плана выполнения и времени выполнения до и после изменений. Сопоставляйте метрики: время выполнения, объем считанных страниц, количество переданных данных между сегментами.
- Что учитывать при проектировании распределения данных?
- Выбирайте распределение по столбцу, который чаще всего участвует в фильтрах или join-условиях и минимизирует межсегментные перенаправления. Регулярно проверяйте баланс загрузки между сегментами и избегайте крупных несбалансированных сегментов, которые могут стать узкими местами.
- Как совместить индексы и материализованные представления?
- Индексы полезны на операциях доступа к деталям внутри сегментов, MV ускоряют повторяющиеся агрегации, а AO/CO хранение ускоряет сканы больших витрин. Правильная архитектура - сочетать локальные индексы там, где они действительно уменьшают объём сканирования, MV - для агрегаций и повторяющихся запросов, и AO/CO - для объема сканов и сжатия.
- Какие риски связаны с частой переиндексацией и обновлениями витрин?
- Частые изменения индексов и MV приводят к накладным расходам на поддержание структур и обновление MV. Необходимо тщательно планировать расписания обновления витрин, чтобы не перегружать систему в пиковые периоды.
- Какие инструменты мониторинга рекомендуются?
- Встроенные средства анализа выполнения запросов, EXPLAIN ANALYZE, сбор метрик по времени выполнения, объемам IO и распределению данных по сегментам. Регулярная регрессия и тестирование на стенде перед переносом изменений в продуктивную среду - обязательны.


