

HTAP: концепции, архитектуры и практика гибридной транзакционно-аналитической обработки
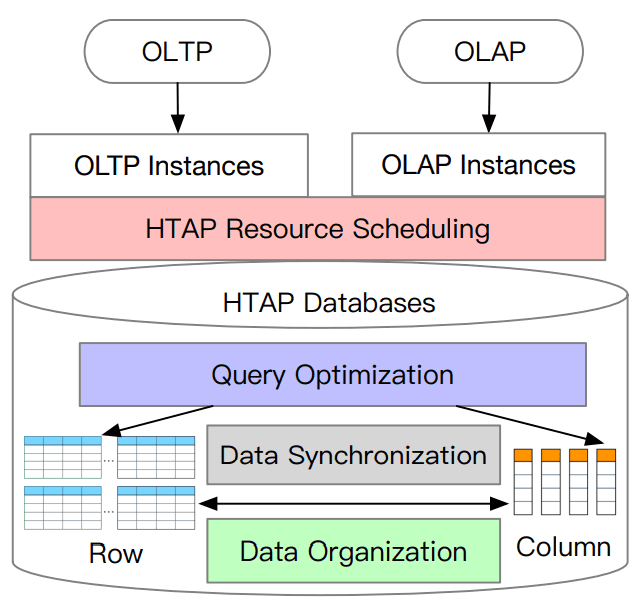
Что такое HTAP: определение и цели гибридной транзакционно-аналитической обработки
HTAP (Hybrid Transactional and Analytical Processing) представляет собой подход, направленный на одновременную и взаимно совместимую реализацию транзакционных и аналитических нагрузок в рамках единого архитектурного пространства. Ключевая идея состоит в том, чтобы избавиться от принудительного разделения операций на два отдельных контура: операционное хранение данных (OLTP) и аналитика (OLAP). В реальной практике HTAP стремится минимизировать задержки между поступлением изменений в данные и их последующим анализом, устранить избыточные копирования данных и синхронизационные конвейеры, которые формируют ETL (Extract, Transform, Load) или ELT (Extract, Load, Transform).
Основные цели HTAP можно сформулировать так:
- обеспечить оперативную актуализацию аналитических результатов на данных, изменяющихся в реальном времени;
- снизить суммарную стоимость владения данными за счет унификации архитектуры и сокращения дубликатов;
- сохранить возможности строгих транзакционных гарантий наряду с мощной аналитикой;
- снизить задержку (latency) между операциями изменения данных и их анализа, включая нагрузочные пики и непрерывный поток изменений;
- упростить операционные процессы за счет единого набора технологий, унифицированного формата хранения и общей модели управления данными.
С точки зрения терминологии стоит различатьOLTP и OLAP как исторически сформированные парадигмы. OLTP-«операционные» системы оптимизированы под быстрые вставки, обновления и удаления с акцентом на целостность и согласованность транзакций. OLAP же ориентирован на массовую аналитику, многомерные запросы и предиктивную обработку больших объемов данных. HTAP ставит своей целью внедрить мост между этими мирами без полной инфраструктурной перегрузки и без обхода преимуществ каждой парадигмы. В современных реалиях HTAP часто рассматривается как развитие концепций «одного хранилища» или «хранилища с унифицированной таблицей» посредством применения многоверсной MVCC-логики, гибридной индексации, смешанных форматов хранения и тесной интеграции вычислительных движков потоковой и пакетной обработки.
Чтобы понять практическое значение HTAP, полезно помнить, что эффективная транзакционная обработка не должна идти в ущерб аналитике, и наоборот. В традиционных системах рекомендуется отделять слои, чтобы каждая часть обработки могла быть оптимизирована под свои цели. HTAP-навык становится особенно ощутимым, когда бизнес-сценарии требуют моментальной реакции на изменения - например, в банковском секторе при обнаружении мошеннических операций, в ритейле при обновлении запасов в реальном времени или в телеком-намощи для мониторинга качества сервиса. Это требует не только технологической перестройки, но и новой концептуальной базы: как хранить данные, как поддерживать консистентность и как запускать аналитические запросы так, чтобы они не блокировали транзакции и не попирали целостность.
Важно помнить: HTAP - это не только «объединение OLTP и OLAP» в одну систему, но и управление конфликтами доступа к данным, выбор подходящих стратегий хранения, обеспечение согласованности и согласованной аналитики на фоне реального времени. В этом контексте MVCC (многоверсионный контроль параллелизма) чаще всего служит основой для реализации сильной консистентности в условиях одновременного выполнения транзакционных и аналитических запросов. Но MVCC - лишь один из элементов архитектуры: он дополняется журналированием, репликацией, ограничениями, синхронной или асинхронной обработкой изменений, а также интеграцией вычислительных движков и унифицированных форматов хранения.
Декомпозиция технических компонентов HTAP: транзакционное хранение, аналитический слой и контролируемая синхронизация
В рамках HTAP принято выделять три базовых компонента, которые взаимодействуют между собой, но могут развиваться независимо в рамках единого архитектурного контура:
-
транзакционное хранение. Это базовый слой, который поддерживает транзакции чтения и записи, обеспечивает целостность данных и гарантирует свойства согласованности на уровне отдельных строк и связанных структур (ключи, внешние ключи, ограничения). В HTAP-системах трансляция изменений в аналитический контур должна происходить без потери транзакционных свойств. Важной характеристикой является поддержка MVCC или аналогичной схемы, обеспечивающей чтение консистентной версии данных на момент запроса, даже если вне Polyns меняются данные. При этом может применяться как строковая организация хранения (для эффективной мутации) так и смешанные режимы, где часть данных держится в колоночной форме для аналитики и агрегаций.
-
аналитический слой. Этот компонент предназначен для выполнения сложных запросов, агрегаций, многомерной аналитики и моделирования на больших объемах данных. Он может включать собственный движок аналитических вычислений или опираться на внешние движки потоковой и пакетной обработки (Spark, Flink) для распределенной аналитики. В HTAP-построении аналитический слой должен быть тесно связан с данными в транзакционном хранилище: запросы должны проходить с минимальными задержками, а данные - быть синхронно или полусинхронно доступны в аналитическом контексте. Важна способность поддержки обновлять аналитические представления без необходимости пол congelation of data, а также способность к быстрой адаптации под новые аналитические модели.
-
контролируемая синхронизация. Это механизм, который обеспечивает согласованность между двумя парадигмами обработки. Он включает журналирование изменений (часто WAL/redo log, Change Data Capture), репликацию и консистентную аналитику. В HTAP этот элемент становится критическим, так как он обеспечивает для аналитики видимость именно той версии данных, которая актуальна на момент запроса без нарушений транзакционного порядка. Различают синхронную репликацию, гарантирующую мгновенную консистентность, и асинхронную, позволяющую повысить пропускную способность, но требующую дополнительных механизмов для устранения расхождений. В контексте HTAP важны также такие аспекты, как задержка между записью в транзакционный журнал и её отражением в аналитическом хранилище, и возможность поддержки потоковой передачи изменений в реальном времени.
Чтобы структурировать рассмотрение, полезно представить это как три слоя, которые могут быть реализованы раздельно или объединены в рамках единого хранилища. В некоторых архитектурах основной слой - транзакционный, но он поддерживает встроенные возможности колоночного аналитического доступа и локальную обработку запросов поверх своей собственной копии данных. В других реализациях аналитический слой является отдельной сущностью, тесно интегрированной через унифицированный формат хранения и публикацию изменений. В любом случае ключ к успеху HTAP - это синхронизированная работа слоев без принуждения к частой переработке данных и без возникновения гонок за ресурсы.
Эволюция подходов к хранению: OLTP vs OLAP и переход к единому HTAP-хранилищу
Исторически развитие систем данных шло через разделение функций. OLTP-системы, ориентированные на строки и запись-ориентированные операции, применяли B-деревья или LSM-деревья для быстрой мутации данных и обеспечения целостности транзакций. OLAP-системы же строились на колоночной организации, ориентированной на параллельную обработку больших массивов данных и сложные аналитические запросы.
С переходом к HTAP появляется новая эра унификации хранения. Этот переход можно рассматривать как эволюцию от узко специализированных архитектур к гибридным системам, способным обслуживать и транзакционные, и аналитические нагрузки на одном хранилище. Важной стратегией становится выбор форматов хранения, которые позволяют сочетать два мира:
-
строковое хранение. Оно обеспечивает эффективную обработку транзакций, быстрые вставки и обновления, минимизацию задержек при мутировании данных. Строковые базы часто применяют традиционные индексы, такие как B-деревья, что обеспечивает быстрый доступ к конкретным строкам и релевантность к операциям типа INSERT/UPDATE/DELETE.
-
колоночное хранение. Оптимизирует аналитические запросы, уменьшая объем данных, которые нужно прочитать, и повышая эффективность агрегаций. Колоночное представление особенно сильное для агрегатов, фильтраций и сквозной аналитики.
Гармония этих форматов достигается различными путями: через распределенное хранение, где основное хранилище может поддерживать оба формата или статически поддерживаемые копии, через репликацию и конверсию данных в режиме реального времени, или через унитарно спроектированное «единое хранилище», которое само поддерживает бинарную совместимость между операционными и аналитическими нагрузками.
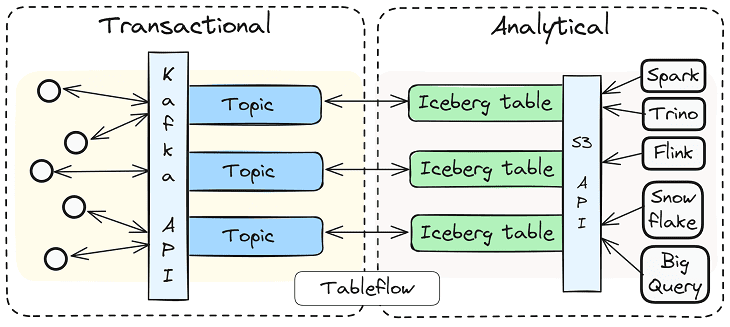
Появление унифицированных форматов хранения, таких как Apache Iceberg, Apache Hudi и Delta Lake, стало важной вехой на пути к HTAP. Эти проекты создают концепцию общих таблиц поверх объектного хранилища (например, S3, HDFS) и предоставляют функционал, близкий к тем же гарантиям целостности, версионирования схем, транзакционной эксплуатации и поддержки обновления метаданных. Они позволяют выносить данные в единый слой хранения, что сокращает задержки, упрощает данные конвейеров и облегчает синхронную работу аналитических и операционных нагрузок.
В практике HTAP-трансформации под задачу унификации попадают также новые гибридные концепции обработки: пакетная обработка с потоковым включением (streaming-orm) и последовательное использование движков пакетной обработки в связке с потоковым анализом. Примером служат подходы, где пакетная обработка тесно сочетается с реальным временем через интеграцию с движками типа Apache Spark и Apache Flink, создавая единую карту данных и единый контекст исполнения запросов.
В итоге, HTAP - это не только про хранение, но и про обработку: единое хранилище - это фундаментальная платформа для унифицированной обработки, где аналитические запросы могут использовать данные в тот же момент, когда обновляются транзакции, и где вычислительные движки способны выполнять задачи в рамках общей схемы доступа к данным.
Архитектурные варианты HTAP: строковое vs колоночное хранение, гибридные схемы и их взаимодействие

Архитектура HTAP может реализовываться в нескольких ключевых вариантах, каждый из которых содержит баланс между латентностью транзакций и эффективностью аналитики. Ниже приведены наиболее распространенные подходы, с пояснениями к их особенностям и компромиссами.
-
Основной слой строкового хранения с синхронной репликацией в колоночный аналитический контур. В этом варианте основное хранилище - строковое, ориентированное на частые мутации. Для аналитических целей данные реплицируются в колоночный или гибридный слой, который оптимизирован под агрегации и большие скрипты. Репликация может происходить синхронно, чтобы обеспечить роль единых источников правды, или асинхронно, с дополнительной обработкой задержки данных. Такой подход часто встречается в инфраструктурных решениях, где важны транзакционные гарантии и быстрая вставка.
-
Основной слой колоночного хранения с поддержкой транзакционных операций. Здесь аналитика может получить доступ к колонноному репозиторию, но используется версия хранимых данных, которая поддерживает транзакционные семантики через MVCC или подобную схему. Транзакции могут быть выполнены через специализированные механизмы блокировок, версионирования и контроля консистентности, чтобы не нарушать одну из двух парадигм. Такой подход чаще всего применяется в системах, где аналитика критична и требует высокой пропускной способности сквозной обработки.
-
Гибридные схемы с параллельной обработкой и локальным смешанным хранением. В рамках гибридной архитектуры данные могут поддерживаться одновременно и в строковом, и в колоночном представлении, при этом обмен данными между слоями осуществляется через механизмы синхронизации и консистентности. Такой подход позволяет выбрать оптимальный путь для конкретного запроса: мигрировать часть данных в колоночный контекст, когда требуется аналитическая активность, и вернуться к строковым структурам при выполнении транзакций.
-
Распределенное HTAP-решение с центральным унифицированным хранением и локализованной обработкой. Объектное хранение в сочетании с таблицами Iceberg/Hudi/Delta Lake обеспечивает единый слой данных, где транзакционные и аналитические операции происходят в рамках одного хранилища, но могут выполняться распределенно. В этом случае центральный узел отвечает за согласованность, а вычисления - за независимое исполнение задач, иногда в рамках одного движка (например, Spark) и на разных уровнях памяти и дисков.
-
Интеграция вычислительных движков. Независимо от конкретной схемы хранения, HTAP-практики требуют тесной интеграции движков вычислений: Spark обеспечивает пакетную обработку и машинное обучение на больших данных; Flink - потоковую и почти в реальном времени аналитику; оба движка могут работать в связке с единым файловым слоем и общими таблицами, обеспечивая эффективную подпитку вычислительных задач. В некоторых современных решениях часть аналитических операций может выполняться непосредственно внутри транзакционного движка, что снижает задержку и избегает промежуточного копирования данных.
Эти архитектурные варианты не являются взаимоисключающими; на практике они могут сочетаться внутри одной платформы в зависимости от конкретных требований к задержкам, масштабируемости и консистентности. Важным аспектом является выбор стратегий индексации и оптимизации запросов, чтобы обеспечить быстрый доступ как к точечным строкам, так и к агрегированным наборам. Гибридность требует и продуманной политики обновления индексов, времени жизни метаданных и согласованности между копиями данных в разных форматах.
Механизмы консистентности и управления данными: MVCC, блокировки, транзакционные ограничения
Ключ к устойчивой HTAP-архитектуре - эффективные механизмы управления данными и консистентностью между транзакциями и аналитикой. Рассмотрим основные элементы и принципы, которые чаще всего применяются в современных системах HTAP.
-
Многоверсионный контроль параллелизма (MVCC). MVCC позволяет читать данные на момент конкретной версии, не блокируя операции записи. Это особенно ценно для аналитических запросов, которые не должны блокироваться долгими транзакциями. MVCC обеспечивает чтение консистентной картинки данных даже при одновременной записи транзакций. Однако MVCC требует управления версиями и очистки устаревших версий, чтобы не перегружать систему.
-
Блокировки. Традиционные механизмы блокировок могут быть необходимы для обеспечения целостности при реализации сложных транзакций и внешних ключей. В HTAP-архитектурах блокировки применяются в сочетании с MVCC, чтобы снизить конфликты и предоставлять справедливые очереди на ресурсы. Выбор уровней блокировок, их длительность и совместное использование с чтением-люди важно для снижения задержек и предотвращения «deadlock» ситуаций.
-
Транзакционные ограничения и целостность (Constraints). Включение внешних ключей, ограничений уникальности, проверок и триггеров в HTAP-системах помогает поддерживать бизнес-правила и целостность данных в рамках единого хранилища. При этом следует учитывать влияние ограничений на производительность и возможность отката изменений.
-
Журналирование и репликация. Журналы изменений служат источником для репликации и синхронизации между транзакционным и аналитическим слоями. WAL (Write-Ahead Logging) и redo-логи играют критическую роль в обеспечении долговременной устойчивости. Репликация может быть синхронной или асинхронной, в зависимости от требований к консистентности и низкой задержке. В HTAP-системах контроль за консистентностью часто включается на уровне временных меток версии, чтобы аналитика могла «видеть» корректную картину данных.
-
Консистентная аналитика. Важная цель HTAP - предоставление согласованных аналитических результатов. Это означает не только наличие единых данных, но и согласованности между различными источниками и версиями. В некоторых реализациях применяется консистентная аналитика на основе транзакционных сигнатур и Snapshot Isolation, что позволяет обеспечить предсказуемость результатов аналитических запросов.
-
Ограничения и правила консистентности. В HTAP-архитектуре возможны режимы строгой консистентности или адаптивной консистентности, где уровень согласованности может быть динамически скорректирован в зависимости от нагрузки и времени ожидания. Это позволяет избегать перегрузки системы, сохраняя при этом качество аналитики на приемлемом уровне.
-
Управление схемами и эволюцией. В унифицированных форматах хранения важную роль играет поддержка версионирования схем, безопасное изменение структуры таблиц и перенос данных без нарушения доступности. Такие механизмы, как временные таблицы, схемы миграций и Time Travel, позволяют аналитикам работать с историческими версиями и проводить ретроспективный анализ.
Комбинация этих механизмов обеспечивает базовую гарантию надежности и предсказуемости в HTAP-системах. Важной задачей архитекторов и инженеров является баланс между уровнем блокировок, задержкой чтения и требований к точной консистентности. Эффективное управление данными требует грамотной настройки режимов MVCC, грамотного планирования индексов и стратегий репликации, а также продуманной политики очистки устаревших версий.
Интеграция вычислительных движков: Spark, Flink и их роль в HTAP
Современная HTAP-архитектура активно вовлекает вычислительные движки, чтобы обеспечить гибкость и мощность анализа. Два наиболее влиятельных направления - пакетная обработка и потоковая обработка. Их роль в HTAP часто определяется требованиями к латентности и характером рабочих нагрузок.
-
Apache Spark. Это движок пакетной обработки, который поддерживает обработку больших наборов данных, машинное обучение и графовую аналитику. В контексте HTAP Spark может выступать как компонент, обрабатывающий батчи данных, извлекаемые из унифицированного хранилища, и формирующий агрегированные представления для аналитических задач. В связке с единым файловым слоем он обеспечивает мощную платформу для кросс-дольной аналитики: от агрегаций до продвинутых моделей анализа. В сочетании с системами HTAP Spark может работать через pushdown-предикаты, динамическое копирование или сплит DataFrame-операций, что уменьшает задержку между изменением данных и аналитической интерпретацией.
-
Apache Flink. Этот движок ориентирован на потоковую обработку и низкую задержку. Flink обеспечивает непрерывную аналитику на основе потоковых данных, поддерживает обработку событий в реальном времени, обработку окон и сложные события. В HTAP-системах Flink часто интегрируется как компонент, который обрабатывает Change Data Capture и потоковые конвейеры, тем самым поддерживая постоянно обновляемые аналитические представления и «живые» панели мониторинга. Flink может работать совместно с Spark, разделяя задачи: Spark - для пакетной тяжелой аналитики, Flink - для поточного анализа и микро-агрегаций.
-
Роль интеграции. В рамках HTAP одной из задач является эффективное сочетание эти движков для обеспечения закрытия «мокрого кольца» между записью и аналитикой. Этапы интеграции включают: (1) обеспечение единого доступа к данным через унифицированный слой хранения, (2) pushdown вычислений, когда возможно перенести вычислительную логику прямо в хранилище, (3) управление временем обработки и консистентностью между пакетной и потоковой обработкой, (4) согласование модельных ограничений и совместимые схемы транзакций.
-
Примеры практик. В некоторых современных HTAP-платформах Spark и Flink используются как внешние движки, интегрированные через единый метаданный слой, который обеспечивает версионирование и консистентность. В других решениях движки могут быть встроены в базовую систему как «партнерские» слои, где основной транзакционный движок и аналитический движок работают синхронно через унифицированные таблицы и журналы изменений.
Итого, роль вычислительных движков в HTAP - обеспечение масштабируемой и гибкой аналитики как в пакетном, так и в потоковом режимах. Современные платформы стремятся к тесной интеграции этих движков с единым слоем хранения, чтобы минимизировать задержку и максимизировать пропускную способность аналитических конвейеров.
Унифицированные форматы хранения: объектное хранение и общие таблицы (Iceberg, Hudi, Delta Lake)
Ключевым элементом современных HTAP-архитектур является переход к унифицированному формату хранения. Объектное хранение, имеющее долговечность и масштабируемость, становится основой для единого слоя хранения, на котором строится как транзакционная, так и аналитическая обработка. Однако проблема в том, как обеспечить транзакционные гарантии и поддержку сложной аналитики на таком слое. Именно здесь на арену вышли концепции общих таблиц, реализуемые проектами Iceberg, Hudi и Delta Lake. Эти проекты предоставляют:
- управляемую версионирование таблиц и схем, что позволяет безопасно эволюционировать структуру данных без потери совместимости;
- поддержку транзакционных сценариев, благодаря форматам изменений и согласованию между параллельными операциями;
- эффективную оптимизацию хранения и выполнение запросов, включая разделение и индексирование данных, чтобы аналитика могла работать быстро даже на больших объёмах;
- Time Travel и версии данных, что обеспечивает возможность ретроспективного анализа и дебага.
Iceberg, Hudi и Delta Lake обеспечивают совместимость с объектным хранилищем и создают слой абстракции над физическим расположением данных. В HTAP-системах эти форматы позволяют осуществлять минимальные задержки между изменениями и аналитикой, предоставляя согласование версий и совместное использование схем. В условиях активно разворачиваемых Data Lakehouse-архитектур такие форматы становятся краеугольным камнем для унифицированного хранения, поскольку они позволяют хранить структурированные данные и партиционированные наборы в одном месте, поддерживая аналитическую функциональность и транзакционные гарантии.
Практические принципы работы с унифицированными таблицами включают:
- управление схемой времени и версиями, которое обеспечивает обратную совместимость и плавную миграцию;
- транзакционные операции на уровне таблиц через механизм, близкий к ACID-гарантиям;
- эффективную обработку изменений через журналы изменений, которые позволяют аналитическим движкам получать данные в нужной последовательности;
- оптимизацию чтения и записи через стратегию сжатия, разбиение по диапазонам и параллелизацию чтения.
Использование Iceberg/Hudi/Delta Lake не только упрощает архитектуру хранения, но и улучшает гибкость в выборе вычислительных движков, позволяя использовать ведущие решения для потоковой и пакетной аналитики в связке с единым хранилищем. В сочетании с современными HTAP-архитектурами эти проекты становятся основой для реализации «Data Lakehouse» концепции, где данные живут в едином слое и обслуживают как транзакционные, так и аналитические задачи.
Реализации HTAP в современных платформах: TiDB, Unistore от Snowflake, TableFlow и аналоги
Рынок HTAP-платформ демонстрирует широкий спектр решений, которые реализуют концепцию объединения транзакционной и аналитической обработки. Ниже приведены примеры заметных проектов и их ключевые особенности:
-
TiDB (от PingCAP). Эта распределенная база данных предоставляет HTAP-способности через гибридные таблицы и интеграцию с вычислительными движками. TiDB поддерживает транзакционные операции через MVCC, а аналитика может выполняться через соединение с движками вроде Spark/Flink или через собственные оптимизированные подсистемы. Важной чертой является горизонтальная масштабируемость, включая репликацию и консистентность между узлами. TiDB часто позиционируется как платформа, которая объединяет традиционные РС-запросы и аналитическую обработку на одном кластере.
-
Unistore от Snowflake. Snowflake традиционно известен как облачный data warehouse, однако в рамках своей архитектуры Unistore внедряет HTAP-подход в гибридных таблицах, сочетая характеристики транзакций, внешних ключей, ссылочной целостности и быстрой аналитики. Unistore предлагает единое хранилище, в котором поддерживаются как транзакционные, так и аналитические запросы без необходимости перемещать данные между системами. Это пример того, как облачные подходы могут реализовать HTAP-горизонты на уровне платформы с нативной поддержкой транзакций и сложной аналитики.
-
TableFlow и аналоги. TableFlow, разработанный в рамках контекста таблиц и потоковой семантики, демонстрирует HTAP-подход через единый механизм хранения (Kora) и предоставление транзакционной потоковой семантики вместе с аналитической семантикой для одного и того же топика. Это иллюстрирует тенденцию к взаимной интеграции потоков и периодического анализа на одной платформе, сокращая задержку и упрощая обработку.
Ключевые выводы из обзоров современных реализаций HTAP таковы:
- HTAP-платформы ориентированы на минимизацию этапов копирования данных и на упрощение ETL/ELT-конвейеров за счет унифицированного формата хранения и общей модели доступа.
- Важной характеристикой является способность поддерживать транзакционные гарантии и в то же время линейно масштабироваться для аналитики.
- Реализация гибридной архитектуры требует продуманной стратегии распределения данных между слоями, а также эффективной интеграции вычислительных движков для минимизации задержек.
- Облачные и гибридные платформы предоставляют новые возможности для автоматизации и саморегулируемой оптимизации запросов, включая предикативное управление нагрузкой и автоматическую настройку памяти и вычислительных ресурсов.
Эти примеры демонстрируют, что HTAP-платформы развиваются по направлению к унифицированному слою хранения и более тесной интеграции вычислений, что позволяет организациям достигать реального времени аналитики на единых данных, не жертвуя целостностью транзакций.
Архитектура синхронизации и репликации: журналирование, репликация и консистентная аналитика
Синхронизация между транзакционным и аналитическим слоями требует четко выстроенной архитектуры журналирования, репликации и консистентной аналитики. Ниже приводятся ключевые принципы и компоненты, которые обеспечивают корректное и предсказуемое поведение HTAP-систем.
-
Журналирование изменений. Журналы изменений служат основой консистентности и аудитирования. Они позволяют транзакциям отражать изменения в аналитический контур или наоборот. Хорошо реализованная система журналирования должна минимизировать задержку между событием изменения и его отражением в аналитической среде, а также поддерживать восстановление после сбоев.
-
Репликация. Репликация может быть как синхронной, так и асинхронной. Синхронная репликация обеспечивает мгновенное согласование между узлами и слоями, что усиливает консистентность, но может повысить задержку. Асинхронная репликация снижает задержку, но требует стратегий борьбы с расхождениями между копиями. В HTAP-контекстах часто применяется смешанный подход: критические транзакционные потоки работают с меньшей задержкой через локальную запись, в то время как аналитический контур обновляется асинхронно.
-
Конcистентная аналитика. Цель аналитики - видеть данные в консистентной картине, соответствующей состоянию базы в момент запроса. Это достигается через соответствие версий и совпадение временных меток. В некоторых реализациях применяется строгая консистентность (strong consistency) для транзакционных операций и последующая согласованная аналитика, в то время как для части аналитических процессов допускается слабая консистентность с поздней синхронизацией.
-
Управление задержками и потоком изменений. HTAP-системы должны эффективно обрабатывать поток изменений без создания «узких мест», поэтому важны механизмы задержек к минимизации задержек между записью и аналитикой. Это может включать уровни буферизации, оптимизацию журналирования, параллелизм при обработке изменений и предиктивную адаптацию ресурсов.
-
Конфигурация консистентного конвейера. В HTAP-конвейере архитекторы настраивают каналы распространения изменений, описывают семантику по времени версии, выбирают режимы задержек, чтобы сохранить баланс между скоростью аналитики и скоростью транзакционных операций. Важной задачей является также обеспечение трассируемости изменений и возможности отката на уровне отдельных версий.
-
Инструменты Change Data Capture (CDC). CDC-технологии позволяют определять изменения в транзакционном хранилище и передавать их в аналитический контур в реальном времени. В сочетании с унифицированными таблицами CDC обеспечивает возможности для аналитики, основанной на последних изменениях, а также исторической аналитики. В HTAP это особенно ценно, поскольку данные могут обновляться постоянно, а аналитика должна реагировать без задержек.
Синхронизация и репликация - это не только технические механизмы, но и стратегические решения, которые определяют поведение системы в условиях перегрузок, сбоев и изменений конфигурации. Эффективная архитектура HTAP требует тщательного проектирования этих процессов и учета компромисс между консистентностью и задержкой, возможностями горизонтального масштабирования и требованиями к SLA.
Эффективность исполнения и устранение задержек: устранение ETL/ELT, минимизация копирования данных
Одной из главных выгод HTAP является сокращение задержек между изменениями данных и их доступностью для аналитической обработки. Это достигается за счет ряда методик, направленных на устранение ETL/ELT-конвейеров, минимизацию копирования данных и сокращение промежуточных шагов.
-
Устранение ETL/ELT-конвейеров. В традиционных архитектурах данные из транзакционных систем требуют извлечения, трансформации и загрузки в отдельное хранилище для аналитики. HTAP-подход позволяет держать данные в едином слое и выполнять трансформацию прямо на месте по мере необходимости, избегая физических копирований и задержек, связанных с копированием больших массивов.
-
Минимизация копирования данных. В рамках HTAP нередко применяется подход «копия по запросу» или «виртуализация данных»: аналитика получает доступ к данным без постоянного дублирования. Объектное хранение с общими таблицами поддерживает такую концепцию за счет метаданных и версий, позволяя работать с данными в гибридном режиме без постоянного перемещения.
-
Pushdown вычислений. Аналитические операции могут быть «пушдом» в ядро СУБД или унифицированного хранилища, когда вычислительная логика встраивается непосредственно в путь чтения данных. Это позволяет снизить перемещаемые объемы и ускорить ответ.
-
Эффективные индексы. Гибридная индексация, которая сочетает B-деревья для OLTP-запросов и bitmap-индексы для OLAP-запросов, может существенно повысить производительность. Однако необходимо балансировать между размером индексов, скоростью обновления и стоимостью обслуживания.
-
Оптимизация выполнения запросов. В HTAP-архитектурах ключевыми являются улучшения в планировании запросов, распараллеливании и эффективном распределении вычислительных задач между узлами кластера. Включение вычислительных движков и использование их специализации (пакетная обработка против потоковой) помогает достигнуть более высокой пропускной способности и меньшей задержки.
-
Управление данными в памяти. В HTAP-решениях нередко применяется хранение части данных в памяти (in-memory) для быстрого доступа, особенно для горячих данных и критических запросов. Это позволяет существенно снизить латентность аналитики и повысить отклик систем в пиковых условиях.
-
Мониторинг и адаптация. Эффективная система HTAP требует механизмы мониторинга нагрузки и автоматической адаптации ресурсов. Динамическое перераспределение памяти, изменение параллелизма и выбор движков в зависимости от характера нагрузки - всё это позволяет поддерживать оптимальный баланс между транзакционными и аналитическими задачами.
Эти подходы вместе формируют основу для высокой производительности HTAP-систем, где задержки минимизируются, копирования сведены к минимуму, а аналитика становится ближе к данным и времени их изменения.
Ограничения и риски HTAP: сложность реализации, вычислительные требования и горизонтальная масштабируемость
Несмотря на многочисленные преимущества, HTAP сталкивается с рядом ограничений и рисков, которые необходимо учитывать при проектировании и внедрении:
-
сложность реализации. Объединение функций транзакций и аналитики требует сложной архитектуры, строгой координации между слоями и продуманной архитектурой консистентности. Реализация эффективного MVCC, синхронной и асинхронной репликации, управления зависимостями и схемами миграции - все это добавляет сложности.
-
вычислительные требования. HTAP может потребовать значительных ресурсов, включая большое количество оперативной памяти и быстрые устройства хранения (NVMe), чтобы поддерживать одновременную обработку транзакций и аналитики без ухудшения производительности. В ряде случаев потребуется выделение вычислительных пулов для отдельных задач и политик QoS.
-
горизонтальная масштабируемость. Хотя многие HTAP-решения предлагают распределение по узлам, реальная масштабируемость может оказаться ограниченной для некоторых рабочих нагрузок. При добавлении узлов важно, чтобы пропорциональная производительность росла для обеих задач, а не только для одной стороны.
-
конкуренция за ресурсы. Одновременная обработка транзакционных и аналитических запросов может приводить к конкуренции за память, CPU и I/O. Для эффективной реализации необходимо продуманное планирование ресурсов, мониторинг и согласование уровней приоритета.
-
риск задержек консистентности. В условиях высокой нагрузки возможно появление задержек между операциями записи и их отражением в аналитическом контуре. Наличие механизмов задержек, версионирования, а также выбора режимов согласованности могут смягчать такие риски, но требуют внимательного управления.
-
сложность эксплуатации и поддержки. HTAP-платформы требуют продвинутых навыков по координации различных компонентов, оптимизации конфигураций и поддержке сложных сценариев миграции. Это может увеличить стоимость владения и требования к квалификации персонала.
-
зависимость от инфраструктуры и облачных условий. У некоторых HTAP-решений зависимость от облачной инфраструктуры может быть высокой, включая требования к сетевой пропускной способности, задержкам и стабильности хранения. Вникание в условия эксплуатации и региональные ограничения становится важной частью планирования.
Осознание ограничений и рисков позволяет архитекторам и руководителям проектов рассчитать реальные затраты и определить соответствующий уровень зрелости проекта, чтобы обеспечить достижимые результаты и устойчивое развитие HTAP-систем.
Метрики эффективности HTAP-систем: latency, throughput, согласованность и стоимость владения
Эффективность HTAP-систем оценивают по нескольким ключевым метрикам. Они помогают определить, достигаются ли цели проекта и как система ведет себя под реальной нагрузкой.
-
задержка (latency). Важно измерять задержку на разных уровнях: транзакционная задержка, задержка между записью и аналитическим отображением, задержка аналитических запросов и конечная задержка пользовательских дашбордов. В HTAP критично держать latency в пределах диапазона, подходящего для бизнес-требований.
-
пропускная способность (throughput). Включает в себя количество транзакций в секунду, количество аналитических запросов за единицу времени и обработку потоковых событий. Важно обеспечить устойчивую производительность при пиковых нагрузках.
-
согласованность. Выбор модели консистентности имеет прямое влияние на точность аналитики. Метрики включают уровень строгости консистентности, время достижения консистентной картины и способность поддерживать конфликт-резолюцию.
-
стоимость владения (total cost of ownership, TCO). В HTAP учитываются затраты на лицензии, оборудование, облачную инфраструктуру, эксплуатацию, мониторинг и обслуживание. Унифицированное хранение может снизить затраты на ETL-конвейеры, но при этом может потребовать более мощного оборудования и специализированной поддержки.
-
устойчивость и доступность. Важные характеристики - время безотказной работы (uptime), время восстановления после сбоев и способность к автоматическому восстановлению после отказа. Это особенно важно для критичных бизнес-сценариев, например банковских систем и систем онлайн-торговли.
-
качество аналитики. Включает точность, полноту и полноту актуальных данных, возможность ретроспективного анализа и корректность результатов при изменениях схем. Оценка качества аналитики требует постоянной валидации и инструментального мониторинга.
Эти метрики должны быть встроены в стратегию эксплуатации HTAP-платформы и контролируемы через KPI. Важна система мониторинга, которая может автоматически выявлять «узкие места» и предлагать варианты оптимизации - от перераспределения ресурсов и изменения параметров MVCC до пересмотра схемы индексации и перенаправления вычислительных задач.
Реальные кейсы применения HTAP: сценарии в банковском деле, ритейле, телеком и пр.
HTAP на практике находит применение в самых различных секторах, где требуется минимальная задержка между изменениями и аналитикой, а также строгая консистентность при больших объемах данных. Ниже приведены ориентировочные сценарии и принципы применения.
-
Банковская сфера. В банковских системах HTAP позволяет в реальном времени оценивать риск, выявлять подозрительные операции и поддерживать ежедневные процессы анализа клиентской активности без задержек. Применяются HTAP-решения для анализа кредитных лимитов, мониторинга транзакций и поддержки персонализированного финансового обслуживания.
-
Ритейл и электронная коммерция. В розничной торговле HTAP обеспечивает мониторинг запасов в реальном времени, оптимизацию ассортимента, ценовую аналитику и персонализированные предложения на основе актуальных транзакций покупателей. Это позволяет избежать дефицита или переизбытка товаров и повысить конверсию.
-
Телекоммуникации. В индустрии коммуникаций HTAP используется для мониторинга качества услуг, обнаружения отклонений, анализа потребления и динамики клиентов. Реальное время позволяет быстро выявлять аномалии и реализовывать корректирующие меры.
-
Производство и логистика. В рамках HTAP можно реализовать мониторинг цепочки поставок, анализ производства и качества продукции в режиме реального времени, интегрируя данные с сенсоров, ERP-систем и систем управления складом. Это поддерживает быстрые управленческие решения и снижение времени реакции.
-
Финансовые сервисы и страхование. HTAP облегчает реализацию онлайн-аналитики для риск-менеджмента, ценообразования и оценку портфелей. Совмещение транзакций и аналитики помогает в создании динамических моделей и быстрого реагирования на изменения рынков.
Эти кейсы демонстрируют, что HTAP - это не лабораторная концепция, а практическая архитектура, применимая в сферах, где требуется оперативность и точность в обработке данных.
Интеграция стеков и синергия технологий: взаимодействие хранения, вычислений и обработки потоков
Одной из центральных задач HTAP является синергия между стеком хранения, вычислениями и обработкой потоков. Этим достигается плавное движение данных и кросс-слой аналитики. Основные принципы интеграции включают:
-
единый слой хранения. Применение унифицированных форматов хранения (Iceberg, Hudi, Delta Lake) позволяет держать данные в одном месте и обеспечить единые принципы консистентности и миграции. Это упрощает обмен данными между транзакционными и аналитическими задачами.
-
интеграция вычислительных движков. Spark и Flink выполняют задачи пакетной и потоковой аналитики, интегрируясь с единым слоем хранения. Это позволяет выполнять глубокий анализ на больших данных без перемещения данных в отдельные OLAP-базы.
-
обработка потоков и изменений. Применение CDC и стрим-аналитики в сочетании с HTAP-слоями позволяет отслеживать изменения в реальном времени и обновлять аналитические представления без задержек.
-
совместное использование памяти и оптимизация ввода/вывода. Эффективная работа требует разумного распределения данных между памятью и дисками, а также оптимизации ввода-вывода через кэширование, агрессивное предикат-пушение и параллелизм.
-
управление схемой и данными. В HTAP-архитектуре важна гибкая политика схем, где версии и миграции управляются через единый набор метаданных. Это снижает риски простоя и упрощает сопровождение.
Эти принципы формируют основу для построения устойчивых и гибких HTAP-решений, где данные могут быть доступны и для оперативной транзакции, и для аналитики в реальном времени и без излишних задержек.
Применение HTAP в экономических секторах: банковский сектор, финансы, розничная торговля, производство
HTAP-технологии особенно актуальны для финансово-экономических сфер, где критична скорость реакции и точность анализа. Ниже приведены направления применения в различных секторах:
-
Банковский сектор и финансы. Реальное время анализа транзакций, мониторинг риск-экспозиции, предотвращение мошенничества и управление портфелями требуют мгновенного отражения изменений и оперативной аналитики. HTAP позволяет сочетать транзакционные механизмы, такие как контроль целостности и внешние ключи, с аналитикой по банковским данным, рынкам и клиентскому поведению.
-
Розничная торговля и онлайн-ритейл. Управление запасами и ценообразование в реальном времени, персонализация предложений и оптимизация цепочек поставок становятся возможными благодаря унифицированному слою хранения и быстрому доступу к актуальным данным.
-
Производство и цепочки поставок. HTAP поддерживает мониторинг производственных процессов на местах, анализ качества и времени простоя, а также оптимизацию логистических маршрутов благодаря интеграции данных в реальном времени.
-
Телекоммуникации. Контроль качества сервиса, анализ использования сетей и мониторинг аномалий требуют быстрого доступа к данным и аналитических выводов для оперативного принятия решений.
Такие примеры иллюстрируют, как HTAP может во многом заменить или заменить частично существующие конвейеры ETL/ELT и разносить анализ и операционные задачи на единый контур, снижая задержку и ускоряя принятие бизнес-решений.
Конкурентный анализ HTAP-решений: дифференциация платформ и сравнение конкурентов
На рынке HTAP-платформ присутствуют как готовые коммерческие решения, так и открытые экосистемы с модульной архитектурой. Ключевые точки дифференциации включают:
-
поддержка транзакционных гарантий. Важна способность сохранять ACID-свойства в транзакциях на единообразном слое хранения, чтобы обеспечить надежность операций.
-
горизонтальная масштабируемость. Возможность равномерно наращивать вычислительные ресурсы и хранение при сохранении производительности.
-
интеграция движков. Наличие глубокой интеграции между внутренними движками и внешними системами вычислений, такими как Spark и Flink, а также способность работать с объектным хранением и общими таблицами.
-
управление схемами. Эффективность миграций и версионирования таблиц, поддержка Time Travel и безопасной эволюции структур.
-
стоимость владения и операционная сложность. Включает ценовую модель, инфраструктурные требования, требования к квалификации персонала и способность к автоматизации.
-
поддержка специфических отраслевых сценариев. Некоторые платформы предлагают готовые паттерны под банковское дело, розничную торговлю, телеком или производство, что может снизить время внедрения.
Сравнение конкурентов требует оценки совокупной ценности: производительности, согласованности, гибкости, бюджета и длительности внедрения. Выбор HTAP-решения должен учитывать как текущие потребности, так и стратегию роста, включая планы по расширению инфраструктуры, миграции на единые таблицы и интеграцию вычислительных движков.
Вопрос-Ответ
Вопрос: Что такое HTAP и какие основные цели этой архитектуры?**
HTAP - это гибридная транзакционно-аналитическая обработка, объединяющая OLTP и OLAP нагрузки в рамках единого контекста хранения и вычислений. Цели включают снижение задержек аналитики, устранение ETL/ELT, поддержку транзакционных гарантий и предоставление реального времени аналитики на актуальных данных.
Вопрос: Какие три базовых компонента характерны для HTAP-архитектуры?**
Транзакционное хранение (обеспечивает изменения и целостность), аналитический слой (обработка сложных запросов и агрегаций), контролируемая синхронизация (журналы изменений, репликация и консистентная аналитика).
Вопрос: Какие главные архитектурные варианты HTAP существуют?**
Варианты включают: (1) основной слой строкового хранения с синхронной репликацией в аналитический контур; (2) основной слой колоночного хранения с поддержкой транзакций; (3) гибридные схемы с параллельной обработкой и локализованным смешанным хранением; (4) распределенное унифицированное хранение через Iceberg/Hudi/Delta Lake; (5) тесная интеграция вычислительных движков (Spark, Flink) с единым хранилищем.
Вопрос: Как MVCC влияет на HTAP?**
MVCC обеспечивает чтение консистентных снимков данных без блокировок записи, что способствует снижению задержек аналитических запросов и облегчает согласованную аналитику на фоне транзакций. Однако MVCC требует управления версиями и очистки устаревших записей.
Вопрос: Какие роли выполняют Iceberg, Hudi и Delta Lake в HTAP?**
Это унифицированные форматы хранения поверх объектного хранилища, которые обеспечивают версии таблиц, транзакционную функциональность и поддержку эволюции схем. Они служат единым слоем хранения для транзакций и аналитики, что упрощает конвейеры и сокращает задержки.
Вопрос: Каким образом достигается консистентная аналитика в HTAP?**
Через синхронную/асинхронную репликацию изменений, журналирование, версии данных и согласование временных меток. Аналитика должна видеть корректную картину данных во времени запроса, и для этого применяются MVCC, Snapshots и строгие правила согласованности.
Вопрос: Какие отраслевые сценарии лучше всего подходят для HTAP?**
Банковский сектор, финансы, розничная торговля, производство, телекоммуникации - везде, где необходима оперативная аналитика на данных, поступающих в реальном времени, и где критична целостность транзакций.
Вопрос: Какие основные риски стоит учитывать при внедрении HTAP?**
Сложность реализации, вычислительные требования, возможная ограниченная горизонтальная масштабируемость и риск конфликтов ресурсов между транзакционными и аналитическими задачами. Также нужно внимательно рассмотреть стоимость владения и требования к персоналу.
Вопрос: Каковы главные преимущества унифицированного хранения в HTAP?**
Упрощение архитектуры, устранение дублирования данных, снижение задержек за счет устранения ETL/ELT-процессов, возможность более быстрой аналитики на актуальных данных и снижение общей стоимости владения.
Вопрос: Какие вычислительные двигки чаще всего применяются вместе с HTAP?**
Apache Spark для пакетной аналитики и Apache Flink для потоковой аналитики. Их интеграция в единый слой хранения обеспечивает гибкость и масштабируемость, позволяя обрабатывать данные как в пакетном, так и в потоковом режимах без лишних перемещений.
Вопрос: Что следует учитывать при выборе HTAP-платформы для организации?**
Необходимо учитывать требования к транзакционной согласованности, масштабируемость, потребности в интеграции вычислительных движков, инфраструктурные ограничения, стоимость владения, отраслевые сценарии и зрелость платформы на рынке.
Структура и логика статьи выстроены в направлении от общих концепций HTAP к конкретным архитектурным решениям, затем к практическим реализациям в реальных платформах и к сценариям применения. В тексте уделено внимание не только «что» делает HTAP, но и «почему» такие подходы необходимы в условиях быстрого роста объема данных, требовательности к задержкам и потребности в едином контексте хранения и анализа. Во всех абзацах подчеркивается роль MVCC, синхронизации, унифицированного формата хранения и интеграции вычислительных движков, что обеспечивает глубокое понимание концепций и дает читателю ориентир для выбора и реализации HTAP в современных организациях.