

FastStream для Apache Kafka: архитектура, интеграции и сценарии применения в потоковой обработке данных
Введение: контекст и мотивация использования FastStream для Kafka
Современная индустрия данных испытывает острую потребность в эффективной организации потоковых конвейеров между источниками событий и хранилищами знаний. Решения на основе Apache Kafka стали де-факто стандартом для передачи больших объемов событий в реальном времени благодаря высокой пропускной способности, устойчивости к отказам и мощной экосистеме инструментов. В этом контексте быстрорастущие команды дата-архитекторов и инженеров API-ориентированно ищут унифицированные фреймворки, которые позволяют сфокусироваться на бизнес-логике, а не на низкоуровневых деталях коммуникации и сериализации.
FastStream выступает как такой унифицированный фреймворк для конвейеров на Python. Основа подхода FastStream состоит в том, что основной единицей конвейера является брокер, вокруг которого строится потоковая обработка: продюсеры и потребители, маршрутизация, кодирование и декодирование сообщений в формате JSON, а также документация AsyncAPI. Использование асинхронного программирования обеспечивает минимальные задержки и высокую пропускную способность на многоядерных системах. Взаимодействие с Apache Kafka реализуется через популярные клиенты AIOKafka и Confluent, что позволяет сочетать простоту использования FastStream с возможностями знаменитых Kafka-экосистем.
Ниже будут рассмотрены архитектура и принципы взаимодействия, теоретические основы потоковой обработки и асинхронного программирования, моделирование данных и способы сериализации, реализация продюсеров и потребителей, практические примеры, интеграция с FastAPI, а также вопросы производительности, рисков и конкурентного анализа. Статья ориентирована на аналитиков, архитекторов данных, руководителей data-направлений и ИТ-директоров, которым важна связность теории и практики в реальном мире корпоративных конвейеров.
Архитектура FastStream: основные компоненты и принципы взаимодействия
FastStream можно рассмотреть как фреймворк, который инкапсулирует работу с несколькими брокерами сообщений, но при этом сохраняет единый стиль разработки продюсеров и потребителей. Основные принципы можно сформулировать следующим образом:
-
Брокер как центральная абстракция: продюсеры и потребители зависят от брокера, который обеспечивает маршрутизацию, сериализацию и обработку ошибок. Это упрощает переход между разными брокерами (Kafka, RabbitMQ, NATS, Redis) без переписывания бизнес-логики.
-
Унифицированный API для публикации и подписки: decorators @broker.publisher(...) и @broker.subscriber(...) позволяют описывать обработку сообщений в одном месте, отделяя бизнес-логику от транспортной инфраструктуры.
-
JSON как основной формат обмена: данные сериализуются в JSON, что совместимо с большинством систем чтения и анализа.
-
Интеграция с современными инструментами: FastStream поддерживает Pydantic для валидации и преобразования схем, AsyncAPI - для генерации документации и контрактов между производителями и потребителями.
-
Асинхронная обработка и параллелизм: благодаря asyncio, многопоточному исполнению и возможности распределения задач по разделам топиков, достигается высокая производительность и масштабируемость.
-
В качестве примера реализации с Kafka используется AIOKafka и Confluent: два популярных клиента - асинхронный клиент на базе asyncio и зрелая платформа для взаимодействия с Kafka и системой управления консьюмерскими группами.
-
Интеграция со стеком разработки: FastStream может быть частью FastAPI-архитектур, позволяя продюсировать и потреблять события в контексте REST- или WebSocket-приложений.
Ключевые компоненты архитектуры FastStream в контексте Kafka можно представить как следующие элементы:
- KafkaBroker (или общий брокер): предоставляет интерфейс к реализации конкретного клиента Kafka через адаптеры AIOKafka/Confluent.
- Publisher и Subscriber: объекты, которые далее используются декораторами для определения поведения продюсирования и подписки на события.
- Преобразование данных: ввод и преобразование входных данных через Pydantic-модели и/или датаклассы, конвертация в JSON.
- Маршрутизатор потоков: механизм, который определяет, как сообщения распределяются по разделам (partitions) топика или по другим критериям маршрутизации.
- Встроенная безопасность: поддержка SASL/SSL и других механизмов аутентификации, что важно для интеграции в корпоративные среды.
- Генерация AsyncAPI: автоматизация документации контрактов и схем коммуникации между участниками конвейера.
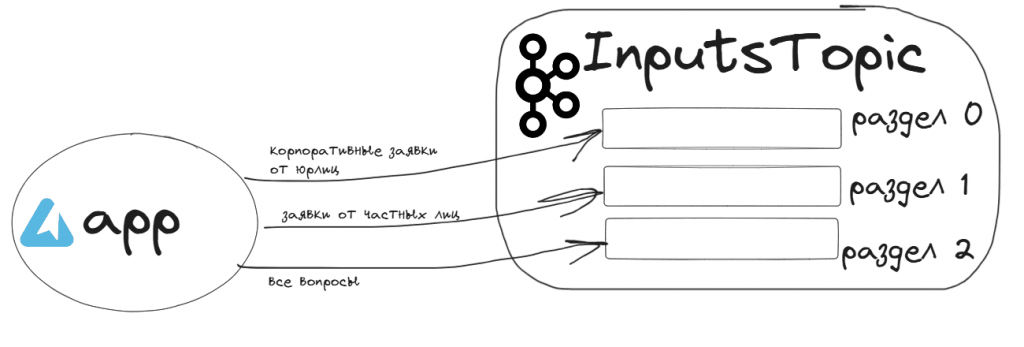
Для лучшего понимания взаимосвязей полезно рассмотреть пример: продюсер публикует сообщения в топик InputsTopic, потребитель обрабатывает их в зависимости от раздела и типа обращения, а маршрутизатор распределяет нагрузку на разделы топика. Такой подход минимизирует задержки и позволяет масштабировать обработку по разделам Kafka и по параллелизму внутри FastStream.
Декомпозиция технических компонентов и их взаимодействия
Чтобы обеспечить устойчивую и понятную архитектуру, рассмотрим детально разбиение на модули и их взаимодействие.
- Брокеры как абстракции транспорта. У каждого брокера будет свой адаптер: Kafka, RabbitMQ и т. д. В FastStream основной объект окружает логику маршрутизации и обработки, а конкретный транспорт реализуется через адаптеры. Это позволяет разработчику не заботиться об особенностях конкретного брокера, если бизнес-логика едина.
- Декораторы публикации и подписки. Функции продюсеров и потребителей объявляются через декораторы. Эти декораторы автоматически оборачивают вызовы в кодирование/декодирование сообщений, валидируют данные на вход, формируют документацию AsyncAPI и управляют контекстом исполнения.
- Серверная валидация и преобразование данных. Известные техники: Pydantic - для строгой валидации и преобразования JSON-сообщений в объекты Python; датаклассы - для компактности и сериализации через asdict. В FastStream возможно комбинированное использование, чтобы обеспечить максимальную гибкость и легко поддерживать контрактные требования.
- Маршрутизация и разделение по разделам топика. В Kafka каждый топик может быть разделен на множество разделов (partitions). FastStream использует логику маршрутизации, которая определяет, в какой раздел отправлять конкретное сообщение. Это критично для обеспечения параллелизма и локализации ошибок.
- Управление состоянием и устойчивость к сбоям. Встроенные механизмы повторной отправки, отката и ретрансляции событий помогают обеспечивать устойчивость конвейера. В реальных системах важно учитывать идемпотентность обработчиков и согласованность событий.
- Потребители и продюсеры в рамках одного конвейера. Архитектура поддерживает как одиночную обработку, так и множество параллельных консьюмеров, которые могут работать в рамках одного брокера или распределяться по нескольким брокерам.
- Безопасность и доступ. Поддержка SASL (Simple Authentication and Security Layer) и SSL/TLS позволяет использовать FastStream в защищенных средах. В корпоративной среде это критично для соответствия требованиям аудита и защиты данных.

Эти элементы образуют устойчивую архитектуру, которая способствует быстрой реализации потоковых решений и упрощает эволюцию конвейеров под изменяющиеся требования бизнеса.
Теоретическая база: основы потоковой обработки и асинхронного программирования
Понимание теоретических основ позволяет обосновать инженерные решения и оценить риски. В контексте FastStream и Kafka речь идет о взаимосвязи между потоковой обработкой и асинхронным программированием.
- Потоковая обработка: концепция непрерывного потока данных, где события приходят постоянно и требуют своевременной обработки. В современных системах важны задержка (latency), пропускная способность (throughput) и согласованность порядка обработки.
- Обработчики событий и их контракты: бизнес-логика должна быть ориентирована на обработку событий без блокировок и с минимальными задержками. Встроенная маршрутизация позволяет распределять нагрузку и управлять очередями.
- Асинхронное программирование в Python: основной механизм ─ asyncio, который реализует неблокирующий цикл событий. Асинхронность обеспечивает высокий уровень параллелизма без явной распараллеливания потоков, что особенно важно при работе с сетью и I/O.
- Многопоточность и параллелизм. В реальных системах неоднозначна грань между параллелизмом и конкурентностью. Python-реализация с GIL ограничивает параллельное исполнение Python-кода в нескольких потоках, но можно использовать многопроцессорность и пул исполнителей для вычислительно тяжелых задач, а для I/O‑оперций применить asyncio и ThreadPoolExecutor.
- Контракты через AsyncAPI. Генерация AsyncAPI позволяет документировать контракт между продюсерами и потребителями в формате, понятном для автоматической генерации клиентов и тестирования. Это повышает качество интеграции между различными участниками конвейера и ускоряет внедрение новых сервисов.
Эти основы служат теоретической основой для разработки продюсеров и потребителей на FastStream и для понимания того, какие архитектурные решения приводят к устойчивому и масштабируемому конвейеру данных.
Модели данных и сериализация: Pydantic, dataclasses, JSON
Эффективная обработка событий требует строгих схем и надёжной сериализации. В FastStream широко применяются:
- Pydantic: обеспечивает валидацию входящих данных, преобразование к нужному типу и четкое описание схем через Python‑типы. Плюсы: понятность, статическая проверка в процессе разработки, автоматическая документация.
- Dataclasses: легковесные структуры данных, удобные для сериализации через asdict и последующей конвертации в JSON. Они хорошо сочетаются с простыми моделями и обеспечивают минимальные накладные расходы.
- JSON: основной формат передачи данных между продюсерами и потребителями и между сервисами. JSON удобен для межсистемной совместимости и читаемости, однако требует осторожности в вопросах эффективной сериализации больших объемов и обеспечения согласованности типов.
- Преобразование входных данных в объекты Python: аннотированная сигнатура функций и моделей помогает автоматически валидировать данные и упрощает тестирование. Аннотации типов обеспечивают совместимость с инструментами статической проверки и генераторами документации.
- Генерация контрактов AsyncAPI: на основе деклараций annotated-моделей можно автоматически формировать документацию, которая описывает темы, форматы сообщений, схемы и требования к безопасности. Это упрощает коммуникацию между командами и поставляет единый источник истины.
Примерная цепочка: от JSON-сообщения к Pydantic-модели -> бизнес-объект -> сериализация обратно в JSON для отправки. Такая трансформация минимизирует ошибки в структурировании данных и облегчает поддержку изменений в схемах.
Реализация продюсеров и потребителей: декораторы брокеров и маршрутизация
Ключевая идея FastStream - это «брокеры» как центральная точка интеграции. Реализация продюсеров и потребителей происходит через декораторы, которые скрывают сложность взаимодействия с транспортом.
- Декоратор @broker.publisher(...): объявляет продюсера и правила публики сообщений. В нём описывается топик, разделение по partitions и требуемая сериализация.
- Декоратор @broker.subscriber(...): объявляет потребителя и обработчик входящих сообщений. Декоратор формирует контекст обработки, валидирует сообщение и вызывает бизнес‑логику.
- Маршрутизация по разделам (partitions): разделение топика на разделы позволяет разделять обработку по типу данных или по административным критериям, обеспечивая параллельную обработку и локализацию ошибок. В примере InputsTopic разделен на 3 раздела, куда попадают запросы в зависимости от типа обращения.
- Автоматизация JSON‑кодирования/декодирования: декораторы упрощают работу с сериализацией, превращая JSON в объекты Python и обратно.
- Генерация AsyncAPI-документации: декларативный стиль создания продюсеров и потребителей позволяет автоматически формировать спецификацию конвейера, улучшая межкомандную совместимость и тестируемость.
- Интеграция с FastAPI: возможна интеграция через StreamRouter: обработчики сообщений объявляются как в FastAPI‑роутере, что упрощает пересечение REST/stream-подходов.
Примерные принципы использования: разработчик объявляет бизнес‑логику внутри функций-подписчиков и функций-публикаторов, не беспокоясь о деталях подключения к Kafka/adapter’ов. Вся сложность сводится к описанию топиков, разделов, форматов сообщений и валидаторов - остальное берет на себя фреймворк.
Интеграция с Apache Kafka: использование AIOKafka и Confluent
Apache Kafka - мощная платформа для потоковой обработки, поддерживаемая двумя основными путями клиентских реализаций: AIOKafka иConfluent. FastStream реализует абстракцию брокера поверх этих клиентов, что обеспечивает совместимость и гибкость.
- AIOKafka: асинхронный клиент на основе asyncio, оптимизированный для высоких задержек и пропускной способности в потоковой обработке. Преимущества: неблокирующая архитектура, простой API, поддержка asyncio, подходящий для Python‑энвайронментов.
- Confluent Kafka: зрелый набор инструментов, в том числе клиент консьюмеров/продюсеров от Confluent. Поддерживает дополнительные возможности, такие как безопасная аутентификация, оптимизация производительности, мониторинг и интеграция с экосистемой Confluent. В FastStream это может быть реализовано через соответствующие адаптеры, обеспечивающие совместимость с существующей инфраструктурой.
- Abstraction через KafkaBroker: независимо от выбранного клиента, FastStream предоставляет единый интерфейс брокера. Это облегчает миграцию между клиентами и позволяет сосредоточиться на бизнес‑логике.
- Безопасность и шифрование: использование SASL/SSL позволяет работать в защищенной корпоративной среде, удовлетворяя требованиям аудита и соответствия. Включение безопасных протоколов - ключ к внедрению в реальных проектах.
- Производительность и масштабирование: AIOKafka хорошо масштабируется в асинхронной среде, что обеспечивает низкие задержки; Confluent может предоставить дополнительные возможности мониторинга и управления конвейером, что полезно на крупных предприятиях.
Сочетание этих клиентов с унифицированной архитектурой FastStream позволяет проектировать конвейеры, которые могут запускаться в разных окружениях и независимо от конкретной реализации Kafka-клиента. Важным является соблюдение контрактов схем и порядка обработки сообщений, чтобы не нарушать бизнес‑правила при переходе между реализациями клиента.
Практический пример: публикация данных в InputsTopic и разделение по разделам
Для иллюстрации рассмотрим практический пример публикации клиентских обращений в топик InputsTopic. Топик разделен на три раздела (partition): корпоративные заявки от юрлиц публикуются в раздел 0, данные обращений в формате JSON имеют схожий набор полей, но различия зависят от типа обращения.
- Модели данных. В примере используются несколько уровней моделей:
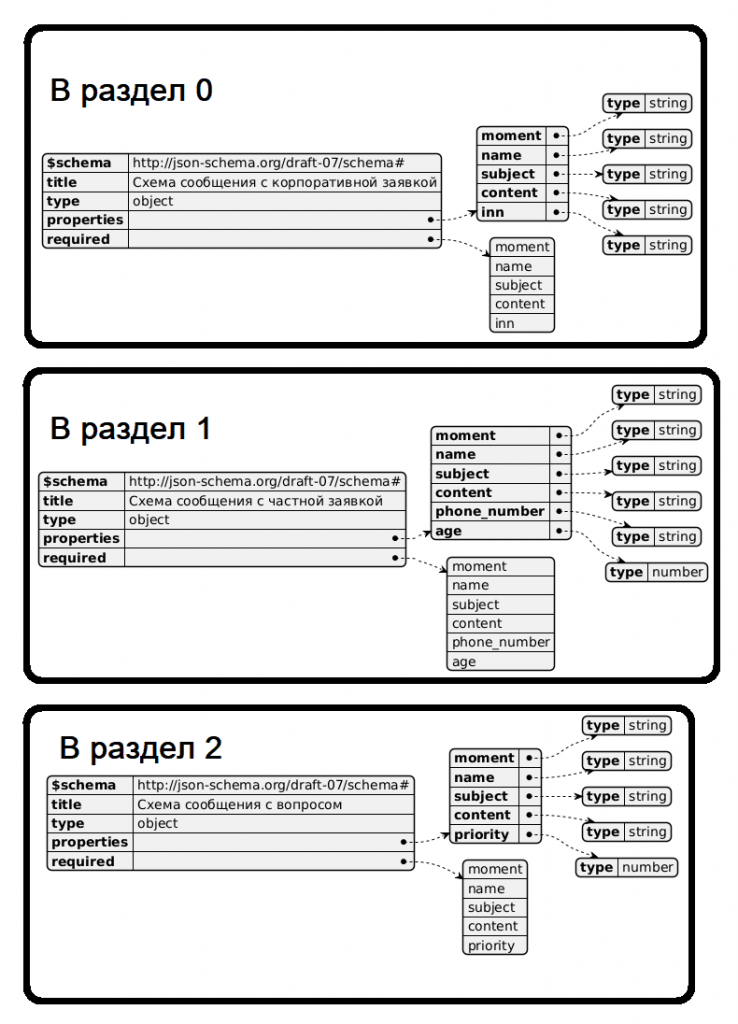
- Базовый класс RequestData: moment, name, subject, content.
- CorporateRequest: добавляет inn (индивидуальный идентификационный номер предприятия).
- PrivateRequest: добавляет phone_number и age.
- QuestionRequest: добавляет priority.
- Генерация данных. С помощью Faker формируются значения полей для реалистичных тестов. Разные типы обращений генерируют различный контент и маршрутизируются в соответствующие разделы.
- Публикация в топик. Объект данных сериализуется в JSON и отправляется с указанием раздела (partition) топика Kafka для равномерного распределения нагрузки и уменьшения конкуренции между потребителями.
- Примерная логика маршрутизации. В зависимости от темы (appointment vs question) и типа обращения (corporate vs private) выбирается раздел:
- Корпоративные заявки → раздел 0.
- Частные заявки → раздел 1.
- Вопросы → раздел 2.
- Роль данных в бизнес-контексте. Корпоративные клиенты требуют строгой идентификации и соблюдения регуляторных требований, тогда как частные клиенты требуют более гибкой маршрутизации. Вопросы требуют отдельной обработки и приоритетной очереди.
Данный сценарий демонстрирует, как архитектура FastStream обеспечивает динамическую маршрутизацию, а AIOKafka/Confluent обеспечивают надёжность транспортного уровня. В реальном проекте добавляются слои валидации, мониторинга и обработки ошибок, чтобы обеспечить устойчивость к сбоям и высокую доступность.
## Пример концепции (упрощенная схема)

class RequestData(BaseModel):
    moment: str
    name: str
    subject: str
    content: str

class CorporateRequest(RequestData):
    inn: str

class PrivateRequest(RequestData):
    phone_number: str
    age: int

class QuestionRequest(RequestData):
    priority: int

## Псевдокод FastStream

app = FastStream(broker)
publisher = broker.publisher("InputsTopic")

@broker.subscriber("InputsTopic")
def process_message(msg: dict):

    ## валидация и обработка

    data = parse(msg)
    route_to(partition=determine_partition(data))
    return data
Этот код иллюстрирует общий подход: объявление моделей данных, регистрация продюсера и потребителя, маршрутизация по разделам и обработка сообщений. В реальном проекте код будет включать полноценную обработку ошибок, ретраи и интеграцию с бизнес‑логикой.
Интеграция стека: совместное использование FastStream с FastAPI
FastAPI - современный асинхронный веб‑фреймворк на Python, который хорошо сочетается с FastStream. Объединение потоковой обработки и REST‑интерфейсов позволяет строить единые сервисы, где веб‑слой и конвейеры событий работают на одной платформе.
- StreamRouter в FastAPI. Использование того же подхода к определению обработчиков сообщений через декораторы позволяет построить единое место описания логики.
- Одновременный доступ к данным. В одном приложении можно обрабатывать запросы HTTP для получения метрик, конфигураций, а также публиковать события в Kafka через продюсер FastStream.
- Контракты и документация. AsyncAPI-документация синхронизируется с OpenAPI (REST) и схемами FastStream, обеспечивая единый контракт между поставщиками и потребителями.
- Мониторинг и observability. Соглашения по трассировке (например, OpenTelemetry) применимы к обоим путям - потокам и REST‑API - что упрощает диагностику и мониторинг.
Интеграция такого стека позволяет компаниям быстро разворачивать минимальные жизнеспособные продукты: сервисы REST для управления конвейером, а параллельно - высокопроизводительную потоковую обработку через FastStream.
Производительность и масштабирование: задержки, многопоточность, параллелизм
Производительность и масштабирование являются критическими аспектами потоковых конвейеров. В контексте FastStream для Kafka можно выделить следующие ключевые подходы:
- Задержки и пропускная способность. Асинхронная обработка в сочетании с маршрутизацией по разделам позволяет достигать малых задержек при высокой пропускной способности. Важно минимизировать блокирующие операции в обработчиках и обеспечить эффективную сериализацию.
- Многопоточность и параллелизм. В Python многопоточность ограничена GIL, однако можно использовать пул потоков для I/O‑операций и распараллеливание вычислительных задач через multiprocessing. В сочетании с asyncio это даёт гибридную модель: асинхронный цикл в основном потоке и дополнительные потоки для специфических задач.
- Масштабирование по разделам топика. Разделение топика на partitions непосредственно поддерживает параллельную обработку: каждый раздел может обрабатываться своим консьюмером, что увеличивает общую пропускную способность конвейера.
- Обработка ошибок и ретраи. Встроенные механизмы повторной отправки и управление ретраями помогают поддерживать устойчивость. Правильная настройка времени между попытками и ограничений по количеству повторов способствует снижению перегрузки.
- Мониторинг и эвристика по задержкам. Метрики задержек, throughput, backlog (скопление не обработанных сообщений) и качество обработки позволяют адаптивно настраивать параметры конвейера: размер пула, количество потребителей, параметры ретраев.
Эти принципы обеспечивают высокую надёжность и предсказуемость характеристик конвейера в реальном промышленном окружении.
Кейсы применения в реальных сценариях
Реальные сценарии показывают практическую ценность FastStream для архитекторов и инженеров:
- Финансовый сектор. Потоковая обработка торговых и риск-данных в реальном времени с требованиями к задержкам и обработке событий в строгом порядке. Использование декораторов и маршрутизации по разделам позволяет управлять сложной логикой обработчиков и обеспечивать соответствие регуляторным требованиям.
- Ритейл и электронная коммерция. Публикация клиентских обращений, заказов и событий активности пользователей в топики Kafka для последующей аналитики и автоматизации маркетинга. Разделение данных по разделам топика обеспечивает параллельную обработку и снижение задержек.
- Здравоохранение и телеметрия. Потоковая передача телеметрических данных устройств и медицинских систем с минимальными задержками и надёжной доставкой. Адаптация к требованиям к приватности и безопасности данных через конфигурацию SASL/SSL.
- Производственные конвейеры и мониторинг. События с датчиков и производственных систем передаются в потоковую дорожку, затем анализируются на предмет коллизий, аномалий и инцидентов. AsyncAPI контракт помогает тесно согласовать форматы сообщений между производителями и потребителями.
Эти кейсы иллюстрируют, как архитектура FastStream может быть адаптирована под различные отраслевые требования и сценарии.
Интеграция технологических стеков и синергия
Универсальность FastStream проявляется в способности работать с различными компонентами технологического стека:
- Интеграция с FastAPI. Потоковые конвейеры могут взаимодействовать с REST‑слоем, обеспечивая единое приложение с единым контекстом конфигурации, логирования и мониторинга.
- Инструменты сериализации и валидации. Pydantic предлагает строгую валидацию и понятную модель данных, что упрощает тестирование и будущие эволюции схем. Dataclasses обеспечивают гибкость и компактность, а совместное использование этих инструментов дает баланс между строгой типизацией и простой сериализацией.
- AsyncAPI и OpenAPI. Документация контрактов и API-спецификаций становится единым источником правды для команд разработки, тестирования и эксплуатации. Это особенно важно в больших организациях с множеством микросервисов и сервисов потоков.
- Безопасность и соответствие. SASL/SSL и управление доступом позволяют внедрять конвейеры в защищенных окружениях, соблюдая требования к аудитам и аудита.
Синергия между фреймворками и клиентами Kafka позволяет создавать устойчивые и гибкие конвейеры, которые не зависят от конкретной реализации клиента и легко адаптируются под новые бизнес‑потребности.
Анализ рисков, уязвимостей, ограничений и метрик эффективности
У любого сложного конвейера есть риски и ограничения. Для FastStream в контексте Kafka можно выделить следующие аспекты:
- Совместное использование JSON. JSON удобен, но может быть неэффективен по объему и скорости парсинга по сравнению с бинарными форматами. В некоторых сценариях целесообразна компрессия сообщений или внедрение специализированных форматов (например, Avro) на основе контрактов AsyncAPI.
- Эволюция схем. Изменения в моделях данных требуют совместимости версий. Важно внедрить стратегию эволюции схем и тестирования на разных версиях моделий.
- Идемпотентность обработчиков. При повторной отправке сообщений необходимо обеспечить идемпотентность бизнес‑логики, чтобы избежать дублирования операций.
- Риск перегрузки и backpressure. Неправильная настройка лимитов очередей, ретраев и количества консьюмеров может привести к перегрузке брокера и задержкам.
- Мониторинг и телеметрия. Эффективные метрики включают задержку публикации и обработки, throughput, процент ошибок, количество повторных попыток, backlog и т. п. Наличие инфраструктуры для мониторинга критично для оперативной поддержки конвейера.
- Совместимость с конкурентами. При сравнении с другими решениями на рынке важно оценивать не только производительность, но и интеграционные возможности, совместимость и стоимость эксплуатации.
Эти аспекты следует учитывать на стадии архитектурного проектирования, чтобы минимизировать риски на этапе эксплуатации и обеспечить предсказуемую эффективность.
Конкурентный анализ конкурирующих решений и дифференциация
На рынке потоковых фреймворков есть несколько альтернатив, включая чистые клиенты Kafka, такие как kafka-python, confluent-kafka, Quix Streams и другие. Дифференциация FastStream проявляется в следующих областях:
- Упор на брокер как ядро моделирования: FastStream строится вокруг концепции брокера, что позволяет абстрагировать транспорт и сосредоточиться на бизнес‑логике. Это облегчает миграцию между брокерами и упрощает повторное использование кода.
- Облегчённые декораторы для продюсеров и потребителей: декларативный подход упрощает разработку, снижает объем шаблонного кода и ускоряет внедрение новых конвейеров.
- Интеграция с AsyncAPI: автоматическое формирование документации контрактов и спецификаций упрощает взаимодействие между командами и тестирование интеграций.
- Поддержка нескольких транспортов: AIOKafka и Confluent обеспечивают гибкость в выборе клиентов, а абстракция брокера позволяет переключаться между ними без изменений бизнес‑логики.
- Интеграция с современными стековыми решениями: совместная работа с FastAPI, OpenTelemetry, Pydantic и т. д. обеспечивает единый технологический стек и упрощает сопровождение.
Эти особенности делают FastStream конкурентоспособным выбором для построения гибких и масштабируемых конвейеров и позволяют получить значительные преимущества в развитии адаптивной архитектуры данных.
Применение в экономических секторах и экономическая эффективность
Экономическая эффективность внедрения потоковых конвейеров на базе FastStream определяется следующими факторами:
- Сокращение времени выхода на рынок. Унифицированный API, генерация AsyncAPI и быстрое развёртывание продюсеров/потребителей позволяют сократить задержку между концептом и готовой функциональности.
- Снижение затрат на поддержание кода. За счёт унифицированного подхода и абстракций уменьшается объем шаблонного кода и риск ошибок.
- Улучшение качества данных. Валидации и контрактная документация поддерживают устойчивость к изменениям схем и упрощают внедрение новых источников данных.
- Масштабируемость. Разделение по разделам топика позволяет увеличивать пропускную способность без радикальной переработки архитектуры.
- Безопасность. Встроенная поддержка SASL/SSL и контроль доступа обеспечивает соответствие требованиям к данным в корпоративной среде.
Для финансовых, розничных и производственных отраслей выгода может быть выражена в скорости реагирования на маркетинговые события, ускорении процессов обработки заявок, сокращении ошибок обработки и улучшении качества аналитических данных. Эффективность достигается за счет оптимизации процессов, модернизаций архитектурных слоёв и уменьшения временных затрат на интеграции между системами.
Выводы и перспективы
FastStream представляет собой современный подход к построению потоковых конвейеров в экосистеме Apache Kafka. Архитектура, основанная на брокере как центральной единице, обеспечивает гибкость и устойчивость к изменениям, а асинхронная обработка - необходимый элемент для высокой производительности. Интеграция с AIOKafka и Confluent позволяет адаптироваться к различным реализациям клиентской инфраструктуры и к требованиям безопасности.
Постоянное развитие стека - взаимосвязь FastStream, FastAPI и AsyncAPI - обеспечивает единую стратегию разработки, тестирования и эксплуатации. При этом важными остаются вопросы эволюции схем, идемпотентности обработчиков и мониторинга качества данных. В перспективе можно ожидать расширения возможностей по поддержке бинарных форматов, улучшенной кросс-сервисной оркестрации и более углубленной интеграции с инструментами observability.
Вопрос-Ответ
- Вопрос: Что такое FastStream и как он упрощает работу с Apache Kafka?**
FastStream - фреймворк для построения потоковых конвейеров на Python, где основная единица разработки - брокер. Он упрощает создание продюсеров и потребителей через декораторы, обеспечивает единую маршрутизацию, сериализацию в JSON и автоматическую генерацию AsyncAPI‑документации, интегрируется с AIOKafka и Confluent для работы с Kafka.
- Вопрос: Какие преимущества дает архитектура брокера?**
Брокер как центральная абстракция облегчает миграцию между транспортами, упрощает повторное использование кода, обеспечивает единый интерфейс для продюсеров/потребителей и позволяет гибко маршрутизировать сообщения по разделам топика.
- Вопрос: Какова роль Pydantic и датаклассов в моделях данных?**
Pydantic обеспечивает строгую валидацию и преобразование входящих сообщений в Python-объекты, улучшая корректность данных; датаклассы - легковесный способ описания структур данных и простая сериализация через asdict, что удобно для быстрого прототипирования.
- Вопрос: Что обеспечивает AsyncAPI в контексте FastStream?**
AsyncAPI генерирует контрактную документацию к потоковым сервисам, описывает топики, схемы и требования к сообщениям, что упрощает тестирование, интеграцию и сотрудничество между командами.
- Вопрос: В чем разница между AIOKafka и Confluent в реализации клиента Kafka?**
AIOKafka - асинхронный клиент на базе asyncio, обеспечивающий неблокирующую обработку сетевых операций; Confluent - зрелый набор инструментов с дополнительными возможностями мониторинга и интеграциями. FastStream обеспечивает абстракцию, позволяющую использовать оба варианта без изменения бизнес‑логики.
- Вопрос: Какие сложности могут возникнуть при эволюции схем данных?**
Основные сложности связаны с поддержкой обратной совместимости, необходимость миграции потребителей и продюсеров, а также тестирование новых версий контрактов. Рекомендовано внедрять версионирование схем и тестирование на совместимость.
- Вопрос: Как FastStream обеспечивает безопасность в корпоративной среде?**
Через встроенную поддержку SASL (например, SCRAM) и SSL/TLS, а также возможность настройки политики доступа и аудита. Это позволяет безопасно работать с данными в защищённых окружениях.
- Вопрос: Какие сценарии наиболее подходят для применения FastStream?**
Применение в потоковых конвейерах с потребностью в низких задержках и высокой пропускной способности, в интеграциях между сервисами через Kafka, в проектах с необходимостью документирования контрактов и совместимости между командами, а также в сочетании с веб-фреймворками (FastAPI) для быстрого разворачивания REST+stream сервисов.
- Вопрос: Какие критерии следует использовать для оценки производительности конвейера?**
Время задержки (latency), пропускная способность (throughput), backlog, доля ошибок, количество повторных попыток и устойчивость к сбоям. Также важны тесты на эволюцию схем и тестирование интеграций с внешними системами.
- Вопрос: Каковы преимущества синергии FastStream и FastAPI?**
Совокупное использование позволяет строить единый стек, где REST‑интерфейсы и потоковые конвейеры взаимно дополняют друг друга, обеспечивая единый контекст конфигураций, мониторинга и безопасности, ускоряя разработку и внедрение новых сервисов.
- Вопрос: Какие ограничения следует учитывать при выборе FastStream?**
Необходимость оценки требований к формату сообщений и скорости выполнения, а также совместимость с существующей Kafka‑инфраструктурой. В некоторых случаях требовательные к формату сообщений задачи могут потребовать перехода на другие форматы сериализации или более детальной настройки ретраев и идемпотентности.
- Вопрос: Какие метрики особенно полезны для анализа эффективности конвейера?**
Latency, throughput, error rate, retry rate, partition-level throughput, backlog, consumer lag и время обработки для разных топиков/разделов. Эти метрики позволяют быстро выявлять узкие места и оптимизировать конфигурацию.
- Вопрос: Как обеспечить устойчивость к изменениям в бизнес‑логике?**
Использовать модульную архитектуру, контрактную эволюцию схем через AsyncAPI и версионирование, а также идти по пути идемпотентной обработки и детализированного тестирования на совместимость.
- Вопрос: Какую роль играет маршрутизация по разделам топика?**
Разделы позволяют распараллелить обработку и локализовать проблемы конкретной тематики. Это существенно ускоряет обработку и упрощает масштабирование конвейера, особенно в больших системах.
- Вопрос: Какие шаги следует предпринять для перехода на FastStream в существующей системе?**
Разработать план миграции с поэтапной интеграцией: определить целевые топики и схемы, внедрить брокер‑интерфейс поверх существующих клиентов Kafka, реализовать пробную волну продюсеров и потребителей через декораторы, и затем постепенно расширять функциональность и покрывать тестами.
- Вопрос: Какие потенциальные направления развития FastStream?**
Расширение поддержки бинарных форматов, углубление интеграции с OpenTelemetry и мониторингом, улучшение инструментов для evolutions схем, поддержка большего числа транспортов и брокеров, улучшение инструментов для тестирования контрактов и эффективного управления производительностью на больших кластерах.
- Вопрос: Можно ли использовать FastStream без Kafka?**
Да, FastStream поддерживает другие брокеры, такие как RabbitMQ, NATS и Redis. Архитектура основана на абстракции брокера, поэтому можно разворачивать конвейер на любом поддерживаемом транспорте, не меняя бизнес‑логики.
- Вопрос: Как обеспечить тестируемость продюсеров и потребителей?**
В рамках FastStream можно писать модульные тесты, которые проверяют обработку сообщений в рамках внутрифреймворочного контекста и контрактов, а также тестировать совместимость между продюсерами и потребителями через Mock‑клиентов и стенды AsyncAPI.
- Вопрос: Что является ключевым фактором успеха внедрения FastStream в организацию?**
Четко определенная архитектура, единые контракты и схемы данных, автоматизированная документация AsyncAPI, надёжная интеграция с существующим стеком Kafka и безопасная инфраструктура, поддерживаемая командой эксплуатации.
- Вопрос: Какие шаги помогут сохранить качество данных при развитии конвейера?**
Внедрить строгие политики версии схем, тестирование на обратную совместимость, идемпотентность обработчиков, мониторинг задержек и ошибок, а также процесс непрерывной интеграции и тестирования контрактов AsyncAPI.
Этот набор вопросов и ответов суммирует ключевые принципы и практические аспекты применения FastStream в связке с Apache Kafka, а также отражает способы развития и поддержки конвейеров в современных корпоративных условиях.
Примечание для руководителей и архитекторов: переход к FastStream в сочетании с Kafka - это эволюционный шаг, который позволяет единообразно управлять бизнес‑логикой потоков данных и обеспечивать гибкость в условиях быстро меняющихся требований. Ваша задача - определить оптимальные разделы топиков, политики ретраев и схемы данных, чтобы конвейер был не только эффективным, но и управляемым на протяжении всего жизненного цикла продукта.