

Интеграция и продакшен‑внедрение LLM в прикладных системах: модели Cloud.ru, OpenAI‑совместимый API и сравнительный анализ LangChain, LlamaIndex, CrewAI и Semantic Kernel
Аннотация и целеполагание исследования
Цель статьи - дать архитекторам, руководителям data‑направлений и техническим лидерам целостную методологию продакшен‑интеграции больших языковых моделей (LLM) в корпоративные приложения. Мы рассматриваем модели Cloud.ru Evolution Foundation Models через OpenAI‑совместимый API, а также четыре ключевых фреймворка: LangChain, LlamaIndex, CrewAI и Semantic Kernel. В фокусе - критерии выбора моделей и стеков, особенности настройки окружения и безопасности, паттерны RAG (Retrieval‑Augmented Generation), мультиагентные сценарии, эксплуатационные метрики и требования соответствия. Статья сочетает теоретическую основу и практические фрагменты конфигурации, позволяя перейти от прототипа к промышленной эксплуатации с измеримым качеством и управляемой стоимостью.
Введение: роль фреймворков интеграции LLM в прикладных системах
LLM уже стали стандартным компонентом бизнес‑продуктов - от ассистентов поддержки до аналитических конвейеров и систем принятия решений. Однако сама по себе модель не создает ценности: критично уметь воспроизводимо подключать ее к прикладным сервисам, соединять с внутренними данными, управлять контекстом и безопасностью, а также обеспечивать наблюдаемость и контроль затрат. Именно здесь фреймворки интеграции дают архитектурные преимущества:
- LangChain - универсальный «конструктор» цепочек и инструментальная база для памяти и инструментов.
- LlamaIndex - специализация на RAG, индексации и поиске по корпоративным данным.
- CrewAI - декларативная мультиагентность, удобная для моделирования бизнес‑процессов.
- Semantic Kernel - enterprise‑ориентированное ядро с асинхронными агентами и телеметрией для .NET и Python.
Дальнейшие разделы строятся по принципу «от стратегии к реализации»: от выбора модели и политики безопасности до конкретных примеров конфигурации и производственных метрик.
Обзор Cloud.ru Evolution Foundation Models и OpenAI‑совместимого API
Cloud.ru Evolution Foundation Models предоставляет доступ к семействам современных открытых моделей через OpenAI‑совместимый интерфейс, что позволяет:
- быстро перенести существующий код, просто заменив endpoint и ключи;
- использовать привычные клиенты и SDK (OpenAI, LangChain, LlamaIndex и др.);
- унифицировать работу с чат‑генерацией и эмбеддингами.
Ключевые особенности:
- Базовый endpoint: https://foundation-models.api.cloud.ru/v1
- Модели: линейка RuadaptQwen2.5 и другие совместимые open‑source модели.
- Поддержка сценариев: чат‑комплишены, эмбеддинги, RAG‑интеграция, мультиагентность.
- Управление параметрами генерации: температура, максимальные токены, штрафы повторов.
За счет OpenAI‑совместимого API перенос приложений сводится к изменению BASE_URL и API‑ключей, что радикально сокращает TTM (time‑to‑market) без переписывания архитектуры.
Подготовка окружения: сервисные аккаунты, API‑ключи, BASE_URL, .env и параметры генерации
Пошаговая процедура для Cloud.ru Evolution:
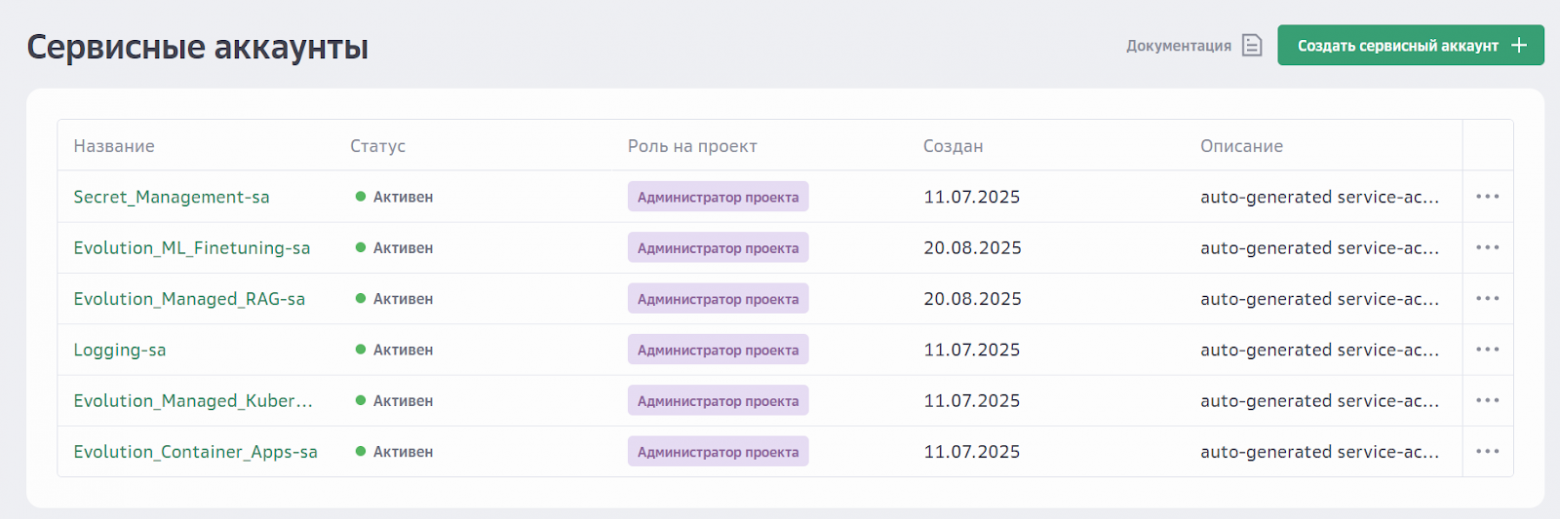
- Создайте сервисный аккаунт: раздел «Пользователи → Сервисные аккаунты → Создать».
- Выпустите API‑ключ: вкладка «API‑ключи → Создать API‑ключ».
- Зафиксируйте параметры:
- BASE_URL: https://foundation-models.api.cloud.ru/v1
- API_KEY: сгенерированный ключ
- MODEL_NAME: точное имя выбранной модели из интерфейса
Рекомендуем хранить конфигурацию в .env:
## .env

API_KEY=xxxxxxxxxxxxxxxx
BASE_URL=https://foundation-models.api.cloud.ru/v1
MODEL_NAME=RuadaptQwen2.5-7B-Lite-Beta
TEMPERATURE=0.2
MAX_TOKENS=1024
Подключение в Python (пример с LangChain/OpenAI‑совместимым клиентом):
from dotenv import load_dotenv
import os
from langchain_openai import ChatOpenAI

load_dotenv()

llm = ChatOpenAI(
    openai_api_key=os.getenv("API_KEY"),
    openai_api_base=os.getenv("BASE_URL"),
    model_name=os.getenv("MODEL_NAME"),
    temperature=float(os.getenv("TEMPERATURE", "0.2")),
    max_tokens=int(os.getenv("MAX_TOKENS", "1024")),
)
Аналогично для .NET используйте переменные окружения и Secret Store. Такой подход минимизирует риск утечки секретов и упрощает деплой в разных средах (dev/stage/prod).
Теоретическая база: языковые модели, контекстные окна, температура, токены, эмбеддинги, RAG и мультиагентность
- LLM (Large Language Model) - вероятностная модель, обученная предсказывать токены. Способна к обобщению, но требует контроля источников знаний.
- Контекстное окно - максимальный объем токенов в одном запросе (сумма системных инструкций, истории, пользовательского ввода и ответа). От него зависят стиль prompting, длина памяти и стоимость.
- Температура - регулирует стохастичность: ниже - детерминированнее, выше - креативнее. Для аналитики и инструктивных задач рекомендуется 0.1-0.3.
- Токены - элементарные единицы текста (байт‑пары/сабворды). Стоимость и латентность прямо зависят от количества токенов ввода/вывода.
- Эмбеддинги - векторные представления текста для семантического поиска и кластеризации.
- RAG - совмещение генерации с внешним поиском по базе знаний. Уменьшает галлюцинации и актуализирует ответы.
- Мультиагентность - разбиение задачи на несколько ролей/агентов с маршрутизацией контекста и обменом результатами. Улучшает разложение сложных проблем и качество планирования.
Правильная комбинация этих элементов - основа надежной и экономичной продакшен‑архитектуры.
Критерии выбора модели под сценарий: скорость, контекст, способности к рассуждению и стоимость
- Скорость генерации: критична для чатов и интерактивных UI. Малые модели выигрывают в задержке.
- Объем контекста: важен для длинных диалогов, многошаговых рассуждений, сложных RAG‑подсказок.
- Способности к рассуждению: требуются в мультиагентных сценариях, планировании, код‑ассистах.
- Стоимость: рассчитывается по токенам. RAG‑сценарии позволяют держать модель меньшего размера и переносить «понимание» в эмбеддинги и поиск.
Общая эвристика: для простых чат‑ботов/FAQ и RAG‑ответов - компактные модели; для сложного планирования и координации - крупные модели с большим контекстом.
Рекомендации по моделям RuadaptQwen2.5: 7B Lite для чат‑ботов и RAG, 32B Pro для мультиагентных систем
-
RuadaptQwen2.5‑7B‑Lite‑Beta:
- высокая скорость и отзывчивость;
- оптимальна для чат‑ботов с короткой памятью, а также RAG, где основная «интеллектуальность» вынесена в поиск и индексацию;
- экономична по токенам и времени.
-
RuadaptQwen2.5‑32B‑Pro‑Beta:
- расширенные способности к рассуждению и планированию;
- увеличенное окно контекста - лучше для координации агентов и сложных подсказок;
- предпочтительна в CrewAI и Semantic Kernel для бизнес‑процессов и аналитических пайплайнов.
Такой дуальный выбор позволяет сбалансировать стоимость и качество, разгрузив сложные задачи туда, где это обосновано.
Интеграция технологических стеков и их синергия: Python и .NET, асинхронность, FAISS, Object Storage и OpenAI Compatible
- Python - быстрая прототипизация, зрелая экосистема для NLP, FAISS, LangChain/LlamaIndex/CrewAI.
- .NET - enterprise‑интеграции, строгая типизация, богатая телеметрия, удобная эксплуатация в Windows/Azure/он‑прем.
- Асинхронность - обязательна для UI‑реактивности и масштабирования I/O‑нагрузок. В Python - asyncio/uvloop; в .NET - async/await.
- FAISS - де‑факто стандарт для векторного поиска в он‑прем/VM; обеспечивает быстрый топ‑k поиск и компромиссы по памяти.
- Object Storage - долговременное хранение исходных документов и артефактов индексации; упрощает бэкапы и версионирование.
- OpenAI‑совместимый API - единая абстракция клиента во всех фреймворках, снижающая риски вендор‑локина и ускоряющая миграции.
Синергия достигается при четком разделении ответственности: данные и индексы - в Object Storage/БД, поиск - FAISS/управляемый RAG, оркестрация - фреймворк и очереди событий.
Паттерны управления конфигурацией и секретами: переменные окружения, политика доступа и rate limiting
- Переменные окружения и Secret Store (Vault/KMS): ключи не коммитятся в VCS, применяются только на уровне среды.
- Политика доступа: минимальные привилегии (least privilege), отдельные сервисные аккаунты per‑service, токены ограниченного срока.
- Ротация и аудит: автоматическая смена ключей, логирование использования, детект аномалий.
- Rate limiting и квоты: backoff (экспоненциальный), джиттер, очереди, «токен‑ведра» на сервис/пользователя.
- Circuit breaker и идемпотентность: предотвращение каскадных сбоев; ретраи с дедупликацией.
- Конфигурация моделей: храните параметры генерации в централизованном storage (конфигурационный сервис) с версионированием.
Такие практики повышают надежность и управляемость при росте нагрузки и команд.
LangChain: концепция цепочек, механизм памяти и промпт‑инжиниринг
Ядро LangChain - «цепочки» (chains), где каждый шаг - промпт, вызов инструмента, пост‑обработка - соединяется в поток. Память (Memory) обеспечивает учет истории диалогов: от буфера последних сообщений до резюмирующей памяти.
Ключ к качеству - системные инструкции (system prompt)и дисциплина подсказок. Четкие роли, ограничения на домыслы и структура ответа снижают вариативность и риск галлюцинаций. Рекомендуется политика «спроси уточнение при недостатке контекста».
LangChain: декомпозиция компонентов (LLM, Memory, PromptTemplate, Chain) и их взаимодействие
- LLM: абстракция модели (в т.ч. через ChatOpenAI для OpenAI‑совместимого API).
- Memory: ConversationBufferMemory, ConversationSummaryMemory, комбинированные варианты.
- PromptTemplate/ChatPromptTemplate: параметризуемые шаблоны с подстановкой переменных и истории.
- Chain/ConversationChain: связывает LLM, Memory и Prompt в исполняемый граф.
Поток: вход → актуализация памяти → форматирование промпта → вызов модели → сохранение ответа → выход.
LangChain: реализация чат‑бота с контекстом - системный промпт, sliding window и ConversationChain
Пример настройки «скользящего окна» (k=8) и строгого системного промпта:
from langchain_openai import ChatOpenAI
from langchain.chains import ConversationChain
from langchain.memory import ConversationBufferWindowMemory
from langchain.prompts import ChatPromptTemplate, SystemMessagePromptTemplate, HumanMessagePromptTemplate

system_prompt = """Вы — надежный и точный AI-ассистент. Опирайтесь только на вход и диалоговую память.
Запрашивайте уточнения при нехватке контекста. Не выдумывайте факты. Структурируйте ответы лаконично."""

memory = ConversationBufferWindowMemory(
    k=8, memory_key="history", return_messages=True
)

prompt_template = ChatPromptTemplate.from_messages([
    SystemMessagePromptTemplate.from_template(system_prompt),
    HumanMessagePromptTemplate.from_template("{user_input}")
])

chain = ConversationChain(
    llm=llm,
    memory=memory,
    prompt=prompt_template,
    input_key="user_input",
    verbose=False
)
Такая схема удерживает контекст без перерасхода токенов и дисциплинирует стиль ответа.
LangChain: лучшие практики и расширения (резюмирующая память, инструменты, композиция через LangGraph)
- Резюмирующая память: периодически сворачивает историю в краткое резюме, освобождая контекстное окно.
- Инструменты (Tools): подключение поиска, БД, API, кода; LLM принимает решения, чем воспользоваться.
- LangGraph: композиция сложных графов с ветвлениями и обратной связью; удобен для сложных workflows.
- Контроль домыслов: системные запреты на галлюцинации, RAG‑подсказки с явным контекстом, валидация ссылок.
Используйте тестовые «контрольные сессии» и метрики качества памяти (процент корректно восстановленного контекста).
LlamaIndex: принципы Retrieval‑Augmented Generation и построение векторных индексов
LlamaIndex выращен из практики RAG: загрузка данных → разбиение на чанки → эмбеддинги → индекс → семантический поиск → генерация ответа. Сильные стороны - простота API и гибкая конфигурация пайплайна. Он снимает рутину организации векторных индексов из файлов, БД, web‑источников и Object Storage.
Основная идея - ответ строится не «из головы» модели, а на основе найденных релевантных фрагментов.
LlamaIndex: декомпозиция пайплайна (загрузка, чанкинг, эмбеддинги, FAISS, семантический поиск, генерация)
- Загрузка: коннекторы для локальных директорий, S3‑совместимых хранилищ, SQL/NoSQL.
- Чанкинг: фиксированный размер, по заголовкам, семантический сплит.
- Эмбеддинги: выбор модели эмбеддингов (русскоязычные/многоязычные) для лучшего семантического соответствия.
- Индекс: FAISS/Annoy/ScaNN или встроенные провайдеры.
- Поиск: top‑k, фильтры по метаданным, reranking.
- Генерация: строгий системный промпт «отвечать по данным контекста».
LlamaIndex: практическая реализация на локальной коллекции и настройка поиска top‑k
Пример легковесной реализации на FAISS:
from pathlib import Path
import faiss
from sentence_transformers import SentenceTransformer
from openai import OpenAI

## DATA_DIR = "./data"

embedding_model = SentenceTransformer("intfloat/multilingual-e5-base")
client = OpenAI(api_key=os.getenv("API_KEY"), base_url=os.getenv("BASE_URL"))
MODEL_NAME = os.getenv("MODEL_NAME")

def load_files_from_dir(dir_path=DATA_DIR):
    texts = []
    for file_path in Path(dir_path).glob("*.txt"):
        with open(file_path, encoding="utf-8", errors="replace") as f:
            texts.append(f.read())
    return texts

def create_faiss_index(documents):
    embs = embedding_model.encode(documents, convert_to_numpy=True).astype("float32")
    index = faiss.IndexFlatL2(embs.shape[1])
    index.add(embs)
    return index

def search_documents(query, index, documents, top_k=3):
    q = embedding_model.encode([query], convert_to_numpy=True).astype("float32")
    distances, indices = index.search(q, top_k)
    return [documents[i] for i in indices[0] if i Регулируйте top‑k для компромисса «полнота/шум». Для длинных документов используйте агрегацию чанков и пост‑обработку.

LlamaIndex: оптимизация качества и управление контекстом (prompting, фильтрация, пост‑обработка)
- Prompting: явно запрещайте домыслы; просите указать «недостаточно контекста» при нехватке данных.
- Фильтрация: по метаданным (дата, источник, тип документа), confidence‑порог для эмбеддингов.
- Reranking: легковесные cross‑encoder модели для переранжирования top‑k.
- Пост‑обработка: дедупликация фрагментов, цитирование источников, валидация ссылок.
- Контекст: суммаризация и «окна» по чанкам, чтобы не переполнять окно модели.
Такой стек повышает точность и снижает долю галлюцинаций.
CrewAI: декларативная мультиагентность - роли, цели, backstory, задачи и «экипаж»
CrewAI формализует роли, целии предысториюагентов, а также их задачи (Task) и «экипаж» (Crew). Декларативный стиль хорошо отражает оргструктуру и процессы: исследователь → писатель → верификатор.
from crewai import Agent, Task, Crew
from openai import OpenAI

llm = OpenAI(api_key=os.getenv("API_KEY"), base_url=os.getenv("BASE_URL"))

researcher = Agent(
    role="Исследователь",
    goal="Провести структурированный анализ применения ИИ в российском бизнесе (2023–2025).",
    backstory="Эксперт-аналитик, проверяет источники, избегает домыслов.",
    llm=llm, verbose=True
)

writer = Agent(
    role="Технический писатель",
    goal="Подготовить краткий бизнес-отчет на основе анализа.",
    backstory="Пишет лаконично, понятно для руководителей.",
    llm=llm, verbose=True
)
Такое разделение обязанностей делает сложные задания управляемыми и воспроизводимыми.
CrewAI: архитектурные компоненты, маршрутизация задач и передача контекста; интеграция с провайдерами
- Компоненты: Agent, Task, Crew, контекст и планировщик.
- Маршрутизация: порядок задач, условные ветвления, передача результатов в контекст следующего шага.
- Провайдеры: OpenAI‑совместимые LLM (достаточно корректного имени модели и base_url).
- Контроль качества: валидация результатов между задачами, «стоп‑условия», ограничители по длине/времени.
При разработке учитывайте границы контекста и агрегацию итогов между агентами.
Semantic Kernel: архитектура ядра, адаптеры сервисов, асинхронные агенты и телеметрия
Semantic Kernel (SK) - ядро для оркестрации агентов и инструментов. Ключевая идея - адаптер сервисов (переводчики), выравнивающие внешние API под единую модель SK. Особенности:
- Асинхронные агенты (ChatCompletionAgent) и неблокирующие вызовы.
- Единый Kernel для регистрации сервисов, инструментов (skills) и памяти.
- Телеметрия и трассировка: интеграция с OpenTelemetry/ActivitySource.
- Параллелизм: удобен для сценариев с несколькими независимыми ветками.
Semantic Kernel: декомпозиция реализации (ChatCompletionClientBase, ChatCompletionAgent, invoke) и неблокирующие паттерны
Пример адаптера и агента с неблокирующим вызовом:
import asyncio
from semantic_kernel.connectors.ai.chat_completion_client_base import ChatCompletionClientBase
from semantic_kernel.contents import ChatHistory, ChatMessageContent
from semantic_kernel.prompt_template import PromptExecutionSettings
from semantic_kernel.agents import ChatCompletionAgent
from openai import OpenAI

class AgentService(ChatCompletionClientBase):
    def __init__(self, service_id: str, model: str, api_key: str, base_url: str):
        super().__init__(service_id=service_id, ai_model_id=model)
        self._client = OpenAI(api_key=api_key, base_url=base_url)
        self._model = model

    async def get_chat_message_contents(self, chat_history: ChatHistory, settings: PromptExecutionSettings, **_):
        messages = [{"role": m.role.value, "content": str(m.content)} for m in chat_history.messages]
        resp = await asyncio.to_thread(
            self._client.chat.completions.create,
            model=self._model, messages=messages,
            temperature=settings.temperature or 0.2,
            max_tokens=settings.max_tokens or 512
        )
        return [ChatMessageContent(role="assistant", content=resp.choices[0].message.content)]
Неблокирующая интеграция через asyncio.to_thread сохраняет отзывчивость цикла и позволяет масштабировать I/O.
Сравнительный анализ и критерии выбора: универсальность, RAG‑фокус, мультиагентность, enterprise‑ориентация
| Критерий | LangChain | LlamaIndex | CrewAI | Semantic Kernel |
|---|---|---|---|---|
| Универсальность | Высокая: цепочки, память, инструм. | Средняя: фокус на RAG | Средняя: фокус на мультиагентах | Высокая: агенты, инструм., память |
| RAG | Поддерживается, требуется сборка | Сильная сторона, удобный пайплайн | Через интеграции | Внутри SK или внешние компоненты |
| Мультиагентность | Через надстройки (LangGraph) | Ограниченно | Сильная сторона (декларативная) | Сильная сторона (асинхронные агенты) |
| Enterprise‑ориентация | Средняя | Средняя/высокая для данных | Средняя | Высокая (.NET, телеметрия, асинхронность) |
| Порог входа | Умеренный | Низкий для RAG | Умеренный | Умеренный/высокий для .NET экосистемы |
| Экосистема | Очень активная | Активная | Растущая | Стабильная в enterprise |
Выбор зависит от доминирующего сценария: быстрые MVP и гибридные цепочки - LangChain; корпоративный поиск - LlamaIndex; процессы с ролями - CrewAI; интеграция в .NET‑ландшафт - Semantic Kernel.
Конкурентный ландшафт: Haystack, AutoGen, DSPy, Guidance, LangGraph и их дифференциация
- Haystack - зрелый RAG‑фреймворк с сильной поддержкой пайплайнов, коннекторов и продакшен‑шаблонов.
- AutoGen - мультиагентная среда с акцентом на взаимодействие LLM‑LLM и инструментов.
- DSPy - декларативная оптимизация подсказок и программирование «через спецификации».
- Guidance - точный контроль генерации с шаблонами и грамматиками.
- LangGraph - графовая оркестрация поверх LangChain, удобна для сложных ветвлений.
Эти инструменты полезны как дополнения или альтернативы в узких задачах (тонкая настройка подсказок, формальные грамматики, автономные агенты).
Управляемые сервисы Cloud.ru: Managed RAG и Object Storage как альтернатива собственной реализации
Для ускорения внедрения и снижения операционных рисков используйте:
- Managed RAG - управляемый сервис построения индексов, поиска и интеграции с LLM. Сокращает кодовую базу и время на эксплуатацию.
- Object Storage - центральное хранилище документов любых форматов; интеграция с пайплайнами индексации, контроль версий и прав доступа.
Такой подход особенно рационален при больших корпусах документов, требующих регулярной переиндексации и строгого управления доступом.
Сценарии применения по секторам экономики: финтех, ритейл и e‑commerce, телеком, промышленность, здравоохранение, госсектор
- Финтех: ассистенты комплаенса, разбор продуктовой документации, генерация объяснимых ответов клиентам, анализ регуляторных писем.
- Ритейл/e‑commerce: поиск по каталогам и политикам возврата, персонализированные подсказки, автоматизация категоризации и описаний.
- Телеком: интеллектуальные чат‑каналы поддержки, анализ SLA и логов, ассистенты для инженеров NOC.
- Промышленность: поиск по техдокументации, поддержка ТОиР, синтез отчетов из полевых данных.
- Здравоохранение: поиск по клиническим протоколам и терминологическим справочникам, ассистенты для регистратур (с соблюдением требований безопасности).
- Госсектор: навигация по нормативной базе, формирование справок и инструкций, гражданские сервисы с RAG‑подстраховкой.
Во всех отраслях ключевое - минимизировать домыслы и логировать обоснования ответа.
Архитектурные паттерны внедрения: web‑интеграция, микросервисы, серверлесс, потоковая генерация и очереди событий
- Web‑интеграция: легкие API‑шлюзы с SSE/WebSocket для потоковой генерации, кэширование горячих запросов.
- Микросервисы: отдельные сервисы для LLM, эмбеддингов, индексов; контрактные API и независимый скейлинг.
- Серверлесс: асинхронная обработка батчевых задач (индексация, ретренировки эмбеддингов).
- Потоковая генерация: улучшает UX, позволяет отмену и динамическую маршрутизацию.
- Очереди событий: back‑pressure, ретраи и изоляция скачков нагрузки (Kafka/RabbitMQ).
Комбинирование паттернов повышает надежность и управляемость под разными SLA.
Метрики эффективности и методики оценки: латентность, пропускная способность, стоимость на 1000 токенов, accuracy@k, RAG‑recall, доля галлюцинаций
- Латентность (p50/p95): время от запроса до начала/окончания ответа; для UI критичен p95.
- Пропускная способность (RPS/QPS): количество успешных запросов в секунду при целевом p95.
- Стоимость/1000 токенов: совокупная стоимость ввода и вывода в разрезе модели и сценариев.
- accuracy@k: доля корректных ответов среди топ‑k кандидатов (для QA‑сценариев).
- RAG‑recall: доля релевантных фрагментов, попавших в контекст, от всех релевантных.
- Доля галлюцинаций: процент ответов с фактическими ошибками или без опоры на контекст.
Практика: создайте эталонный набор запросов (golden set), автоматизируйте прогон и отчетность, привяжите метрики к регресс‑тестам и CI.
Риски, уязвимости и ограничения: prompt‑injection, утечки, дрейф знаний, лимиты контекста; стратегии смягчения
- Prompt‑injection: изоляция пользовательского ввода, «no‑override» системных инструкций, контент‑фильтры.
- Утечки: строгое разграничение памяти, запрет на раскрытие скрытых инструкций и приватных данных.
- Дрейф знаний: регулярная переиндексация, контроль версий источников, дата‑фильтры.
- Лимиты контекста: резюмирование, top‑k с reranking, структурированные ответы.
- Злоупотребления API: rate limiting, детект аномалий, ключи per‑client.
- Юридические риски: валидация цитат и источников; запрет генерации чувствительных данных без оснований.
Комбинируйте организационные и технические меры; проводите красные команды (red teaming) по подсказкам.
Безопасность и соответствие требованиям: шифрование, контроль доступа, аудит, соответствие 152‑ФЗ и отраслевым стандартам
- Шифрование: TLS для транзита, KMS/Vault для хранения секретов и ключей, шифрование бакетов Object Storage.
- Доступ: RBAC/ABAC, принцип наименьших привилегий, сегментация сетей, отдельные VPC/проекты.
- Аудит: централизованные логи, неизменяемые хранилища, SIEM‑интеграция.
- 152‑ФЗ и отраслевые стандарты: категоризация ПДн, правовые основания обработки, локализация хранения, DPIA/оценка рисков.
- Управление инцидентами: планы реагирования, учения, каналы эскалации.
Соблюдение комплаенса - условие доступа к данным в реальных корпоративных средах.
Практические кейсы: чат‑поддержка, корпоративная вики, аналитические отчеты, ассистенты для специалистов
- Чат‑поддержка: LangChain + 7B Lite + резюмирующая память; RAG поверх базы знаний; потоковая генерация в UI.
- Корпоративная вики: LlamaIndex + FAISS или Managed RAG; эмбеддинги с доменной адаптацией; контроль цитирования.
- Аналитические отчеты: CrewAI или Semantic Kernel с 32B Pro; роли «исследователь/писатель/верификатор»; журнал источников.
- Ассистенты специалистов: поиск по инструкциям и нормам, чек‑листы, генерация объяснимых рекомендаций с явными ссылками.
Во всех кейсах применяйте строгий системный промпт и логи обоснований.
От POC к production: обработка ошибок, логирование, мониторинг, тестирование, CI/CD и observability
- Обработка ошибок: ретраи с backoff, таймауты, лимиты длины подсказок, предикаты повторной генерации.
- Логирование: структурированные логи запросов/ответов/токенов; защита персональных данных (редакция PII).
- Наблюдаемость: трассировка (OpenTelemetry), метрики (Prometheus), дашборды (Grafana), алерты SLO.
- Тестирование: синтетические и регрессионные наборы подсказок; метрики качества в CI; канареечные релизы.
- CI/CD: версионирование подсказок и конфигураций, миграции индексов, тесты производительности перед релизом.
- Управление моделями: feature‑флаги для переключения моделей, A/B‑тесты, контроль стоимости.
Такой конвейер позволяет безопасно эволюционировать решения без деградаций.
Заключение и ключевые выводы; приложения (репозитории, конфигурации, шаблоны промптов, чек‑листы)
Интеграция LLM сегодня - это не только выбор модели, но и архитектуравзаимодействия: дисциплинированные подсказки, управление контекстом, безопасная работа с данными, наблюдаемость и метрики качества. OpenAI‑совместимый API Cloud.ru упрощает перенос и снижает риски вендор‑локина. На уровне фреймворков:
- LangChain - универсальный инструмент для цепочек и быстрых MVP.
- LlamaIndex - оптимальный выбор для RAG‑систем поверх корпоративных данных.
- CrewAI - декларативное моделирование мультиагентных бизнес‑процессов.
- Semantic Kernel - enterprise‑ядро с асинхронными агентами и телеметрией, особенно уместно в .NET‑ландшафте.
Рекомендации по моделям: RuadaptQwen2.5‑7B‑Liteдля чат‑ботов и RAG; RuadaptQwen2.5‑32B‑Proдля мультиагентных и многошаговых рассуждений. Усильте архитектуру управляемыми сервисами Cloud.ru: Managed RAG и Object Storage. Применяйте строгие практики безопасности и комплаенса, заводите метрики и автоматические тесты качества - и вы получите масштабируемую, экономичную и объяснимую систему.
Приложения (для самостоятельной адаптации):
- Примеры конфигурации: .env, Docker‑секреты, Helm‑values.
- Шаблоны промптов: системные инструкции «без домыслов», RAG‑шаблоны с цитированием.
- Чек‑листы: безопасность и комплаенс, нагрузочное тестирование, качество RAG.
Вопрос‑Ответ:
-
Вопрос: Зачем использовать OpenAI‑совместимый API Cloud.ru?
Ответ: Он позволяет перенести существующий код практически без изменений, сократив интеграцию к замене BASE_URL и ключа. Это ускоряет внедрение и снижает риски. -
Вопрос: Как выбрать модель под сценарий?
Ответ: Ориентируйтесь на скорость, размер контекста, способности к рассуждению и стоимость. 7B Lite - для чатов и RAG; 32B Pro - для мультиагентности и сложных рассуждений. -
Вопрос: Чем отличаются LangChain, LlamaIndex, CrewAI и Semantic Kernel?
Ответ: LangChain - универсальные цепочки; LlamaIndex - RAG и индексы; CrewAI - декларативные мультиагенты; Semantic Kernel - enterprise‑ядро с асинхронными агентами и телеметрией. -
Вопрос: Как снизить галлюцинации в RAG?
Ответ: Строгий системный промпт, качественные эмбеддинги, фильтрация и reranking, суммаризация контекста, обязательное цитирование источников. -
Вопрос: Какие ключевые метрики для продакшена?
Ответ: p50/p95 латентность, пропускная способность, стоимость/1000 токенов, accuracy@k, RAG‑recall, доля галлюцинаций; все метрики автоматизируйте в CI. -
Вопрос: Как обезопасить секреты и доступы?
Ответ: Храните ключи в Secret Store, применяйте RBAC/ABAC и принцип наименьших привилегий, проводите ротацию ключей и аудит, настраивайте rate limiting и circuit breaker. -
Вопрос: Когда выбрать Managed RAG вместо собственной сборки?
Ответ: При больших объемах данных, требованиях к SLA и ограниченных ресурсах команды на эксплуатацию индексов и обновления пайплайна. -
Вопрос: Как перейти от POC к production без регрессий?
Ответ: Введите тестовые наборы подсказок, автоматизируйте метрики качества в CI/CD, применяйте канареечные релизы, observability и управление версиями подсказок и индексов.


