

Хранилище корпоративных данных: компоненты EDW, ключевые концепты и типы архитектуры
В течение дня мы принимаем множество решений, опираясь на свой предыдущий опыт. Наш мозг хранит триллионы бит данных о прошлых событиях и использует эти воспоминания каждый раз, когда мы сталкиваемся с необходимостью принять какое-либо решение. Как и люди, компании генерируют и собирают тонны данных о прошлом. И, безусловно, эти данные можно и нужно использовать для принятия наиболее эффективных решений.
В то время как наш мозг служит как для обработки, так и для хранения информации, компаниям требуется множество инструментов для работы с данными. Одних из самых востребованных на рынке инструментов является корпоративное хранилище данных или EDW.
В этой статье мы обсудим, что такое корпоративное хранилище данных, его типы и основные функции, а также то, как именно оно используется для обработки данных. Мы определим, чем корпоративные хранилища данных отличаются от обычных, какие типы хранилищ данных существуют и как они работают.
Что такое хранилище корпоративных данных?
Корпоративное хранилище данных (EDW) - это форма централизованного корпоративного хранилища, в котором хранятся все исторические бизнес-данные предприятия. Информация обычно поступает из различных систем, таких как ERP, CRM, записей и других плоских файлов. Чтобы подготовить данные к дальнейшему анализу, их необходимо поместить в единое хранилище. Таким образом, различные бизнес-подразделения смогут обращаться к агрегированным данным и анализировать информацию с разных точек зрения. Но для того чтобы любые данные превратились в действительно полезную информацию, они должны пройти долгий путь.
С помощью хранилища данных предприятие может управлять огромными массивами данных, не прибегая к администрированию нескольких баз данных. Такая практика является самым оптимальным способом хранения данных для бизнес-аналитики (BI), которая представляет собой набор методов,технологий, а также инструментов для преобразования необработанных данных в полезные сведения. Поскольку EDW является важной частью этой системы, ее вполне можно сравнить с человеческим мозгом, хранящим информацию.
Компоненты EDW
Существует несколько компонентов, используемых для создания EDW. Давайте посмотрим на каждый из них с высоты птичьего полета и разберем их основные функции.
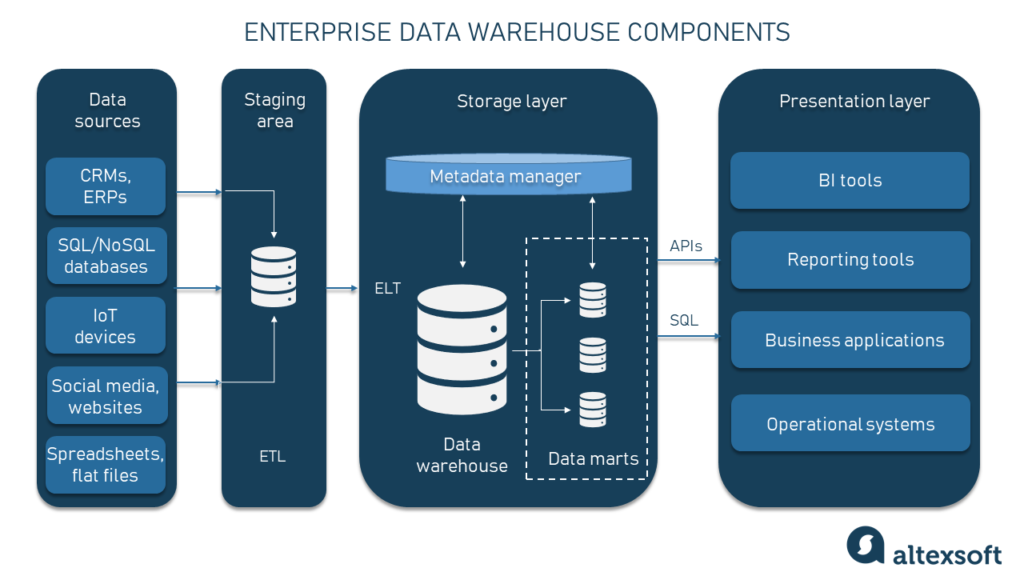
Источники данных: именно в них возникают и/или хранятся необработанные данные. Это могут быть простые электронные таблицы, плоские файлы или даже реляционные базы данных SQL, системы IoT и т. д.
Слой приема данных (Ingestion layer). Существует два основных подхода к извлечению данных из источников данных и их передаче в хранилище. Инструменты извлечения, преобразования, загрузки (ETL) и извлечения, загрузки, преобразования (ELT) подключаются ко всем исходным данным и осуществляют их извлечение, преобразование и загрузку в централизованную систему хранения (для удобства доступа к данным и их анализа). Основное различие между подходами ETL и ELT заключается в порядке основных процессов. В случае ETL преобразования происходят в Staging area, то есть до того, как данные попадают в EDW. Более современный подход, ELT, проводит все операции преобразования внутри хранилища, Staging area отсутствует.
В случае ETL Staging area - это то самое место, где данные преобразуются перед тем, как поступить в EDW. Здесь они очищаются, дедуплицируются, разделяются/объединяются и преобразуются в единый формат, соответствующий заданной модели хранилища данных. Данная область может включать в себя инструменты управления качеством данных.
Хранение (Storage layer). Итак, после сбора данные загружаются в хранилище. При использовании подхода ELT здесь может потребоваться некоторое преобразование. Как мы уже говорили, хранилища данных чаще всего представляют собой реляционные базы данных. DW также включают в себя систему управления БД и дополнительное хранилище для метаданных.
Модуль метаданных (Metadata module). Метаданные - это данные о данных или пояснения, подсказывающие пользователям/администраторам, к какому предмету/домену относится та или иная информация. Эти данные могут быть техническими метаданными (например, исходный источник) или бизнес-метаданными (например, регион продаж). Все метаданные хранятся в отдельном модуле EDW и управляются менеджером метаданных. В некоторых случаях поверх всей инфраструктуры может быть создан дополнительный слой для хранения метаданных, например слой виртуализации данных или слой структуры данных.
Витрины данных (необязательный компонент). В некоторых случаях EDW включать в себя набор более мелких подразделов, называемых витринами данных, которые создаются специально для определенной предметной области, бизнес-функции или группы пользователей. Например, отдельная витрина данных для маркетинговых целей и отдельная витрина данных для финансового отдела.
Уровень представления (Presentation layer). Последний строительный блок EDW включает в себя инструменты, предоставляющие конечным пользователям доступ к данным. Этот слой, также называемый BI-интерфейсом, служит в качестве дашборда для визуализации данных, составления бизнес-отчетов и извлечения информации для решения таких задач, как машинное обучение.
Теперь давайте разберемся в том, почему такое хранилище называется хранилищем корпоративных данных, а не просто хранилищем данных.
EDW vs обычное хранилище данных: ключевые различия
По своей сути любое хранилище данных - это база данных, которая всегда связана с источниками необработанных данных посредством инструментов интеграции данных с одной стороны и аналитическими интерфейсами с другой. Они предоставляют собой что-то вроде «емкости» для хранения данных, а также механизмы для их преобразования, перемещения и предоставления конечному пользователю. Если это так, то почему мы выделяем именно корпоративную форму?
Отличие обычного хранилища данных от EDW заключается в гораздо более широком архитектурном разнообразии и функциональности. Из-за сложной структуры и размера EDW часто декомпозируются на более мелкие базы данных, и конечным пользователям гораздо удобнее выполнять запросы именно к этим небольшим БД.
Однако не только размер хранилища определяет его техническую сложность, требования к аналитическим и отчетным возможностям, количеству моделей данных и самим данным. Поэтому, чтобы понять, что такое EDW, давайте изучим его основные концепции и функции.
Ключевые концепты и функции EDW
При всем многообразии инструментов основу любого хранилища данных составляют базовые концепции и функции. Именно эти основы определяют хранилище данных как технологический феномен.
- Служит универсальным хранилищем данных. EDW - это единое хранилище всех корпоративных бизнес-данных, существовавших когда-либо в организации.
- Отражает исходные данные. EDW получает данные из Google Analytics, CRM, IoT-устройств и т. д. Если данные «разбросаны» по нескольким системам, управлять ими невозможно. Поэтому основная цель EDW состоит в обеспечении подобия исходных данных в едином хранилище. Поскольку в компании и за ее пределами постоянно генерируются новые данные, поток данных требует специальной инфраструктуры для управления ими до того, как они попадут в хранилище.
- Хранит структурированные данные. Данные, хранящиеся в EDW, всегда стандартизированы и структурированы. Это позволяет конечным пользователям запрашивать их через BI-интерфейсы и формировать нужные отчеты. Именно этим хранилище данных отличается от озера данных. Озера данных используются для хранения неструктурированных данных. В отличие от хранилищ данных, озера данных, как правило, используются для работы с большими массивами необработанных данных.
- Предметно - ориентированные данные. Основное внимание в хранилище данных уделяется бизнес-данным, касающимся самых различных областей. Чтобы понять, к чему именно относятся те или иные данные, они всегда структурируются вокруг определенного объекта, называемого моделью данных. В качестве примера можно привести регион продаж или общий объем продаж определенного товара. Кроме того, добавляются метаданные, которые подробно объясняют, откуда взялась та или иная информации.
- Зависимость данных. Собранные данные, как правило, являются историческими, поскольку описывают события прошлого. Чтобы понять, когда и как долго происходило то или иное событие, преобладающая часть хранимой информации делится на временные периоды.
- Энерго-зависимые данные. Как только данные попали в хранилище данных, они остаются там навсегда, удалить их невозможно. Данные можно изменять или обновлять, но не удалять, по крайней мере, конечный пользователь никогда не сможет это сделать. Тем не менее раз в несколько лет можно проводить общий пересмотр данных для того, чтобы избавиться от неактуальных данных.
Опираясь на базовые принципы, рассмотрим типы EDW.
Типы EDW
Локальное EDW
Локальное EDW считается классическим вариантом EDW, при котором используются собственные локальные аппаратные и программные возможности для унифицированного хранения данных. Когда данные хранятся на физических серверах, не нужно настраивать средства интеграции данных между несколькими базами. Вместо этого EDW можно подключить к источникам данных через API и постоянно получать информацию, а также преобразовывать ее в процессе работы. Таким образом, вся работа выполняется либо в staging area (место, где данные преобразуются перед загрузкой в DW), либо в самом хранилище.
Классическое хранилище данных считается более совершенным, чем виртуальное (о котором мы поговорим ниже), поскольку в нем нет дополнительного уровня абстракции. Это значительно упрощает работу дата-инженеров и облегчает процесс создания отчетности.
Основные недостатки классического хранилища:
- дорогостоящая технологическая инфраструктура (и аппаратная составляющая, и ПО);
- необходимость найма команды дата-инженеров, а также специалистов по DevOps для того, чтобы создать платформу данных и поддерживать ее в работоспособном состоянии.
В каких случаях использовать: такой тип EDW подходит для организаций любого размера, которые хотят безопасно обрабатывать свои данные и извлекать из них максимальную пользу. Классические хранилища позволяют варьировать архитектурные стили платформы данных и масштабироваться, сохраняя при этом конфиденциальность данных.
Виртуальное EDW
Виртуальное хранилище данных - это тип EDW, используемый в качестве альтернативы классическому хранилищу. По сути, это несколько БД, соединенных межу собой виртуальным способом.
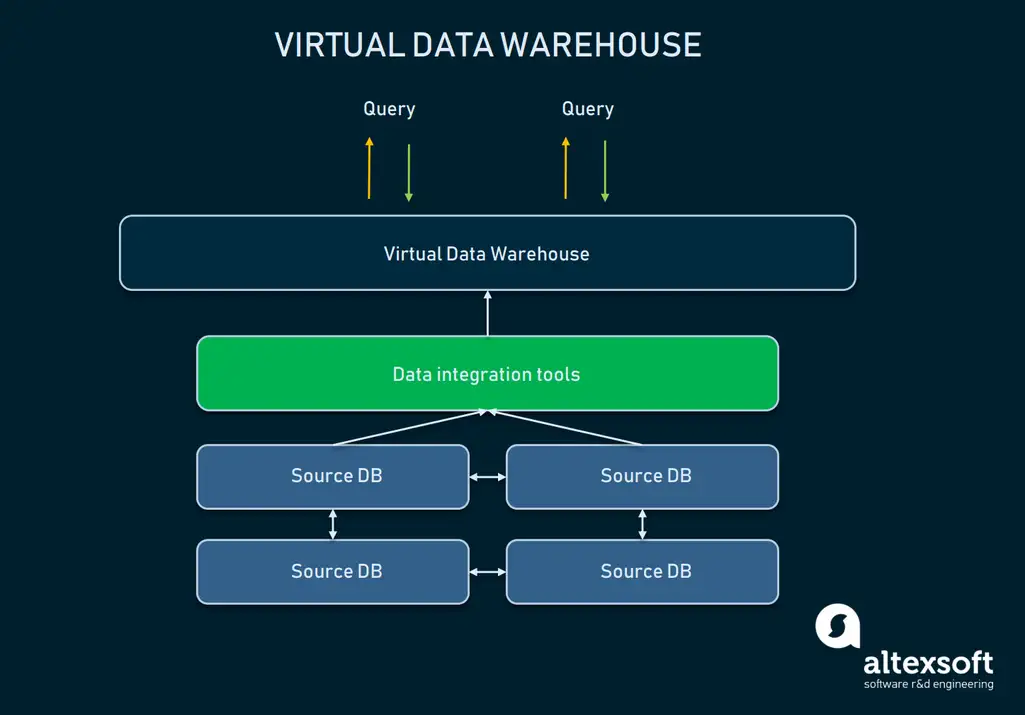
Данные могут оставаться в своих источниках: физически они никуда не перемещаются, но всегда могут быть извлечены с помощью аналитических инструментов. Виртуальные хранилища можно использовать в том случае, если Вы не хотите возиться со всей базовой инфраструктурой или если имеющиеся данные легко управляемы. Однако у такого подхода есть ряд недостатков:
- несколько баз данных требуют постоянного обслуживания и затрат на программное и аппаратное обеспечение.
- данные, хранящиеся в виртуальной DW, по-прежнему нуждаются в программном преобразовании, чтобы сделать их удобоваримыми для конечных пользователей и инструментов отчетности.
- сложные запросы к данным могут занимать слишком много времени, поскольку нужные фрагменты данных могут быть размещены в двух разных базах данных.
В каких случаях использовать: виртуальные EDW подходят для предприятий, располагающих необработанными данными в стандартизированной форме, не требующими сложной аналитики. Они также подходят организациям, которые не используют BI систематически, либо хотят начать именно с такого варианта.
Облачное EDW
Облачное хранилище данных - это центральное хранилище данных, размещенное в облаке. В этом случае база данных предоставляется облачным провайдером в качестве управляемого сервиса и оптимизирована для аналитики и масштабирования.
Облачные хранилища обычно состоят из вычислительного, хранилищного и клиентского (сервисного) уровней. На вычислительном уровне имеется несколько вычислительных кластеров с узлами, обрабатывающими запросы параллельно. На уровне хранения, как это и следует из названия, хранится информация всех типов. Клиентский слой отвечает за работу с данными.
В этом случае архитектура облачного хранилища имеет те же преимущества, что и любой другой облачный сервис. Вам не нужно создавать собственные серверы, базы данных и инструменты для управления ими. Стоимость такой услуги зависит от объема памяти и вычислительных возможностей, необходимых для выполнения запросов.
Единственный аспект, который может Вам не понравится, - это безопасность данных. Ваши бизнес-данные - это конфиденциальность информации. Поэтому крайне важно проверить, можно ли доверять выбранному поставщику или нет. Это не означает, что локальное хранилище более безопасно, но в этом случае безопасность Ваших данных находится в Ваших руках.
В каких случаях использовать: облачные EDW подходят для организаций любого размера. Они обеспечивают управляемую интеграцию данных, обслуживание DW и поддержку BI.
Архитектура EDW
Подходов к построению архитектуры хранилища данных, расширяющей его возможности, существует достаточно много. Мы же остановимся на наиболее распространенных вариантах. Не вдаваясь в излишние технические подробности, конвейер данных можно разделить на три слоя:
- Слой сырых данных;
- Хранилище и его экосистема;
- Пользовательский интерфейс (аналитические инструменты)
Инструменты, связанные с извлечением, преобразованием и загрузкой данных в хранилище, представляют собой отдельную категорию инструментов, известную как ETL. Кроме того, ETL подразумевает и инструменты интеграции данных, которые выполняют манипуляции с данными перед их перемещением в хранилище данных. Эти инструменты работают между слоем необработанных данных и хранилищем.
Когда данные загружаются в хранилище, они также могут быть преобразованы. Таким образом, хранилищу потребуется определенный функционал для очистки/стандартизации данных. Эти и другие факторы определяют сложность архитектуры хранилища данных. Предлагаю рассмотреть архитектуру EDW с точки зрения потребностей организации.
Одноуровневая архитектура
В большинстве случаев хранилище данных представляет собой реляционную базу данных с модулями, позволяющими работать с многомерными данными, или такую базу данных, которая может отделять информацию, специфичную для каждой конкретной области, в целях облегчения доступа к ней. В своей самой примитивной форме хранилище данных может иметь только одноуровневую архитектуру.
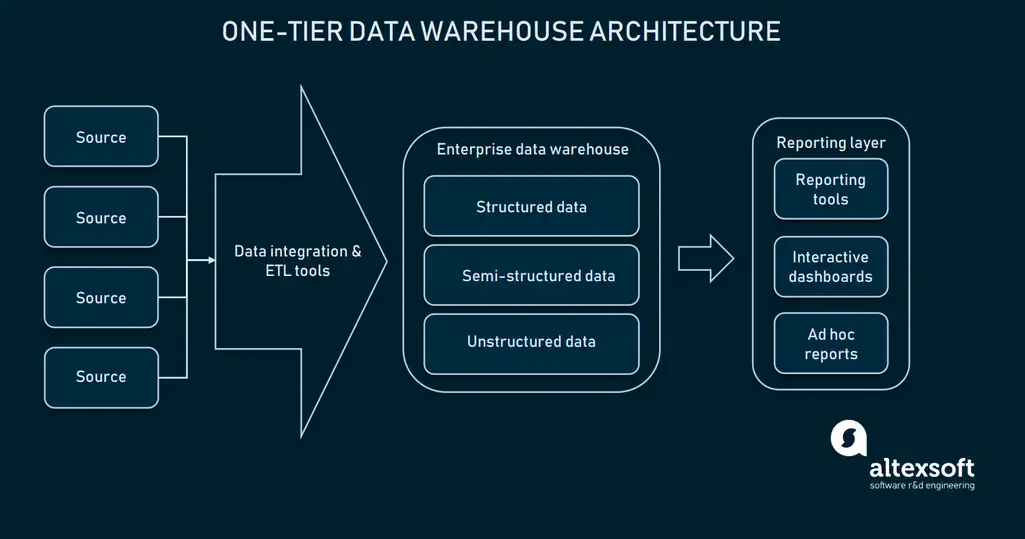
Одноуровневая архитектура EDW означает, что база данных напрямую связана с аналитическими интерфейсами, к которым конечный пользователь может делать запросы. Правда, установка прямого соединения между EDW и аналитическими инструментами сопряжена с рядом проблем:
- Традиционно хранилищем данных можно считать хранение данных объемом от 100 ГБ. Работа с ним напрямую может привести к беспорядочным результатам запросов, а также к низкой скорости обработки запросов.
- Запрос данных напрямую из DW может потребовать точного ввода, чтобы система смогла отфильтровать ненужные данные. Это в каком-то смысле затрудняет работу с инструментами представления данных.
- Ограниченная гибкость/аналитические возможности.
Кроме того, одноуровневая архитектура хранилища данных подразумевает определенные ограничения на сложность составляемой отчетности. Ввиду медлительности и непредсказуемости этот подход крайне редко используется для крупномасштабных платформ данных.
Двухуровневая архитектура (уровень витрины данных)
В двухуровневой архитектуре между пользовательским интерфейсом и EDW добавляется уровень витрины данных. Витрина данных – это простая форма хранилища данных, ориентированная на одно направление деятельности или тему (маркетинг, продажи и т.д.). С витриной данных сотрудники могут быстрее получать доступ к данным и статистическим показателям, потому что им не нужно тратить время на поиск по более сложному хранилищу данных или собирать данные из разных источников вручную.
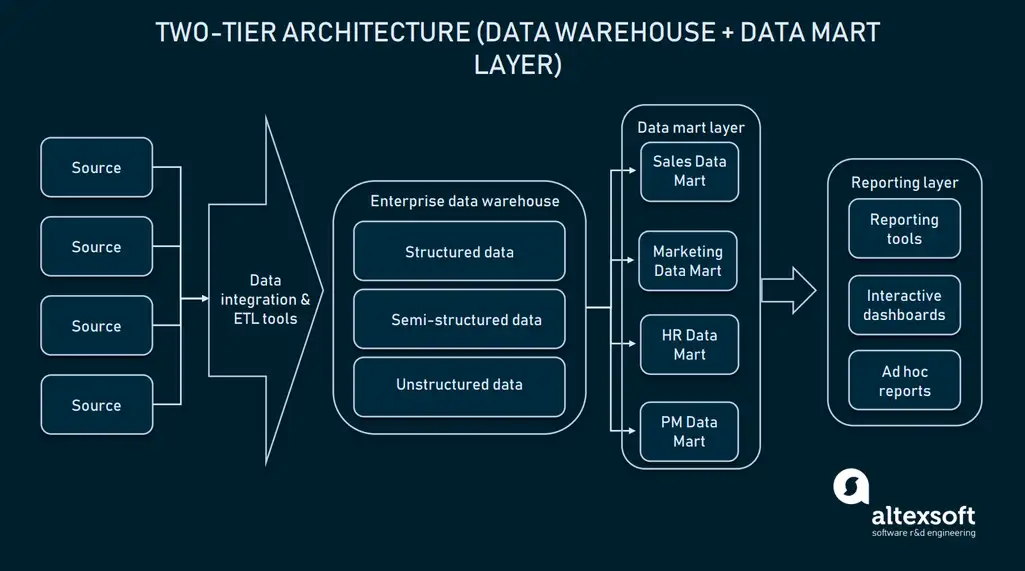
Создание слоя витрины данных требует дополнительных ресурсов на создание аппаратного обеспечения и интеграцию этих баз данных с остальной платформой данных. Однако такой подход решает проблему с запросами: каждому отделу будет проще получить доступ к нужным данным, так как в витрине будет содержаться только специфическая информация, касающаяся каждой конкретной области. Кроме того, витрины данных ограничивают доступ к данным для конечных пользователей, что делает EDW более безопасным.
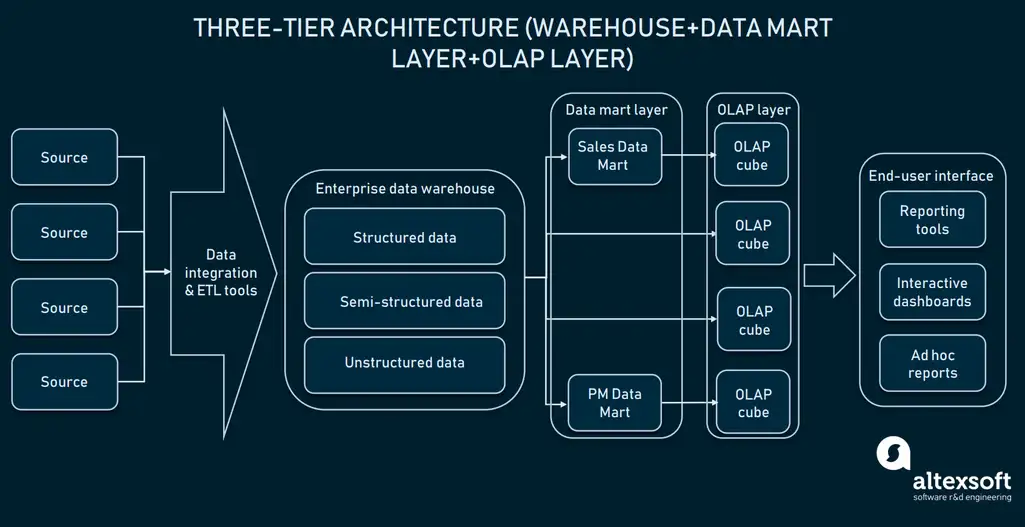
Трехуровневая архитектура (OLAP)
Поверх слоя витрины данных предприятия также часто используют OLAP-кубы. OLAP-куб – это агрегат многомерных данных. Если реляционные базы данных представляют данные только в двух измерениях (вспомните Excel или Google Sheets), то OLAP позволяет собирать данные в нескольких измерениях и свободно перемещаться между ними.
Словами это объяснить достаточно сложно, поэтому давайте посмотрим наглядное изображение того, как может выглядеть куб.

Итак, как Вы видите, куб добавляет к данным размерность. Он может быть редставлен как несколько таблиц Excel, объединенных друг с другом. Лицевая сторона куба - это обычная двумерная таблица, где по вертикали указан регион (Африка, Азия и т. д.), а по горизонтали - количество и даты продаж. Настоящее волшебство начинается тогда, когда мы смотрим на верхнюю грань куба, где продажи сегментированы по маршрутам, а внизу указан временной период. Это и есть многомерные данные.
Бизнес-ценность OLAP заключается в том, что она позволяет пользователям нарезать данные на слайсы и составлять подробные отчеты. Если кубы оптимизированы для работы с хранилищами, их можно использовать для того, чтобы обеспечить доступ ко всем корпоративным данным. Что касается реализации, то почти все поставщики хранилищ данных предлагают OLAP как услугу. В качестве примера можно привести документацию Microsoft.
Итак, мы рассмотрели основные типы архитектуры хранилища данных, теперь предлагаю изучить технические компоненты, которые может включать в себя хранилище данных.
Хранилище данных vs Озеро данных vs Витрина данных
Говоря об архитектуре хранения данных, нельзя не упомянуть такие варианты, как витрина данных и озеро данных. Их очень часто путают, поэтому давайте уточним определения.

Хранилища данных в их традиционной форме предназначены для хранения структурированных данных, представленных в виде столбцов и строк для того, чтобы инструментам запросов было проще работать, а конечные пользователи могли получать исчерпывающие результаты. Хранилища, используемые в основном для BI, обычно имеют размер от 100 ГБ до бесконечности. Они получают данные из большого количества внешних и внутренних источников, охватывающих самые разные сферы бизнеса. Если говорить о локальных хранилищах данных, то на их настройку могут уйти месяцы.
Озера данных используются для хранения огромных объемов различной информации, включая структурированные, неструктурированные и полуструктурированные данные в их родных форматах. Озера данных очень часто используются для машинного обучения или обработки больших данных. В последнее время озера данных используются для BI: необработанные данные загружаются в озеро и там преобразуются, что является альтернативой процессу ETL. Кстати, сравнительно недавно появился совершенно новый, гибридный вариант - Data Lakehouse.
Также может возникнуть некоторая путаница между хранилищем данных и витриной данных.
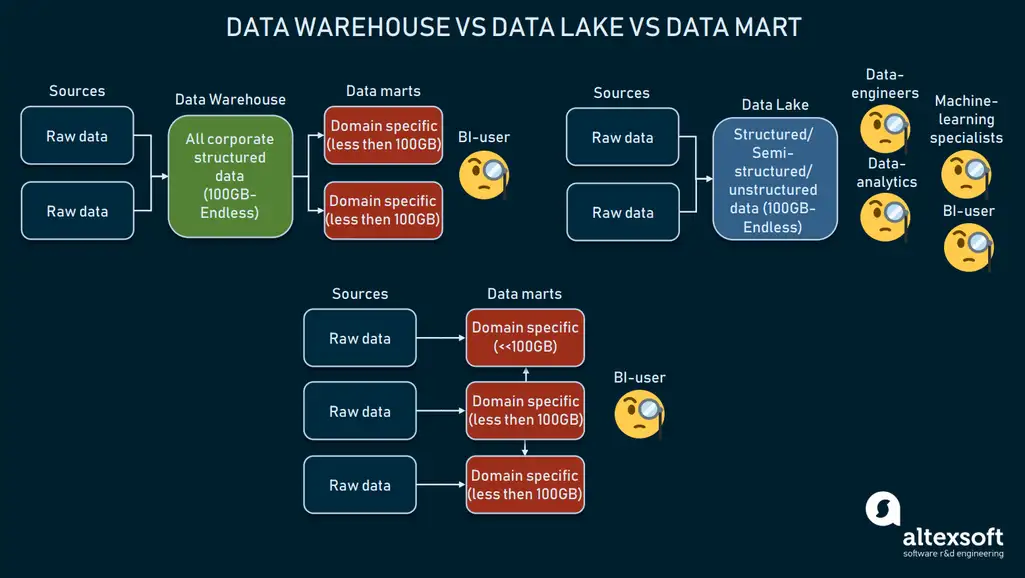
Витрины данных – это объектно-ориентированные реляционные БД, которые содержащие только определенное подмножество данных DW, относящихся к определенному отделу предприятия, например, финансовому. Они также могут использоваться в качестве альтернативы DW. Однако из-за своего небольшого размера (обычно менее 100 ГБ) витрины данных практически не используются на предприятиях. Чаще всего их используют для сегментации большого DW на более работоспособные сегменты. Витрины данных получают информацию из относительно небольшого количества источников, обычно содержат структурированные данные и требуют меньше времени на настройку – как правило, от 3 до 6 месяцев для локальных решений.

Технологии EDW
Понимание того, какие инструменты для создания корпоративных хранилищ данных представлены на рынке, поможет Вам определиться с тем, что нужно для построения Вашей платформы данных.
Как владелец бизнеса, Вы можете потеряться в огромном количестве представленных вариантов и технологий, поэтому крайне важно проконсультироваться с экспертами в области хранилищ, ETL и BI.
В последнее время огромной популярностью пользуются облачные технологии. На рынке можно найти бесчисленное количество поставщиков, которые предлагают хранение данных как услугу, то есть Вы будете использовать вычислительные мощности и пространство, предоставляемые облачными провайдерами. В большинстве случаев такие поставщики предлагают полностью управляемое, масштабируемое хранилище данных как часть своего BI-инструментария.
Вот несколько наиболее популярных решений для облачного хранения данных.
Amazon Redshift - это облачный сервис для хранения данных петабайтного масштаба, одно из решений экосистемы данных Amazon. Он позволяет одновременно обрабатывать большие объемы данных в зависимости от потребностей компании. С Amazon Redshift можно начать с малого - по цене 0,25 USD в час и увеличивать масштаб – до нескольких петабайтов хранилища и тысяч одновременно работающих пользователей. Расширяйте систему хранения данных без избыточного выделения вычислительных мощностей или ресурсов хранилища, выбрав именно тот вариант, который подходит Вашему бизнесу.
Google BigQuery - это бессерверное, масштабируемое облачное хранилище данных с мощной инфраструктурой от Google, которое может похвастаться RESTful веб-сервисом. Конечно же, тесно взаимодействует с другими сервисами от Google. Что касается стоимости использования данного решения, Вы можете выбрать одну из двух моделей ценообразования: фиксированную цену (flat-rate) или цену, зависящую от объема обрабатываемых данных (on-demand).
Snowflake - это популярное облачное хранилище данных SQL, созданное на базе Amazon Web Services или Microsoft Azure. Что отличает Snowflake от других вариантов на рынке, так это то, что Вы можете масштабировать вычисления и хранилище по отдельности. Snowflake предоставляет клиенту эластичное хранилище данных в виде сервиса (Data Warehouse as a Service). Это высокопроизводительная колоночная СУБД, которая поддерживает стандартный SQL и соответствует требованиям ACID. Snowflake работает по модели оплаты по мере использования. У Snowflake есть отдельные затраты на хранение и вычисления. Плата за хранилище взимается за терабайт, начиная с фиксированной ставки в размере 23 долларов США за терабайт и начисляется ежемесячно.


