

Kafka vs RabbitMQ: что выбрать для асинхронной интеграции
Kafka и RabbitMQ — популярные брокеры сообщений для асинхронной интеграции, микросервисной архитектуры и обработки событий. Они помогают разгружать сервисы, передавать данные между системами, сглаживать пики нагрузки и снижать риск потери сообщений при сбоях.
Несмотря на похожую область применения, Kafka и RabbitMQ решают задачи по-разному. Kafka лучше подходит для потоков событий, высокой пропускной способности, хранения и повторной обработки сообщений. RabbitMQ чаще выбирают для классических очередей, маршрутизации сообщений и сценариев, где важна гибкая доставка между сервисами. В статье сравним Kafka и RabbitMQ по архитектуре, модели обмена, хранению сообщений, масштабированию, задержкам и типовым сценариям использования.
Что внутри:
- что такое брокер сообщений;
- зачем очереди сообщений нужны в микросервисах;
- особенности Apache Kafka;
- продюсеры, консьюмеры, топики и pull-модель;
- хранение сообщений и повторная обработка в Kafka;
- распределенная архитектура Kafka;
- особенности RabbitMQ;
- очереди, exchange, routing и push-модель;
- сравнение Kafka и RabbitMQ;
- что выбрать для высокой нагрузки;
- что выбрать для интеграции микросервисов;
- рекомендации по выбору брокера сообщений.
Очереди сообщений (они же брокеры сообщений) помогают справится с высокой нагрузкой, сокращают время ответа за счёт асинхронной обработки и предотвращает потерю информации при сбоях. Использование брокеров сообщений особенно актуально в микросервисной архитектуре для асинхронной интеграции.
В статье рассматриваются самые популярные брокеры сообщений: Kafka и RabbitMQ. Попробуем рассказать об особенностях каждого из брокеров, сравним их друг с другом по пунктам и подумаем, когда что лучше использовать.
Особенности Apache Kafka
Apache Kafka – популярный брокер сообщений с открытым исходным кодом. Применяется в высоконагруженных системах для асинхронной интеграции, где требуется гарантированная доставка сообщений.
Подход к обмену сообщениями
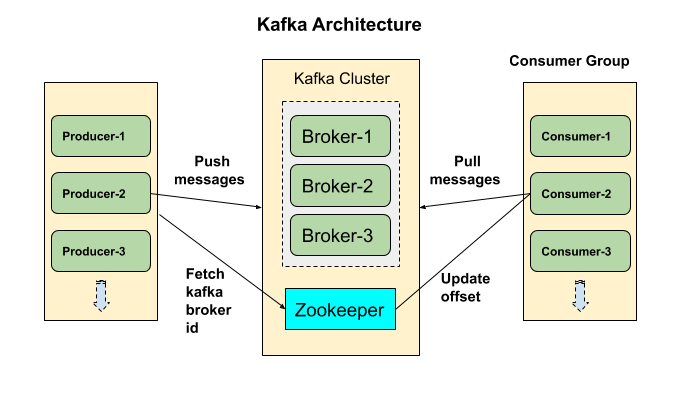
Те, кто отправляют сообщения в Kafka, называются продюсерами, а те, кто читает, косьюмерами. В Kafka используется подход pull, когда консьюмеры сами отправляют запросы в брокер раз в n миллисекунд для получения новой порции сообщений. Такой подход позволяет группировать сообщения в пакеты, достигая лучшей пропускной способности. К минусам модели можно отнести потенциальную разбалансированность нагрузки между разными консьюмерами и более высокую задержку обработки данных.
После прочтения косньюмерами сообщения в Kafka не удаляются и могут храниться неограниченное время. Благодаря этому одно и то же сообщение может быть обработано сколько угодно раз разными консьюмерами и в разных контекстах.
Архитектура Kafka
Kafka является распределенной системой. Все серверы объединяются в кластеры. Хранение и пересылка сообщений идёт параллельно на разных серверах, это даёт большую надежность и отказоустойчивость. Такая архитектура упрощает горизонтальное масштабирование: достаточно добавить дополнительные серверы.
Хранение сообщений в Kafka
Каждое сообщение (event или message) в Kafka состоит из ключа, значения, таймстампа и опционального набора метаданных (headers). Сообщения хранятся в топиках, которые делятся на партиции (partitions). Партиции распределены между брокерами в кластере и могут быть реплицированы для надёжности. Сообщения с одинаковыми ключами попадают в одну партицию, что обеспечивает порядок записи и чтения.
Чтение сообщений в Kafka
Как не читать одно сообщение дважды? Консьюмеры в Kafka отмечают обработанные сообщения с помощью оффсетов. Оффсет – это номер сообщения в партиции. Консьюмер отправляет брокеру запрос offset-commit с офсетом, который нужно сохранить. Брокер хранит эти офсеты в специальном топике. Консьюмеры могут получить последний закоммиченный оффсет у брокера и продолжить чтение сообщений с него.
Процесс обмена сообщениями в Kafka
- Создается именованный топик, который является точкой интеграции между продюсером и консьюмером. Топик делится на несколько партиций, которые распределяются между брокерами в кластере
- Продюсер отправляет сообщение в топик брокера. Сообщение содержит ключ, значение, таймстамп и опциональные хедеры. Ключ определяет, в какую партицию попадет сообщение.
- Консьюмер пытается забрать сообщение и его уникальный идентификатор (оффсет), присвоенный брокером (как правило, порядковый номер).
- Брокер хранит сообщение до запланированной очистки журнала. Kafka не отслеживает, какие сообщения были обработаны консьюмерами.
- Консьюмер обрабатывает сообщение, исходя из своей бизнес-логики и отправляет запрос обратно на сервер, используя его уникальный офсет и сообщает брокеру либо об успешной обработке (offset-commit), либо об ошибке (offset-reset).
- В случае успеха офсет помечается как закоммиченный и сохраняется в специальном топике. В случае ошибки оффсет сбрасывается на предыдущее значение или на дефолтное. Сообщение не удаляется из партиции и доступно для повторного чтения консьюмерами.
Где используется Kafka
Kafka используется для обработки больших объёмов данных, сотен тысяч сообщений в секунду, которые читаются тысячами подписчиков. Kafka — это легко масштабируемая система, обладающая повышенной отказоустойчивостью, что очень важно в крупных проектах, например, банкинг, телеком социальные сети, IoT.

Основы RabbitMQ
RabbitMQ – это брокер сообщений с открытым исходным кодом, который реализует протокол AMQP (Advanced Message Queuing Protocol). Применяется в системах для асинхронной интеграции, где требуется гибкая и надежная маршрутизация сообщений.
Основная фишка RabbitMQ — это гибкая маршрутизация сообщений между различными поставщиками (продьюсерами) и потребителями (косьюмерами) событий. RabbitMQ – это не просто очередь данных между двумя сторонами, это менеджер очередей, который маршрутизирует данные в разные очереди сообщений. Продьюсер отправляет сообщения не в саму очередь, а на обменник, который сам распределяет сообщения между очередями.
Например, одно и то же сообщение должны получить три подписчика. Оно попадает на узел (обменник), который отправит три одинаковых сообщения в три очереди для всех подписчиков, которым оно должно быть доставлено. При этом в очереди может храниться любое количество сообщений от неограниченного количества поставщиков, а получать их может неограниченное число подписчиков.

Подход к обмену сообщениями
В RabbitMQ используется подход push, когда брокер сам активно отправляет сообщения консьюмерам, которые подписаны на очереди. Такой подход позволяет уменьшить задержку обработки данных и более равномерно распределить нагрузку между потребителями.
В RabbitMQ после получения консьюмерами сообщение удаляется из очереди. Благодаря этому одно и то же сообщение может быть обработано только одним консьюмером и не хранится дольше необходимого.
К минусам подхода push относится меньшая гибкость для потребителей. В отличие от модели pull, когда потребитель сам ходит за новыми сообщениями, когда ему надо, push не оставляет выбора потребителю – тот должен обработать поступившее сообщение. Кроме того, RabbitMQ не гарантирует порядок доставки сообщений.
Процесс обмена сообщениями в RabbitMQ
- Создается именованный обменник, который является точкой интеграции между продюсером и консьюмером. Обменник задает правила маршрутизации сообщений.
- Создаются одна или несколько очередей, которые привязываются к обменнику с помощью ключей маршрутизации.
- Продюсер отправляет сообщение в обменник
- Обменник, получив сообщение, маршрутизирует его в одну или несколько очередей в соответствии с правилами привязки между ним и очередью
- Очередь отправляет сообщение потребителям (одному или нескольким), которые подписались на “push-уведомления” (поставили на канале)
- Потребитель обрабатывает сообщение, исходя из своей бизнес-логики и отправляет брокеру подтверждение об успешной обработке (ack) или отказе (nack)
- В случае успешной обработки брокер удаляет сообщение из очереди. В случае неудачной обработки со стороны потребителя (nack) сообщение остается в очереди, пока не будет успешно обработано
В случае некорректного завершения работы сервера, данные в очереди не теряются. И при последующем запуске обработка продолжается с того места, где был обрыв.
Архитектура RabbitMQ
RabbitMQ является распределенной системой. Все серверы объединяются в кластеры. Пересылка сообщений идёт через специальные узлы, называемые обменниками (exchanges), которые могут иметь разные типы и правила маршрутизации. Обменники отправляют сообщения в очереди (queues). Обменники и очереди связаны через binding – правила, которое сообщает имеющемуся обмену в какой из очередей эти сообщения должны сохраняться. Очереди могут быть распределены между брокерами в кластере и реплицированы для надёжности.
Где используется RabbitMQ
RabbitMQ — это универсальный брокер сообщений. Он отлично подходит для интеграции микросервисов, потоковой передачи данных в режиме реального времени или при передаче работы удалённым работникам. Его используют крупные компании, в числе которых Bloomberg, Reddit, NASA и др.
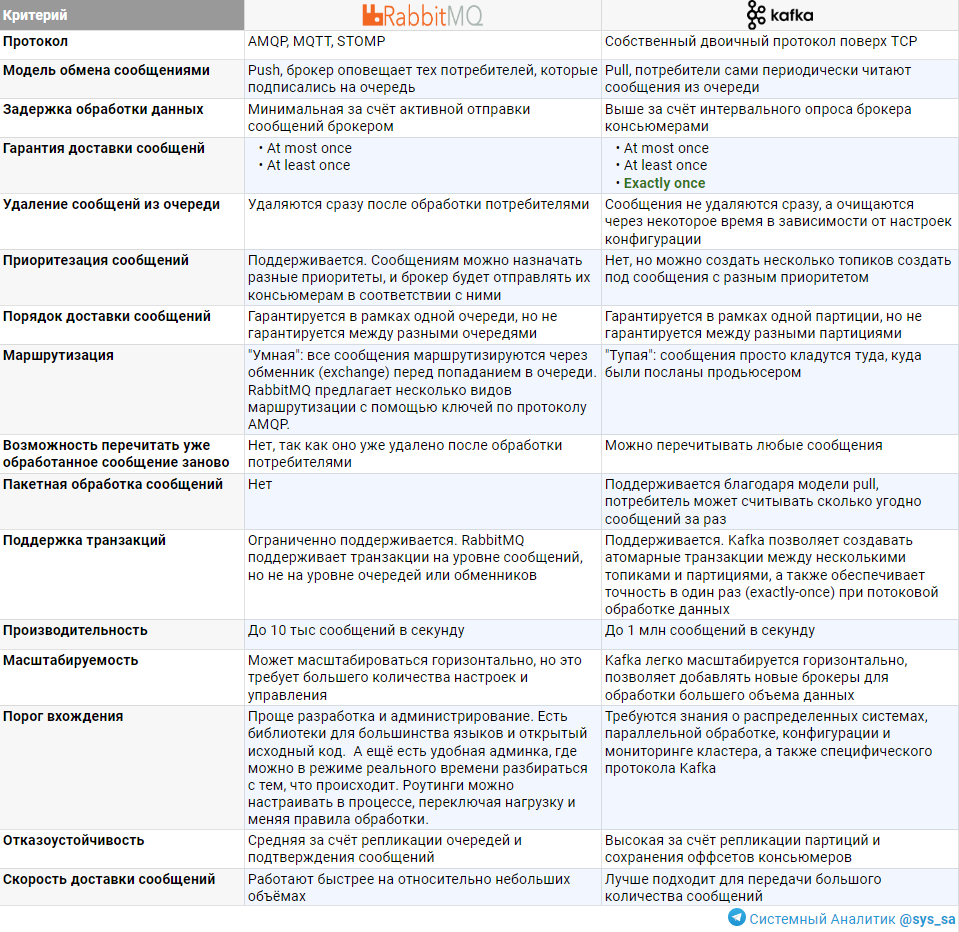
Kafka vs RabbitMQ: сравнение по пунктам
Подход к обмену сообщениями
- В RabbitMQ используется подход push, когда брокер сам активно отправляет сообщения консьюмерам, которые подписаны на очереди. Плюсы: меньше задержка и равномернее нагрузка. Минусы: меньшая гибкость для потребителя и невозможность потребления сообщений пакетами.
- В Kafka используется подход pull, когда консьюмеры сами отправляют запросы в брокер раз в n миллисекунд для получения новой порции сообщений. Такой подход позволяет группировать сообщения в пакеты, достигая лучшей пропускной способности. К минусам модели можно отнести потенциальную разбалансированность нагрузки между разными консьюмерами и более высокую задержку обработки данных.
Удаление сообщений из очереди
- В RabbitMQ после получения консьюмерами сообщение удаляется из очереди Благодаря этому одно и то же сообщение может быть обработано только одним консьюмером и не хранится дольше необходимого.
- В Kafka сообщения после прочтения косньюмерами не удаляются и могут храниться неограниченное время. Благодаря этому одно и то же сообщение может быть обработано сколько угодно раз разными консьюмерами и в разных контекстах.
Скорость доставки сообщений
- Очереди RabbitMQ работают быстрее всего на относительно небольших объёмах.
- Kafka хранит большие объемы данных с минимальными издержками, поэтому подходит для передачи большого количества сообщений, + поддерживает пакетное потребление сообщений
Масштабируемость
- RabbitMQ может масштабироваться горизонтально, но это требует большего количества настроек и управления
- Kafka легко масштабируется горизонтально, что позволяет добавлять новые брокеры для обработки большего объема данных
Маршрутизация сообщений
- В RabbitMQ все сообщения маршрутизируются через обменник (exchange) перед попаданием в очереди. RabbitMQ предлагает несколько видов маршрутизации с помощью ключей по протоколу AMQP.
- У Kafka упрощённый подход к маршрутизации
Протокол
- RabbitMQ поддерживает несколько стандартизированных протоколов: AMQP, MQTT, STOMP и др. Это позволяет заменить его на любой брокер на основе AMQP.
- Kafka использует собственный двоичный протокол поверх TCP. Вы не сможете так просто удалить или заменить эту платформу, потому что она единственная реализует данный протокол.
Приоритезация сообщений
- RabbitMQ позволяет назначать приоритет сообщениям
- В Kafka приоритет для всех сообщений одинаков и его нельзя изменить. Обходной путь: создать нескольких топиков под сообщения с разным приоритетом, например, events_low, events_medium, events_high, а затем реализовать логику приоритетного чтения на стороне консьюмера.
Kafka vs RabbitMQ
Что лучше: Kafka или RabbitMQ?
Как видите, однозначного ответа нет. Оба инструмента прекрасны и каждый из них может Вам подойти в зависимости от ситуации.
Kafka – это про большие данные и потоковую обработку:
- когда в реальном времени требуется обрабатывать огромные куски данных с частотой от тысяч до миллионов сообщений в секунду
- когда нужно собирать кучу данных с большого числа источников (например, системы логирования и мониторинга)
- когда в реальном времени требуется обрабатывать огромные куски данных с частотой от тысяч до миллионов сообщений в секунду
RabbitMQ подходит для более стандартной очереди или брокера сообщений:
- когда нужна сложная маршрутизация сообщений (например, выборочная подписка или публикация)
- когда нужно просто передавать краткосрочные сообщения от одного микросервиса к другому
- когда нужна поддержка разных протоколов обмена и более зрелый подход к стандартной очереди задач
Автор: канал Системный Аналитик
FAQ
Вопрос: Чем Kafka отличается от RabbitMQ?
Ответ: Kafka ориентирована на потоковую обработку событий, высокую пропускную способность, хранение сообщений и повторное чтение. RabbitMQ больше похож на классический брокер очередей с гибкой маршрутизацией и доставкой сообщений потребителям.
Вопрос: Когда лучше использовать Kafka?
Ответ: Kafka подходит для event streaming, логов, аналитических событий, CDC, real-time pipelines, интеграции больших потоков данных и сценариев, где сообщения нужно хранить и переиспользовать.
Вопрос: Когда лучше использовать RabbitMQ?
Ответ: RabbitMQ хорошо подходит для очередей задач, асинхронной обработки, маршрутизации сообщений между сервисами и сценариев, где важна гибкая доставка и подтверждение обработки.
Вопрос: Что такое producer и consumer в Kafka?
Ответ: Producer отправляет сообщения в Kafka, а consumer читает их из топиков. В Kafka потребители сами запрашивают новые сообщения, поэтому модель чтения обычно называют pull.
Вопрос: Можно ли считать Kafka обычной очередью?
Ответ: Kafka можно использовать для некоторых задач очередей, но архитектурно это скорее распределенный журнал событий. Сообщения после чтения не удаляются сразу и могут быть прочитаны повторно.
- Debezium: CDC, Kafka Connect и репликация данных
- Apache Airflow DAGs: основы и расписания
- ETL и ELT: 5 основных отличий
- DWH: зачем компании хранилище данных
- ClickHouse для новичков


