

Что такое Apache Kafka
Apache Kafka®, разработанная как система обмена сообщениями по принципу «публикация-подписка» и изначально предназначенная для обработки больших объемов данных в LinkedIn, сегодня является одной из самых востребованных платформ распределенной потоковой передачи событий с открытым исходным кодом, которую используют более 80% компаний из списка Fortune 100.
Это руководство по работе с Kafka поможет Вам подробнее узнать о продукте, его преимуществах и вариантах использования, а также о том, как начать работу с данной системой. Данная статья включает в себя обзор архитектуры Kafka,ее основных концепций и коннекторов.
Введение
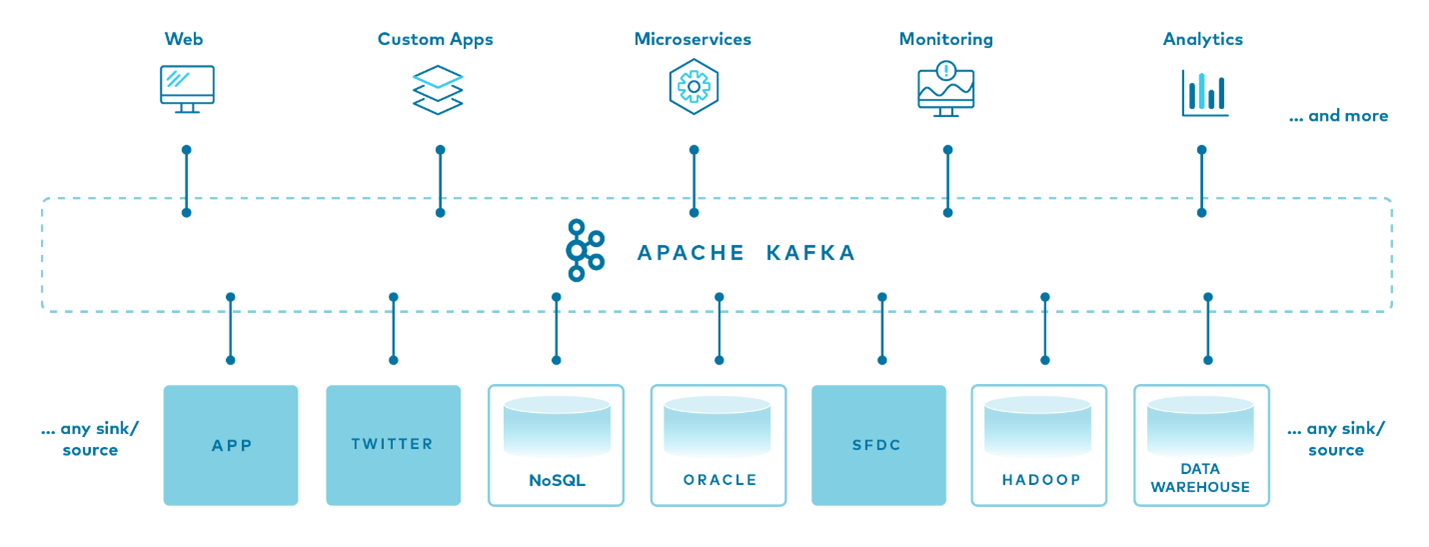
Apache Kafka - это платформа, предназначенная для потоковой передачи событий, используемая для сбора, обработки, хранения, интеграции данных, а также для обмена сообщениями pub/sub.
Для того, чтобы лучше понять, что именно делает Kafka, предлагаю разобраться в том, что такое платформа потоковой передачи событий и как она работает.
Прежде чем углубиться в архитектуру Kafka и ее основные компоненты, давайте обсудим, что такое событие.
Что такое событие?
Событие - это любой тип действий или изменений, которые идентифицируются или регистрируются программным обеспечением или приложениями. Например, платеж, переход на веб-сайт или измерение температуры, а также описание того, что произошло.
Другими словами, событие - это комбинация уведомления - элемента «когда», который может быть использован для запуска других действий, и состояния. Это состояние обычно довольно небольшое, скажем, меньше мегабайта, и , как правило, представлено в некотором структурированном формате, например, в JSON или объекте, сериализованном с помощью Apache Avro™ или Protocol Buffers.
Kafka и события – пара «ключ – значение»
В основе Kafka лежит понятие распределенного журнала фиксации. Разбивая журнал на разделы, Kafka позволяет масштабировать системы. По сути, Kafka моделирует события как пары ключ -значение. Внутренне ключи и значения - это просто последовательности байтов, но внешне, в выбранном языке программирования, они часто представляют собой структурированные объекты, представленные в системе типов Вашего языка. В Kafka перевод между языковыми типами и внутренними байтами называется сериализацией и десериализацией. Сериализованный формат обычно представляет собой JSON, JSON Schema, Avro или Protobuf.
Значения обычно представляют собой сериализованное представление объекта домена приложения или некоторую форму необработанного входного сообщения, например, выход датчика.
Ключи также могут быть сложными доменными объектами, но чаще всего представляют собой примитивные типы, такие как строки или целые числа. Ключевая часть события Kafka не обязательно является уникальным идентификатором события, как, например, первичный ключ строки в реляционной базе данных. Скорее всего, это идентификатор какой-то сущности в системе, например пользователя, заказа или конкретного подключенного устройства.
Сейчас это может показаться не столь важным, но позже мы увидим, что ключи имеют решающее значение для того, как Kafka работает с такими вещами, как распараллеливание и локальность данных.
Почему именно Kafka? Ключевые преимущества
Более чем 100 000 организаций по всему миру доверяют Kafka. Развитием платформы занимается сообщество профессиональных разработчиков, которые постоянно совершенствуют технологию потоковой обработки данных. Благодаря высокой пропускной способности, отказоустойчивости и масштабируемости Kafka востребована абсолютно во всех отраслях - от банковского дела и выявления мошенничества до транспорта и IoT. Для чего используют данную платформу?
- Интеграция данных
Kafka может подключаться практически к любому другому источнику данных в традиционных корпоративных информационных системах, современных базах данных и даже в облаке. Платформа образует эффективную точку интеграции со встроенными коннекторами данных.
- Метрики и мониторинг
Kafka очень часто используется для мониторинга оперативных данных. Это предполагает агрегирование статистики распределенных приложений для создания централизованных каналов с показателями в режиме реального времени.
- Агрегирование журналов
Современная система, как правило, является распределенной. Данные протоколирования должны быть централизованы в одном месте. Учитывая все выше сказанное, Kafka служит единым источником истины, централизуя данные из всех источников, независимо от их формы и объема.
- Потоковая обработка данных
Выполнение вычислений в режиме реального времени над потоками событий - основная компетенция Kafka. От обработки данных в режиме реального времени до программирования потоков данных - Kafka получает, хранит и обрабатывает потоки данных по мере их генерации абсолютно в любом масштабе.
- Обмен сообщениями pub/sub
Будучи распределенной системой обмена сообщениями pub/sub, Kafka отлично справляется с ролью модернизированной версии традиционного брокера сообщений. В любой ситуации, когда процесс, генерирующий события, должен быть отделен от процесса или от процессов, получающих события, Kafka гарантированно придет Вам на помощь.
Архитектура Kafka– основные концепты
- Топики Kafka
События имеют тенденцию разрастаться - просто подумайте о событиях, которые произошли с Вами сегодня утром, - поэтому нам нужна надежная система для их организации. Наиболее фундаментальной единицей организации событий в Kafka является топик, который чем-то напоминает таблицу в реляционной базе данных. Топики создаются для организации хранения разных типов событий.
Топик - это журнал событий. Журналы легко понять, поскольку они представляют собой простые структуры данных с понятной семантикой. Во-первых, они работают только на добавление: когда Вы записываете новое сообщение в журнал, оно всегда идет в конце журнала. Во-вторых, их можно прочитать только путем поиска произвольного смещения в журнале, а затем путем сканирования последовательных записей журнала. В-третьих, события в журнале неизменны - если что-то произошло, то сделать так, чтобы его не было, крайне сложно. Простая семантика журнала делает возможным обеспечить высокий уровень устойчивой пропускной способности при входе и выходе из топиков, а также облегчает репликацию топиков, о чем мы поговорим чуть позже.
Помимо всего прочего журналы являются фундаментально долговечными сущностями. В традиционных корпоративных системах обмена сообщениями есть топики и очереди, которые временно хранят сообщения для буферизации их между источником и получателем.
Поскольку топики Kafka - это журналы, в их данных нет ничего временного. Каждый топик может быть настроен на уничтожение данных по достижении определенного возраста (или определенного размера темы в целом), от нескольких секунд до нескольких лет, или даже на неограниченное хранение сообщений. Журналы, лежащие в основе топиков Kafka, представляют собой файлы, хранящиеся на диске. Когда Вы записываете событие в топик, оно хранится так же долго, как если бы Вы записали его в любую базу данных, которой когда-либо доверяли.
Простота журнала и неизменность его содержимого - залог успеха Kafka как важнейшего компонента современной инфраструктуры данных, но это только начало.
- Партиции Kafka
Если бы топик «жил» только на одной машине, это сильно ограничило бы возможности Kafka по масштабированию. Платформа может управлять многими топиками на многих машинах - ведь Kafka является распределенной системой, - но ни один топик никогда не станет слишком большим. К счастью, у Kafka есть неплохое решение - платформа дает нам возможность разбивать топики на партиции.
Партиционирование берет журнал одного топика и разбивает его на несколько журналов, каждый из которых может жить на отдельном узле в кластере Kafka. Таким образом, работа с сообщениями может быть разделена между многими узлами кластера.
Принцип работы партиционирования Kafka
После того, как мы разбили топик на партиции, нам нужно решить, какие сообщения записывать в те или иные разделы. Обычно, если сообщение не имеет ключа, последующие сообщения распределяются по кругу между всеми партициями топиками. В этом случае все партиции получают равную долю данных. Если у сообщения есть ключ, то раздел назначения будет вычисляться из хэша ключа. Это позволяет Kafka гарантировать, что сообщения с одинаковым ключом всегда попадают в одну и ту же раздел, а значит, они всегда упорядочены.
Например, если Вы формируете события, связанные с одним и тем же клиентом, использование идентификатора клиента в качестве ключа гарантирует, что все события от данного клиента всегда будут приходить по порядку. Это создает вероятность того, что слишком активный ключ создаст более крупную и активную партицию, однако на практике этот риск минимален, и если, такая ситуация случается, ее достаточно просто разрешить.
- Брокеры Kafka
До сих пор мы говорили о событиях, топиках и партициях, но пока не слишком подробно затронули компьютеры. С точки зрения физической инфраструктуры, Kafka состоит из сети машин, называемых брокерами. При развертывании это могут быть не отдельные физические серверы, а контейнеры, работающие на подсистемах, функционирующих на виртуализированных серверах. Как бы они ни были развернуты, это независимые машины, на каждой из которых запущен процесс брокера Kafka. Каждый брокер содержит некоторый набор партиций и обрабатывает входящие запросы на запись новых событий в эти партиции. Брокеры также обрабатывают репликацию партиций.
- Репликация
Независимо от того, являются ли брокеры «голыми» серверами или управляемыми контейнерами, они е подвержены сбоям, поэтому нам нужно скопировать данные партиции на несколько других брокеров, чтобы сохранить их в безопасности. Эти копии называются репликами-последователями, основной раздел называется репликой-лидером. Когда Вы передаете данные лидеру, лидер и последователи работают вместе таким образом, чтобы реплицировать эти новые записи на последователей.
Этот процесс происходит автоматически, и хотя Вы всегда можете настроить некоторые параметры в продюсере для получения различных уровней гарантии долговечности, как правило, этот процесс не требует от разработчика, создающего системы на базе Kafka, особых усилий. Все, что Вам действительно нужно знать, - это то, что Ваши данные - в безопасности, и что если один узел в кластере «умрет», его функции возьмет на себя другой работоспособный узел.
- Приложения
Теперь давайте выйдем за пределы кластера Kafka и обратимся к приложениям, которые используют Kafka: продюсеры и консюмеры. Это клиентские приложения, которые содержат Ваш код, помещающий сообщения в топики и читающий сообщения из топиков. Каждый компонент платформы Kafka, который не является брокером Kafka, по сути, - либо продюсер, либо консюмер, либо и то, и другое сразу. Продюсер и консюмер - это то, как Вы взаимодействуете с кластером.
- Продюсеры Kafka
API библиотека продюсера довольно легкая: в Java есть класс KafkaProducer, который используется для подключения к кластеру. Вы передаете этому классу карту конфигурационных параметров, включая адреса некоторых брокеров в кластере, любые соответствующие настройки безопасности и другие параметры, определяющие сетевое поведение продюсера. Существует еще один класс ProducerRecord, который используется для хранения пары ключ-значение, которую Вы хотите отправить на кластер.
В первом приближении, все это - область API для создания сообщений. Библиотека управляет пулами соединений, сетевой буферизацией, ожиданием подтверждения сообщений брокерами, повторной передачей сообщений при необходимости и множеством других деталей, о которых не должен беспокоиться ни один прикладной программист.
- Консюмеры Kafka
Использование API консюмера похоже на работу с продюсером. В обоих случаях для подключения к кластеру Вы используете класс KafkaConsumer (передавая карту конфигурации для указания адреса кластера, безопасности и других параметров). Затем Вы используете это соединение для подписки на одну или несколько топиков. Как только сообщения становятся доступными в топиках, они возвращаются в коллекцию под названием ConsumerRecords, которая в свою очередь содержит отдельные экземпляры сообщений в виде объектов ConsumerRecord. Объект ConsumerRecord представляет собой пару ключ-значение одного сообщения Kafka.
KafkaConsumer управляет пулом соединений и сетевым протоколом точно так же, как и KafkaProducer, но на стороне чтения есть гораздо более важная цель, чем просто сетевые соединения. Прежде всего, Kafka отличается от традиционных очередей сообщений тем, что чтение сообщения не уничтожает его; оно по-прежнему доступно для чтения любому другому консюмеру, которому оно может быть интересно. На самом деле, в Kafka допустима ситуция, когда многие консюмеры читают сообщения из одного и того же топика.
Кроме того, консюмеры должны быть способны справиться со сценарием, в котором скорость потребления сообщений из топика в сочетании с вычислительными затратами на обработку одного сообщения слишком высоки, чтобы один экземпляр приложения мог справиться с ними. То есть число консюмеров должно постоянно расти. В Kafka масштабирование групп потребителей происходит более или менее автоматически.
Экосистема Kafka
Если бы у Вас были только брокеры, управляющие разделенными, реплицируемыми топиками с постоянно растущей коллекцией продюсеров и консюмеров, пишущих и читающих события, у Вас была бы довольно стабильная система. Однако все время появляются определенные шаблоны, которые побуждают разработчиков снова и снова создавать новые элементы вокруг ядра Kafka.
В итоге Вы будете создавать общие слои функциональности приложения для повторения определенных недифференцированных задач.
Может возникнуть соблазн написать этот код самостоятельно, но делать этого не стоит. Kafka Connect, Confluent Schema Registry, Kafka Streams, и ksqlDB - это примеры инфраструктурного кода. Рассмотрим каждый из них по очереди.
- Kafka Connect
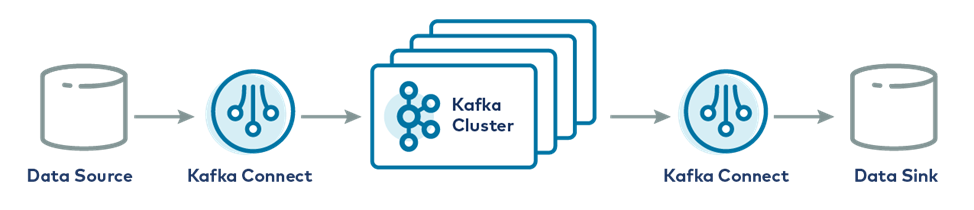
В мире данных не все системы эквиваленты Kafka. Иногда Вы хотите, чтобы данные из этих систем попадали в топики Kafka, а иногда – наоборот, чтобы данные из топиков Kafka попадали в эти системы. Именно эту задачу и решает Kafka Connect .
Что делает Kafka Connect?
С одной стороны, Kafka Connect – это экосистема подключаемых коннекторов, а с другой - клиентское приложение. Как клиентское приложение, Connect представляет собой серверный процесс, который работает на аппаратном обеспечении, независимом от самих брокеров Kafka. Он масштабируемый и отказоустойчив, то есть Вы можете запустить не один-единственный рабочий Connect, акластер рабочих Connect, которые разделяют нагрузку по перемещению данных в Kafka из внешних систем и обратно. Кроме того, Kafka Connect абстрагирует код от пользователя и требует только JSON-конфигурации. Например, передать данные из Kafka в Elasticsearch можно следующим образом:
{
  "connector.class": "io.confluent.connect.elasticsearch.ElasticsearchSinkConnector",
  "topics"         : "my_topic",
  "connection.url" : "http://elasticsearch:9200",
  "type.name"      : "_doc",
  "key.ignore"     : "true",
  "schema.ignore"  : "true"
}
Преимущества Kafka Connect
Одно из главных преимуществ Kafka Connect – это обширная экосистема коннекторов. Написание кода, который перемещает данные в облачное хранилище, пишет в Elasticsearch или вставляет записи в реляционную базу данных. Аналогично, чтение из реляционной базы данных, Salesforce или устаревшей файловой системы HDFS - это одна и та же операция, независимо от того, какое приложение ее выполняет. Вы, безусловно, можете написать такой код, но трата времени на эту задачи абсолютно не оправдана.
Все это - примеры коннекторов Kafka, доступных в Confluent Hub, - курируемой коллекции коннекторов всех видов и, что самое важное, всех лицензий и уровней поддержки. Некоторые из них лицензированы на коммерческой основе, некоторые можно использовать совершенно бесплатно. Connect Hub позволяет искать коннекторы-источники и коннекторы-стоки всех видов и четко показывает лицензию каждого коннектора. Конечно, коннекторы не обязательно должны быть из Hub, их можно найти на GitHub или в других подобных местах. И если после всего этого Вы все еще не можете найти коннектор, который делает то, что Вам нужно, Вы можете написать свой собственный, используя довольно простой API.
На первый взгляд может показаться, что создать подобную функциональность своими силами проще простого: Если внешняя система-источник читается легко, то будет достаточно просто читать из нее и производить в конечный топик. Если внешняя система-поглотитель проста для записи, то опять же будет достаточно просто потреблять из топика и записывать в эту систему. Однако в процессе Вы столкнетесь со множеством сложностей (как обеспечить отказоустойчивость, как гарантировать горизонтальное масштабирование и т.д.).
Таким образом, Connect кажется обманчиво простым, но на самом деле он представляет собой достаточно сложную распределенную систему и экосистему плагинов в своем собственном понимании. И если в этой экосистеме плагинов нет того, что Вам нужно, фреймворк Connect с открытым исходным кодом позволит легко создать свой собственный коннектор и унаследовать все свойства масштабируемости и отказоустойчивости, которые предлагает Connect.
- Schema Registry
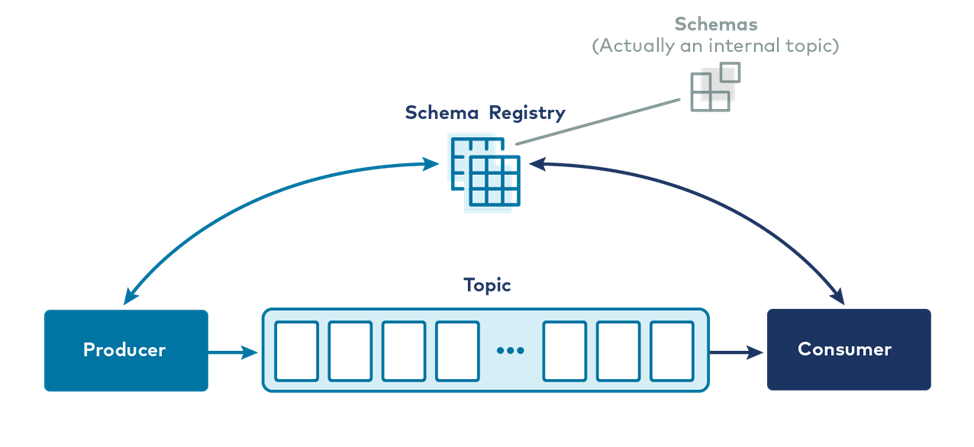
Когда приложения начнут активно отправлять сообщения в Kafka и получать их из нее, произойдут две вещи. Во-первых, появятся новые консюмеры существующих топиков. Речь идет о совершенно новых приложениях - возможно, написанных командой, которая создала первоначального продюсера сообщений, возможно, другой командой, - и они должны будут понимать формат сообщений в топике. Во-вторых, формат этих сообщений будет меняться по мере развития бизнеса. Объекты заказов получают новое поле статуса, имена пользователей разделяются на имя и фамилиюи так далее. Схема объектов нашего домена - это постоянно развивающаяся субстанция, и мы должны иметь возможность согласовать схему сообщений в любом топике.
Что такое Schema Registry?
Schema Registry - это отдельный серверный процесс, который запускается на машине, внешней по отношению к брокерам Kafka. Его задача - поддерживать базу данных всех схем, которые были записаны в темы кластера, за который он отвечает. Эта «база данных» хранится во внутреннем топике Kafka и кэшируется в Schema Registry. Schema Registry может работать в избыточной конфигурации с высокой степенью доступности, так что даже при выходе из строя одного экземпляра он остается работоспособным.
Schema Registry - это также API, позволяющий продюсерам и консюмерам предсказывать, совместимо ли сообщение, которое они собираются произвести или потребить, с предыдущими версиями. Когда продюсер настроен на использование Schema Registry, он вызывает API на конечной точке Schema Registry REST и представляет схему нового сообщения. Если она такая же, как и у последнего созданного сообщения, вероятность успешности производства достаточно велика. Если она отличается от последнего сообщения, но соответствует правилам совместимости, определенным для данного топика, то производство все равно может быть успешным. Но если оно отличается от предыдущего и при этом нарушает правила совместимости, то производство потерпит неудачу, которую сможет обнаружить код приложения.
Аналогично и на стороне консюмера: если консюмер читает сообщение, которое имеет несовместимую схему с версией, которую ожидает код консюмера, Schema Registry скажет ему не потреблять это сообщение. Schema Registry не полностью автоматизирует проблему эволюции схем - это проблема любой системы, независимо от инструментария, - но он значительно облегчает сложную задачу, по возможности предотвращая сбои во время выполнения.
Таким образом, у нас есть система для долговременного хранения событий, возможность записи и чтения этих событий, фреймворк для интеграции данных и даже инструмент для управления эволюционирующими схемами. Остается только вычислительная сторона обработки потоков.
- Kafka Streams
В развивающемся приложении на базе Kafka консюмеры становятся все более и более сложными. То, что могло начаться как простое преобразование (например, маскировка персональной идентификационной информации или изменение формата сообщения в соответствии с внутренними требованиями схемы), вскоре превращается в сложную агрегацию, обогащение и многое другое. Если Вы вспомните код консюмера, который мы рассматривали выше, то в этом API не так много поддержки для подобных операций: Вам придется создать код фреймворка для обработки временных окон, поздно пришедших сообщений, таблиц поиска, агрегации по ключу и т. д. И как только Вы разберетесь со всем этим, вспомните, что такие операции, как агрегация и обогащение, как правило, обладают состоянием.
Этим «состоянием» будет память в куче Вашей программы, а значит, это ответственность за отказоустойчивость. Если Ваше приложение для обработки потоков выйдет из строя, его состояние уйдет вместе с ним, если только Вы не придумали схему сохранения этого состояния. Подобные вещи непомерно сложны создания с нуля, при этом, по большому счету они никак не улучшают жизнь пользователей системы. Именно поэтому Apache Kafka предоставляет API для обработки потоков. Именно поэтому у нас есть Kafka Streams.


