

Массивно-параллельная обработка запросов и файлов журнала с помощью ClickHouse
В этой статье мне хотелось бы поговорить о том, как использовать ClickHouse для параллельной обработки запросов и файлов журналов.
Мы давно работаем с MySQL и MongoDB, но, к сожалению, ни одна из них не подходит для выполнения серьезных аналитических нагрузок. Практически каждый день мы анализируем большие наборы данных, и одной из самых важных задач является анализ лог-файлов. Ниже я покажу Вам, как для эффективного решения этого вопроса можно использовать ClickHouse. Данная система в первую очередь привлекательна тем, что в ней реализована многоядерная параллельная обработка запросов. Кроме того, она может выполнять один запрос сразу на нескольких процессорах в фоновом режиме.
Я очень хочу как следует разобраться в том, как ClickHouse использует несколько ядер и потоков процессора. Я буду использовать сервер с двумя сокетами, оснащенными «Intel(R) Xeon(R) CPU E5-2683 v3 @ 2.00GHz». Таким образом, в общей сложности мы получаем 28 процессорных ядер / 56 процессорных потоков.
Для анализа рабочих нагрузок я буду использую лог-файл Apache с одного из серверов Percona. Журнал содержит 1,56 миллиарда строк и в несжатом виде занимает 274 Гбайт. При вставке в ClickHouse таблица на диске занимает 9 Гб.

Как вставить данные в ClickHouse? Существует множество скриптов для преобразования формата логов Apache в CSV, который ClickHouse может принять.
Таблица ClickHouse:
CREATE TABLE default.apachelog ( remote_host String, user String, access_date Date, access_time DateTime, timezone String, request_method String, request_uri String, status UInt32, bytes UInt32, referer String, user_agent String) ENGINE = MergeTree(access_date, remote_host, 8192)
Для того, чтобы посмотреть, как ClickHouse работает с несколькими ядрами/потокми CPU, я выполню тот же самый запрос, только выделю от от 1 до 56 потоков CPU для процессов ClickHouse:
ps -eLo cmd,tid | grep clickhouse-server | perl -pe 's/.* (d+)$/1/' | xargs -n 1 taskset -cp 0-$i
...где $i - (N CPUs-1).
Мы также должны учитывать тот факт, что не все запросы одинаковы. Поэтому я протестирую три разных запроса. В конце концов, мы не можем обойти закон Амдала!
Первый запрос можно выполнить параллельно:1
select extract(request_uri,'(w+)$') p,sum(bytes) sm,count(*) c from apachelog group by p order by c desc limit 100
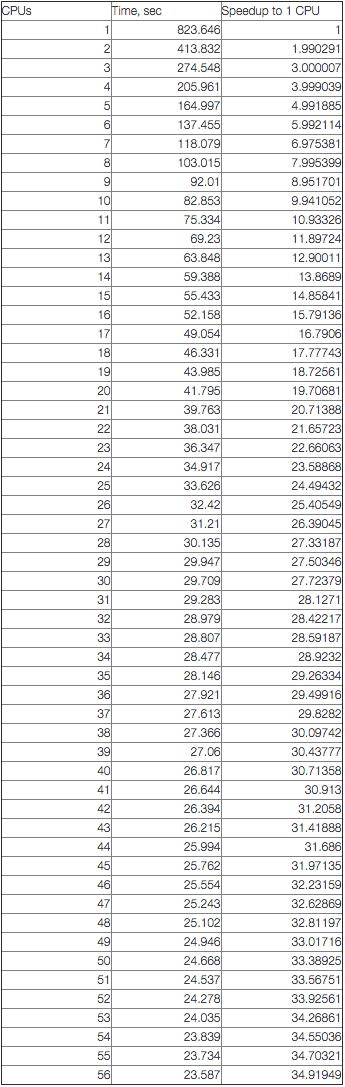
Ускорение:
Гораздо лучше представить эти результаты в виде графика:

На графике отчетливо видно, что запрос масштабируется линейно вплоть до 28 ядер. После он продолжает масштабироваться до 56 потоков (при этом наклон кривой более пологий). Я думаю, это связано с архитектурой процессора (у нас 28 физических ядер и 56 «потоков» процессора). Давайте еще раз посмотрим на полученные результаты. При одном доступном процессоре на выполнение запроса ушло 823,6 секунды. При использовании всех доступных процессоров процесс завершился за 23,6 секунды. Таким образом, общее ускорение составило 34,9 раза.
Теперь давайте рассмотрим запрос с меньшей степенью параллелизма.1
select access_date c2, count(distinct request_uri) cnt from apachelog group by c2 order by c2 limit 300
В данном случае происходит агрегация, которая подсчитывает уникальные URI, что ограничивает процесс подсчета одной общей структурой. Таким образом, некоторая часть выполнения запроса ограничивается одним процессом. Я не буду показывать полные результаты для всех процессоров от 1 до 56, но скажу, что для одного процессора время выполнения составляет 177,715 секунды, а для 56 процессоров - 11,564 секунды. Общее ускорение составляет 15,4 раза.
График ускорения выглядит следующим образом:
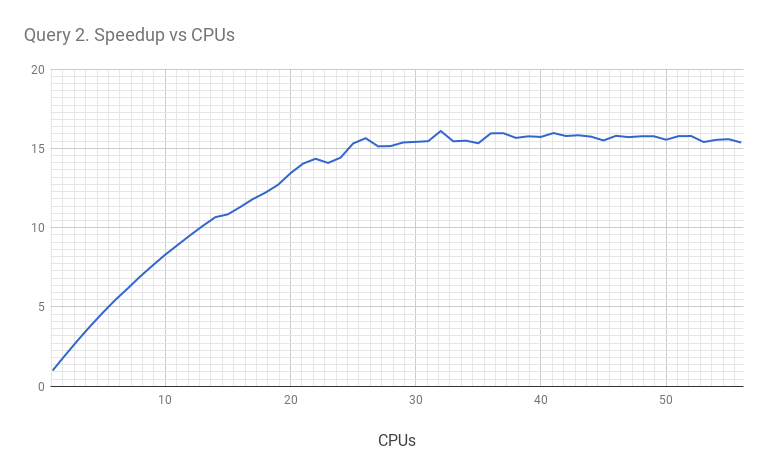
Как мы и предполагали, этот запрос подразумевает меньший параллелизм. А как насчет еще более серьезных запросов?
SELECT y, request_uri, cnt FROM (SELECT access_date y, request_uri, count(*) AS cnt FROM apachelog GROUP BY y, request_uri ORDER BY y ASC ) ORDER BY y,cnt DESC LIMIT 1 BY y
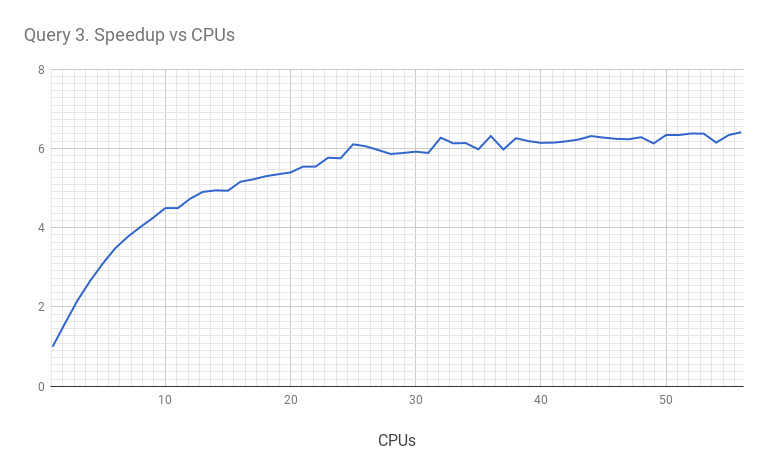
В этом запросе мы создаем производную таблицу (чтобы разрешить подзапрос), и я думаю, что это еще больше ограничит параллелизм. Так и было: на одном процессоре запрос выполняется 183,063 секунды. С 56 процессорами он занимает 28,572 секунды. Таким образом, ускорение составляет всего 6,4 раза.
График:
Заключение
ClickHouse может использовать несколько ядер процессора, имеющихся на сервере. Выполнение запросов не ограничивается одним процессором (как в MySQL). Степень параллелизма определяется сложностью запроса, и в лучшем случае мы видим линейную масштабируемость с увеличением количества ядер CPU.
Однако если запросы выполняются последовательно, это ограничивает ускорение (в соответствии с законом Амдала).
В качестве примера можно привести журнал Apache объемом 1,5 миллиарда записей - мы видим, что ClickHouse может выполнять сложные аналитические запросы всего лишь за десятки секунд.


