

ClickHouse для новичков: введение, характеристики и начало работы
ClickHouse — это open-source OLAP-СУБД для быстрой аналитики больших объемов данных. Ее используют для отчетности, продуктовой аналитики, логов, событий, BI-дашбордов и других задач, где важно быстро выполнять агрегирующие SQL-запросы по большим таблицам.
ClickHouse отличается высокой скоростью, колоночным хранением, сжатием данных, масштабируемостью и поддержкой облачных вариантов развертывания. В статье разберем, что такое ClickHouse, чем OLAP-база отличается от обычной транзакционной СУБД, какие у ClickHouse ключевые особенности, где ее применяют и с чего начать новичку.
Что внутри:
- что такое ClickHouse простыми словами;
- чем OLAP-СУБД отличается от OLTP-баз данных;
- почему ClickHouse быстро выполняет аналитические запросы;
- колоночное хранение и сжатие данных;
- open-source и облачные варианты ClickHouse;
- сценарии применения: BI, логи, события, продуктовая аналитика;
- основные характеристики ClickHouse;
- примеры компаний и задач, где используют ClickHouse;
- когда ClickHouse подходит, а когда лучше выбрать другую базу;
- с чего начать изучение ClickHouse новичку.
ClickHouse, OLAP база данных с открытым исходным кодом, отличается удивительной скоростью и исключительной производительностью при реализации самых разных сценариев хранения и аналитики данных.
Быстрый рост популярности этой СУБД свидетельствует о ее высокой производительности, благодаря которой она стала важной частью технологических стеков таких известных компаний, как eBay, Microsoft, Lyft, IBM и др.
Существует множество сравнений, демонстрирующих невероятную скорость работы ClickHouse.

На данный момент подавляющее большинство наиболее быстрых СУБД - это системы, которые могут использовать преимущества графических процессоров и сопроцессоров с очень большим количеством ядер, таких как Intel Xeon Phi или NVidia Tesla. К таким системам баз данных относится, например, BrytlyteDB. Интересно отметить, что ClickHouse, работающая на ноутбуке с процессором Intel Core i5 4670K, 16 ГБ оперативной памяти и SSD SanDisk, показала более высокую производительность, чем 6-узловой кластер Redshift. Таким образом, одноузловая ClickHouse, работающая локально на ноутбуке, является довольно мощным инструментом для быстрого исследования и анализа данных.

Ключевые особенности
Отличительные особенности ClickHouse, которые пригодятся самым разным специалистам по работе с данными:
- ClickHouse доступен как в виде продукта с открытым исходным кодом, так и в виде облачного предложения на AWS, Azure и GCP. На момент написания статьи Azure находится в стадии бета-версии. ClickHouse обладает такими преимуществами управляемых предложений, как автоматическое масштабирование, модель оплаты за использование, раздельное масштабирование хранилищ и вычислений и т.д.
- ClickHouse - это многоузловая система баз данных, допускающая горизонтальное масштабирование. Она может выполнять части запросов сразу на нескольких узлах.
- Комбинация столбцового хранения данных в ClickHouse и движка запросов Vectorized в несколько раз повышает эффективность аналитических запросов. Эти функции особенно полезны для обработки типичных аналитических запросов, объединяющих большое количество строк. Благодаря тому, что данные хранятся по столбцам, их можно быстро агрегировать.
- ClickHouse - это очень быстрая OLAP-СУБД, оптимизированная для агрегирования большого количества данных. Поскольку это не OLTP-система, она не предназначена для выполнения большого количества мутаций данных. Операции обновления и удаления асинхронны, поддержка транзакций отсутствует. Кроме того, ClickHouse не рассчитана на обработку большого количества параллельных соединений, поэтому по достижении определенного масштаба ее следует использовать в качестве хранилища данных, где запросы приложений и пользователей направляются к витринам данных.
Настройка локального 3-узлового кластера ClickHouse
Первым шагом при работе с ClickHouse является создание локального кластера ClickHouse. Для выполнения примеров кода в этой статье я создал кластер из трех узлов с одной репликой, используя Docker и Docker Compose. Итак, сначала убедитесь в том, что Docker и Docker Composed уже установлены.
Обязательные условия
Я предпочитаю использовать Docker Desktop, поскольку он поставляется с Docker и Docker Compose и имеет приятный интерфейс.
- Загрузить и установить Docker Desktop на Ваш компьютер можно здесь.
- Убедитесь в том, что Docker и Docker Compose работают должным образом
NB: вместо Docker-Compose я использую команду Docker Compose, поскольку первая команда является рекомендуемой для Docker Compose V2.
Настройка кластера
Далее необходимо клонировать следующий репозиторий.
Или же просто скачайте и распакуйте код.
Затем в терминале перейдите в папку, содержащую клонированный репозиторий, и запустите кластер с помощью следующей команды:
docker compose up
Эта команда запускает 3-узловой кластер, на всех 3 узлах которого работают ClickHouse и ClickHouse Keeper.

Для того, чтобы убедиться, что работают все 3 кластера, выполните команду docker compose :

Наш локальный кластер состоит из 3 узлов, каждый из которых имеет 4 ГБ оперативной памяти и 2 процессора. Этот код можно модифицировать для работы на 2 или даже на 1 узле. Однако помните, что запускать ClickHouse Keeper рекомендуется на нечетном количестве узлов.
Так, если есть 2 узла ClickHouse, на третьем узле должен работать только ClickHouse Keeper. Кроме того, в производственных средах рекомендуется запускать ClickHouse Keeper на отдельных узлах.
Альтернативное решение - настройка экземпляра ClickHouse с одним узлом
Если Вы не хотите запускать кластер из 3 узлов, можно запустить ClickHouse автономно в контейнере Docker, используя официальный образ:
https://hub.docker.com/r/clickhouse/clickhouse-server/
Подключение к кластеру
Подключиться к ClickHouse можно с помощью java-драйвера ClickHouse, который можно загрузить отсюда.
В качестве клиента базы данных я предпочитаю использовать DBeaver, который можно скачать, пройдя по этой ссылке.
Для подключения к первому узлу ClickHouse выберите в DBeaver опцию создание нового соединения, а затем - драйвер ClickHouse (он должен соответствовать используемой Вами версии ClickHouse, драйвер не должен быть устаревшим).

Для подключения к 1 узлу установите localhost и порт 8123. Имя пользователя - по умолчанию, пароль отсутствует:
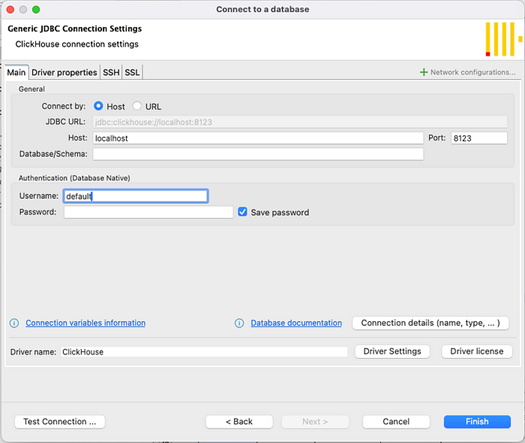
Для проверки соединения выберите Test Connection:

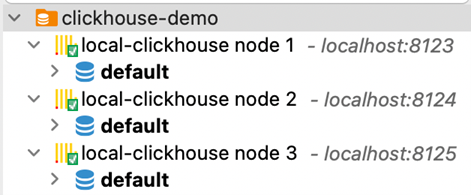
Аналогичным образом создайте еще 2 подключения, второе - к узлу 2 (порт: 8124, остальные параметры остаются прежними), а третье - к узлу 3 (порт: 8125, остальные параметры остаются прежними). Убедитесь в том, что Вы можете подключиться ко всем 3 узлам:
На любом узле выполните следующую команду:
SELECT version();
Он должен вывести текущую версию ClickHouse. Далее запустите код SQL:
SELECT * FROM system.clusters;
Информация о кластере о ClickHouse

Для завершения процесса установки нажмите Ctrl + C в окне терминала или на вкладке, где была выполнена команда docker compose up. Это приведет к завершению работы узлов. Далее, для того, чтобы очистить узлы и при необходимости начать все заново используйте команду docker compose down. Файлы clickhouse-server.log и clickhouse-server.err.log, находящиеся в папках logs/logs_1, logs/logs_2 и logs/logs_3, лучше удалить, - так Вы сможете изолировать журналы, которые помогут Вам в диагностике любых проблем, с которыми Вы можете столкнуться в дальнейшем.
В производственных средах рекомендуется не включать пользователя по умолчанию. Вместо этого создайте пользователей с правами в соответствии с их потребностями и целями использования. Для настройки пользователей и соответствующих параметров пройдите по ссылке.
Данные в ClickHouse мы пока не загружали, процесс загрузки данных будет описан чуть позже.
Движки таблиц ClickHouse
Движки таблиц играют центральную роль в оптимизации работы ClickHouse. Они определяют, как хранятся данные, как обрабатываются запросы, как предоставляется доступ к данным и т. д. Выбор правильного движка требует понимания основных семейств движков, способов хранения данных, возможности замены. Согласно официальной документации ClickHouse движки определяют следующее:
- Как и где хранятся данные, куда их записывать и откуда читать.
- Какие запросы поддерживаются, каким образом.
- Одновременный доступ к данным.
- Использование индексов, если они есть.
- Возможно ли многопоточное выполнение запросов.
- Параметры репликации данных.
Подробная информация касательно движков таблиц в ClickHouse доступна по ссылке.
Важно отметить то, что ClickHouse позволяет выбирать различные движки для хранения данных в материализованных представлениях, об этом мы поговорим чуть позже. А пока давайте рассмотрим некоторые наиболее востребованные семейства движков:
- MergeTree: Семейство движков MergeTree - наиболее широко используемое и надежное семейство движков, подходящее для большинства случаев использования.
- ReplicatedMergeTree: реплицируемая версия семейства движков MergeTree, поддерживающая репликацию данных для обеспечения высокой доступности в многоузловых кластерах ClickHouse. Рекомендуется для использования на производстве, за исключением случаев с одноузловым кластером.
В нашем примере кластер не имеет репликации, так как он настроен на обслуживание только одной копии данных, поэтому мы не сможем увидеть репликацию в действии. Однако ссылки в разделе «Настройка кластера» содержат подробную документацию, а также примеры Docker Compose, которые можно использовать в качестве справочника.
- Log: В семейство движков Log входит TinyLog, рекомендованный для работы с небольшими объемами данных (до 1 млн строк) и быстрой вставки данных. Во многих учебниках и примерах ClickHouse используется именно это семейство движков ввиду его простоты.
- Специальные движки: Сюда входят специальные движки, такие как Distributed, Dictionary и File, которые используются для создания распределенных таблиц между узлами кластера ClickHouse.
- Движки интеграции: Они используются для подключения к внешним источникам данных. Например, движок PostgreSQL позволяет подключаться к данным на экземпляре PostgreSQL и выполнять там запросы.
Семейство движков MergeTree (и ReplicatedMergeTree)
Семейство движков MergeTree - самое надежное и популярное среди специалистов по работе с данными, оно предназначено для работы с большими объемами данных. В этом разделе мы как раз будем работать с таблицами MergeTree.
Подробную документацию по MergeTree можно найти по ссылкам:
Данные в таблицах MergeTree сортируются по столбцам (или выражениям) ключа сортировки в блоки, называемые гранулами, по 8192 строки (этот параметр можно настраивать, по умолчанию его значение = 8192). Если ключ сортировки содержит больше столбцов или выражений, данные будут сначала сортироваться по первому столбцу ключа сортировки, а в пределах каждого значения первого столбца будут сортироваться по второму ключу, и так далее. Каждая гранула имеет метку, в которой хранятся значения ключевых столбцов для данного блока.
Первичный ключ необязателен, его можно указать в том случае, если он отличается от ключа сортировки. Если первичный ключ не указан, ключ сортировки становится первичным ключом таблицы.
Данные сортируются по ключу сортировки, а метки ключа сортировки (значения столбцов ключа сортировки в начале каждой гранулы) используются для поиска строк, запрашиваемых фильтрами запроса. Поэтому ключ сортировки следует выбирать в соответствии с шаблонами использования распространенных запросов для быстрого извлечения данных. Таким образом, движки семейства MergeTree должны быть настроены на запросы, выполняемые в таблице, иначе для поиска нужных строк придется просканировать достаточно много данных (если не все данные).
Важной особенностью семейства MergeTree является то, как работают ключи и метки сортировки при определении данных для сканирования и как работают фильтры запросов. Об этом подробно рассказывается в документации ClickHouse по семейству движков MergeTree – ссылка.
В качестве демонстрационных данных используется популярный набор данных TLC Trip Record. Данные содержат записи о поездках на желтых и зеленых такси в Нью-Йорке, в которых указаны места посадки и высадки, стоимость проезда, чаевые, расстояние и т. д. Этот набор данных можно скачать по ссылке.
Загрузите отчеты о поездках «Желтого такси» за 2021, 2022 и 2023 годы. Это будут файлы в формате Parquet. Сохраните их в папках data/rides_2021, data/rides_2022 и data/rides_2023 соответственно:
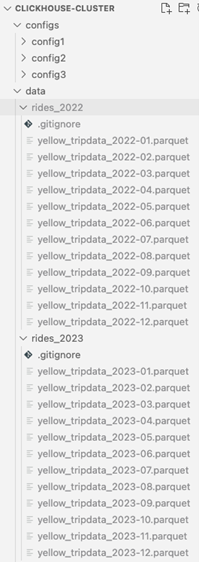
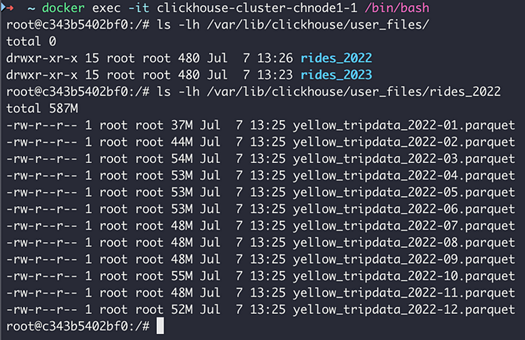
Папка data была перемещена в папку /var/lib/clickhouse/user_files на всех узлах кластера ClickHouse. Подключите свой терминал к узлу 1, выполнив следующие команды:
docker exec -it clickhouse-cluster-chnode1-1 /bin/bash
ls -lh /var/lib/clickhouse/user_files/
ls -lh /var/lib/clickhouse/user_files/rides_2022
Файлы данных, доступные на узле 1:
Для перечисления всех работающих узлов кластера и получения их имен для команды docker exec Вы можете использовать команду docker ps.
Создание базы данных поездок и таблиц заказов
Создадим таблицы и загрузим в них данные, но сначала создадим базу данных для хранения этих таблиц. Запустите следующий SQL-код из DBeaver (или любого клиента, который Вы используете для подключения к ClickHouse) на узле 1 (или любом другом узле).
CREATE database rides ON CLUSTER 'cluster_3S_1R';
После этого нажмите кнопку refresh на всех 3 узлах кластера, только что созданная база данных должна быть видна на всех 3 узлах:
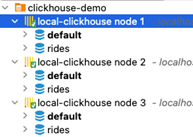
Затем на первом узле создайте таблицу:
CREATE TABLE rides.trips
(
    VendorID Int32,
    tpep_pickup_datetime DateTime64(6),
    tpep_dropoff_datetime DateTime64(6),
    passenger_count Nullable(Int64),
    trip_distance Nullable(Float64),
    RatecodeID Nullable(Int64),
    store_and_fwd_flag Nullable(String),
    PULocationID Int32,
    DOLocationID Int32,
    payment_type Nullable(Int64),
    fare_amount Nullable(Float64),
    extra Nullable(Float64),
    mta_tax Nullable(Float64),
    tip_amount Nullable(Float64),
    tolls_amount Nullable(Float64),
    improvement_surcharge Nullable(Float64),
    total_amount Nullable(Float64),
    congestion_surcharge Nullable(Float64),
    Airport_fee Nullable(Float64)
)

ENGINE = MergeTree
PARTITION BY toYYYYMM(tpep_pickup_datetime)
ORDER BY (tpep_pickup_datetime, tpep_dropoff_datetime, PULocationID, DOLocationID)
SETTINGS index_granularity = 8192;
Таблица поездок создается на первом узле базы данных. Она доступна для запросов только с первого узла. Алгоритм создания распределенных таблиц, доступных со всех трех узлов, описывается в последующих разделах этой статьи. А сейчас давайте вставим данные в таблицу.
INSERT INTO rides.trips FROM INFILE '/var/lib/clickhouse/user_files/rides_2023/*.parquet' FORMAT Parquet;
Выполнение этого запроса на клиенте выдаст следующую ошибку:
SQL Error [78] [07000]: Code: 78. DB::Exception: Query has infile and was send directly to server. (UNKNOWN_TYPE_OF_QUERY) (version 24.5.3.5 (official build)), server ClickHouseNode [uri=http://localhost:8123/default, options={use_server_time_zone=false,use_time_zone=false}]
Этот запрос нужно будет выполнить из клиента ClickHouse на самом узле. Подключите терминал к узлу 1 и выполните следующие команды:
docker exec -it clickhouse-cluster-chnode1-1 /bin/bash
clickhouse-client
Для этого, конечно, необходимо, чтобы на узле присутствовал клиент ClickHouse. Он должен быть установлен и доступен на всех узлах кластера. Ссылка.
Выполните тот же запрос на вставку на клиенте ClickHouse:
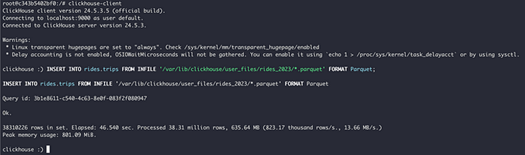
NB: Обратите внимание, что вставка может не произойти, если каждый узел имеет менее 4 ГБ оперативной памяти. Если Вы используете компьютер с недостаточным объемом оперативной памяти, данные можно вставлять пофайлово.
Набор содержит 38,31 миллиона строк. Запустим подсчет строк и агрегацию общего тарифа. Теперь его можно выполнить из клиента. Выполните следующие два запроса:
SELECT sum(total_amount), avg(total_amount), count(1) AS num_rows
FROM rides.trips t;

explain (
        SELECT sum(total_amount), avg(total_amount), count(1)
        FROM rides.trips t
)
Результат их выполнения будет следующим:
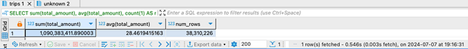
Результат был получен очень быстро, на моем компьютере на суммирование, усреднение и подсчет значений всех 38 миллионов строк ушло чуть больше 0,5 секунды. Давайте посмотрим план запроса:
explain                                                                       |
------------------------------------------------------------------------------+
Expression ((Project names + Projection))                                     |
  Aggregating                                                                 |
    Expression ((Before GROUP BY + Change column names to column identifiers))|
      ReadFromMergeTree (rides.trips)                                         |
Этот план запроса показывает простое сканирование всего набора данных, за которым следуют операции агрегирования. Далее выполним фильтрацию по tpep_pickup_datetime, одному из столбцов упорядочивания:
SELECT sum(total_amount), avg(total_amount), count(1) AS num_rows
FROM rides.trips t
WHERE tpep_pickup_datetime >= '2023-05-01 00:00:00' AND tpep_pickup_datetime < '2023-06-01 00:00:00';
Этот запрос выполняется очень быстро, даже быстрее, чем предыдущий. На моем компьютере он осуществился быстрее 0,1 секунды, и хотя в конечном результате использовалось более 3 миллионов строк, это было действительно быстро.
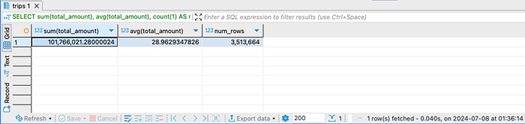
Для сравнения давайте отфильтруем столбец, который не является частью ключа сортировки, т.е. passenger_count, и отфильтруем по нему:
SELECT sum(total_amount), avg(total_amount), count(1) AS num_rows
FROM rides.trips t
WHERE passenger_count = 6
Этот запрос выполняется медленнее, поскольку для его обработки сканируется весь набор данных. Хотя количество строк, возвращаемых фильтром, значительно меньше, система все же не может воспользоваться всеми преимуществами фильтра, поскольку данные не упорядочены по столбцу passenger_count. На моем компьютере обработка этого запроса занимает от 0,3 до 0,7 секунды, что аналогично времени, затрачиваемому на выполнение примера с агрегацией всех данных.
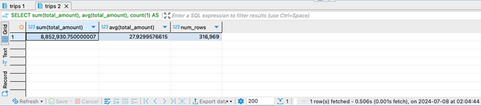
Это наглядно демонстрирует преимущество оптимизации таблиц для частых запросов, поскольку меньшее количество сканируемых данных приводит к более быстрому выполнению запросов к большим наборам данных.
Далее рассмотрим материализованные представления и движок SummingMergeTree.
Движок SummingMergeTree
SummingMergeTree - это вариант MergeTree, который суммирует все числовые столбцы всех строк ключа сортировки. Если для ключа сортировки подходят сразу несколько строк, они объединяются в одну строку, числовые столбцы которой равны сумме значений в строках.
Официальное руководство по ClickHouse рекомендует использовать MergeTree для хранения данных, а SummingMergeTree - для данных, которые используются в отчетах: ссылка.
Следует также отметить и то, что данные суммируются со временем, что подразумевает возможность того, что некоторые части не будут агрегированы, поскольку они еще не были объединены. Для объединения всех оставшихся частей можно выполнить запрос OPTIMIZE. Эта и другие хитрости, касающиеся движка SummingMergeTree подробно описаны здесь.
Обратите внимание и на то, что механизмы ReplicatedMergeTree и ReplicatedSummingMergeTree также доступны для таблиц с репликацией.
Материализованные представления
Материализованные представления в ClickHouse - это предварительно заполненные представления, которые позволяют ускорить выполнение запросов за счет переноса сложных операций на процесс INSERT вместо запросов на получение данных. Материализованные представления обновляются при вставке новых данных в исходную таблицу(ы) в режиме реального времени. В официальном руководстве ClickHouse дается следующее описание материализованных представлений:
Материализованные представления позволяют пользователям перенести стоимость вычислений со времени запроса на время вставки, что приводит к ускорению запросов SELECT.
В отличие от транзакционных баз данных, таких как Postgres, материализованное представление ClickHouse - это просто триггер, выполняющий запрос на блоки данных по мере их вставки в таблицу. Результат этого запроса вставляется во вторую «целевую» таблицу.
и
Материализованные представления в ClickHouse обновляются в режиме реального времени по мере поступления данных в таблицу, на которой они основаны, функционируя подобно постоянно обновляемым индексам.
Более подробная информация доступна по ссылке.
Основным преимуществом использования материализованных представлений в ClickHouse является перенос сложной обработки на процесс вставки, что делает каждый запрос более простым и быстрым (если он направлен на представления). Это не только повышает производительность, но и снижает нагрузку на систему во время выполнения запроса. Благодаря предварительному вычислению и хранению результатов сложных запросов материализованные представления позволяют значительно сократить время получения искомых данных.

Вот синтаксис материализованных представлений в документации CREATE VIEW:
CREATE MATERIALIZED VIEW [IF NOT EXISTS] [db.]table_name [ON CLUSTER] [TO[db.]name] [ENGINE = engine] [POPULATE]
[DEFINER = { user | CURRENT_USER }] [SQL SECURITY { DEFINER | INVOKER | NONE }]
AS SELECT ...
Флаг POPULATE заполняет представление существующими данными в исходной таблице. Если он не указан, то все новые данные, которые будут добавляться в таблицу, будут вставлены в представление (это не относится к тем данным, которые существовали до создания get). Однако разработчики Clickhouse не рекомендуют его использовать, так как любые данные, вставляемые в таблицу в момент создания представления, не будут вставлены в представление.
Кроме того, как видно из синтаксиса, можно указать движок, который может отличаться от движка таблицы-источника. Выбор правильного движка таблицы - это ключ к максимальной производительности работы с таблицами и представлениями.
Давайте посмотрим на этот процесс в действии. Создайте представление, которое суммирует поездки по дате поездки, идентификатору поставщика услуги и месту посадки пассажира. Для суммирования столбцов passenger_count, trip_distance, total_amount и congestion_surcharge оно будет использовать механизм SummingMergeTree:
CREATE MATERIALIZED VIEW rides.trips_by_origin ENGINE SummingMergeTree() ORDER BY (VendorID, pickup_date, PULocationID) POPULATE
AS
SELECT VendorID, PULocationID, toDate(tpep_pickup_datetime) AS pickup_date, passenger_count, trip_distance, fare_amount, total_amount, congestion_surcharge
FROM rides.trips;
Здесь мы определили ключ сортировки как VendorID, pickup_date, PULocationID. Остальные столбцы суммируются. Поскольку присутствует флаг POPULATE, данные из таблицы также вставляются в представление. Создание представления на моем компьютере заняло всего несколько секунд, поскольку оно выполнило агрегирование всех данных в таблице. По завершении данного процесса можно отправить следующий запрос:
SELECT *
FROM rides.trips_by_origin tbo
LIMIT 10;
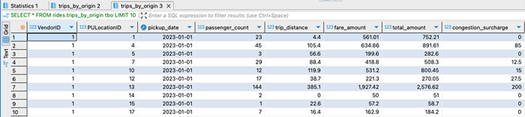
Далее выполним два запроса: один - к представлению, второй - к таблице:
SELECT *
FROM rides.trips_by_origin
WHERE VendorID = 1 and PULocationID = 1 and pickup_date = '2023-01-01';

SELECT VendorID, PULocationID, tpep_pickup_datetime, passenger_count, trip_distance, fare_amount, total_amount, congestion_surcharge
FROM rides.trips t
WHERE VendorID = 1 and PULocationID = 1 and toDate(tpep_pickup_datetime) = '2023-01-01';
В данном случае первый запрос фильтрует строки с VendorID = 1, PULocationID = 1 и pickup_date = 01-01-2023. В результате мы получаем только одну строку, потому что механизм SummingMergeTree объединяет все строки для каждого значения ключа сортировки в одну строку:

Тогда как второй запрос возвращает все строки из таблицы:
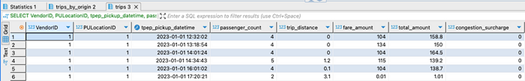
Обратите внимание на то, что в определении материализованного представления мы не использовали выражение Group By, но благодаря использованию SummingMergeTree все строки с одинаковым значением ключа сортировки сворачиваются в одну строку, а числовые столбцы суммируются в ней. В этом можно достаточно легко убедиться. Если вместо SummingMergeTree используется движок MergeTree, представление будет содержать все строки:
CREATE MATERIALIZED VIEW rides.trips_by_origin_test ENGINE MergeTree() ORDER BY (VendorID, pickup_date, PULocationID) POPULATE
AS
SELECT VendorID, PULocationID, toDate(tpep_pickup_datetime) AS pickup_date, passenger_count, trip_distance, fare_amount, total_amount, congestion_surcharge
FROM rides.trips;

SELECT VendorID, PULocationID, pickup_date, passenger_count, trip_distance, fare_amount, total_amount, congestion_surcharge
FROM rides.trips_by_origin_test t
WHERE VendorID = 1 and PULocationID = 1 and pickup_date = '2023-01-01';

DROP VIEW rides.trips_by_origin_test;
Результат запроса, приведенного выше:
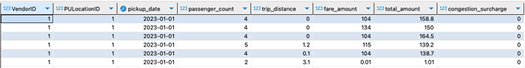
Представления можно удалить с помощью запроса DROP VIEW.
Далее рассмотрим строки в представлении по месяцам и годам:
SELECT toMonth(pickup_date) mnth, toYear(pickup_date) AS yr, count(1)
FROM rides.trips_by_origin tbo
GROUP BY mnth, yr
ORDER BY mnth, yr;
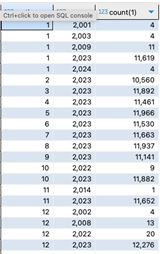
Представление содержит данные в таблице, которые в основном относятся к 2023 году. В нем также есть несколько строк 2001, 2003, 2009 и других годов.
Если в таблицу вставляются новые строки, представление обновляется. Для демонстрации вставим строки за январь 2024 года. Скачайте файл Parquet, содержащий данные, и вставьте его в папку data/rides_2024 в хранилище. Как уже говорилось, эта папка создана на всех трех узлах кластера. Далее подключитесь к первому узлу, как было показано ранее, и вставьте данные с помощью клиента ClickHouse, после чего представление обновится:
INSERT INTO rides.trips FROM INFILE '/var/lib/clickhouse/user_files/rides_2024/*.parquet' FORMAT Parquet;
После вставки выполните тот же запрос, что и выше, в результате Вы увидите, что количество строк для января 2024 года в представлении будет обновлено:
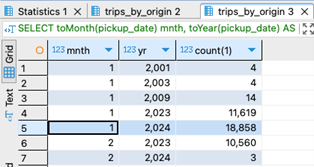
Кроме того, в синтаксисе SQL для создания материализованных представлений есть необязательный пункт TO <table>, который отправляет результат запроса представления для заполнения целевой таблицы. Представления - это очень мощная концепция ClickHouse, мнжество примеров ее использования доступны по ссылке.
В этой статье из блога ClickHouse рассказывается об объединении материализованных представлений с целью создания конвейера, который заполняет несколько таблиц, созданных на основе потоковой таблицы, подключенной к Kafka.
Эта статья прекрасно демонстрирует всю мощь и гибкость материализованных представлений в ClickHouse.
Мутации в ClickHouse
В ClickHouse операции UPDATE и DELETE называются мутациями. Мутации реализованы как асинхронные процессы, выполняющиеся в фоновом режиме, и их эффект не проявляется мгновенно, поскольку запрошенные операции не применяются сразу. Можно отслеживать ход выполнения мутаций, поскольку команды, выдающие мутации, возвращаются немедленно. Мы рассмотрим способ проверки прогресса мутаций чуть позже.
Мутации выполняются с помощью предложения запроса ALTER TABLE, в этой статье приведен полный список операций мутации.
Важно помнить, что ClickHouse создан как хранилище данных. Кроме того, предполагается, что изменения в существующих данных будут происходить нечасто и в больших объемах. В общем, ожидается, что данные, хранящиеся в ClickHouse, не будут меняться, а вставки будут осуществляться партиями больших данных.
Далее рассмотрим операции обновления и удаления в действии:
ALTER TABLE … UPDATE и DELETE
Для обновления строк используется предложение запроса ALTER TABLE <имя таблицы> UPDATE. Его синтаксис выглядит следующим образом:
ALTER TABLE [db.]table [ON CLUSTER cluster] UPDATE column1 = expr1 [, ...] [IN PARTITION partition_id] WHERE filter_expr
По умолчанию эта операция является асинхронной и может начаться или завершиться не сразу. Кроме того, невозможно обновить ключевые столбцы. Обновление - это тяжелая операция, требующая обновления данных во многих частях. Попробуем обновить количество пассажиров в каждой поездке, добавив к нему 1. Запрос на обновление будет выглядеть следующим образом:
ALTER TABLE rides.trips UPDATE passenger_count = passenger_count + 1;
Но вместо того, чтобы выполнить обновление, запрос возвращает ошибку:
SQL Error [62] [07000]: Code: 62. DB::Exception: Syntax error: failed at position 69 (end of query): . Expected one of: token, DoubleColon, Comma, IN PARTITION, WHERE. (SYNTAX_ERROR)
Это связано с тем, что в синтаксисе запроса обновления не обойтись без WHERE. Изменение строк - тяжелая операция, и ClickHouse не позволяет выполнять ее для всех данных. Поскольку условие where является обязательным, можно выполнить запрос с условием WHERE TRUE, но делать это следует с осторожностью. Данных в нашей таблице не так уж и много, поэтому давайте запустим обновление:

Предложение Update возвращается немедленно и запускает асинхронную операцию UPDATE.
Статус мутаций можно проверить с помощью запроса к таблице system.mutations:
SELECT database, table, command, create_time, is_done
FROM system.mutations;
Результат выполнения запроса:

В запросе видно, что операция UPDATE завершена, так как is_done равно 1. Когда мутация находится в процессе, оно равно 0.
Далее для некоторых строк обновим дату получения:
ALTER TABLE rides.trips UPDATE tpep_pickup_datetime = toDateTime('2025-01-01 00:00:00') WHERE tpep_pickup_datetime < '2022-01-01';
Результатом запроса будет следующая ошибка:
SQL Error [420] [07000]: Code: 420. DB::Exception: Cannot UPDATE key column `tpep_pickup_datetime`. (CANNOT_UPDATE_COLUMN) (version 24.5.3.5 (official build))
Обновление невозможно, поскольку ключевые столбцы обновлять нельзя.
Как и обновление, операция удаления также является мутацией, ее синтаксис выглядит следующим образом:
ALTER TABLE [db.]table [ON CLUSTER cluster] DELETE WHERE filter_expr
Ссылка на официальное руководство.
Несмотря на то, что UPDATE и DELETE являются мутациями и по умолчанию выполняются асинхронно, можно заставить запрос ждать завершения мутаций, а также настроить ожидание момента, пока все реплики не будут обновлены. Это можно сделать с помощью параметра mutations_sync.
Более подробная информация доступна по ссылке.
Облегченный DELETE для движка MergeTree
Для таблиц, использующих вижок MergeTree, доступна облегченная операция DELETE. Она использует синтаксис DELETE FROM и работает путем пометки строк как удаленных, в результате чего они не появляются в последующих запросах. Затем, во время следующей операции слияния строки, помеченные как удаленные, очищаются. Об облегченной операции удаления, ее ограничениях, плюсах и минусах, а также о случаях использования читайте здесь.
Удаление большого количества данных путем сброса партиций
Удалять данные рекомендуется путем сброса целых партиций (именно за счет этого достигается высокая скорость проведения операций удаления данных). Это возможно в том случае, если фильтр операции удаления совпадает с ключом раздела таблицы.
В нашем примере таблица rides.trips разбита на партиции по месяцам и годам. В операторе создания таблицы ключ раздела был указан как PARTITION BY toYYYYMM(tpep_pickup_datetime). Поэтому мы можем отказаться от партиций для определенных месяцев, удалив все данные за этот месяц. Например, если мы хотим удалить данные за июнь 2023 года, мы должны выполнить следующий запрос:
ALTER TABLE rides.trips DROP PARTITION '202306';
Данных за июнь 2023 года больше нет:
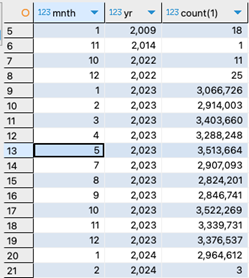
Помимо сбрасывания партиций их можно отсоединять или присоединять. Так, для массовой замены или обновления данных можно создать временную таблицу и заполнить ее данными.
Затем, после выполнения проверок, можно присоединить к конечной таблице новые партиции, отсоединив разделы, содержащие старые данные.
Данный процесс можно представить следующим образом:

Несмотря на то, что эта статья посвящена PostgreSQL, описанные в ней концепции можно применять и в Clickhouse. Однако знайте, что в виду различий в системах баз данных синтаксис и некоторые механизмы могут отличаться. Подробности, как всегда, Вы найдете в официальном руководстве Clickhouse.
В этой статье подробно рассматриваются доступные в ClickHouse механизмы для обновления и удаления данных, каждый из которых имеет свои плюсы и минусы. Настоятельно рекомендую Вам прочитать ее.
Таким образом, обновление и удаление данных в ClickHouse являются асинхронными операциями, налагающими на ключевые столбцы определенные ограничения. Кроме того, данная СУБД предоставляет возможность осуществления массовых операций, таких как удаление целых партиций. Используя эти возможности, Вы сможете оптимизировать работу с ClickHouse и повысить эффективность процессов обработки данных.
Распределенная таблица - использование движка DistributedTable
Пока что все созданные нами таблицы находятся на одном узле кластера. В ClickHouse можно создавать таблицы, охватывающие сразу несколько узлов. Более того, можно создавать таблицы, охватывающие все узлы, и все части этих таблиц реплицируются на узлах-репликах, если они существуют. Распределенные таблицы можно создавать с помощью движка Distributed.
Распределенная таблица не хранит никаких данных и представляет собой логическую сущность над набором физических таблиц. В официальном руководстве ClickHouse движок распределенных таблиц описан следующим образом:
Таблицы с движком Distributed не хранят никаких собственных данных, но позволяют обрабатывать запросы на нескольких серверах.
Чтобы продемонстрировать это, мы создадим три таблицы с именем rides.trips_part на всех трех узлах. Таблица на узле 1 будет содержать данные за 2023 год, таблица на узле 2 - за 2022 год, а таблица на узле 3 - за 2021 год:

Первым шагом будет создание таблицы на всех 3 узлах и вставка в нее данных. Подключитесь ко всем 3 узлам с помощью команды docker exec, как было показано ранее. С помощью команды docker ps узнайте имена подов, работающих на узлах. Затем создайте таблицы и загрузите в них данные:
docker exec -it clickhouse-cluster-chnode1-1 /bin/bash
<on the pod>
clickhouse-client

CREATE TABLE rides.trips_part
(
    VendorID Int32,
    tpep_pickup_datetime DateTime64(6),
    tpep_dropoff_datetime DateTime64(6),
    passenger_count Nullable(Int64),
    trip_distance Nullable(Float64),
    RatecodeID Nullable(Int64),
    store_and_fwd_flag Nullable(String),
    PULocationID Int32,
    DOLocationID Int32,
    payment_type Nullable(Int64),
    fare_amount Nullable(Float64),
    extra Nullable(Float64),
    mta_tax Nullable(Float64),
    tip_amount Nullable(Float64),
    tolls_amount Nullable(Float64),
    improvement_surcharge Nullable(Float64),
    total_amount Nullable(Float64),
    congestion_surcharge Nullable(Float64),
    Airport_fee Nullable(Float64)
)

ENGINE = MergeTree
PARTITION BY toYYYYMM(tpep_pickup_datetime)
ORDER BY (tpep_pickup_datetime, tpep_dropoff_datetime, PULocationID, DOLocationID)
SETTINGS index_granularity = 8192;

INSERT INTO rides.trips_part FROM INFILE '/var/lib/clickhouse/user_files/rides_2023/*.parquet' FORMAT Parquet;
Сделайте то же самое и со 2 узлом:
docker exec -it clickhouse-cluster-chnode2-1 /bin/bash
<on the pod>
clickhouse-client

CREATE TABLE rides.trips_part
(
    VendorID Int32,
    tpep_pickup_datetime DateTime64(6),
    tpep_dropoff_datetime DateTime64(6),
    passenger_count Nullable(Int64),
    trip_distance Nullable(Float64),
    RatecodeID Nullable(Int64),
    store_and_fwd_flag Nullable(String),
    PULocationID Int32,
    DOLocationID Int32,
    payment_type Nullable(Int64),
    fare_amount Nullable(Float64),
    extra Nullable(Float64),
    mta_tax Nullable(Float64),
    tip_amount Nullable(Float64),
    tolls_amount Nullable(Float64),
    improvement_surcharge Nullable(Float64),
    total_amount Nullable(Float64),
    congestion_surcharge Nullable(Float64),
    Airport_fee Nullable(Float64)
)

ENGINE = MergeTree
PARTITION BY toYYYYMM(tpep_pickup_datetime)
ORDER BY (tpep_pickup_datetime, tpep_dropoff_datetime, PULocationID, DOLocationID)
SETTINGS index_granularity = 8192;

INSERT INTO rides.trips_part FROM INFILE '/var/lib/clickhouse/user_files/rides_2022/*.parquet' FORMAT Parquet;
Теперь – очередь 3 узла:
docker ps
docker exec -it clickhouse-cluster-chnode3-1 /bin/bash
<on the pod>
clickhouse-client

CREATE TABLE rides.trips_part
(
    VendorID Int32,
    tpep_pickup_datetime DateTime64(6),
    tpep_dropoff_datetime DateTime64(6),
    passenger_count Nullable(Int64),
    trip_distance Nullable(Float64),
    RatecodeID Nullable(Int64),
    store_and_fwd_flag Nullable(String),
    PULocationID Int32,
    DOLocationID Int32,
    payment_type Nullable(Int64),
    fare_amount Nullable(Float64),
    extra Nullable(Float64),
    mta_tax Nullable(Float64),
    tip_amount Nullable(Float64),
    tolls_amount Nullable(Float64),
    improvement_surcharge Nullable(Float64),
    total_amount Nullable(Float64),
    congestion_surcharge Nullable(Float64),
    Airport_fee Nullable(Float64)
)

ENGINE = MergeTree
PARTITION BY toYYYYMM(tpep_pickup_datetime)
ORDER BY (tpep_pickup_datetime, tpep_dropoff_datetime, PULocationID, DOLocationID)
SETTINGS index_granularity = 8192;

INSERT INTO rides.trips_part FROM INFILE '/var/lib/clickhouse/user_files/rides_2021/*.parquet' FORMAT Parquet;
После выполнения команд на всех трех узлах обновите соединения с ними на DBeaver, вновь созданные таблицы должны стать видимыми:
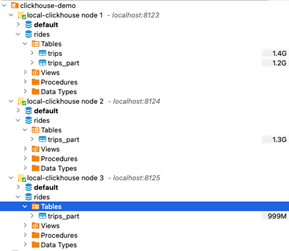
NB: для создания таблицы на всех трех узлах можно выполнить запрос create table с предложением on cluster <cluster_name>. Загрузку данных придется выполнять на каждом узле по отдельности. Чтобы узнать имя кластера, выполните команду show clusters.
Для получения дополнительной информации о выполнении распределенных DDL-запросов сразу на всем кластере, а не на отдельных узлах, пройдите по этой ссылке.
Далее перейдем к созданию распределенной таблицы:
CREATE TABLE rides.trips_distributed on cluster 'cluster_3S_1R' AS rides.trips_part
ENGINE Distributed('cluster_3S_1R', rides, trips_part, toYear(tpep_pickup_datetime));
Здесь мы указали условие on cluster, поэтому распределенная таблица будет создана на всех трех узлах.
Кроме того, мы указали необязательный ключ шардинга как toYear(tpep_pickup_datetime). Это требование необходимо для вставки данных в распределенную таблицу, оно будет рассмотрено чуть позже.
Вот ссылка на документацию по движку DistributedTable, содержащую синтаксис и другие подробности определения и использования распределенных таблиц в ClickHouse.
Теперь проверим подсчеты и другие данные:
select count(1) from rides.trips_distributed;
explain(select count(1) from rides.trips_distributed);

SELECT  toYear(tpep_pickup_datetime) AS yr, toMonth(tpep_pickup_datetime) mnth, count(1)
FROM rides.trips_distributed dist
GROUP BY yr, mnth
ORDER BY yr, mnth;
Получим следующий план запросов:
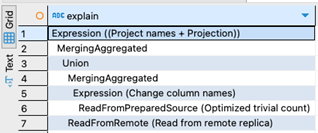
В плане запроса есть ReadFromRemote, указывающее на то, что некоторые данные были получены с других узлов. ClickHouse не только получает эти данные, но и частично обрабатывает их на других узлах (включая группировку и агрегирование), прежде чем отправить их на узел, на котором выполнялся сам запрос. Эта частичная предварительная обработка затем используется для сборки окончательного результата.
Наконец, последний запрос возвращает следующий результат:
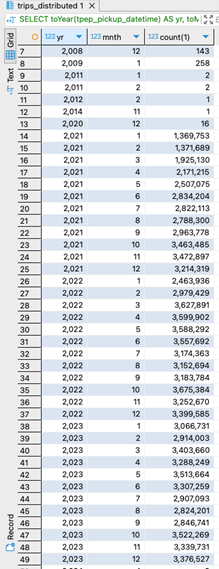
Здесь отображены данные по всем месяцам 2021, 2022 и 2023 годов с указанием количества строк. Результат был получен из таблиц rides.trips_part на всех трех узлах.
Добавление данных в распределенную таблицу
В официальной документации ClickHouse упоминаются два способа вставки данных в распределенные таблицы:
-
Вставка непосредственно в распределенную таблицу. Поскольку сама распределенная таблица является виртуальной сущностью и не содержит никаких данных, данные отправляются на соответствующие узлы, но для них должен быть указан
ключ sharding_key. - Вставка данных непосредственно в базовые таблицы на узлах кластера. В документации этот метод указан как наиболее эффективный и гибкий из всех возможных.
Заключение
В заключение хотим сказать, что ClickHouse - это мощная и универсальная колоночно-ориентированная система управления БД, предназначенная для аналитической обработки данных в режиме реального времени. Она обеспечивает эффективное хранение данных, быструю обработку запросов и гибкое манипулирование данными благодаря таким функциям, как материализованные представления, распределенные таблицы и асинхронные мутации. За счет способности обрабатывать большие объемы данных и быстро выполнять даже самые сложные запросы ClickHouse является по-настоящему бесценным решением. Будь то работа с потоками данных в режиме реального времени или выполнение операций с большими объемами данных, ClickHouse предоставляет все необходимые инструменты для решения самых разнообразных и сложных задач, связанных с обработкой данных.
ClickHouse - это высокопроизводительная система с огромным набором функций, для подробного описания которых потребуется не менее 200 страниц. В этой статье мы лишь поверхностно рассмотрели некоторые ее возможности, что бы Вы могли понять, в каких случаях она Вам может пригодиться.
FAQ
Вопрос: Что такое ClickHouse?
Ответ: ClickHouse — это колоночная OLAP-СУБД с открытым исходным кодом, предназначенная для быстрых аналитических запросов по большим объемам данных.
Вопрос: Для чего используют ClickHouse?
Ответ: ClickHouse используют для BI-отчетов, аналитических витрин, логов, событий, продуктовой аналитики, мониторинга, adtech, финтеха и других сценариев, где нужны быстрые агрегации по большим таблицам.
Вопрос: Почему ClickHouse считается быстрой базой данных?
Ответ: ClickHouse хранит данные по колонкам, эффективно сжимает их и оптимизирована для аналитических запросов. Это позволяет быстро читать только нужные столбцы и выполнять агрегаты на больших объемах данных.
Вопрос: Подходит ли ClickHouse новичкам?
Ответ: Да, если новичок уже знаком с SQL и понимает базовые принципы аналитики данных. Но важно учитывать, что ClickHouse лучше подходит для аналитических нагрузок, а не для классических транзакционных приложений.
Вопрос: Можно ли использовать ClickHouse в облаке?
Ответ: Да, ClickHouse доступен как open-source продукт для самостоятельного развертывания и как управляемые облачные сервисы. Облачный вариант упрощает масштабирование, обслуживание и администрирование.
- FAQ по ClickHouse
- Что такое Parquet: преимущества и случаи использования
- DWH: зачем компании хранилище данных
- Что такое витрина данных и зачем она бизнесу
- ETL и ELT: 5 основных отличий


