

Открытые стандарты для Data Lineage: OpenLineage для пакетной и потоковой обработки данных
Рассмотрим тенденции и способы обеспечения открытого стандарта с помощью OpenLineage, а также то, как решения по управлению данными помогают удовлетворить потребности в управлении данными в масштабах предприятия.
Одно из самых заветных желаний компаний – обеспечение сквозной видимости операционных и аналитических процессов. Откуда поступают данные? Куда они попадают? Кто имеет доступ к данным? Как я могу отслеживать проблемы с качеством данных? Возможность проследить за потоком данных, чтобы ответить на эти вопросы, называется data lieage (линия данных). В этой статье мы рассмотрим современные тенденции и методы создания открытого стандарта OpenLineage, а также то, как решения по управлению данными от таких производителей, как IBM, Google, Confluent и Collibra, помогают удовлетворить потребности большинства компаний в управлении данными в масштабах предприятия, включая технологии потоковой передачи данных, такие как Apache Kafka и Flink..
Что такое Data Governance?
Data Governance относится к общему управлению доступностью, удобством использования, целостностью и безопасностью данных, используемых в организации. Оно включает в себя создание процессов, ролей, политик, стандартов и метрик для обеспечения надлежащего управления данными на протяжении всего их жизненного цикла. Управление данными направлено на обеспечение их точности, целостности, безопасности и соответствия нормативным требованиям и политике организации. Оно включает в себя такие виды деятельности, как управление качеством данных, обеспечение безопасности данных, управление метаданными, а также соблюдение нормативных требований и стандартов, связанных с данными.

В чем заключается ценность Data Governance для бизнеса?
Data Governance имеет очень большое значение для бизнеса:
- Повышение качества данных: DG обеспечивает точность, согласованность и надежность данных, что приводит к оптимизации процесса принятия решений, сокращению количества ошибок и повышению операционной эффективности.
- Повышение соответствия нормативным требованиям: Благодаря разработке политик и процедур DG и обеспечению соответствия таким нормативным требованиям, как GDPR, HIPAA и CCPA, управление данными помогает снизить риски, связанные с несоблюдением требований, включая штрафы и репутационный ущерб.
- Повышение доверия и уверенности: Эффективное DG вызывает у заинтересованных сторон доверие и уверенность в используемых данных. Это приводит к формированию культуры принятия решений на основе данных и развитию сотрудничества между отделами.
- Снижение затрат: Благодаря сокращению избыточности данных, устранению несоответствий данных и оптимизации процессов хранения и обслуживания данных DG помогает организациям минимизировать расходы, связанные с управлением данными и соблюдением нормативных требований.
- Более эффективное управление рисками: DG позволяет организациям выявлять, оценивать и снижать риски, связанные с управлением данными, безопасностью, конфиденциальностью и соблюдением нормативных требований, уменьшая вероятность и последствия инцидентов, связанных с данными.
- Поддержка бизнес-инициатив: DG создает основу для стратегических инициатив, таких как цифровая трансформация, аналитика данных и проекты AI/ML, обеспечивая наличие, доступность и надежность данных для анализа и принятия решений.
- Конкурентное преимущество: Организации с надежной практикой DG могут более эффективно использовать данные для получения глубоких знаний, внедрения инноваций и быстрого реагирования на изменения рынка, что дает им конкурентное преимущество в своей отрасли.
В целом, Data Governance способствует повышению качества данных, соответствия требованиям, доверия, эффективности затрат, управления рисками и конкурентоспособности, что в конечном итоге приводит к улучшению результатов деятельности организации.
Что такое Data Lineage?
Data lineage - это способность проследить полный жизненный цикл данных, от момента их происхождения до каждого преобразования и перемещения по различным системам и процессам. Она обеспечивает детальное понимание того, как данные создаются, изменяются и потребляются в экосистеме данных организации.
Data Lineage - важный компонент управления данными: понимание структуры данных помогает организациям обеспечить качество данных, соответствие нормативным требованиям и соблюдение внутренних политик, обеспечивая видимость потоков и преобразований данных.
Data Lineage не имеет ничего общего с отслеживанием событий!
Отслеживание событий и data lineage – это совершенно разные концепции, которые служат разным целям в сфере управления данными:
Data Lineage
- Линия данных - это возможность отслеживать и визуализировать полный жизненный цикл данных, от момента их происхождения до каждого преобразования и перемещения по различным системам и процессам.
- Линия данных обеспечивает детальное понимание того, как именно создаются данные, как они изменяются и потребляются в экосистеме данных организации, включая информацию об их источнике, применяемых преобразованиях и местах назначения.
- Линия данных фокусируется на потоке данных и метаданных, помогая организациям обеспечить высокое качество данных, соответствие нормативным требованиям и достоверность путем предоставления видимости потоков и преобразований данных.
Отслеживание событий
- Отслеживание событий, также известное как распределенная трассировка, - это метод, используемый в распределенных системах для мониторинга и отладки потока отдельных запросов или событий по мере их прохождения через различные компоненты и сервисы.
- Распределенная трассировка включает в себя инструментальное обеспечение приложений для генерации данных трассировки, которые содержат информацию о пути и времени событий при их распространении через различные узлы и сервисы.
- Отслеживание событий в основном используется для мониторинга производительности, устранения неполадок и анализа первопричин в сложных распределенных системах, помогая организациям выявлять узкие места, проблемы задержки и ошибки в обработке запросов.
В целом, в центре внимания Data Lineage - жизненный цикл данных в экосистеме данных организации, в то время как отслеживание событий в большей степени связано с отслеживанием потока отдельных событий или запросов через распределенные системы для устранения неполадок и анализа производительности.
Вот пример из области обработки платежей: data lineage отслеживает путь платежных данных от инициации до расчетов, подробно описывая каждый шаг и преобразование, которому они подверглись. Отслеживание событий позволяет увидеть отдельные события в платежной системе в режиме реального времени, фиксируя последовательность и результат действий, таких как проверка подлинности и утверждение транзакций.
Стандарт "OpenLineage"
Open Lineage - это проект с открытым исходным кодом, целью которого является стандартизация управления метаданными для отслеживания истории данных. Он обеспечивает основу для сбора, хранения и обмена метаданными, относящимися к истории данных по мере их прохождения через различные этапы обработки в инфраструктуре данных организации. Предоставляя общий формат и API для выражения и доступа к информации об истории данных, Open Lineage обеспечивает совместимость между различными системами и инструментами обработки данных, облегчая управление данными, соответствие нормативным требованиям и высокое качество данных.

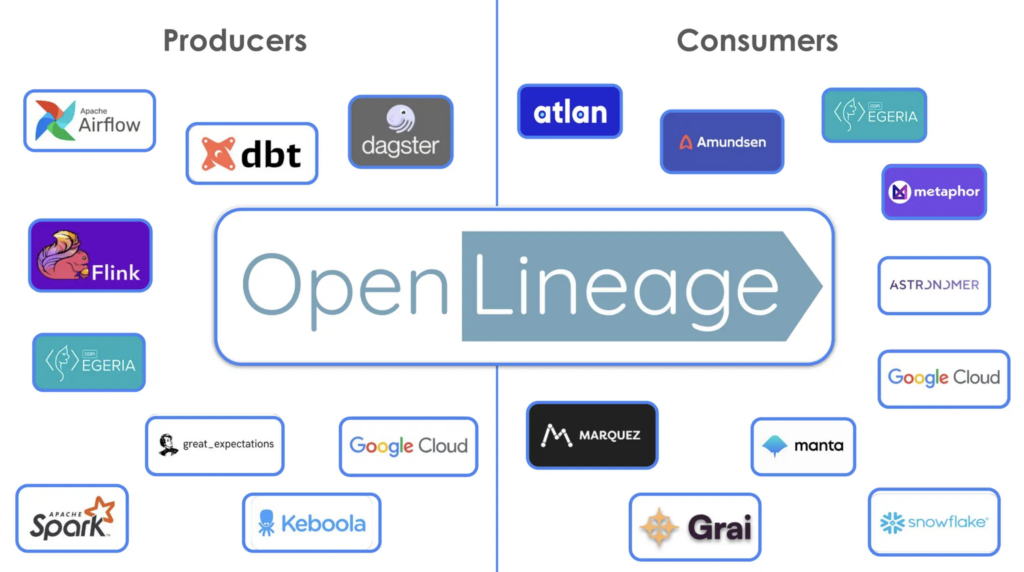
OpenLineage - это открытая платформа для сбора и анализа линейных данных. Она включает в себя открытый стандарт для сбора данных, библиотеки для наиболее распространенных инструментов, а также репозиторий метаданных/реализацию ссылок (Marquez). Многие фреймворки поддерживают как продюсеров, так и консюмеров:
Data Governance для потоковой передачи данных (Apache Kafka и Flink)
Потоковая передача данных подразумевает обработку и перемещение данных в режиме реального времени через распределенную платформу обмена сообщениями. Это позволяет организациям получать, обрабатывать и анализировать большие объемы данных из различных источников. Разделяя производителей и потребителей данных, платформа потоковой передачи данных обеспечивает масштабируемое и отказоустойчивое решение для построения конвейеров данных в режиме реального времени для поддержки таких сценариев использования, как онлайн - аналитика, архитектура данных, ориентированная на события, и интеграция данных.
Стандартом де-факто для потоковой передачи данных является Apache Kafka, используемый более чем 100 000 организаций по всему миру. Kafka используется не только для работы с большими данными, это решение также обеспечивает мощную поддержку транзакционных рабочих нагрузок.
Data governance при потоковой передаче данных vs Data Lake vs DWH
Внедрение DG и структурирования данных при потоковой передаче данных отличается от data governance в рамках Data Lake и DWH следующим:
1. Работа в режиме реального времени
Потоковая передача данных подразумевает обработку данных в режиме реального времени в момент их получения, в то время как озера данных и хранилища данных обычно занимаются пакетной обработкой исторических данных. Для потоковой передачи данных в режиме реального времени требуются процессы управления и контроля, способные работать со скоростью поступления, обработки и анализа потоковых данных.
2. Динамический поток данных
Среды потоковых данных характеризуются динамичными и непрерывными потоками данных; данные поступают, обрабатываются и анализируются практически в режиме реального времени. Такой динамичный характер работы с информацией требует наличия надежных механизмов управления данными, способных адаптироваться к изменениям источников данных, схем и конвейеров обработки в режиме реального времени, обеспечивая последовательное применение политик управления во всей экосистеме потоковых данных.
3. Детальная линия данных
При потоковой передаче данных необходимо отслеживать их историю на более детальном уровне (по сравнению с озерами данных и хранилищами данных). Это связано с тем, что потоковые данные часто подвергаются многочисленным преобразованиям и обогащениям по мере прохождения через потоковые конвейеры. В некоторых случаях для обеспечения высокого качества данных и соответствия нормативным требованиям необходимо проследить историю каждой отдельной записи данных.
4. Возможность немедленного действия
Среды потоковой передачи данных требуют немедленной реакции в отношении политик управления данными и средств контроля для решения таких проблем, как проблемы качества данных, нарушения безопасности или нормативно-правового соответствия в режиме реального времени. Это требует автоматизации процессов управления и интеграции средств управления непосредственно в конвейеры обработки потоковых данных.
5. Масштабируемость и отказоустойчивость
Популярные платформы потоковой передачи данных, такие как Apache Kafka и Apache Flink, разработаны с учетом требований масштабируемости и отказоустойчивости для обработки как больших объемов данных, так и транзакционных рабочих нагрузок с критическими SLA. Платформа должна обеспечивать непрерывную обработку потоков даже в условиях сбоев. Механизмы управления данными в потоковых средах так же должны быть масштабируемыми и устойчивыми для того, чтобы соответствовать масштабу и скорости обработки потоковых данных, обеспечивая последовательное внедрение управления в распределенной и устойчивой потоковой инфраструктуре.
6. Решение трудностей, связанных с управлением метаданными
Потоковая передача данных создает трудности в плане управления метаданными, поскольку их необходимо собирать и управлять ими в режиме реального времени, чтобы обеспечить видимость конвейеров потоковых данных, эволюцию схем и историю данных. Это требует специализированных инструментов и методов захвата, хранения и запроса метаданных в потоковых средах.
Таким образом, внедрение управления данными в потоковых средах требует решения уникальных проблем, связанных с особенностью работы в режиме реального времени, динамическим потоком данных, гранулярной структурой данных, возможностью немедленного принятия мер, масштабируемостью, устойчивостью и требованиями к управлению метаданными в средах потоковых данных. Это предполагает внедрение специализированных процессов управления, средств контроля, инструментов и методов, учитывающих особенности и требования таких платформ потоковой передачи данных, как Apache Kafka и Apache Flink.
Схемы и контракты данных для потоковых данных
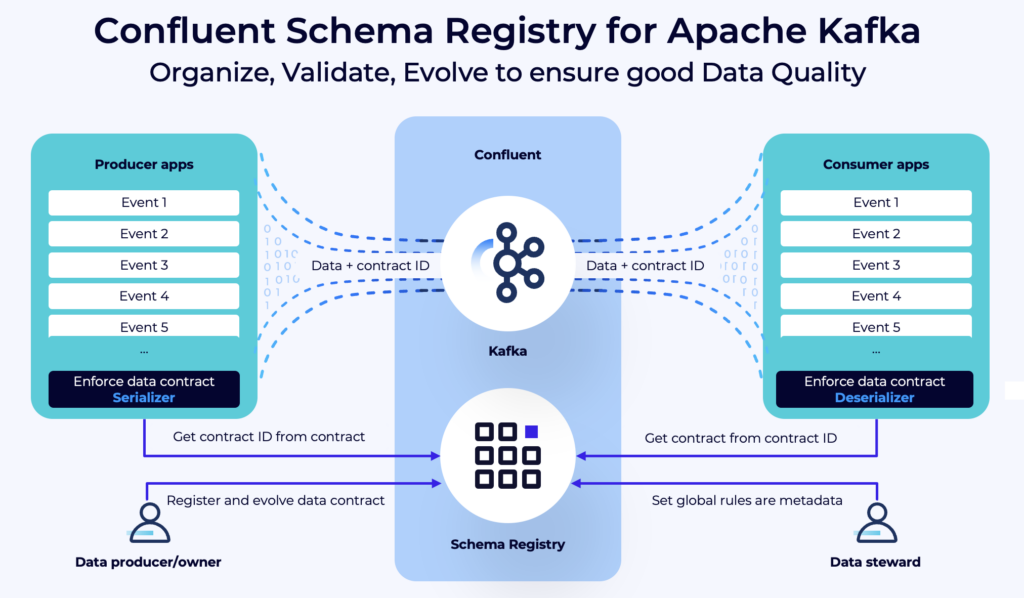
Основой управления данными для потоковых данных являются схемы и контракты на данные. Реестр схем Confluent доступен на Github . Реестр схем доступен под лицензией Confluent, что позволяет развертывать его в производственных сценариях без дополнительных затрат на лицензирование.
Data Lineage для потоковой передачи данных
Проекты по потоковой передаче данных, являющиеся одной из основ управления данными, требуют наличия надежной линии данных. Современный рынок предлагает в основном два варианта: собственные проекты или покупка коммерческого продукта/облачного сервиса. Однако рынок постоянно развивается, и появляются открытые стандарты для организации потоков данных и интеграции потоков данных в свои системы.
Давайте рассмотрим пример коммерческого решения и открытого стандарта для потоковой передачи данных:
- Облачный сервис: Линейка данных в составе Confluent Cloud
- Открытый стандарт: Интеграция OpenLineage с Apache Flink и Marquez
Data Lineage в Confluent Cloud для Kafka и Flink
Чтобы продвигаться вперед в обновлении критически важных приложений или отвечать на вопросы по таким важным темам, как регулирование данных и соблюдение нормативных требований, командам необходимо простое и надежное средство для понимания общей картины движения данных.
Линейка данных обеспечивает графический пользовательский интерфейс потоков событий и взаимосвязей данных как с высоты птичьего полета, так и с возможностью увеличения, что позволяет ответить на такие вопросы, как:
- Откуда пришли данные?
- Куда они направляются?
- Где, когда и как они были преобразованы?
Ответы на подобные вопросы позволяют разработчикам доверять полученным данным и получать необходимую информацию, чтобы убедиться в том, что их изменения не приведут к негативным или неожиданным последствиям. Разработчики могут быстро учиться и принимать взвешенные решения благодаря живым метрикам и проверке метаданных, встроенным непосредственно в графики линейного развития.
Документация Confluent содержит гораздо больше подробностей, включая примеры, учебные пособия и т. д. Большая часть приведенного выше описания скопирована именно оттуда.
OpenLineage для потоковой обработки данных с помощью Apache Flink
В последние месяцы потоковая обработка данных стала предметом особого внимания сообщества OpenLineage, о чем было рассказано в специальном докладе на саммите Kafka 2024, прошедшем в Лондоне.
В реализации OpenLineage реализовано множество полезных функций для обработки потоков, включая следующие:
- Бесшовная интеграция OpenLineage и Apache Flink
- Поддержка потоковых заданий в таких каталогах данных, как Marquez, manta, atlan
- Заметный прогресс в создании встроенного API Lineage в кодовой базе Flink
На саммите Kafka разработчики провели презентацию, показывающую, как именно данные перемещаются между топиками Kafka, приложениями Flink и другими базами данных с помощью эталонной реализации OpenLineage (Marquez).
Интеграция OpenLineage с Flink находится на ранней стадии развития и имеет ряд ограничений, например, пока нет поддержки Flink SQL или Table API. Но это действительно важная инициатива. Кросс-платформенная линия данных позволяет получить целостный обзор потока данных и его зависимостей в рамках организаций.
Потребность в Data Governance и Data Lineage в масштабах всего предприятия
Data governance, включая data lineage, является проблемой в масштабах всего предприятия. OpenLineage - это отличный подход к созданию открытого стандарта для интеграции с различными платформами данных, такими как платформы потоковой передачи данных, озера данных, хранилища данных, дома-озера и любые другие бизнес-приложения.
Однако мы все еще находимся в самом начале этого пути. Сегодня большинство компаний вынуждены создавать собственные решения для управления данными в масштабах всего предприятия и их интеграции с различными платформами. В краткосрочной перспективе большинство компаний используют специально разработанные функции управления данными и их структурирования в облачных продуктах, таких как Confluent, Databricks и Snowflake. Это имеет место быть, так как обеспечивает видимость потоков данных и повышает их качество.
Управление данными в масштабах предприятия должно интегрироваться со всеми различными платформами данных. Сегодня большинство компаний создают свои собственные решения, для их реализации все чаще используются специализированные пакеты корпоративного управления, такие как Collibra или Microsoft Purview. Поставщики программного обеспечения/облачных решений, такие как Confluent, интегрируют в эти платформы свои специально разработанные системы управления данными. Либо просто через открытые API, либо через прямые сертифицированные интеграции.
Баланс между стандартизацией и инновациями с помощью открытых стандартов и облачных сервисов
OpenLineage - это отличная инициатива сообщества по стандартизации интеграции между платформами данных и data governance. Надеемся, что в будущем поставщики примут подобные открытые стандарты.
Баланс между стандартизацией и инновациями - это всегда компромисс: поиск правильного баланса между стандартизацией и инновациями подразумевает простоту, гибкость и тщательный процесс рассмотрения с упором на решение реальных болевых точек и поощрение расширений, создаваемых сообществом.


