

Apache Iceberg: Формат открытых таблиц для Data Lakehouse и потоковой передачи данных
В этой статье рассматриваются войны таких форматов таблиц , как Apache Iceberg, Hudi, Delta Lake и XTable, а также стратегия продуктов Snowflake, Databricks, Confluent, AWS и Google.
В каждой организации, управляемой данными, есть операционные и аналитические рабочие нагрузки. В процессе использования различных платформ данных, включая потоковые данные, озера данных, хранилища данных и другие решения, а также облачных сервисов, формируется оптимальный подход. Открытые табличные форматы, такие как Apache Iceberg, необходимы в для обеспечения надежного управления данными и обмена ими, беспрепятственной эволюции схем, эффективной работы с большими массивами данных и экономичного хранения, а также для поддержки ACID-транзакций и запросов с временным перемещением.
В этой статье рассматриваются различные актуальные тенденции рынка, применение Iceberg, Hudi, Paimon, Delta Lake и XTable, а также продуктовая стратегия некоторых ведущих поставщиков платформ данных, таких как Snowflake, Databricks (Apache Spark), Confluent (Apache Kafka/Flink), Amazon Athena и Google BigQuery.
Что такое формат открытых таблиц для платформы данных?
Открытый формат таблиц помогает поддерживать целостность данных, оптимизировать производительность запросов и обеспечивать четкое понимание данных, хранящихся на платформе.
Открытый формат таблиц для платформ данных обычно включает в себя четко определенную структуру с конкретными компонентами, которые обеспечивают организованность, доступность и легкость запросов к данным. Типичный формат таблицы содержит имя таблицы, имена столбцов, типы данных, первичные и внешние ключи, индексы и ограничения.
Это не новая концепция. Ваша любимая база данных, созданная десятилетиями назад, например Oracle, IBM DB2 (даже на мэйнфрейме) или PostgreSQL, использует те же принципы. Однако для облачных хранилищ данных, озер данных и озерных хранилищ требования и задачи несколько изменились, особенно в отношении масштабируемости, производительности и возможностей запросов.

Преимущества "формата таблиц Lakehouse ", похожего на Apache Iceberg
Каждая часть предприятия руководствуется данными. Следствием этого являются обширные массивы данных, обмен данными с продуктами данных между бизнес-подразделениями и новые требования к обработке данных практически в режиме реального времени.
Apache Iceberg обеспечивает множество преимуществ:
- Единое хранилище: Данные хранятся в одном месте (при этом поступают они из различных источников данных), что снижает стоимость и сложность хранения.
- Доступность: Доступ без усилий из любого аналитического механизма благодаря эффективной интеграции.
- Все данные: Унификация операционных и аналитических рабочих нагрузок (транзакционные системы, журналы больших данных/IoT/clickstream, мобильные API, сторонние B2B-интерфейсы и т. д.)
- Независимость от поставщиков: Работа с любым любимым аналитическим движком (независимо от того, работает ли он в режиме близком к реальному времени, в пакетном режиме или на основе API).
Apache Hudi и Delta Lake обладают схожими характеристиками. Хотя Delta Lake в основном ориентирована на Databricks как на единственного поставщика..
Табличный формат и интерфейс каталога
Важно понимать, что Apache Iceberg или аналогичные фреймворки для работы с таблицами включает в себя два понятия: формат таблицы и интерфейс каталога! Как конечному пользователю технологии, Вам нужно и то, и другое!
Проект Apache Iceberg реализует формат талиц, но предоставляет только спецификацию (но не реализацию) для каталога:
- Формат таблицы определяет то, как данные организуются, хранятся и управляются внутри таблицы.
- Интерфейс каталога управляет метаданными таблиц и обеспечивает уровень абстракции для доступа к таблицам в озере данных.
В официальной документации по Аpache Iceberg Вы найдете более подробную информацию, в том числе касательно диаграммы, представленной ниже.
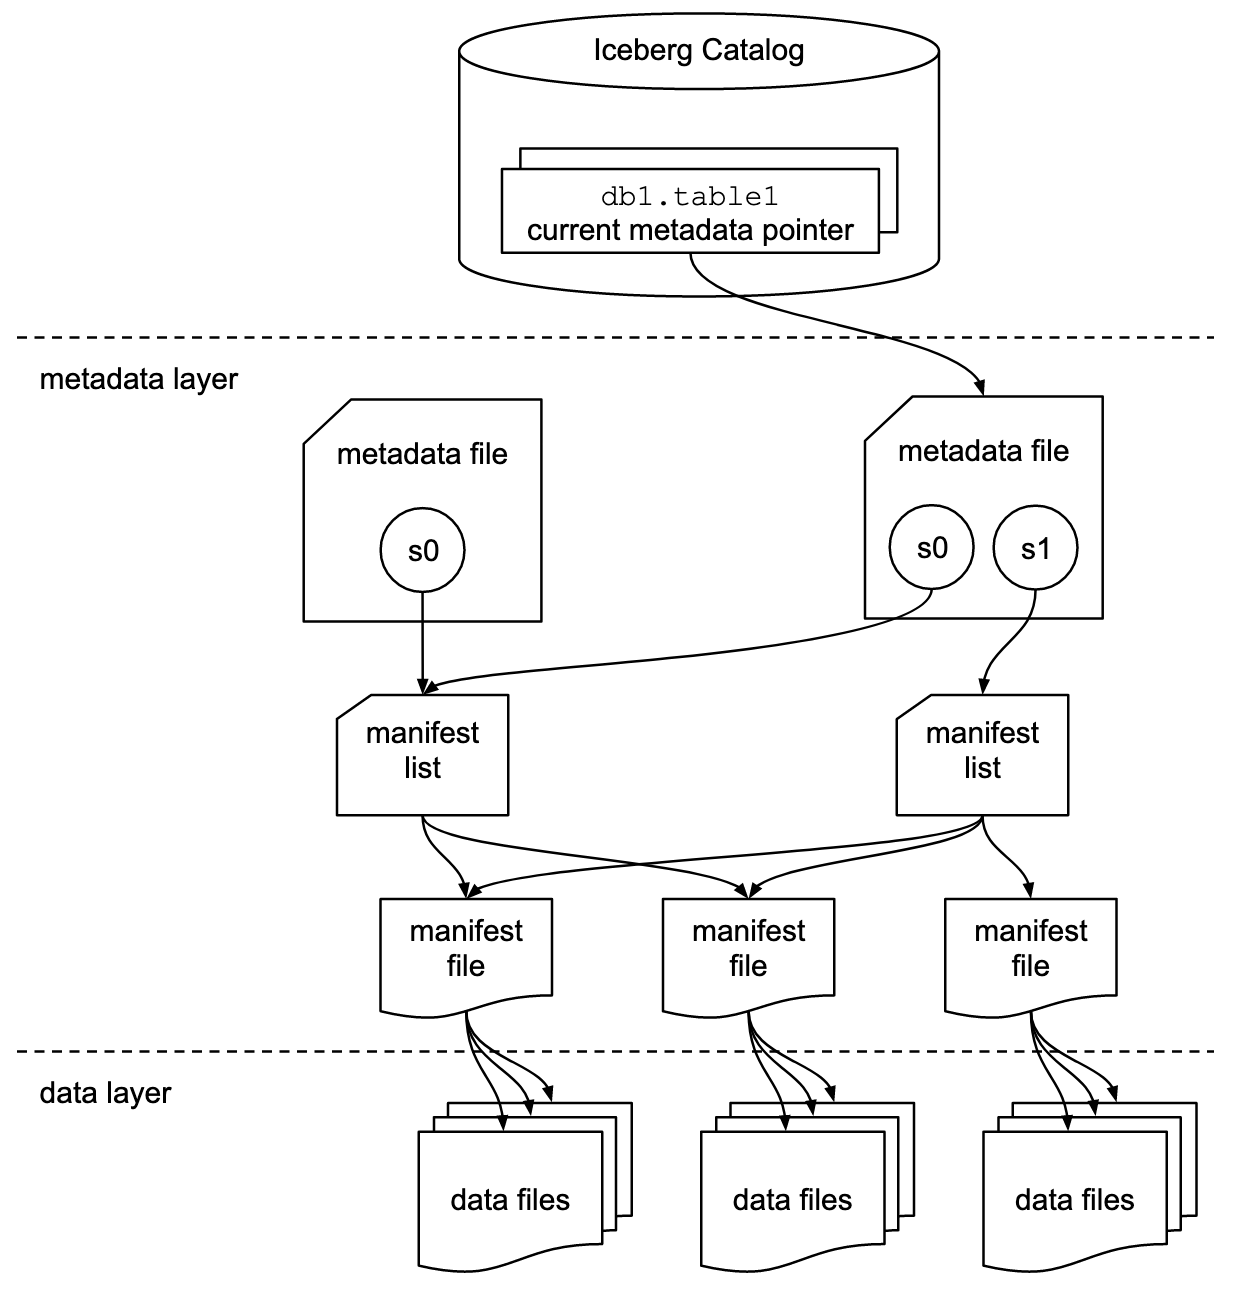
Организации используют различные реализации интерфейса каталога Iceberg. Каждая из них интегрируется с различными хранилищами метаданных и сервисами. К основным реализациям относятся следующие:
- Каталог Hadoop: Использует распределенную файловую систему Hadoop (HDFS) или другие совместимые файловые системы для хранения метаданных. Подходит для сред, уже использующих Hadoop.
- Каталог Hive: Интегрируется с метахранилищем Apache Hive для управления метаданными таблиц. Идеально подходит для пользователей, использующих Hive для управления метаданными.
- Каталог AWS Glue: Использует AWS Glue Data Catalog для хранения метаданных. Предназначен для пользователей, работающих в экосистеме AWS.
- REST-каталог: Предоставляет REST-интерфейс для работы с каталогом через HTTP. Обеспечивает интеграцию с пользовательскими или сторонними сервисами метаданных.
- Каталог Nessie: Использует Project Nessie, который обеспечивает Git-подобный опыт для управления данными.
Динамика и растущая популярность Apache Iceberg побуждают многих поставщиков платформ данных внедрять свои собственные каталоги Iceberg. Ниже в разделе о стратегиях поставщиков платформ данных и облачных вычислений я расскажу Вас о нескольких интересных стратегиях, включая Polaris от Snowflake, Unity от Databricks и Tableflow от Confluent.
Первоклассная поддержка Iceberg vs Iceberg Connector
Обратите внимание, что поддержка Apache Iceberg (или Hudi/Delta Lake) означает гораздо больше, чем просто предоставление коннектора и интеграция с форматом таблиц через API. Вендоры и облачные сервисы отличаются друг от друга предоставляемыми возможностями, такими как автоматическое сопоставление форматов данных, критические SLA, «путешествие в прошлое», интуитивно понятные пользовательские интерфейсы и так далее.
Давайте рассмотрим пример: Интеграция между Apache Kafka и Iceberg. Различные коннекторы Kafka Connect уже были реализованы ранее. Однако вот перечень основных преимуществ использования первоклассной интеграции с Iceberg (например, Tableflow от Confluent) по сравнению с использованием только коннектора Kafka Connect:
- Отсутствие конфигурации коннектора
- Отсутствие потребления через коннектор
- Встроенное обслуживание (уплотнение, сборка мусора, управление моментальными снимками)
- Автоматическая эволюция схемы
- Синхронизация с внешними службами каталогов
- Более простые операции (в полностью управляемом SaaS-решении это бессерверная система, не требующая масштабирования или операций со стороны конечного пользователя)
Аналогичные преимущества относятся и к другим платформам данных.
Открытый формат таблиц для Data Lake/Data lakehouse с использованием Apache Iceberg, Apache Hudi и Delta Lake
Общая цель таких фреймворков для работы с таблицами, как Apache Iceberg, Apache Hudi и Delta Lake, - повысить функциональность и надежность озер данных, решив общие проблемы, связанные с управлением крупными данными. Эти фреймворки помогают сделать следующее:
1. Улучшить управление данными:
- Упрощение процесса ввода, хранения и извлечения данных в озерах данных.
- Обеспечивают эффективную организацию и хранение данных, поддерживая более высокую производительность и масштабируемость.
2. Обеспечить согласованность данных:
- Предоставление механизмов для ACID-транзакций, гарантирующих сохранение целостности и надежности данных даже при одновременных операциях чтения и записи.
- Поддержка изоляции моментальных снимков, позволяющая пользователям просматривать целостное состояние данных в любой момент времени.
3. Поддержать эволюцию схемы:
- Позволяет вносить изменения в схему данных (например, добавлять, переименовывать или удалять столбцы), не нарушая существующие данные и не требуя сложных миграций.
4. Оптимизировать производительность запросов:
- Реализуйте передовые стратегии индексирования и разбиения на разделы для повышения скорости и эффективности запросов к данным.
- Обеспечьте эффективное управление метаданными для эффективной обработки больших наборов данных и сложных запросов.
5. Улучшить управление данными:
- Предоставьте инструменты для более эффективного отслеживания и управления историей данных, версионирования и аудита, что крайне важно для поддержания качества данных и соответствия нормативным требованиям.
Решая все эти задачи, такие фреймворки табличного формата, как Apache Iceberg, Apache Hudi и Delta Lake, помогают организациям создавать более прочные, масштабируемые и надежные озера и хранилища данных. Инженеры по обработке данных, специалисты по анализу данных и бизнес-аналитики используют инструменты аналитики, AI/ML или инструменты отчетности/визуализации поверх табличного формата для управления и анализа больших объемов данных.
Сравнение Apache Iceberg, Hudi, Paimon и Delta Lake
Я не буду приводить здесь сравнение фреймворков табличного формата Apache Iceberg, Apache Hudi, Apache Paimon и Delta Lake. Об этом уже писали многие эксперты и не раз. У каждого фреймворка есть свои сильные стороны и преимущества. Но в силу быстрой эволюции и инноваций, добавляющих новые улучшения и возможности в эти фреймворки, каждый месяц требуются обновления.
Вот краткий обзор того, что я вижу в различных публикациях касательно этих четырех вариантов:
- Apache Iceberg: Отличается эволюцией схем и разделов, эффективным управлением метаданными и широкой совместимостью с различными механизмами обработки данных.
- Apache Hudi: лучше всего подходит для ввода и обновления данных в режиме реального времени, обладает широкими возможностями захвата данных об изменениях и версионирования данных.
- Apache Paimon: формат озера, позволяющий построить архитектуру Lakehouse в режиме реального времени с использованием Flink и Spark для потоковых и пакетных операций.
- Delta Lake: Обеспечивает надежные ACID-транзакции, применение схемы и функции перемещения во времени, что делает его идеальным для поддержания качества и целостности данных..
Ключевым моментом в принятии решения может стать то, что Delta Lake управляется не широким сообществом, как Iceberg и Hudi, а главным образом Databricks как единственным поставщиком, стоящим за ней.
Apache XTable как взаимодействующий межтабличный фреймворк, поддерживающий Iceberg, Hudi и Delta Lake
У пользователей есть большой выбор. XTable, ранее известная как OneTable, - это еще один фреймворк для создания таблиц под лицензией Apache с открытым исходным кодом, обеспечивающий беспрепятственное кросс-табличное взаимодействие между Apache Hudi, Delta Lake и Apache Iceberg.
Apache XTable:
- Обеспечивает кросс-табличную совместимость между форматами таблиц Lakehouse.
- Не является новым или отдельным форматом. Apache XTable предоставляет абстракции и инструменты для трансляции метаданных формата таблиц Lakehouse.
Возможно, Apache XTable - это то самое решение, которые позволит предоставлять варианты для конкретных платформ данных и облачных поставщиков, обеспечивая при этом простую интеграцию и совместимость.
Но будьте осторожны: обертка поверх различных технологий - это не панацея. Мы убедились в этом много лет назад, когда появился Apache Beam. Apache Beam - это унифицированная модель с открытым исходным кодом и набор SDK для определения и выполнения рабочих процессов ввода данных и их обработки. Она поддерживает различные механизмы обработки потоков, такие как Flink, Spark и Samza. Основной движущей силой Apache Beam является компания Google, которая позволяет осуществлять миграцию рабочих процессов в Google Cloud Dataflow. Однако ограничений очень много, поскольку такая обертка должна найти наименьший общий знаменатель поддерживаемых функций. А ключевым преимуществом большинства фреймворков являются те 20 %, которые не укладываются в такую обертку. По этим причинам, например, Kafka Streams намеренно не поддерживает Apache Beam, потому что это потребовало бы слишком много ограничений при проектировании…
Реакция рынка на фреймворки формата таблицы
Прежде всего, мы все еще находимся на ранних стадиях развития форматов таблиц. С точки зрения Gartner Hype Cycle мы все еще находимся на этапе инноваций, приближаясь к достижению пика завышенных ожиданий. Большинство организаций все еще оценивают целесообразность использования, но пока еще не внедряют эти форматы таблиц в производство по всей организации.
Флэшбэк: Контейнерные войны Kubernetes vs. Mesosphere vs. Cloud Foundry
Дебаты вокруг Apache Iceberg напомнили мне о контейнерных войнах, разразившихся несколько лет назад. Термин «контейнерные войны» относится к конкуренции и соперничеству между различными технологиями и платформами контейнеризации в сфере разработки программного обеспечения и ИТ-инфраструктуры.
Тремя конкурирующими технологиями были Kubernetes, Mesosphere и Cloud Foundry. Вот к чем это привело:
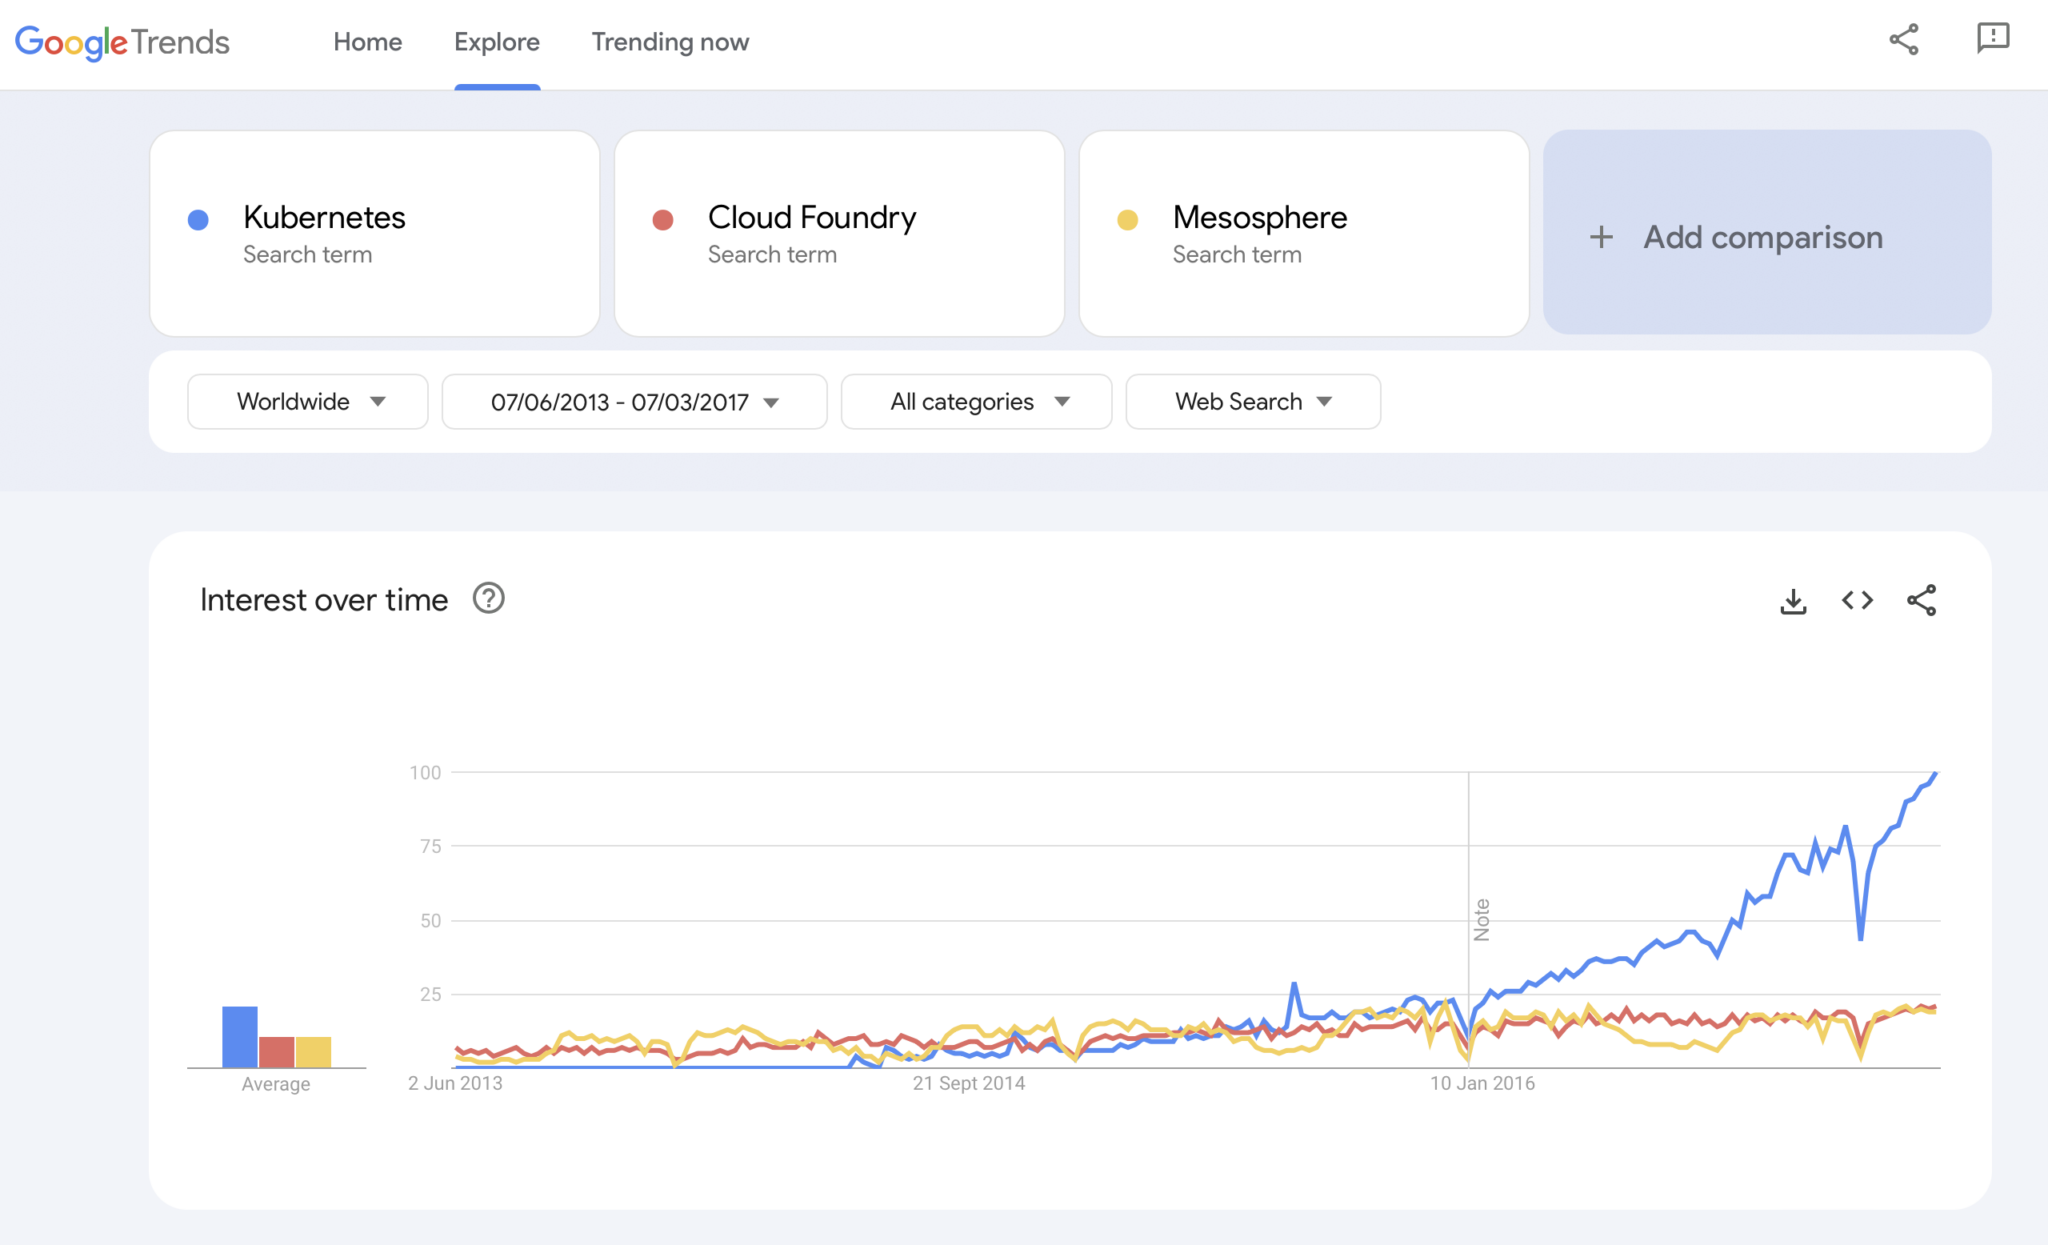
Cloud Foundry и Mesosphere появились раньше, но Kubernetes все равно выиграла битву. Почему? Я так и не понял всех технических деталей и различий. В конце концов, если три фреймворка довольно похожи друг на друга, значит, все дело в:
- Принятии сообществом
- Правильном распределении времени выпуска функций
- Хорошем маркетинге
- Удаче
- И еще нескольких факторах
Но для индустрии программного обеспечения хорошо иметь один ведущий фреймворк с открытым исходным кодом, на котором можно строить решения и бизнес-модели. А не три возможных варианта.
Настоящее: Настольные форматные войны Apache Iceberg vs Hudi vs Delta Lake
Разумеется, Google Trends не самый популярный инструмент, однако в прошлом я очень часто использовал его как интуитивно понятный, простой и бесплатный инструмент для анализа рыночных тенденций, а также для того, чтобы посмотреть, совпадают ли поисковые запросы Google с моим личным опытом внедрения на рынок Apache Iceberg, Hudi и Delta Lake (Apache XTable еще слишком мал, чтобы его добавлять в этот список):
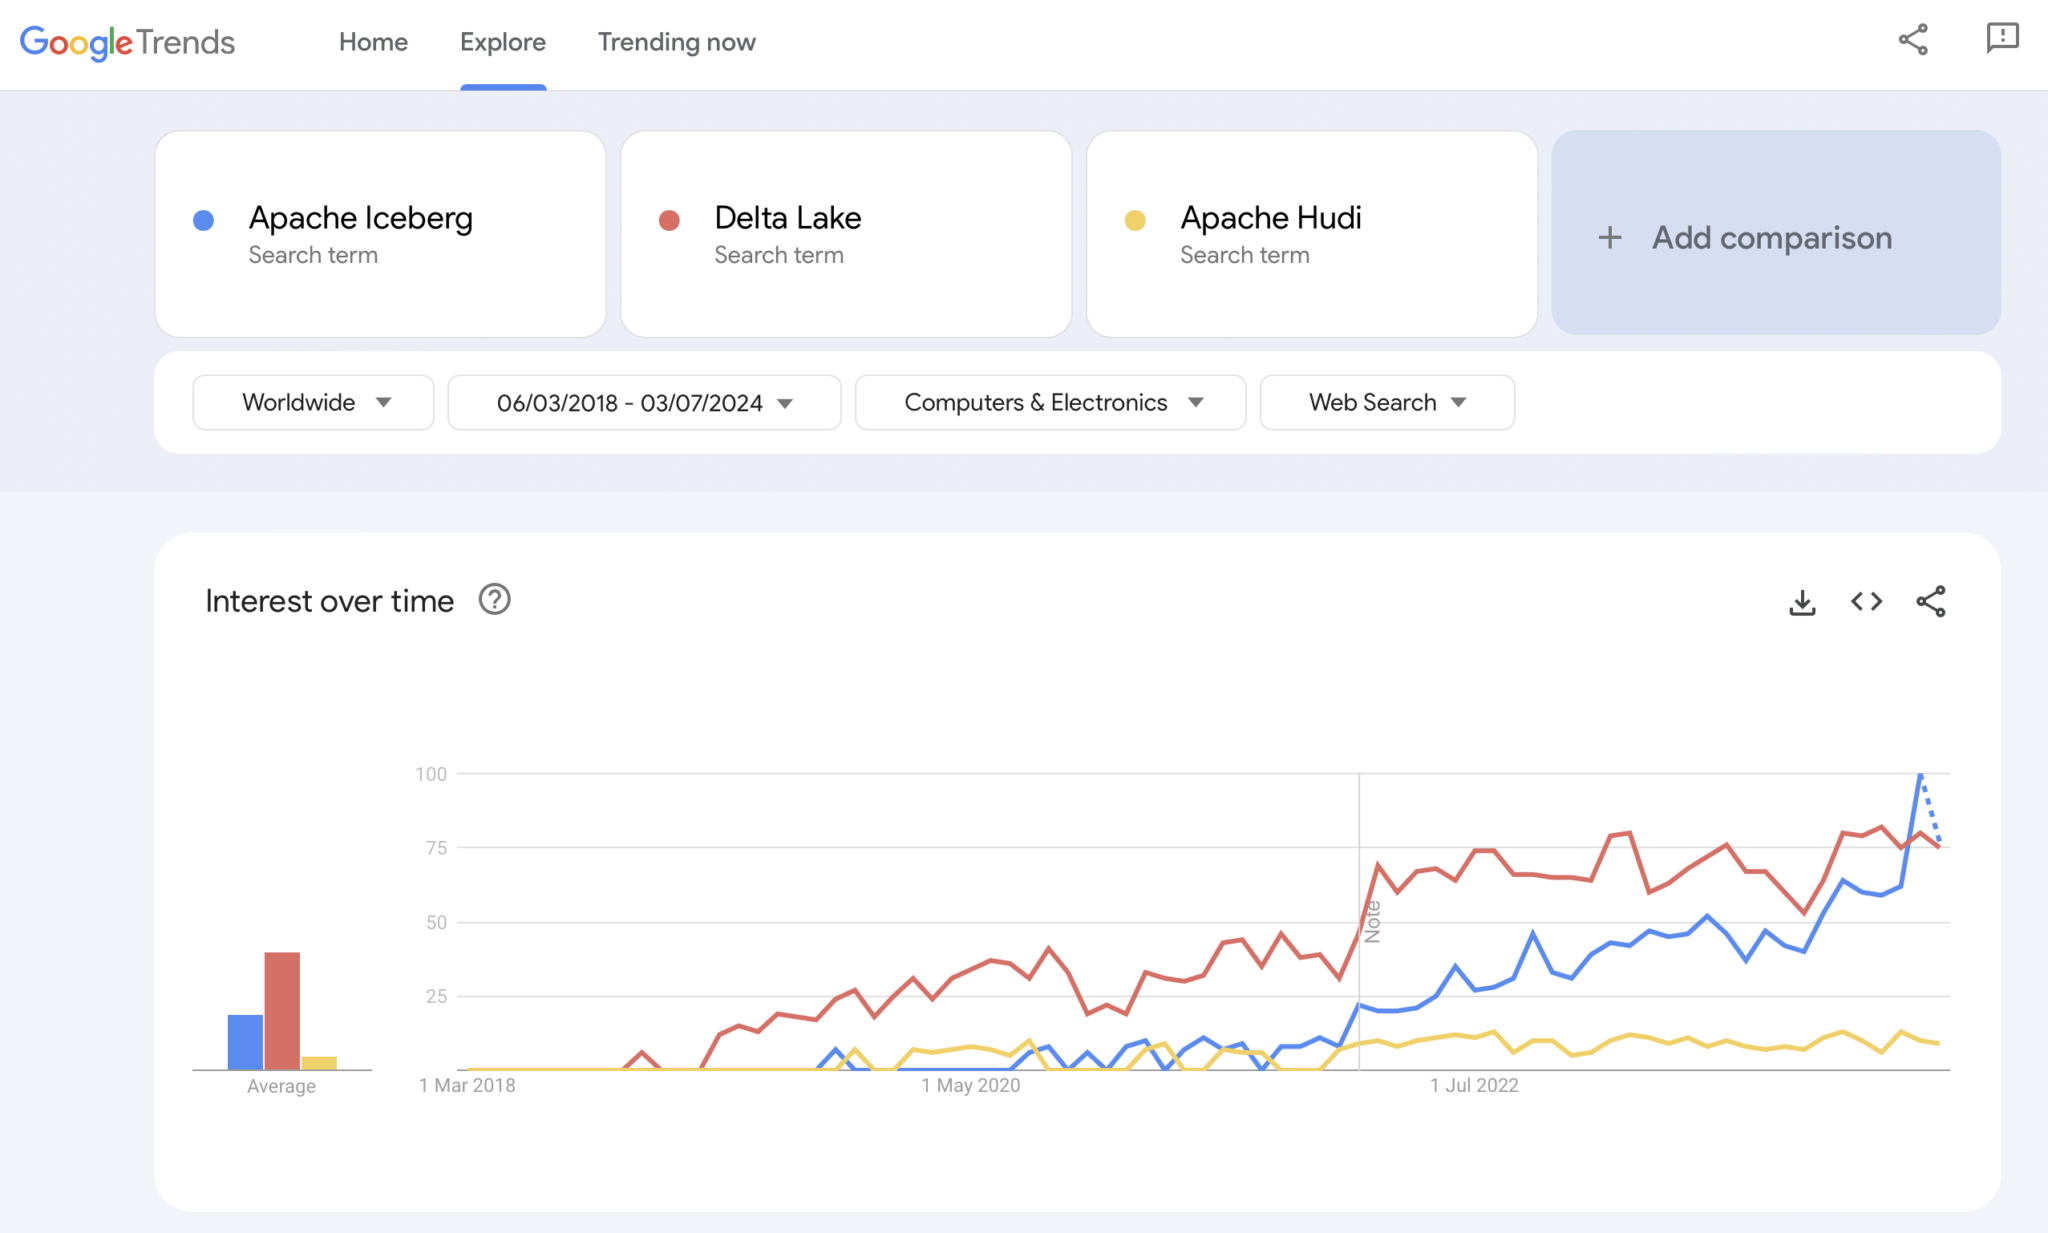
Очевидно, что сейчас мы наблюдаем ту же картину, что и несколько лет назад во время контейнерных войн. Я понятия не имею, куда это приведет.
Мое личное мнение? Я думаю, что Apache Iceberg выиграет эту гонку. Почему? Я не могу привести никаких технических аргументов. Я просто вижу, что многие клиенты во всех отраслях говорят о нем все больше и больше. И все больше и больше вендоров начинают его поддерживать. Но посмотрим. На самом деле мне все равно, кто победит. Однако, как и в случае с войной контейнеров, я считаю, что хорошо иметь единый стандарт.
Учитывая все вышесказанное, давайте рассмотрим текущую стратегию ведущих платформ обработки данных и облачных провайдеров в отношении поддержки форматов таблиц в их платформах и облачных сервисах.
Стратегии поставщиков платформ данных и вендоров облачных вычислений для Apache Iceberg
В этом разделе я не буду заниматься спекуляциями. Эволюция фреймворков табличных форматов происходит достаточно быстро, и стратегии поставщиков быстро меняются. За последней информацией обращайтесь на сайты поставщиков. Представляю Вашему вниманию краткий обзор стратегий поставщиков платформ данных и вендоров облачных вычислений в отношении поддержки и интеграции Apache Iceberg.
Snowflake:
- Поддерживает Apache Iceberg уже довольно долгое время.
- Регулярно добавляются новые интеграции и новые функции
- Варианты внутреннего и внешнего хранения (с компромиссами), такие как хранилище Snowflake или Amazon S3.
- Анонсирован Polaris, реализация каталога с открытым исходным кодом для Iceberg, с обязательством поддерживать двунаправленную интеграцию по инициативе сообщества, не зависящую от производителя.
Databricks:
- Фокусируется на Delta Lake как формате таблиц и (теперь с открытым исходным кодом) Unity как каталоге.
- Приобретение Tabular, ведущей компании, стоящей за Apache Iceberg.
- Неясна будущая стратегия поддержки открытого интерфейса Iceberg (в обоих направлениях) или только для подачи данных в свою платформу Lakehouse и такие технологии, как Delta Lake и Unity Catalog.
Confluent:
- Встраивает Apache Iceberg в качестве «первоклассного гражданина» в свою платформу потоковой передачи данных (продукт называется Tableflow).
- Преобразование топика Kafka и связанных с ним метаданных схемы (т. е. контракта с данными) в таблицу Iceberg
- Двунаправленная интеграция между операционными и аналитическими рабочими нагрузками
- Аналитика с помощью встроенного бессерверного Flink и его унифицированного пакетного и потокового API или обмен данными со сторонними аналитическими движками, такими как Snowflake, Databricks или Amazon Athena.
Большинство платформ данных и аналитических движков с открытым исходным кодом:
- Список технологий и облачных сервисов, поддерживающих Iceberg, растет с каждым месяцем.
- Несколько примеров: Apache Spark, Apache Flink, ClickHouse, Dremio, Starburst с использованием Trino (ранее PrestoSQL), Cloudera с использованием Impala, Imply с использованием Apache Druid, Fivetran
Поставщики облачных услуг (AWS, Azure, Google Cloud, Alibaba):
Различные стратегии и интеграции, но абсолютно все облачные провайдеры единогласно увеличивают поддержку Iceberg в своих сервисах, например:
- Объектные хранилища: Amazon S3, Azure Data Lake Storage (ALDS), Google Cloud Storage
- Каталоги: Специфические для облака, например AWS Glue Catalog, или не зависящие от поставщика, например Project Nessie или Hive Catalog.
- Аналитика: Amazon Athena, Azure Synapse Analytics, Microsoft Fabric, Google BigQuery.
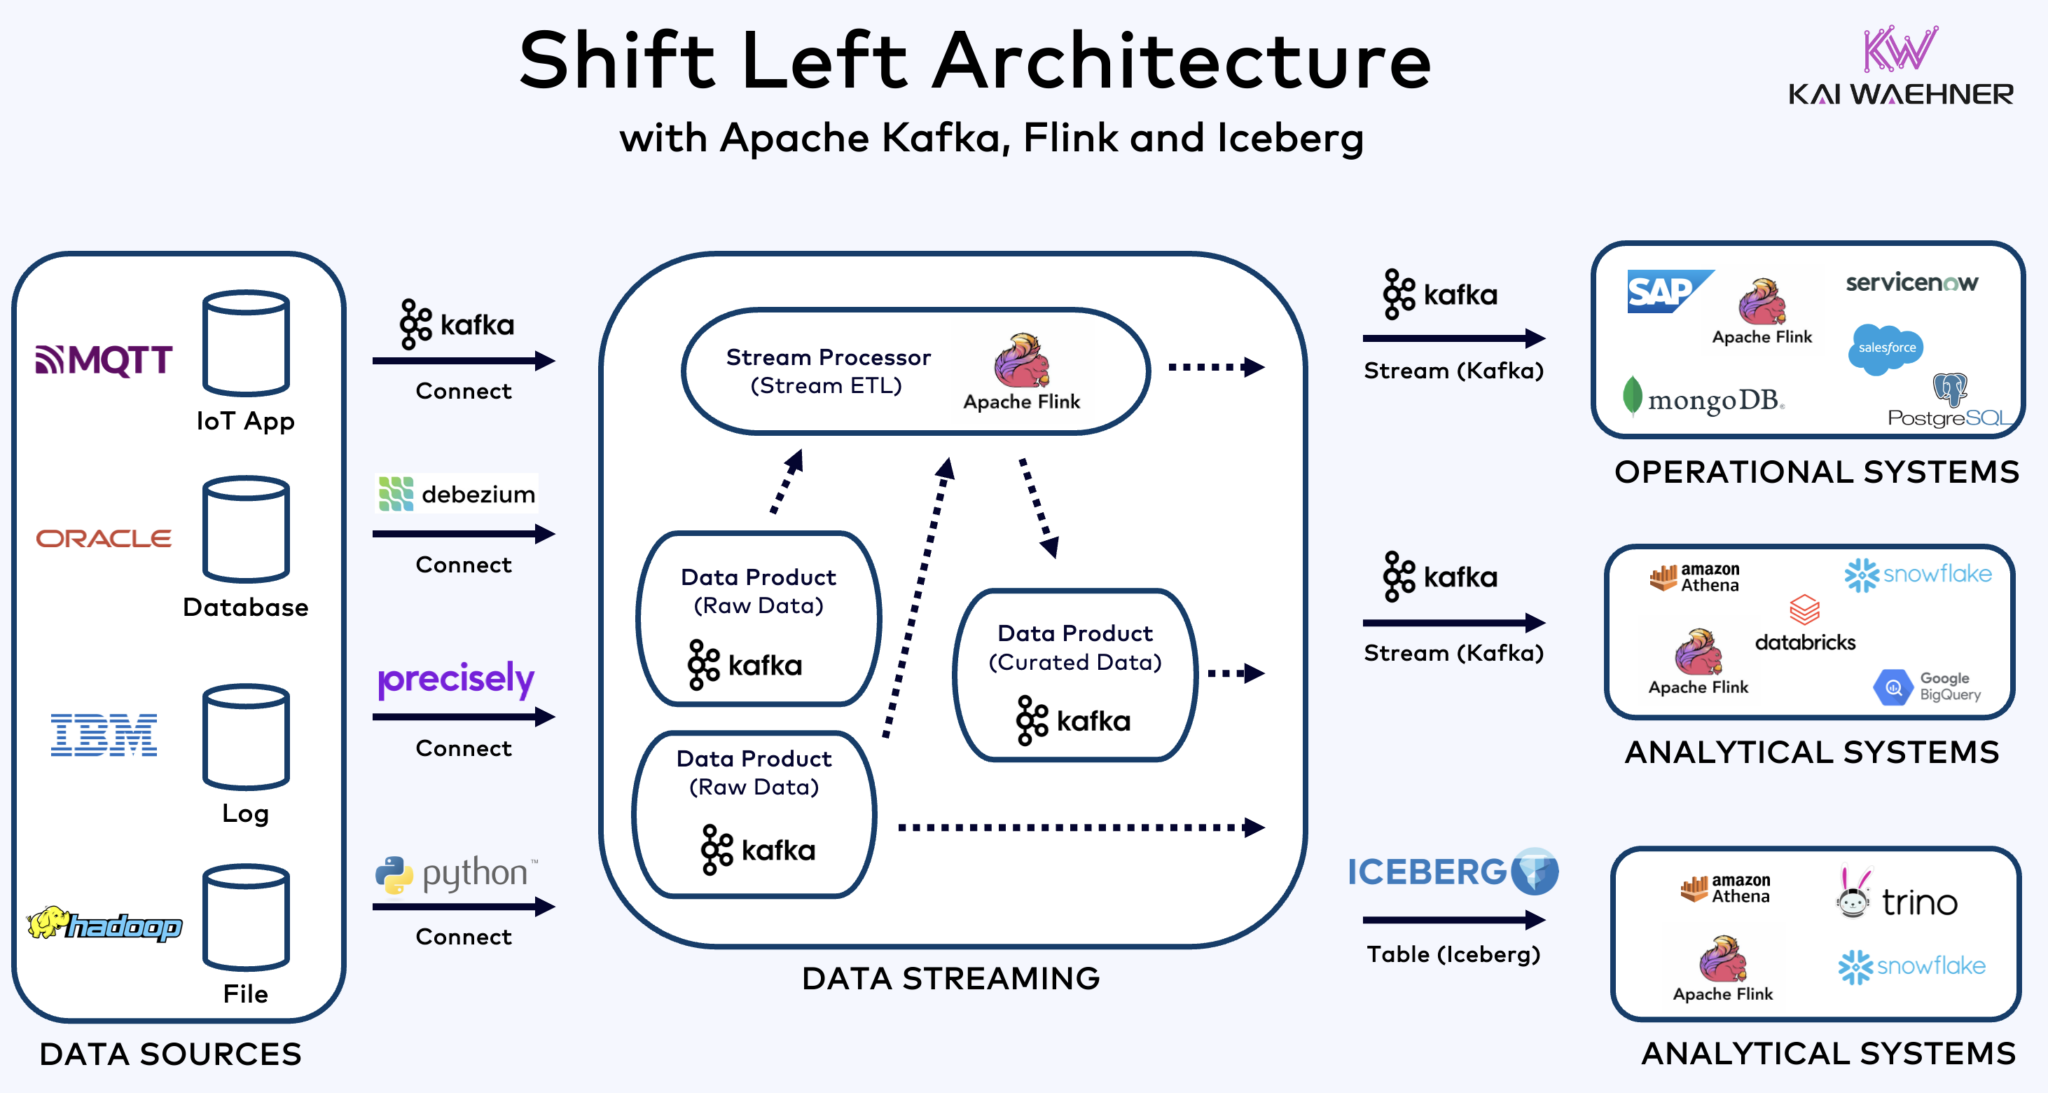
Архитектура Shift Left с Kafka, Flink и Iceberg для унификации операционных и аналитических рабочих нагрузок
Архитектура «Shift Left» приближает обработку данных к источнику, используя технологии потоковой передачи данных в реальном времени, такие как Apache Kafka и Flink, для обработки данных в движении непосредственно после их получения. Такой подход позволяет сократить время ожидания и повысить согласованность и качество данных.
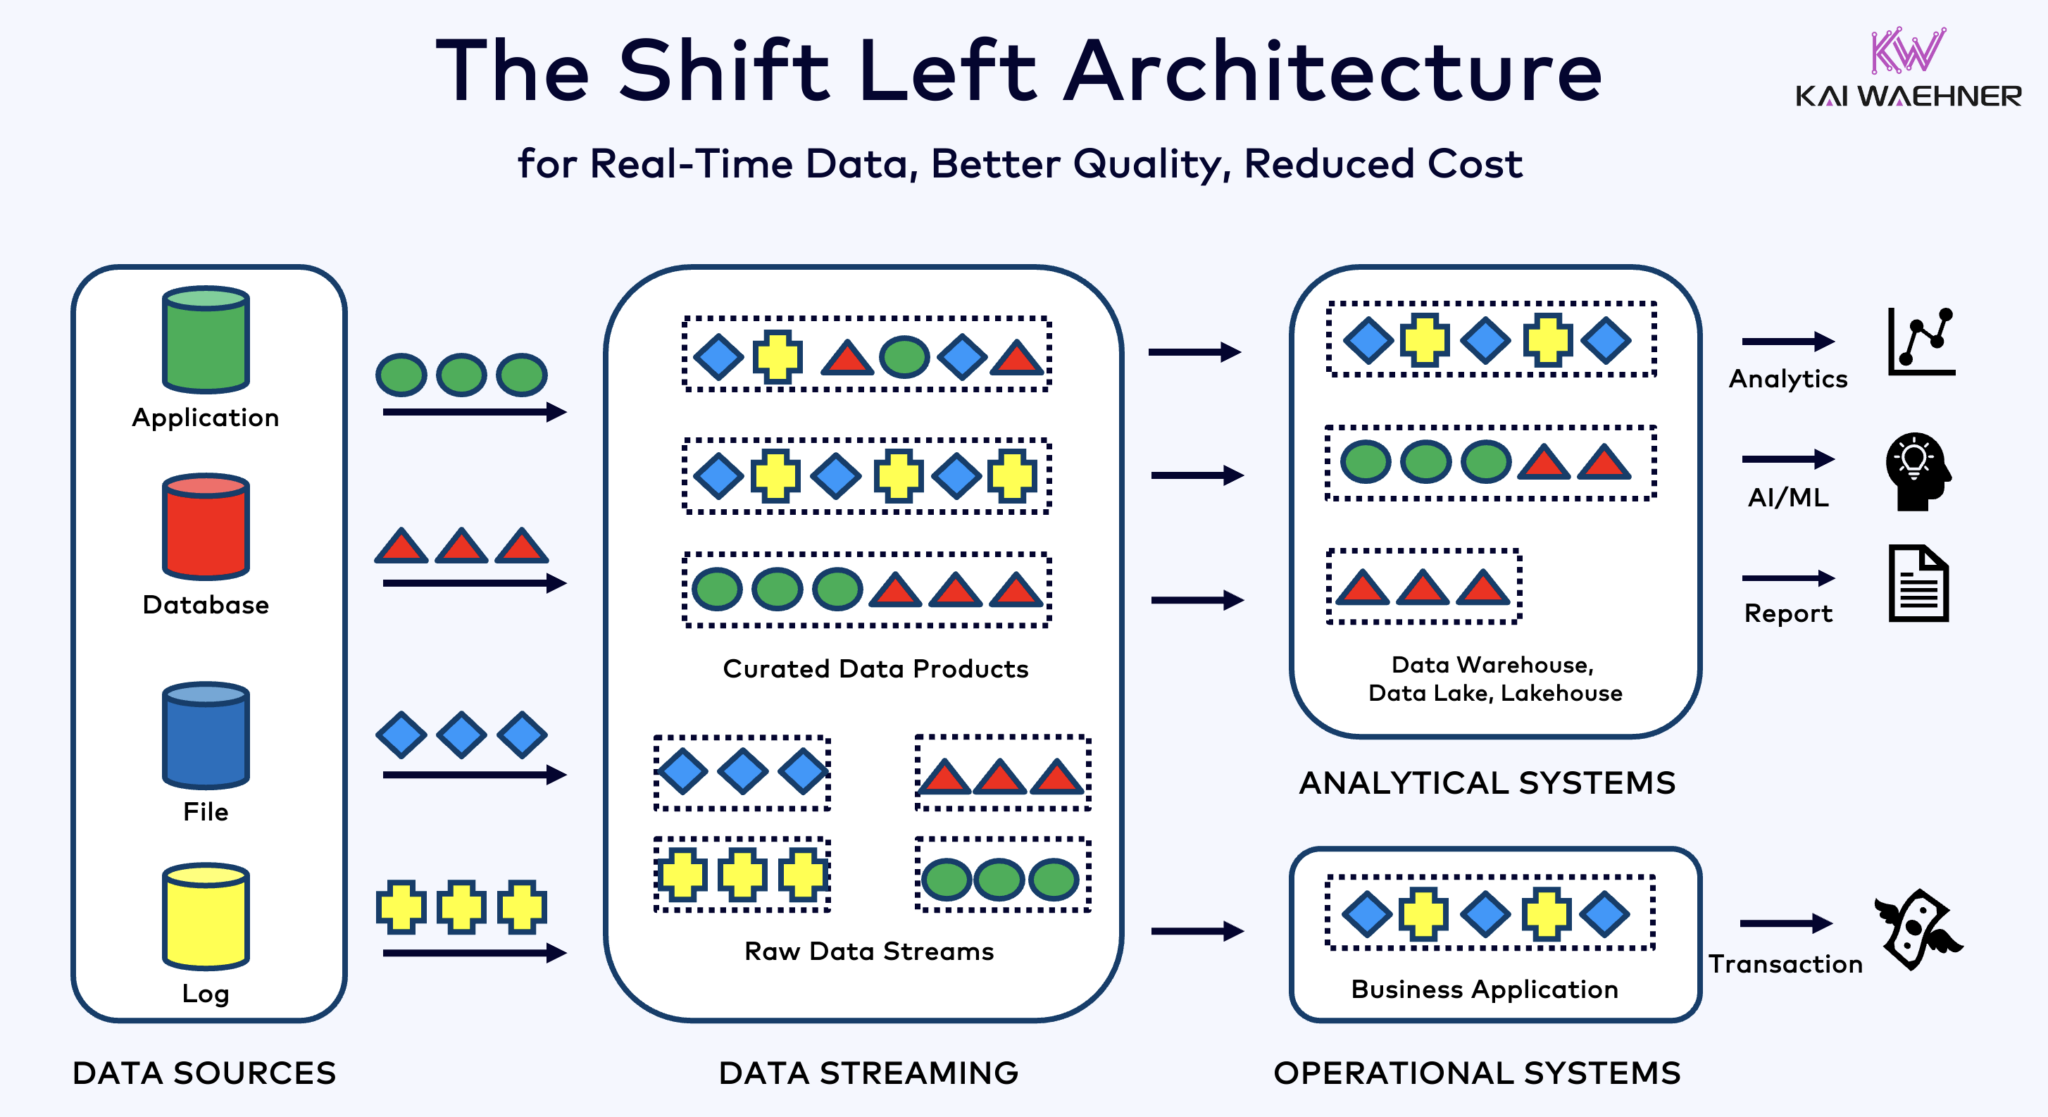
В отличие от ETL и ELT, которые предполагают пакетную обработку данных, хранящихся в состоянии покоя, архитектура shift left позволяет собирать и преобразовывать данные в режиме реального времени. Она соответствует концепции zero-ETL, поскольку делает данные пригодными для немедленного использования. Но в отличие от zero-ETL, перенос обработки данных в левую часть архитектуры предприятия позволяет избежать сложной, трудно поддерживаемой архитектуры «спагетти» с множеством соединений «точка-точка».
Архитектура Shift left также снижает потребность в обратном ETL, обеспечивая возможность использования данных в режиме реального времени как операционными, так и аналитическими системами. В целом такая архитектура повышает свежесть данных, снижает затраты и ускоряет вывод на рынок приложений, основанных на данных.
Apache Iceberg как открытый формат таблиц и каталог для бесшовного обмена данными между аналитическими системами
Открытый формат таблиц и каталогов дает огромные преимущества в архитектуре предприятия:
- Доступность
- Большой выбор аналитических движков
- Быстрый выход продукта на рынок
- Умеренные затраты
Apache Iceberg, похоже, стал стандартом де-факто среди вендоров и облачных провайдеров. Однако он все еще находится на ранней стадии, и конкурирующие технологии, такие как Apache Hudi, Apache Paimon, Delta Lake и Apache XTable, также пытаются набрать обороты.
Iceberg и другие открытые форматы таблиц - это не только огромный выигрыш для единого хранения и интеграции с несколькими платформами аналитики/данных/AI/ML, такими как Snowflake, Databricks, Google BigQuery и т. д., но и для объединения операционных и аналитических рабочих нагрузок с использованием потоковой передачи данных с помощью таких технологий, как Apache Kafka и Flink. Shift Left в архитектуре - это значительное преимущество, позволяющее сократить трудозатраты, повысить качество и согласованность данных, а также обеспечить работу приложений и аналитических материалов в режиме реального времени вместо пакетной обработки.


