

Освоить Presto за 8 минут
Uber, Netflix, Airbnb и LinkedIn используют именно этот движок.
Введение
Apache Spark - король обработки данных.
Он был разработан в 2012 году в ответ на ограничения от MapReduce.
Сначала люди использовали Spark для ETL-процессов. Однако уже в 2015 году команда Spark представила возможности SQL, что сделало его вариантом, подходящим для реляционного механизма запросов.
В 2020 году компания Databricks представила парадигму Lakehouse. Они оснастили Spark движком Photon для того, чтобы сделать его более эффективным в качестве движка для запросов к Data Lake.
Надежный механизм запросов, работающий с огромными объемами данных, может дать множество преимуществ.
Это осознает не только Databricks.
BigQuery - это движок запросов (Dremel), работающий на гигантских системах хранения данных (Coloussus).
Snowflake - это набор рабочих узлов, которые работают на S3.
Помимо облачных хранилищ данных, к тусовке присоединилась еще одна крупная технологическая компания.
В 2012 году Facebook разработала интерактивный движок SQL-запросов с аналогичной концепцией.
Они назвали его Presto или «SQL по всему, чего только пожелаете»

Обзор
Компания Facebook разработала Presto для удовлетворения растущей потребности в извлечении информации из больших объемов данных. Цель заключалась в том, чтобы с помощью SQL сделать аналитику данных доступной для большего числа сотрудников организации.
В конце 2018 года специалисты по работе с данными Facebook использовали Presto для большинства аналитических нагрузок на SQL, включая интерактивные/BI-запросы и длительные пакетные ETL-задания.
Presto - это распределенный механизм запросов SQL, который ежедневно обрабатывает сотни петабайт данных и квадриллионы строк в Facebook.
Вот его основные характеристики:
- Он может выполнять сотни ресурсоемких запросов одновременно.
- Он может масштабироваться до тысяч рабочих узлов.
- Он может запрашивать сразу несколько источников данных, даже в рамках одного запроса.
- Он может поддерживать множество сценариев использования с различными ограничениями и характеристиками производительности.
- Он обещает работать с высокой производительностью.
Варианты использования Presto в Facebook:
- Интерактивная аналитика: Инженеры и специалисты по анализу данных используют Presto для изучения небольших объемов данных, проверки гипотез и создания визуализаций и дашбордов.
- Пакетный ETL: Presto поддерживает пользователей, переходящих с устаревших систем пакетной обработки данных для ETL-запросов. Эти запросы более ресурсоемки, чем интерактивные.
- A/B-тестирование: Presto поддерживает инфраструктуру A/B-тестирования Facebook. Она помогает объединить несколько больших наборов данных для получения подробной информации об эксперименте.
- Аналитика для разработчиков/рекламодателей: Presto поддерживает пользовательские инструменты отчетности, такие как Facebook Analytics, для внешних разработчиков и рекламодателей.
Presto или Trino
Прежде чем узнать об архитектуре Presto, я немного расскажу о его истории.
Как уже упоминалось ранее, Facebook начала разработку Presto в 2012 году и открыла ее в 2013 году.
В 2014 году компания Netflix сообщила, что использует Presto на 10 петабайтах данных S3.
В 2016 году Amazon анонсировала знаменитый сервис Athena. Они создали Athena на базе Presto.
В 2017 году компания Starburst Data начала поддерживать Presto на коммерческой основе.
В 2018 году первоначальные разработчики Presto покинули Facebook из-за изменения политики, которая давала коммиттерам Facebook больше привилегий в фиксации изменений, чем сообществу разработчиков открытого кода.
В 2019 году разработчики Presto форкнули PrestoDB, поддерживаемый Facebook, а также PrestoSQL, поддерживаемый Presto Software Foundation.
В том же году Facebook передал PrestoDB в дар Linux Foundation.
В декабре 2020 года PrestoSQL был переименован в Trino, поскольку Facebook получила торговую марку на слово «Presto».
Архитектура
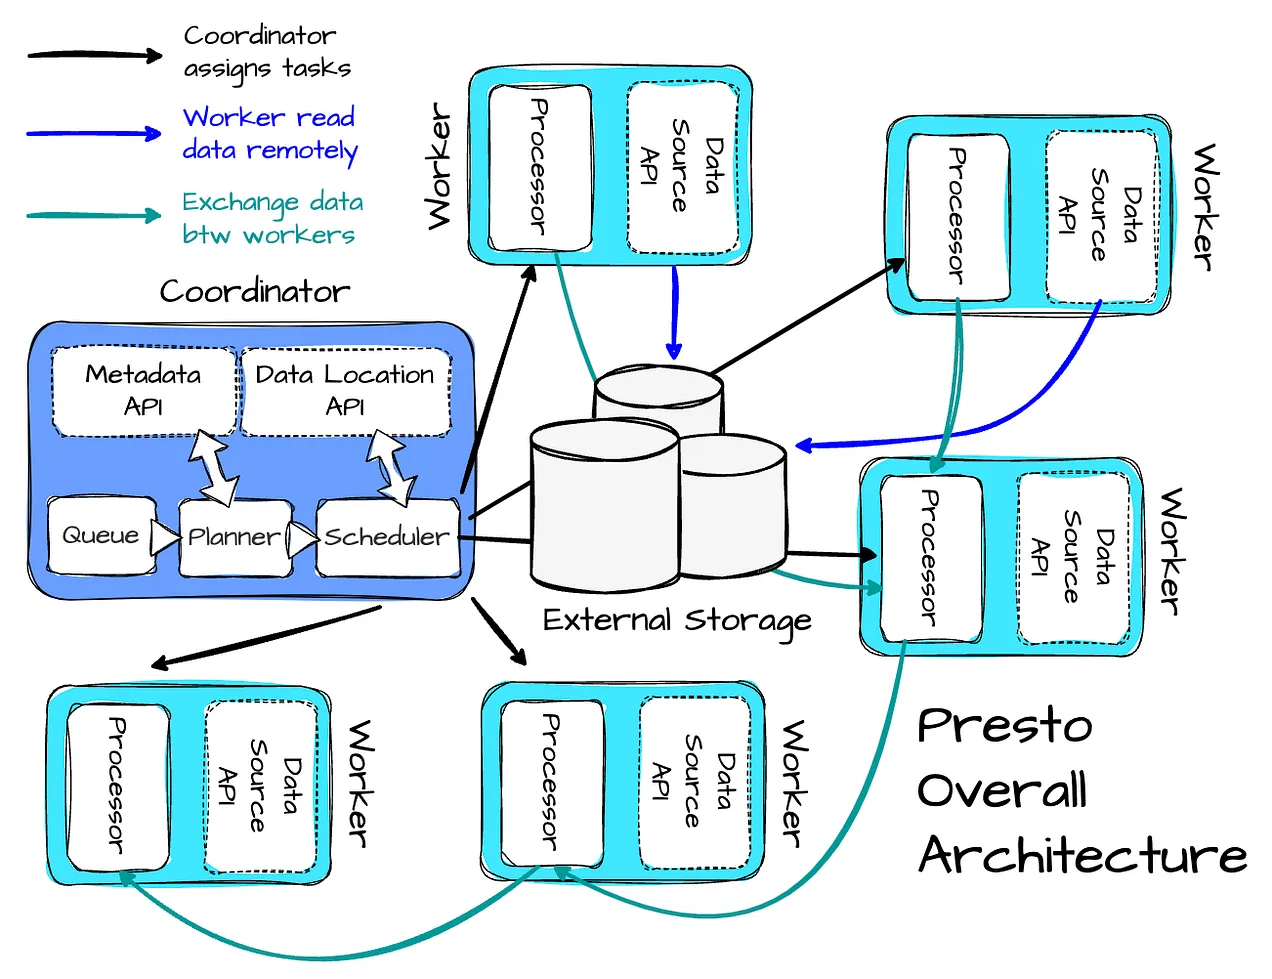
Кластер Presto состоит из узла-координатора и множества рабочих узлов:
- Координатор анализирует, планирует и организует запросы.
- Рабочие узлы выполняют запрос.
Вот типичный поток:
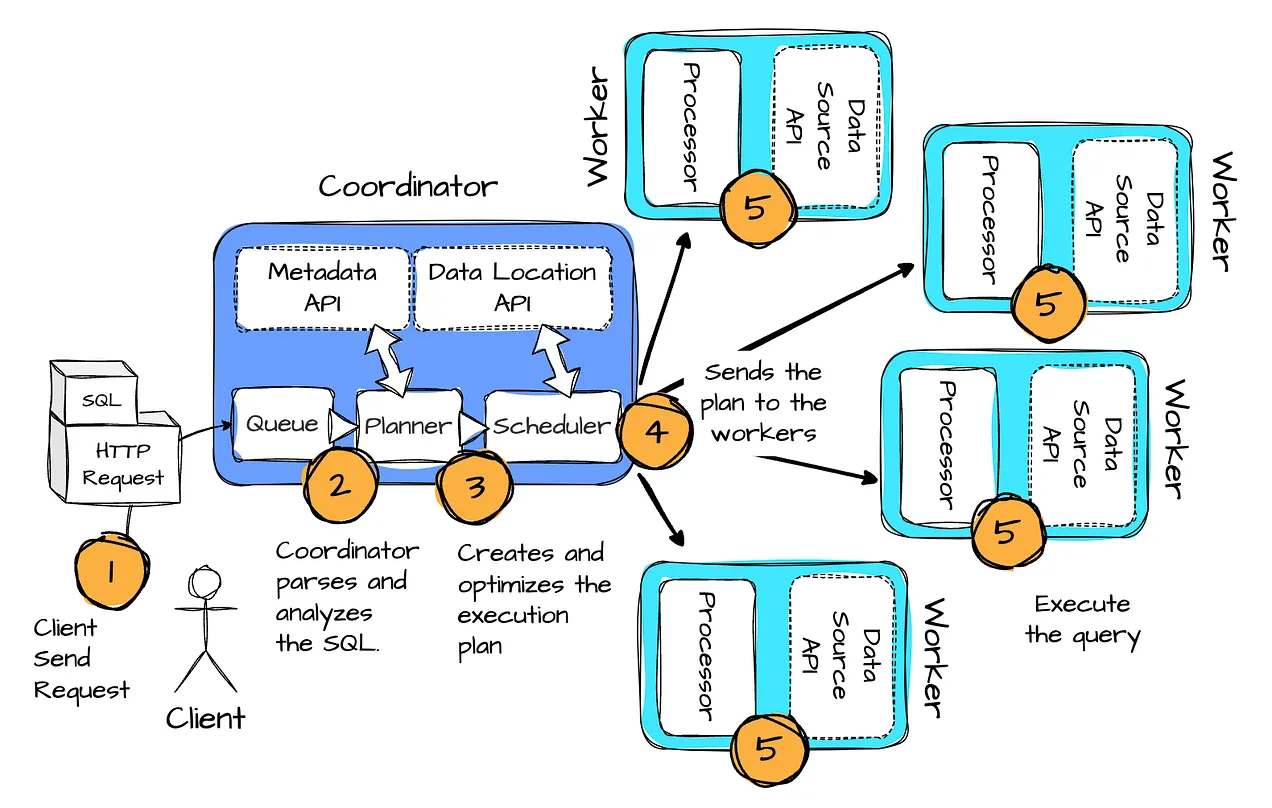
- Клиент отправляет HTTP-запрос с SQL-запросом координатору.
- Координатор разбирает и анализирует SQL.
- Затем он создает и оптимизирует план выполнения.
- Координатор отправляет план рабочим узлам.
- Рабочие узлы приступают к выполнению задач, оперируя сплитами, которые представляют собой куски данных во внешней системе хранения.
- Входными данными для рабочих узлов являются удаленные сплиты или промежуточные результаты, полученные от вышестоящих рабочих узлов. Рабочие узлы хранят промежуточные данные в памяти столько, сколько это возможно.
Facebook разработал Presto с учетом возможности расширения; они представили интерфейс плагинов для Presto. Интерфейс позволяет пользователям выполнять множество дополнительных настроек:
- Пользовательские типы данных
- Пользовательские функции
- Пользовательские реализации контроля доступа
- Пользовательские политики очередей
- Пользовательские коннекторы позволяют Presto взаимодействовать с внешними хранилищами данных через API коннекторов, который состоит из четырех частей: API метаданных, API расположения данных, API источников данных и API стоков данных.
Ключевое решение при проектировании системы
Диалект SQL
Presto придерживается ANSI SQL для достижения совместимости с другими системами. Facebook также выбрал расширения ANSI SQL для Presto, такие как лямбда-выражения и функции высшего порядка для того, чтобы оптимизировать удобство работы со сложными типами данных, такими как карты и массивы.
Клиентский интерфейс
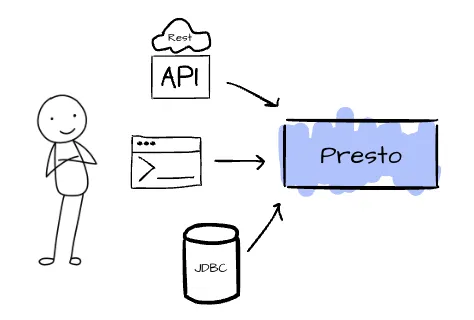
Presto предоставляет несколько клиентских интерфейсов:
- REST HTTP-интерфейс для клиентов.
- Интерфейс командной строки.
- JDBC-клиент, обеспечивающий совместимость с BI-инструментами, такими как Tableau.
Планирование и оптимизация запросов
Логический планировщик генерирует промежуточное представление (IR) плана запроса на основе синтаксического дерева. IR представляет собой дерево узлов плана, где каждый узел - это физическая или логическая операция, получающая входные данные от своих дочерних узлов.
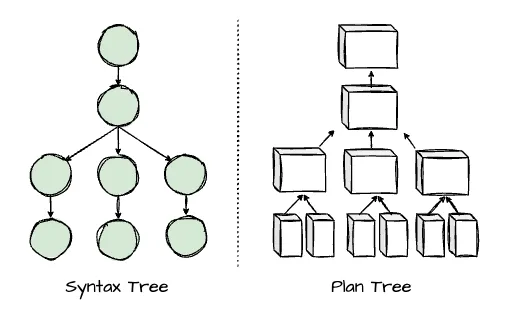
Оптимизатор запросов создает физический план на основе логического плана. В этом процессе используется набор правил преобразования, таких как вытеснение предикатов и ограничений, обрезка столбцов и декорреляция.
Схемы расположения данных
Для оптимизации запросов Presto использует физическую схему расположения данных, предоставляемую API-интерфейсом Data Layout коннектора. Некоторые сведения о компоновке включают расположение данных, схему их разбиения, индекс данных, а также способы сортировки или группировки данных.
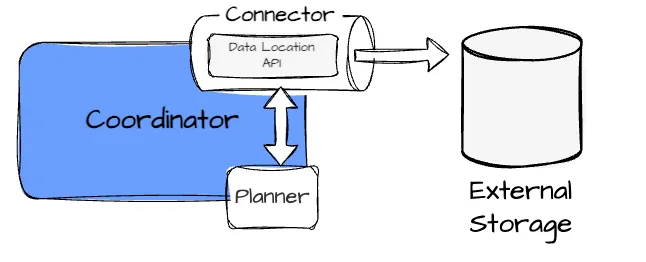
Для таблицы коннектор может возвращать не только информацию о компоновке; оптимизатор может выбрать наиболее эффективную компоновку для запроса. (например, используя разделение на части, но игнорируя сортировку).
Работа с предикатами
Presto может передавать предикаты источнику данных через коннекторы для того, чтобы повысить эффективность фильтрации. Оптимизатор будет взаимодействовать с коннектором, чтобы решить, когда именно использовать эту технику.
Параллелизм между узлами
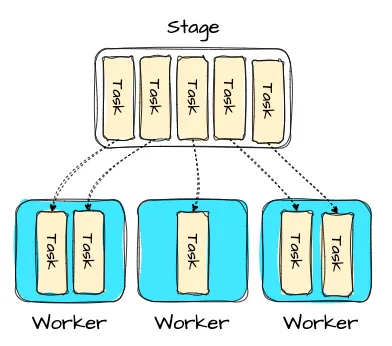
Оптимизатор также решает, какие этапы плана могут выполняться параллельно на всех рабочих узлах. Этап может содержать множество задач, выполняющих одну и ту же логику на подмножестве входных данных. При обмене данными между этапами происходит перетасовка. Перемешивание данных увеличивает задержку и использует много процессора и памяти. Таким образом, оптимизатор должен учитывать количество перетасовок в плане.
Параллелизм внутри узла
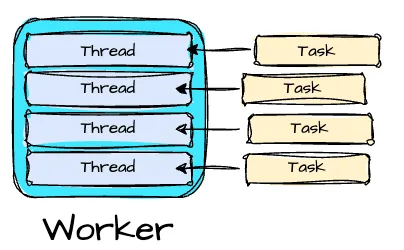
Оптимизатор может определять и распараллеливать секции на этапе плана между потоками на одном рабочем узле. Это гораздо эффективнее, чем межузловой параллелизм; потоки могут совместно использовать данные памяти, такие как хэш-таблицы или словари, с меньшими накладными расходами.
Планирование
Чтобы выполнить запрос, движок принимает два решения о планировании:
- Планирование этапов: Presto поддерживает две политики: all-at-once и поэтапную. В первом случае все этапы планируются одновременно, что выгодно для чувствительных к задержкам сценариев использования, таких как интерактивная аналитика. Поэтапная политика выполняет этапы в топологическом порядке. Например, хэш-соединение не будет планировать задачи из фазы зондирования до тех пор, пока не завершится фаза сборки. Поэтапная политика повышает эффективность использования памяти для пакетного использования.
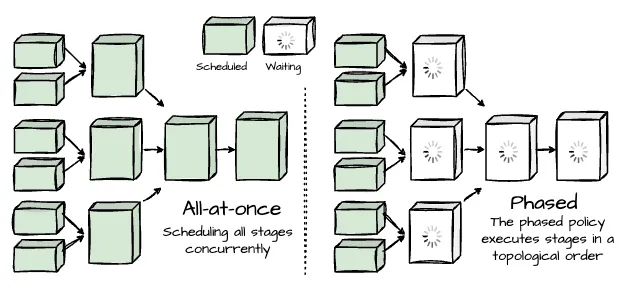
При хэш-соединении этап построения создает таблицу поиска (путем хэширования) из одного набора данных. Фаза зондирования использует эту таблицу для поиска совпадающих строк из таблицы поиска.
- Планирование задач: Планировщик задач делит этапы на листовые и промежуточные. Листовые этапы считывают данные с коннектора, а промежуточные этапы обрабатывают результаты других этапов. Листовые этапы считывают данные с коннекторов; при размещении учитываются ограничения сети и коннекторов. Промежуточные этапы обрабатывают промежуточные результаты; они могут быть размещены на любом рабочем узле.
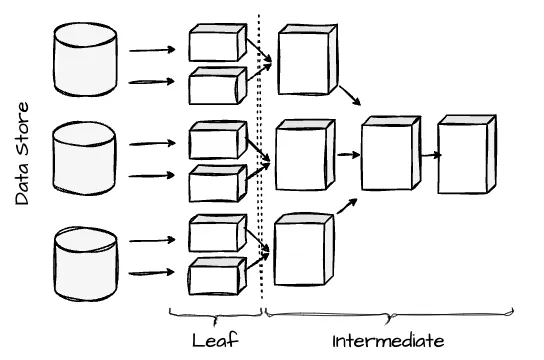
На листовом этапе узел получает один или несколько сплитов (фрагментов данных) от внешних систем. Координатор должен назначить один или несколько сплитов задаче листовой стадии, чтобы она получила право на выполнение. Задачи промежуточного этапа всегда имеют право на выполнение и завершаются, когда все вышестоящие задачи завершены.
Координатор назначает сплиты после того, как Presto установит задачи для рабочих узлов. Presto просит коннекторы перечислить небольшие партии сплитов и лениво назначает их задачам. Это имеет некоторые преимущества:
- Запросы, которым не нужно обрабатывать все данные, например, с фильтрами или условиями LIMIT, могут быть отменены раньше.
- Он отделяет время, необходимое для получения первого результата, от общего времени, необходимого для перечисления всех разделов. Это полезно в тех случаях, когда коннекторам вроде Hive может потребоваться значительное время для перечисления всех разделов и файлов.
- Ленивое перечисление позволяет не хранить все метаданные разбиения в памяти; коннектор Hive может обрабатывать миллионы разбиений.
- У рабочиего узла есть очередь назначенных разбиений. Координатор назначает разделы задачам с самой короткой очередью, сохраняя размер очереди небольшим и помогая управлять колебаниями времени обработки разных разделов и производительности рабочего.
Выполнение запросов
Поток выполняется в цикле над сплитом. Единицей данных, с которой работает цикл драйвера, является страница - столбцовое кодирование последовательности строк.
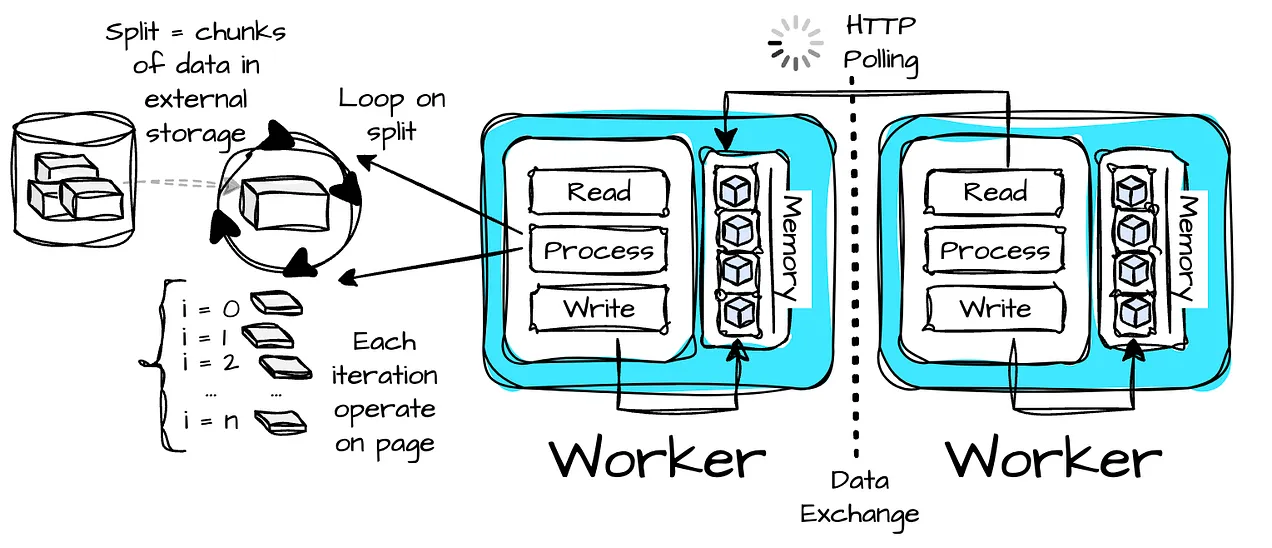
Для эффективного обмена данными между рабочими узлами в Presto используются буферизованные шаффлы в памяти по протоколу HTTP. Рабочие узлы хранят произведенные данные в памяти, чтобы другие рабочие узлы могли их использовать, выполняя HTTP-опрос. Движок настраивает параллелизм для поддержания целевого коэффициента использования выходных и входных буферов. Переполненные выходные буферы приводят к остановке выполнения сплита и занимают всю память, а недоиспользованные входные буферы добавляют ненужные накладные расходы на обработку.
Для процесса записи результатов Presto использует адаптивный подход для динамического увеличения параллелизма писателей.
Управление ресурсами
Presto идеально подходит для многопользовательских развертываний благодаря тонкой системе управления ресурсами; кластер может обрабатывать сотни запросов одновременно.
Facebook разработала механизм планирования процессора Presto, чтобы максимизировать общую пропускную способность кластера; приоритет отдается общему времени процессора, затраченному на обработку данных.
Presto использует модель кооперативной многозадачности и планирует одновременное выполнение задач на каждом рабочем узле для достижения многопользовательского доступа. Задача может выполняться только в течение максимального отрезка времени, называемого квантом. По истечении этого времени поток прекращает обработку данного сплита, независимо от того, завершен он или нет. Такой подход гарантирует, что ни один сплит не заберет все ресурсы, и позволяет эффективно распределять их между несколькими запросами.
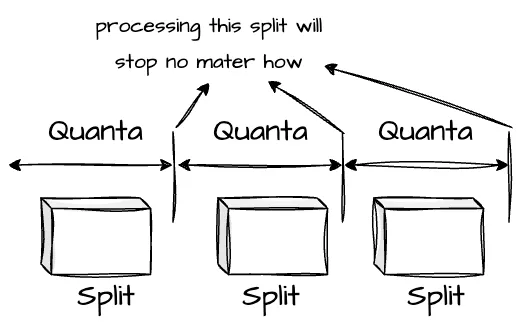
Кооперативная многозадачность - это метод многозадачности, используемый операционными системами, при котором каждый запущенный процесс должен периодически сигнализировать о том, что он выполнил свою задачу или что ему больше не нужны ресурсы процессора, чтобы дать возможность другим процессам выполнять свои задачи. Этот подход основан на добровольном сотрудничестве каждого процесса, чтобы передать контроль над системными ресурсами другим процессам.
Presto предоставляет операторам возможность отказаться от управления, чтобы решить проблемы длительных вычислений в кооперативной многозадачной среде. Если оператор превышает количество квантов, планировщик «начисляет» задаче использованное время потока, временно снижая частоту ее выполнения в будущем. Такая адаптивность обеспечивает эффективное распределение ресурсов даже при различных формах запросов.
Вместо того чтобы заранее предсказывать потребности в ресурсах, Presto классифицирует задачи на основе их накопленного процессорного времени. По мере того как задача использует больше процессора, она переходит на более высокие уровни очередей, каждый из которых получает настраиваемую долю доступного процессорного времени. Эта стратегия гарантирует, что менее требовательные запросы получат ресурсы, поскольку они накапливают меньше процессорного времени и остаются на более низких уровнях очереди. Это отражает ожидание того, что пользователи отдают предпочтение быстрым ответам на интерактивные запросы и не так чувствительны к времени возврата интенсивных заданий.
После процессора мы посмотрим, как Presto управляет ресурсами памяти.
Presto классифицирует выделяемую память как пользовательскую или системную. Пользовательская память относится к использованию памяти, которое пользователи могут оценить на основе своего понимания запроса и данных. Системная память представляет собой память, используемую в результате выбора реализации, например буферов перемешивания.
Presto имеет ограничения на пользовательскую и общую память (пользовательская + системная). Запрос, требующий ресурс памяти, превышающий память кластера или лимит для каждого узла, будет остановлен. Эти отдельные ограничения обеспечивают гибкость в управлении различными рабочими нагрузками.
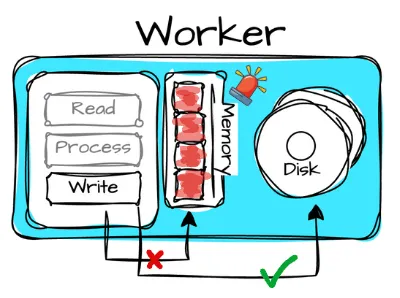
Когда память рабочего узла исчерпывается, Presto останавливает обработку задач на этом узле. Presto использует несколько стратегий для решения проблемы нехватки памяти и предотвращения нестабильности кластера:
- Переливание: Presto может отозвать память у подходящих задач, когда у узла заканчивается память, записав их состояние в памяти на диск. Presto устанавливает приоритет этого процесса на основе времени выполнения задач, начиная с самых долго выполняющихся задач. Конечно, выгрузка на диск увеличивает общее время ответа на запрос. В Facebook по умолчанию не включают функцию «переливания», поскольку пользователи ценят предсказуемую задержку при выполнении в памяти.
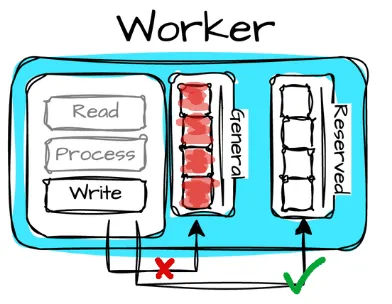
- Зарезервированный пул: Еще один механизм - резервный пул памяти. Presto делит пул памяти узла на общий и зарезервированный пулы. Presto продвигает запрос, потребляющий ресурсы памяти в зарезервированном пуле. Система учитывает использование памяти этим запросом в резервном пуле, не позволяя ему конкурировать с другими запросами за общий пул.
Отказоустойчивость
Последствия сбоев:
- Координатор: Если координатор выходит из строя, кластер становится недоступным.
- Рабочий узел: Если рабочий узел выходит из строя, все запросы, выполняемые на этом узле, не выполняются.
Чтобы смягчить последствия этих сбоев, Presto полагается на внешние механизмы:
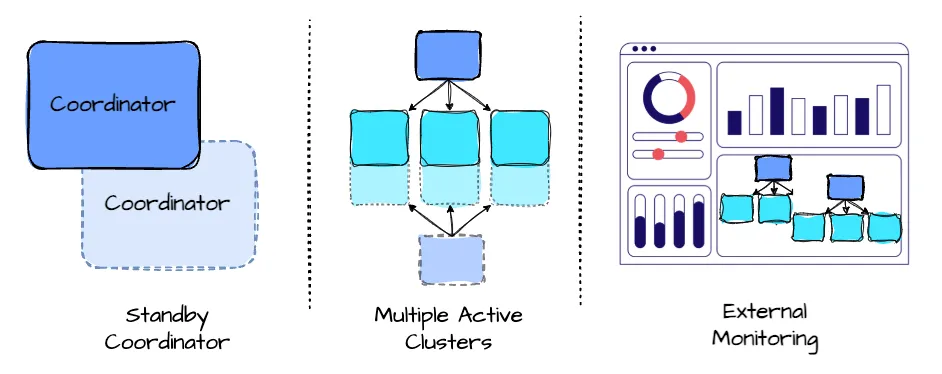
- Резервные координаторы: Facebook использует резервный координатор, готовый взять на себя ответственность в случае выхода из строя основного.
- Несколько активных кластеров: Facebook управляет несколькими активными кластерами Presto. Если один кластер выходит из строя, запросы могут выполняться на другом доступном кластере.
- Внешний мониторинг: Внешние системы следят за кластерами Presto, выявляют отказавшие узлы и удаляют их из кластера.
Хотя эти механизмы сокращают время простоя, они не могут его устранить. Реализация традиционных методов обеспечения отказоустойчивости, таких как создание контрольных точек или репликация, является сложной и ресурсоемкой задачей. На момент написания статьи компания Facebook работала над улучшением отказоустойчивости для длительных запросов.
Оптимизация
Для оптимизации обработки запросов в Presto Facebook применяет ряд специальных техник.
JVM и генерация кода
Поскольку компания Facebook разработала Presto на языке Java, она использует сильные стороны виртуальной машины Java (JVM), сводя к минимуму влияние ее ограничений. Presto использует компилятор JVM Just-In-Time (JIT) для оптимизации критически важного кода.
Presto избегает выделения больших объектов для предотвращения проблем с производительностью и использует плоские массивы памяти для критически важных структур данных, сокращая накладные расходы на сборку мусора.
Особенности формата файла
Presto использует особенности форматов колоночных файлов для оптимизации обработки данных:
- Пропуск данных: Пользовательские программы чтения для таких форматов, как ORC и Parquet, используют статистику в заголовках и нижних колонтитулах файлов (например, диапазоны min-max, фильтры Блума) для эффективного пропуска нерелевантных секций данных.
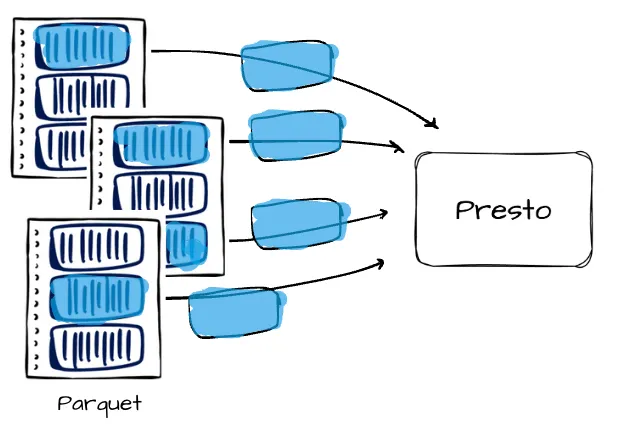
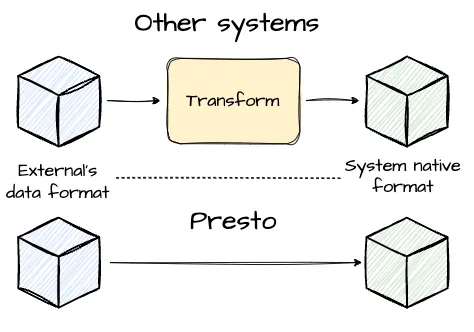
- Прямое преобразование блоков: Считыватели могут напрямую конвертировать сжатые данные в родной формат блоков Presto, обеспечивая эффективную обработку без накладных расходов на декомпрессию.
Работа с сжатыми данными
Presto обрабатывает данные в сжатом виде, когда это возможно:
- Обработка словарей и блоков с кодировкой длины пробега (RLE): Presto выполняет операции прямо на сжатых данных, используя преимущества их структуры для эффективной обработки. Он обрабатывает словари в быстрых безусловных циклах, а их структура используется при построении хэш-таблиц для объединения и агрегирования.
- Сжатые промежуточные результаты: Presto создает сжатые промежуточные результаты, минимизируя перемещение и хранение данных. Например, процессор объединений генерирует словарные или RLE-блоки для выходных данных, используя существующие сжатые структуры.
Ленивая загрузка данных
Presto поддерживает ленивую материализацию, загружая и обрабатывая данные только тогда, когда это необходимо: Presto распаковывает и декодирует данные в сжатых блоках (словарь или RLE) только при обращении к ячейкам блока. Это минимизирует количество получаемых и обрабатываемых данных, что приводит к значительному увеличению производительности.


