

Файлы Parquet повсюду
Для многих аналитиков, работающих с большими данными, формат файлов Parquet является золотым стандартом. Он присутствует практически во всех наших рабочих процессах - озера данных, денормализованные таблицы и многое другое построено на Parquet. Но насколько хорошо мы понимаем этот формат? Что отличает его от таких альтернатив, как Avro или CSV? И, возможно, самое важное – в каких случаях Parquet – не самое лучшее решение?
Я сделаю небольшое отступление и рассмотрю различные форматы хранения данных. Такой подход поможет прояснить преимущества и ограничения файла Parquet, сделав «почему» и «почему нет» более очевидными.
Хранение данных, ориентированное на строки
Хранилище на основе строк хранит все данные одной строки в едином непрерывном месте на диске. Оно лучше всего подходит для систем OLTP (Online Transaction Processing). Например, система бронирования отелей.
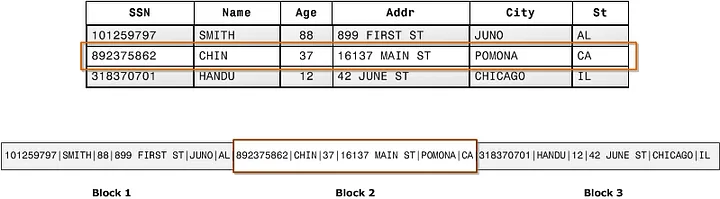
Хранение на основе строк имеет ряд преимуществ. Оно быстро обращается к отдельным записям и обеспечивает эффективное обновление. Это связано с тем, что изменяется только конкретная строка, не затрагивая другие. Это хранилище не очень хорошо справляется с аналитическими задачами. К технологиям в этой области относятся MySQL, PostgreSQL, Avro или CSV.
Хранилище на основе строк отлично справляется с такими запросами, как «Как называется строка 2?» или «Найти все продажи в США?». Можно представить себе хранилище на основе строк как множество книг, где каждая книга содержит полную историю одного человека (идеально для быстрого поиска истории конкретного человека).
Хранение, ориентированное на столбцы
Хранилище на основе столбцов хранит все значения одного столбца вместе. Это оптимальный вариант для аналитики (OLAP-системы).
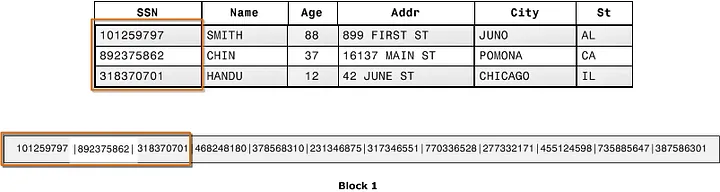
Хранилище на основе столбцов очень быстро справляется с суммированием, усреднением или подсчетом. Кроме того, оно обеспечивает отличное сжатие. К технологиям в этой области относятся файлы Parquet - или нет? подробнее об этом позже - и ORC.
Почему хранилища на основе столбцов лучше справляются с фильтрацией и группировкой данных? Потому что хранилище на основе строк должно сканировать строки последовательно, а поскольку строки хранятся непрерывно, базе данных придется обрабатывать все столбцы для каждой строки, даже если некоторые из них не нужны для фильтрации или группировки.
Хранилище на основе столбцов отлично справляется с такими запросами, как «Каково общее количество продаж?». Можно представить себе хранилище на основе столбцов как книгу, в которой каждая глава содержит данные об определенном атрибуте: возрасте, имени, городе.

Гибридное хранение данных, Привет, Parquet!
Если Вы попросите ChatGPT привести примеры хранилищ, ориентированных на столбцы, он с гордостью скажет Вам, что Parquet – это то, что Вам нужно. Но это не совсем так, ведь файлы Parquet - это гибридное хранилище. И вот почему:
Файлы Parquet организуют данные вертикально (группы столбцов) и горизонтально (группы строк). Преимуществами этого формата файлов являются метаданные, кодирование и многофайловость. Файлы Parquet - отличный вариант для решения аналитических задач с большим объемом данных.
- Файлы Parquet организуют данные вертикально (куски столбцов) и горизонтально (группы строк). Преимуществами этого формата файлов являются метаданные, кодирование и многофайловость. Файлы Parquet - отличный формат для аналитических задач с большим объемом данных.
- Метаданные: Содержат важную информацию, например, минимальные и максимальные значения каждого столбца. Движки запросов используют эти метаданные, чтобы эффективно пропускать целые группы строк и считывать только необходимые столбцы, что значительно повышает производительность.
- Кодировка: Файлы Parquet имеют словарное кодирование вместе с кодированием длины выполнения (Run-Length Encoding, RLE). При словарном кодировании большие строки заменяются целыми числами, а их сопоставление сохраняется в метаданных. После словарного кодирования данные дополнительно сжимаются с помощью RLE.
- Многофайловые файлы / партиционирование: Parquet поддерживает разбиение на разделы и многофайловый вывод, позволяя разделить наборы данных на несколько файлов или каталогов по заданным критериям. Например, для повышения производительности запросов принято разделять файлы по дате: данные за 2024-08-01 хранятся в папке date=2024-08-01, а данные за 2024-08-02 - в date=2024-08-02. Используя дату в качестве фильтра, системы запросов пропускают неактуальные разделы, значительно сокращая объем обрабатываемых данных.
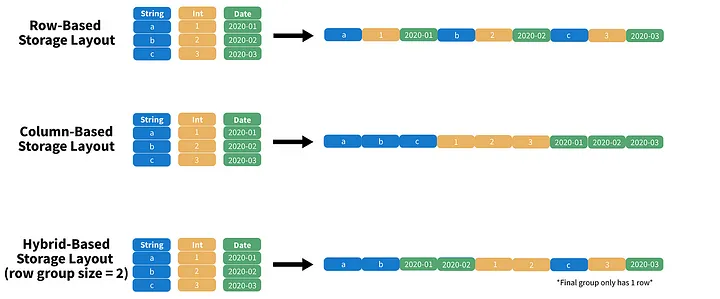
Итак, файлы Parquet максимально эффективны при минимизации сканирования таблиц и отлично справляются со сжатием, так почему бы не использовать их постоянно в аналитических целях? Ниже приведены два случая, в которых лично я воздержался бы от использования Parquet…
Во-первых, если Вы когда-нибудь использовали Parquet, то наверняка знаете, что при получении конкретного значения или при доступе всего к нескольким строкам он крайне медлителен. Это происходит потому, что файлы содержат много оверхедов. Метаданные и сжатие? При небольших объемах чтения стоимость разбора этих метаданных может перевесить все их преимущества. Кроме того, декомпрессия и декодирование для небольших запросов добавляют накладные оверхеды. Другими словами, не храните данные в Parquet, если Вы используете OLTP.
Второе: Parquet - не самое оптимальное решение для небольших наборов данных. Хранение множества небольших файлов в формате Parquet может привести к снижению производительности. Например, если Ваш пайплайн часто вызывает API для получения небольших фрагментов данных, использование Parquet приведет к нежелательным оверхедам на метаданные и сжатие. Это не только увеличивает время записи файлов, но и может привести к увеличению затрат на хранение данных в Вашем ETL-пайплайне.


