

Комплексная система обработки данных на основе реальных данных с использованием Kafka, Spark, Airflow, Postgres и Docker
Этот проект, который идеально подходит для тех, кто не знаком с системами обработки данных или приложениями с языковой моделью, состоит из двух сегментов:
В этой начальной статье вы узнаете, как построить конвейер передачи данных с использованием Kafka для потоковой передачи, Airflow для оркестровки, Spark для преобразования данных и PostgreSQL для хранения. Для настройки и запуска этих инструментов мы будем использовать Docker.
- Вторая статья, которая выйдет позже, будет посвящена созданию агентов с использованием таких инструментов, как LangChain, для взаимодействия с внешними базами данных.
- Эта первая часть проекта идеально подходит для начинающих в области разработки данных, а также для специалистов по обработке данных и инженеров по машинному обучению, которые хотят углубить свои знания о процессе обработки данных в целом. Полезно использовать эти инструменты для разработки данных на собственном опыте. Это помогает усовершенствовать создание и расширение моделей машинного обучения, обеспечивая их эффективную работу в практических условиях.
В этой статье больше внимания уделяется практическому применению, а не теоретическим аспектам обсуждаемых инструментов. Для получения подробного представления о том, как эти инструменты работают внутри компании, в Интернете доступно множество отличных ресурсов.

Обзор
Давайте разберем процесс конвейерной обработки данных шаг за шагом:
- Потоковая передача данных: Изначально данные передаются из API в раздел Kafka.
- Обработка данных: Затем выполняется задание Spark, которое использует данные из раздела Kafka и переносит их в базу данных PostgreSQL.
- Планирование с помощью Airflow: Как потоковая задача, так и задание Spark организуются с помощью Airflow. Хотя в реальном сценарии разработчик Kafka постоянно прослушивал бы API, в демонстрационных целях мы запланируем ежедневное выполнение потоковой задачи Kafka. Как только потоковая передача завершена, Spark обрабатывает данные, подготавливая их к использованию приложением LLM.
Все эти инструменты будут созданы и запущены с использованием docker, а точнее, docker-compose.
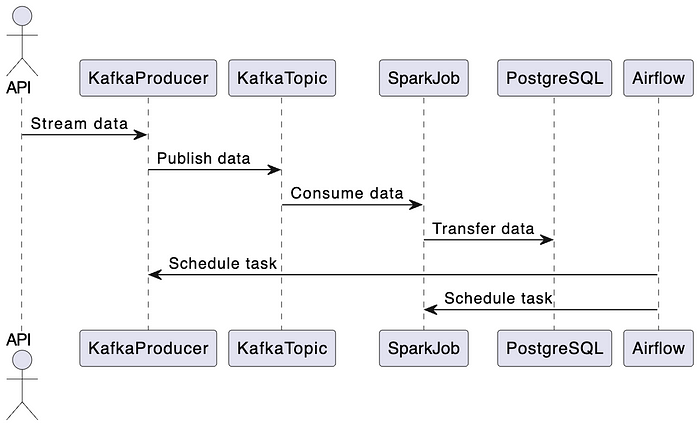
Обзор конвейера передачи данных. Изображение предоставлено автором.
Теперь, когда у нас есть схема нашего конвейера, давайте углубимся в технические детали!
Локальная настройка
Сначала вы можете клонировать репозиторий Github на своем локальном компьютере, используя следующую команду:
git clone https://github.com/HamzaG737/data-engineering-project.git
Вот общая структура проекта:
├── LICENSE
├── README.md
├── airflow
│   ├── Dockerfile
│   ├── __init__.py
│   └── dags
│       ├── __init__.py
│       └── dag_kafka_spark.py
├── data
│   └── last_processed.json
├── docker-compose-airflow.yaml
├── docker-compose.yml
├── kafka
├── requirements.txt
├── spark
│   └── Dockerfile
└── src
    ├── __init__.py
    ├── constants.py
    ├── kafka_client
    │   ├── __init__.py
    │   └── kafka_stream_data.py
    └── spark_pgsql
        └── spark_streaming.py
- Каталог data содержит файл last_processed.json, который имеет решающее значение для задачи потоковой передачи Kafka. Более подробная информация о его роли будет представлена в разделе, посвященном Kafka.
- Каталог airflow содержит пользовательский файл Dockerfile для настройки airflow и каталог dags для создания и планирования задач.
- Файл docker-compose-airflow.yaml определяет все службы, необходимые для запуска airflow.
- Файл docker-compose.yaml определяет службы Kafka и включает docker-proxy. Этот прокси-сервер необходим для выполнения заданий Spark через docker-оператора в Airflow, концепция которого будет рассмотрена позже.
- Каталог spark содержит пользовательский файл Dockerfile для настройки spark.
- src содержит модули python, необходимые для запуска приложения.
Чтобы настроить локальную среду разработки, начните с установки необходимых пакетов Python. Единственным необходимым пакетом является psycopg2-binary. У вас есть возможность установить только этот пакет или все пакеты, перечисленные в файле requirements.txt. Чтобы установить все пакеты, используйте следующую команду:
pip install -r requirements.txt
Далее давайте пошагово рассмотрим детали проекта.
Об API
API - это RappelConso от французских государственных служб. Он предоставляет доступ к данным, касающимся отзывов продуктов, объявленных профессионалами во Франции. Данные представлены на французском языке и изначально содержат 31 столбец (или поле). Вот некоторые из наиболее важных::
- sous_categorie_de_produit (подкатегория товара): Например, мы можем включить мясо, молочные продукты, крупы в качестве подкатегорий в категорию продуктов питания.
- categorie_de_produit (Категория товара): Например, продукты питания, электроприборы, инструменты, транспортные средства и т.д. …
- reference_fiche (справочный лист): Уникальный идентификатор отзываемого продукта. Позже он будет использоваться в качестве первичного ключа нашей базы данных Postgres.
- motif_de_rappel (причина отзыва): не требует пояснений и является одним из наиболее важных полей.
- date_de_publication, которая переводится как дата публикации.
- risques_encourus_par_le_consommateur содержит информацию о рисках, с которыми потребитель может столкнуться при использовании продукта.
- Также есть несколько полей, соответствующих различным ссылкам, таким как ссылка на изображение продукта, ссылка на список распространителей и т.д..
Мы усовершенствовали столбцы данных несколькими ключевыми способами:
- Такие столбцы, как ndeg_de_version и rappelguid, которые были частью системы управления версиями, были удалены, поскольку они не нужны для нашего проекта.
- Мы объединили столбцы, посвященные потребительским рискам, — risques_encourus_par_le_consommateur и description_complementaire_du_risque — для более четкого обзора рисков, связанных с продуктом.
- Столбец date_debut_fin_de_commercialization, который указывает на период маркетинга, был разделен на две отдельные колонки. Такое разделение позволяет упростить запросы о начале или окончании маркетинга продукта.
- Мы убрали акценты из всех столбцов, за исключением ссылок, номеров ссылок и дат. Это важно, потому что некоторые инструменты обработки текста не справляются с символами с ударением.
Для подробного ознакомления с этими изменениями ознакомьтесь с нашим сценарием преобразования по адресу src/kafka_client/transformations.py. Обновленный список столбцов доступен insrc/constants.py в разделе DB_FIELDS.
Потоковая передача Kafka
Чтобы избежать отправки всех данных из API при каждом запуске задачи потоковой передачи, мы определяем локальный json-файл, содержащий дату последней публикации последней потоковой передачи. Затем мы будем использовать эту дату в качестве начальной для нашей новой задачи потоковой передачи.
В качестве примера предположим, что последний отозванный продукт был опубликован 22 ноября 2023 года. Если мы предположим, что информация обо всех отозванных продуктах до этой даты уже сохранилась в нашей базе данных Postgres, то теперь мы можем передавать данные в потоковом режиме, начиная с 22 ноября. Обратите внимание, что это совпадение, поскольку у нас может быть сценарий, в котором мы не обработали все данные за 22 ноября.
Файл сохранен в ./data/last_processed.json и имеет следующий формат:
{last_processed:"2023-11-22"}
По умолчанию файл представляет собой пустой json-файл, что означает, что наша первая потоковая задача обработает все записи API, которых приблизительно 10 000.
Обратите внимание, что в производственных условиях такой подход к сохранению даты последней обработки в локальном файле нежизнеспособен, и другие подходы, включающие внешнюю базу данных или службу хранения объектов, могут оказаться более подходящими.
Код для потоковой передачи kafka можно найти на ./src/kafka_client/kafka_stream_data.py и он включает в себя, в первую очередь, запрос данных из API, выполнение преобразований, удаление потенциальных дубликатов, обновление даты последней публикации и обработку данных с помощью kafka producer.
Следующим шагом будет запуск службы kafka, определенной в docker-compose, определенной ниже:
version: '3'

services:
  kafka:
    image: 'bitnami/kafka:latest'
    ports:
      - '9094:9094'
    networks:
      - airflow-kafka
    environment:
      - KAFKA_CFG_NODE_ID=0
      - KAFKA_CFG_PROCESS_ROLES=controller,broker
      - KAFKA_CFG_LISTENERS=PLAINTEXT://:9092,CONTROLLER://:9093,EXTERNAL://:9094
      - KAFKA_CFG_ADVERTISED_LISTENERS=PLAINTEXT://kafka:9092,EXTERNAL://localhost:9094
      - KAFKA_CFG_LISTENER_SECURITY_PROTOCOL_MAP=CONTROLLER:PLAINTEXT,EXTERNAL:PLAINTEXT,PLAINTEXT:PLAINTEXT
      - KAFKA_CFG_CONTROLLER_QUORUM_VOTERS=0@kafka:9093
      - KAFKA_CFG_CONTROLLER_LISTENER_NAMES=CONTROLLER
    volumes:
      - ./kafka:/bitnami/kafka

  kafka-ui:
    container_name: kafka-ui-1
    image: provectuslabs/kafka-ui:latest
    ports:
      - 8800:8080
    depends_on:
      - kafka
    environment:
      KAFKA_CLUSTERS_0_NAME: local
      KAFKA_CLUSTERS_0_BOOTSTRAPSERVERS: PLAINTEXT://kafka:9092
      DYNAMIC_CONFIG_ENABLED: 'true'
    networks:
      - airflow-kafka

networks:
  airflow-kafka:
    external: true
- Сервис kafka использует базовый образ bitnami/kafka.
- Мы настраиваем сервис только с одним брокером, которого достаточно для нашего небольшого проекта. Брокер Kafka отвечает за получение сообщений от производителей (которые являются источниками данных), хранение этих сообщений и доставку их потребителям (которые являются получателями или конечными пользователями данных). Брокер прослушивает порт 9092 для внутренней связи внутри кластера и порт 9094 для внешней связи, позволяя клиентам за пределами сети Docker подключаться к брокеру Kafka.
- В части, касающейся томов, мы сопоставляем локальный каталог kafka с каталогом контейнеров docker /bitnami/kafka, чтобы обеспечить сохранность данных и возможную проверку данных Kafka из хост-системы.
- Мы настроили сервис kafka-ui, который использует образ docker provectuslabs/kafka-ui:latest . Он предоставляет пользовательский интерфейс для взаимодействия с кластером Kafka. Это особенно полезно для мониторинга тем и сообщений Kafka и управления ими.
- Чтобы обеспечить связь между kafka и airflow, которые будут запущены как внешняя служба, мы будем использовать внешнюю сеть airflow-kafka.
Перед запуском службы kafka давайте создадим сеть airflow-kafka, используя следующую команду:
docker network create airflow-kafka
Теперь все готово к окончательному запуску нашего сервиса kafka
docker-compose up
После запуска сервисов зайдите в kafka-ui по адресу http://localhost:8800/. Обычно у вас должно получиться что-то вроде этого:
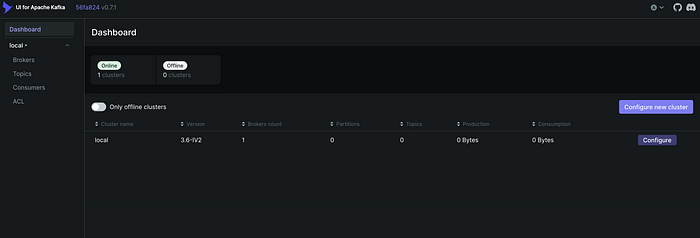
Далее мы создадим нашу тему, которая будет содержать сообщения API. Нажмите на разделы слева, а затем добавьте тему вверху слева. Наша тема будет называться rappel_conso, и поскольку у нас есть только один брокер, мы устанавливаем коэффициент репликации равным 1. Мы также установим номер раздела равным 1, так как одновременно у нас будет только один поток-потребитель, поэтому нам не понадобится никакой параллелизм. Наконец, мы можем установить небольшое время для сохранения данных, например, один час, поскольку мы запустим задание spark сразу после задачи потоковой передачи kafka, поэтому нам не нужно будет долго сохранять данные в разделе, посвященном kafka.
Настройка Postgres
Прежде чем настраивать наши конфигурации spark и airflow, давайте создадим базу данных Postgres, в которой будут храниться наши данные API. Для этой задачи я использовал инструмент pgadmin 4, однако с этой задачей может справиться любая другая платформа разработки Postgres.
Чтобы установить postgres и pgadmin, перейдите по этой ссылке https://www.postgresql.org/download/ и получите пакеты, соответствующие вашей операционной системе. Затем при установке postgres вам необходимо установить пароль, который нам понадобится позже для подключения к базе данных из среды spark. Вы также можете оставить порт 5432.
Если установка прошла успешно, вы можете запустить pgadmin, и вы увидите примерно такое окно:
Поскольку у нас много столбцов для таблицы, которую мы хотим создать, мы решили создать таблицу и добавить в нее столбцы с помощью скрипта, используя psycopg2, адаптер базы данных PostgreSQL для Python.
Вы можете запустить скрипт с помощью команды:
python scripts/create_table.py
Обратите внимание, что в скрипте я сохранил пароль postgres в качестве переменной окружения и назвал его POSTGRES_PASSWORD. Поэтому, если вы используете другой метод для доступа к паролю, вам нужно соответствующим образом изменить скрипт.
Настройка Spark
Настроив нашу базу данных Postgres, давайте углубимся в детали задания spark. Цель состоит в том, чтобы передать данные из раздела Kafka rappel_conso в таблицу Postgres rappel_conso_table.
from pyspark.sql import SparkSession
from pyspark.sql.types import (
    StructType,
    StructField,
    StringType,
)
from pyspark.sql.functions import from_json, col
from src.constants import POSTGRES_URL, POSTGRES_PROPERTIES, DB_FIELDS
import logging

logging.basicConfig(
    level=logging.INFO, format="%(asctime)s:%(funcName)s:%(levelname)s:%(message)s"
)

def create_spark_session() -> SparkSession:
    spark = (
        SparkSession.builder.appName("PostgreSQL Connection with PySpark")
        .config(
            "spark.jars.packages",
            "org.postgresql:postgresql:42.5.4,org.apache.spark:spark-sql-kafka-0-10_2.12:3.5.0",
        )
        .getOrCreate()
    )

   logging.info("Spark session created successfully")
    return spark

def create_initial_dataframe(spark_session):
    """
    Reads the streaming data and creates the initial dataframe accordingly.
    """
    try:
        # Gets the streaming data from topic random_names
        df = (
            spark_session.readStream.format("kafka")
            .option("kafka.bootstrap.servers", "kafka:9092")
            .option("subscribe", "rappel_conso")
            .option("startingOffsets", "earliest")
            .load()
        )
        logging.info("Initial dataframe created successfully")
    except Exception as e:
        logging.warning(f"Initial dataframe couldn't be created due to exception: {e}")
        raise

    return df

def create_final_dataframe(df):
    """
    Modifies the initial dataframe, and creates the final dataframe.
    """
    schema = StructType(
        [StructField(field_name, StringType(), True) for field_name in DB_FIELDS]
    )
    df_out = (
        df.selectExpr("CAST(value AS STRING)")
        .select(from_json(col("value"), schema).alias("data"))
        .select("data.*")
    )
    return df_out

def start_streaming(df_parsed, spark):
    """
    Starts the streaming to table spark_streaming.rappel_conso in postgres
    """
    # Read existing data from PostgreSQL
    existing_data_df = spark.read.jdbc(
        POSTGRES_URL, "rappel_conso", properties=POSTGRES_PROPERTIES
    )

    unique_column = "reference_fiche"
    logging.info("Start streaming ...")
    query = df_parsed.writeStream.foreachBatch(
        lambda batch_df, _: (
            batch_df.join(
                existing_data_df, batch_df[unique_column] == existing_data_df[unique_column], "leftanti"
            )
            .write.jdbc(
                POSTGRES_URL, "rappel_conso", "append", properties=POSTGRES_PROPERTIES
            )
        )
    ).trigger(once=True) \
        .start()
   return query.awaitTermination()

def write_to_postgres():
    spark = create_spark_session()
    df = create_initial_dataframe(spark)
    df_final = create_final_dataframe(df)
    start_streaming(df_final, spark=spark)

if __name__ == "__main__":
    write_to_postgres()
Давайте рассмотрим основные моменты и функциональные возможности spark-задания:
Сначала мы создаем Spark-сессию
def create_spark_session() -> SparkSession:
    spark = (
        SparkSession.builder.appName("PostgreSQL Connection with PySpark")
        .config(
            "spark.jars.packages",
            "org.postgresql:postgresql:42.5.4,org.apache.spark:spark-sql-kafka-0-10_2.12:3.5.0",

       )
        .getOrCreate()
    )

   logging.info("Spark session created successfully")
   return spark
Функция create_initial_dataframe использует потоковые данные из раздела Kafka, используя структурированную потоковую передачу Spark.
def create_initial_dataframe(spark_session):
    """
    Reads the streaming data and creates the initial dataframe accordingly.
    """
    try:
        # Gets the streaming data from topic random_names
        df = (
            spark_session.readStream.format("kafka")
            .option("kafka.bootstrap.servers", "kafka:9092")
            .option("subscribe", "rappel_conso")
            .option("startingOffsets", "earliest")
            .load()
        )
        logging.info("Initial dataframe created successfully")
    except Exception as e:
        logging.warning(f"Initial dataframe couldn't be created due to exception: {e}")
        raise

   return df
Как только данные получены, create_final_dataframe преобразует их. Он применяет схему (определенную столбцами DB_FIELDS) к входящим данным JSON, гарантируя, что данные структурированы и готовы к дальнейшей обработке.
def create_final_dataframe(df):
    """
    Modifies the initial dataframe, and creates the final dataframe.
    """
    schema = StructType(
        [StructField(field_name, StringType(), True) for field_name in DB_FIELDS]
    )
    df_out = (
        df.selectExpr("CAST(value AS STRING)")
        .select(from_json(col("value"), schema).alias("data"))
        .select("data.*")
    )
    return df_out
Функция start_streaming считывает существующие данные из базы данных, сравнивает их с входящим потоком и добавляет новые записи.
def start_streaming(df_parsed, spark):
    """
    Starts the streaming to table spark_streaming.rappel_conso in postgres
    """
    # Read existing data from PostgreSQL
    existing_data_df = spark.read.jdbc(
        POSTGRES_URL, "rappel_conso", properties=POSTGRES_PROPERTIES
    )

   unique_column = "reference_fiche"
   logging.info("Start streaming ...")
    query = df_parsed.writeStream.foreachBatch(
        lambda batch_df, _: (
            batch_df.join(
                existing_data_df, batch_df[unique_column] == existing_data_df[unique_column], "leftanti"
            )
            .write.jdbc(
                POSTGRES_URL, "rappel_conso", "append", properties=POSTGRES_PROPERTIES
            )
        )
    ).trigger(once=True) \
        .start()

    return query.awaitTermination()
Полный код для задания Spark находится в файле src/spark_pgsql/spark_streaming.py. Для выполнения этого задания мы будем использовать Airflow DockerOperator, как описано в следующем разделе.
Давайте рассмотрим процесс создания образа Docker, необходимого для запуска нашего задания Spark. Вот файл Dockerfile для справки:
FROM bitnami/spark:latest

WORKDIR /opt/bitnami/spark
RUN pip install py4j

COPY ./src/spark_pgsql/spark_streaming.py ./spark_streaming.py
COPY ./src/constants.py ./src/constants.py

ENV POSTGRES_DOCKER_USER=host.docker.internal
ARG POSTGRES_PASSWORD
ENV POSTGRES_PASSWORD=$POSTGRES_PASSWORD
В этом файле Dockerfile мы начинаем с образа bitnami/spark в качестве основы. Это готовый к использованию образ Spark. Затем мы устанавливаем py4j, инструмент, необходимый Spark для работы с Python.
Переменные среды POSTGRES_DOCKER_USER и POSTGRES_PASSWORD настроены для подключения к базе данных PostgreSQL. Поскольку наша база данных находится на хост-компьютере, мы используем host.docker.internal в качестве пользователя. Это позволяет нашему контейнеру Docker получать доступ к службам на хосте, в данном случае к базе данных PostgreSQL. Пароль для PostgreSQL передается в качестве аргумента сборки, поэтому он не является жестко запрограммированным в образе.
Важно отметить, что такой подход, особенно передача пароля базы данных во время сборки, может быть небезопасным для производственных сред. Это потенциально может привести к раскрытию конфиденциальной информации. В таких случаях следует рассмотреть более безопасные методы, такие как Docker BuildKit.
Теперь давайте создадим образ Docker для Spark:
docker build -f spark/Dockerfile -t rappel-conso/spark:последняя версия --build-arg POSTGRES_PASSWORD=$POSTGRES_PASSWORD .
Эта команда создаст образ rappel-conso/spark:latest . Этот образ включает в себя все необходимое для запуска нашего задания Spark и будет использоваться DockerOperator от Airflow для выполнения задания. Не забудьте заменить $POSTGRES_PASSWORD на ваш действительный пароль PostgreSQL при выполнении этой команды.
Airflow
Как говорилось ранее, Apache Airflow служит инструментом согласования в конвейере передачи данных. Он отвечает за планирование и управление рабочим процессом задач, обеспечивая их выполнение в определенном порядке и при определенных условиях. В нашей системе Airflow используется для автоматизации потока данных от потоковой передачи с помощью Kafka до обработки с помощью Spark.
Airflow DAG
Давайте взглянем на направленный ациклический граф (DAG), который описывает последовательность и зависимости задач, позволяя Airflow управлять их выполнением.
start_date = datetime.today() - timedelta(days=1)

default_args = {
    "owner": "airflow",
    "start_date": start_date,
    "retries": 1,  # number of retries before failing the task
    "retry_delay": timedelta(seconds=5),
}

with DAG(
    dag_id="kafka_spark_dag",
    default_args=default_args,
    schedule_interval=timedelta(days=1),
    catchup=False,
) as dag:

    kafka_stream_task = PythonOperator(
        task_id="kafka_data_stream",
        python_callable=stream,
        dag=dag,
    )

   spark_stream_task = DockerOperator(
        task_id="pyspark_consumer",
        image="rappel-conso/spark:latest",
        api_version="auto",
        auto_remove=True,
        command="./bin/spark-submit --master local[*] --packages org.postgresql:postgresql:42.5.4,org.apache.spark:spark-sql-kafka-0-10_2.12:3.5.0 ./spark_streaming.py",
        docker_url='tcp://docker-proxy:2375',
        environment={'SPARK_LOCAL_HOSTNAME': 'localhost'},
        network_mode="airflow-kafka",
        dag=dag,
    )

    kafka_stream_task >> spark_stream_task
Вот ключевые элементы этой конфигурации
- Задачи настроены на ежедневное выполнение.
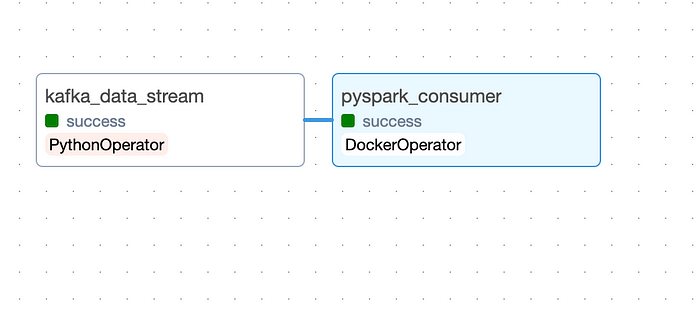
- Первая задача - это задача Kafka Stream. Она реализована с использованием PythonOperator для запуска потоковой функции Kafka. Эта задача передает данные из API RappelConso в раздел Kafka, инициируя рабочий процесс обработки данных.
- Следующей задачей является задача Spark Stream. Для выполнения используется DockerOperator. Он запускает контейнер Docker с нашим пользовательским образом Spark, которому поручено обрабатывать данные, полученные из Kafka.
- Задачи расположены последовательно, где задача потоковой передачи Kafka предшествует задаче обработки Spark. Этот порядок имеет решающее значение для обеспечения того, чтобы данные сначала передавались в потоковом режиме и загружались в Kafka, а затем обрабатывались в Spark.
О DockerOperator
Использование docker operator позволяет нам запускать docker-контейнеры, соответствующие нашим задачам. Основным преимуществом такого подхода является упрощение управления пакетами, лучшая изоляция и улучшенная тестируемость. Мы продемонстрируем использование этого оператора в задаче spark streaming.
Ниже приведены некоторые ключевые сведения об операторе docker для задачи spark streaming.:
- Мы будем использовать изображение rappel-conso/spark: последнее, указанное в разделе Настройки Spark.
- Команда будет работать искру подать команду внутри контейнера, указания учителя, местные, в том числе необходимые пакеты для PostgreSQL и Кафка интеграции, и, указывая на сценарий spark_streaming.py что содержит логику для работы свечи зажигания.
- docker_url представляет URL-адрес хоста, на котором запущен демон docker. Естественным решением было бы задать его как unix://var/run/docker.sock и смонтировать var/run/docker.sock в контейнере airflow docker. Одной из проблем, с которой мы столкнулись при таком подходе, является ошибка разрешения на использование файла socket внутри контейнера airflow. Распространенный обходной путь - изменение разрешений с помощью chmod 777 var/run/docker.sock - представляет значительную угрозу безопасности. Чтобы обойти это, мы внедрили более безопасное решение, используя bobrik/socat в качестве docker-прокси. Этот прокси, определенный в службе Docker Compose, прослушивает TCP-порт 2375 и перенаправляет запросы в сокет Docker:
docker-proxy:
    image: bobrik/socat
    command: "TCP4-LISTEN:2375,fork,reuseaddr UNIX-CONNECT:/var/run/docker.sock"
    ports:
      - "2376:2375"
    volumes:
      - /var/run/docker.sock:/var/run/docker.sock
    networks:
      - airflow-kafka
В DockerOperator мы можем получить доступ к хосту docker /var/run/docker.sock через URL-адрес http://docker-proxy:2375
Наконец, мы устанавливаем сетевой режим на airflow-kafka. Это позволяет нам использовать ту же сеть, что и прокси-сервер, и docker, в которых запущен kafka. Это важно, поскольку в задании spark будут использоваться данные из раздела kafka, поэтому мы должны убедиться, что оба контейнера могут взаимодействовать.
После определения логики нашего DAG давайте теперь разберемся с конфигурацией служб airflow в файле docker-compose-airflow.yaml.
Конфигурация Airflow
Файл compose для airflow был адаптирован из официального файла apache airflow docker-compose. Вы можете ознакомиться с исходным файлом.
Предлагаемая версия airflow является очень ресурсоемкой, главным образом потому, что в качестве ядра-исполнителя используется CeleryExecutor, который более приспособлен для распределенных и крупномасштабных задач обработки данных. Поскольку у нас небольшая рабочая нагрузка, достаточно использовать LocalExecutor с одним узлом.
Вот обзор изменений, которые мы внесли в конфигурацию airflow для docker-compose:
- Мы присвоили переменной среды AIRFLOW__CORE__EXECUTOR значение LocalExecutor.
- Мы удалили службы airflow-worker и flower, потому что они работают только для исполнителя Celery. Мы также удалили службу кэширования redis, поскольку она работает как серверная часть для celery. Мы также не будем использовать средство запуска airflow, поэтому мы удаляем и его.
- Мы заменили базовый образ ${AIRFLOW_IMAGE_NAME:-apache/airflow:2.7.3} для остальных служб, в основном для планировщика и веб-сервера, пользовательским образом, который мы создадим при запуске docker-compose.
version: '3.8'
x-airflow-common:
  &airflow-common
  build:
    context: .
    dockerfile: ./airflow_resources/Dockerfile
  image: de-project/airflow:latest
Мы установили необходимые тома, которые нужны airflow. Параметр AIRFLOW_PROJ_DIR определяет каталог проекта airflow, который мы определим позже. Мы также настроили сеть как airflow-kafka, чтобы иметь возможность взаимодействовать с серверами kafka boostrap.
volumes:
  - ${AIRFLOW_PROJ_DIR:-.}/dags:/opt/airflow/dags
  - ${AIRFLOW_PROJ_DIR:-.}/logs:/opt/airflow/logs
  - ${AIRFLOW_PROJ_DIR:-.}/config:/opt/airflow/config
  - ./src:/opt/airflow/dags/src
  - ./data/last_processed.json:/opt/airflow/data/last_processed.json
user: "${AIRFLOW_UID:-50000}:0"
networks:
  - airflow-kafka
Далее нам нужно создать некоторые переменные окружения, которые будут использоваться docker-compose:
echo -e "AIRFLOW_UID=$(id -u)\nAIRFLOW_PROJ_DIR=\"./airflow_resources\"" > .env
Где AIRFLOW_UID представляет идентификатор пользователя в контейнерах Airflow, а AIRFLOW_PROJ_DIR - каталог проекта airflow.
Теперь все готово для запуска вашей службы airflow. Вы можете запустить ее с помощью этой команды:
docker compose -f docker-compose-airflow.yaml up
Затем, чтобы получить доступ к пользовательскому интерфейсу airflow, перейдите по этому адресу http://localhost:8080 .
По умолчанию в качестве имени пользователя и пароля используется airflow. После входа в систему вы увидите список DAG, которые поставляются с airflow. Найдите dag нашего проекта kafka_spark_dag и нажмите на него.
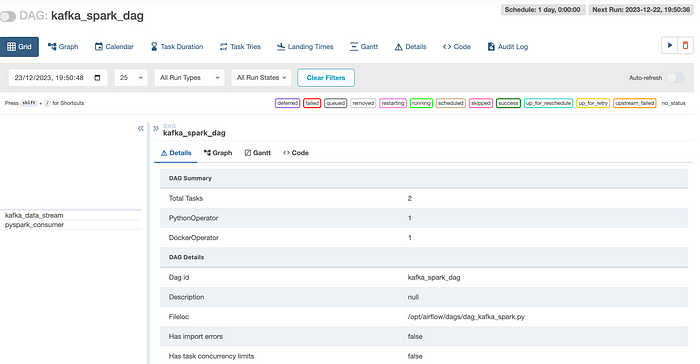
Вы можете запустить задачу, нажав на кнопку рядом с DAG: kafka_spark_dag.
Далее вы можете проверить статус ваших задач на вкладке График. Задача считается выполненной, когда она становится зеленой. Итак, когда все будет готово, она должна выглядеть примерно так:
Чтобы убедиться, что таблица rappel_conso_table заполнена данными, используйте следующий SQL-запрос в инструменте запроса pgAdmin:
SELECT count(*) FROM rappel_conso_table
Когда я запускал это в январе 2024 года, запрос вернул в общей сложности 10022 строки. Ваши результаты также должны быть примерно такими.
Вывод
В этой статье успешно продемонстрированы шаги по созданию базового, но функционального конвейера обработки данных с использованием Kafka, Airflow, Spark, PostgreSQL и Docker. Предназначенный в первую очередь для начинающих и тех, кто плохо знаком с разработкой данных, он обеспечивает практический подход к пониманию и внедрению ключевых концепций потоковой передачи, обработки и хранения данных.
В этом руководстве мы подробно рассмотрели каждый компонент конвейера, от настройки Kafka для потоковой передачи данных до использования Airflow для оркестровки задач, а также от обработки данных с помощью Spark до их хранения в PostgreSQL. Использование Docker в рамках всего проекта упрощает настройку и обеспечивает согласованность в различных средах.
Важно отметить, что, хотя эта настройка идеально подходит для обучения и небольших проектов, ее масштабирование для использования в производственной среде потребует дополнительных соображений, особенно с точки зрения безопасности и оптимизации производительности. Будущие усовершенствования могут включать в себя интеграцию более совершенных методов обработки данных, использование аналитики в режиме реального времени или даже расширение конвейера для включения более сложных источников данных.
По сути, этот проект служит практической отправной точкой для тех, кто хочет заняться разработкой данных. Это закладывает основу для понимания основ, обеспечивая прочную основу для дальнейших исследований в этой области.


