Текущий стек данных слишком сложен: 70% руководителей и практиков, занимающихся обработкой данных, согласны с этим
TLDR
- Дальновидные организации перестраивают команды, ориентируясь на бизнес-области, а не на технологические специализации. Распространение инструментов приводит к специализации, необходимой для их интеграции, что приводит к фрагментации знаний, что приводит к замедлению и усложнению процесса принятия решений. Он самоподкрепляется и становится все более укоренившимся, если не заниматься им напрямую. Компании, нацеленные на подготовку профессионалов Т-образного профиля (иначе говоря, универсалов), обладающих глубокими знаниями в области базовых платформ в сочетании с более широкими знаниями, развивают институциональные возможности решения проблем, с которыми не могут сравниться специализированные команды. Борьба с перегрузкой инструментов является ключевым шагом на пути к достижению этой цели.
- Может показаться интуитивным просто улучшить работу существующих инструментов и решений, но этот опрос выявил проблему, связанную с таким подходом. Многие респонденты рассказали о трудностях, с которыми они сталкиваются при использовании слишком большого количества инструментов, что приводит к созданию чрезмерно сложных решений. Это существенно ограничивает возможности использования ИИ. Старые решения не подходят для постоянно растущих объемов данных и быстрорастущей категории потребителей ИИ, требующей больших ожиданий.
- Руководители компаний теперь понимают, что преобразующий потенциал ИИ напрямую зависит от наличия хорошо реализованной стратегии обработки данных. Без всеобъемлющей стратегии обработки данных, поддерживаемой руководством, их амбиции "сделать что-то" с GenAI/General AI столкнутся с трудностями и с высокой вероятностью потерпят неудачу (Forbes приводит причины, по которым 85% проектов в области искусственного интеллекта терпят неудачу). Они должны использовать свое влияние, используя бюджеты и поддержку сверху вниз, для улучшения методов управления данными в своих компаниях в соответствии с потребностями ИИ.

Вступление
Недавно, в 2024 году, компания Modern Data Company провела опрос в сотрудничестве с сообществом MD101. Ответы поступили от более чем 230 человек из 48 стран, имеющих в среднем более чем 15-летний опыт работы в сфере обработки данных.
Одним из конкретных выводов, подтвердивших наши опасения, стало переполнение инструментами большинства наборов данных, используемых респондентами, и связанная с этим когнитивная перегрузка и финансовые последствия.
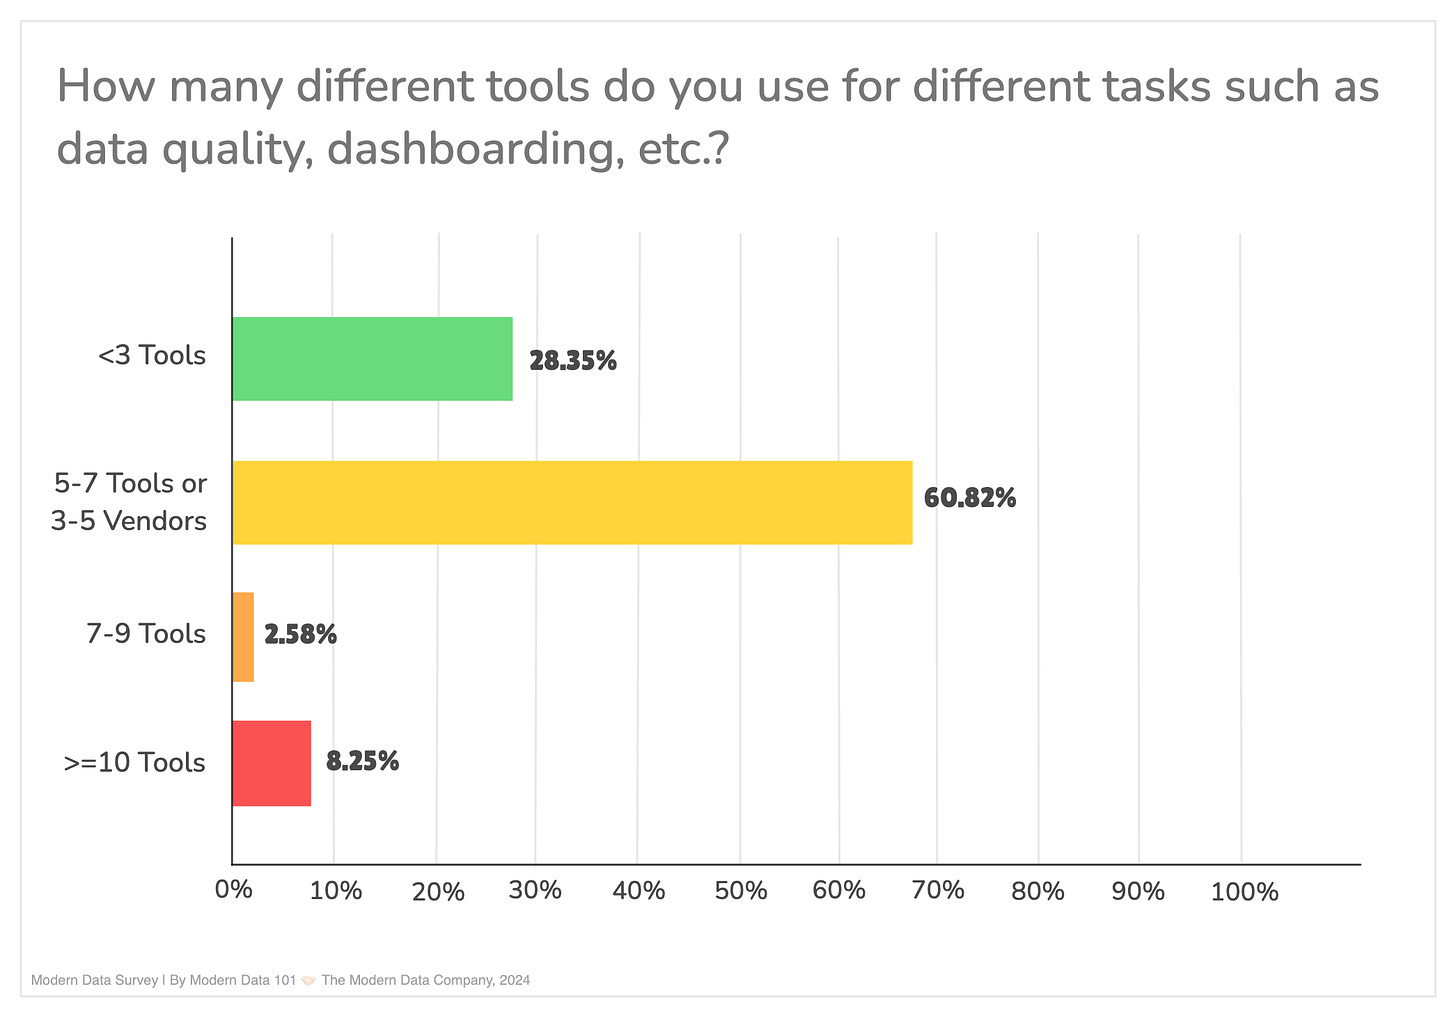
Более 70% респондентов вынуждены использовать более 5-7 различных инструментов или работать с 3-5 поставщиками для решения различных задач, таких как качество данных и создание информационных панелей. Около 10% используют более 10 инструментов, что свидетельствует о растущей сложности структуры данных.
Как мы пришли к этому: К Переполнению Стека Инструментов для управления данными и аналитики?
Это становится все более сложной задачей для неопытных конечных пользователей по мере того, как экосистемы данных постепенно превращаются в сложные и изолированные системы с непрерывным потоком точечных решений. Сложная инфраструктура, требующая постоянного обслуживания, отвлекает большинство талантливых инженеров от выполнения важных операций, таких как разработка приложений для обработки данных, которые непосредственно влияют на бизнес и в конечном итоге повышают рентабельность инвестиций в команды обработки данных. ~ datadeveloperplatform.org
Современный стек данных (MDS) принес много положительных результатов, одним из заметных результатов стал переход к облачным экосистемам, который снизил барьеры для доступа и сделал данные не только более доступными, но и восстанавливаемыми.
Но с появлением MDS вендоры и провайдеры были вынуждены решать небольшие проблемы, связанные с общей картиной, что действительно было насущной потребностью. Распространение инструментов, особенно со стороны вендоров, было вызвано некоторыми (среди многих) из этих факторов:
- Предпочтение специализации перед обобщением: Специализированные инструменты решали проблемы с узкоспециализированными данными и создавали изолированные системы.
- Снижение барьеров для входа: облачные технологии и SaaS снизили затраты и ускорили внедрение инструментов.
- Различные партнерские отношения между поставщиками и лидерами в разных областях: смена руководства с различными предпочтениями в отношении инструментов и независимые командные решения привели к несогласованности в наборе инструментов.
- Отсутствие комплексной стратегии обработки данных в организации: приоритет отдавался немедленным исправлениям. Инструменты были внедрены для решения сиюминутных проблем без учета долгосрочной масштабируемости или интеграции.
Результат интеграции инструментов обработки данных
Хотя целью изолированных инструментов было создание модульной сети решений, которые пользователи могли бы использовать для решения более масштабных задач, современный стек данных вскоре стал палкой о двух концах. Это привело к возникновению лабиринта интеграционных процессов, понятного лишь нескольким выдающимся инженерам, проработавшим в организации годы, что подразумевает как техническую, так и культурную централизацию ключевых ресурсов данных и решений.
- Завышенные ожидания
- Раздутое количество инструментов
- Перегрузка
- Подрыв доверия
- Команда данных превращается в операционную функцию
- Рентабельность работы команды данных
- Скрытые издержки
- Огромная потеря времени
Подумайте о том, сколько времени тратят команды, чтобы просто оставаться на плаву в условиях фрагментированного инструментария. Каждый новый инструмент требует внедрения, обучения и адаптации к его уникальному дизайну и рабочим процессам. Пользователи должны научиться не только пользоваться инструментом, но и тому, как он вписывается (или, зачастую, не вписывается) в их существующие процессы.
Переключение между инструментами приводит к еще одному уровню неэффективности, поскольку пользователи часто теряют контекст при переходе от одного интерфейса к другому. Это постоянное переключение не только замедляет работу, но и увеличивает вероятность ошибок.
Проблемы с интеграцией еще больше усугубляют проблему. Команды тратят часы на устранение ошибок в интеграции и исправление связей между инструментами, которые никогда не были предназначены для совместной работы. Даже после решения этих проблем постоянное техническое обслуживание становится необходимым условием для обеспечения работоспособности интеграции в повседневной работе.
Кроме того, проверка точности и согласованности результатов является трудоемкой задачей. Команды вынуждены выполнять детальное отслеживание происхождения, вручную просматривая данные в нескольких системах, чтобы подтвердить их достоверность. Этот процесс не только отнимает много времени, но и подвержен недосмотру, что приводит к повторяющемуся циклу разочарований и неэффективности. Результат? Ценное время и ресурсы тратятся на выполнение накладных задач, вместо того чтобы сосредоточиться на анализе и действиях, которые повышают ценность.
Высокие скрытые издержки: Накладные расходы на интеграцию
Лицензирование, обучение и поддержка множества инструментов значительно увеличивают затраты.
Операционные расходы
- Затраты на выделенные команды разработчиков платформы для поддержания инфраструктуры в рабочем состоянии
- Затраты на непрерывное обслуживание интеграций и, как следствие, на заполнение конвейеров
- Затраты на устранение сложных зависимостей при частой передаче проекта
Затраты на инфраструктуру и миграцию
- Затраты на перенос огромных ресурсов данных
- Затраты на настройку инфраструктуры проектирования данных для реализации точечных решений
- Затраты на хранение, перемещение и вычисления 100% данных в data swamp
Затраты на лицензирование и инструментарий
- Стоимость отдельных лицензий для точечных решений, необходимых для обеспечения работы облака
- Стоимость общих или избыточных показателей для точечных решений (дублирование)
- Затраты на интеграцию и экосистему
Затраты на непрерывную интеграцию всякий раз, когда новый инструмент присоединяется к экосистеме
- Затраты на изолированное управление для каждой точки доступа или точки интеграции
- Затраты на когнитивные функции и риски
- Затраты на когнитивную нагрузку и нишевую экспертизу для понимания различных принципов работы каждого инструмента
- Затраты на частые риски для данных из-за множественности точек доступа
Как вы можете догадаться, этот список далеко не исчерпывающий.
Рентабельность инвестиций - это распространение инструментов с меньшей отдачей от инвестиций
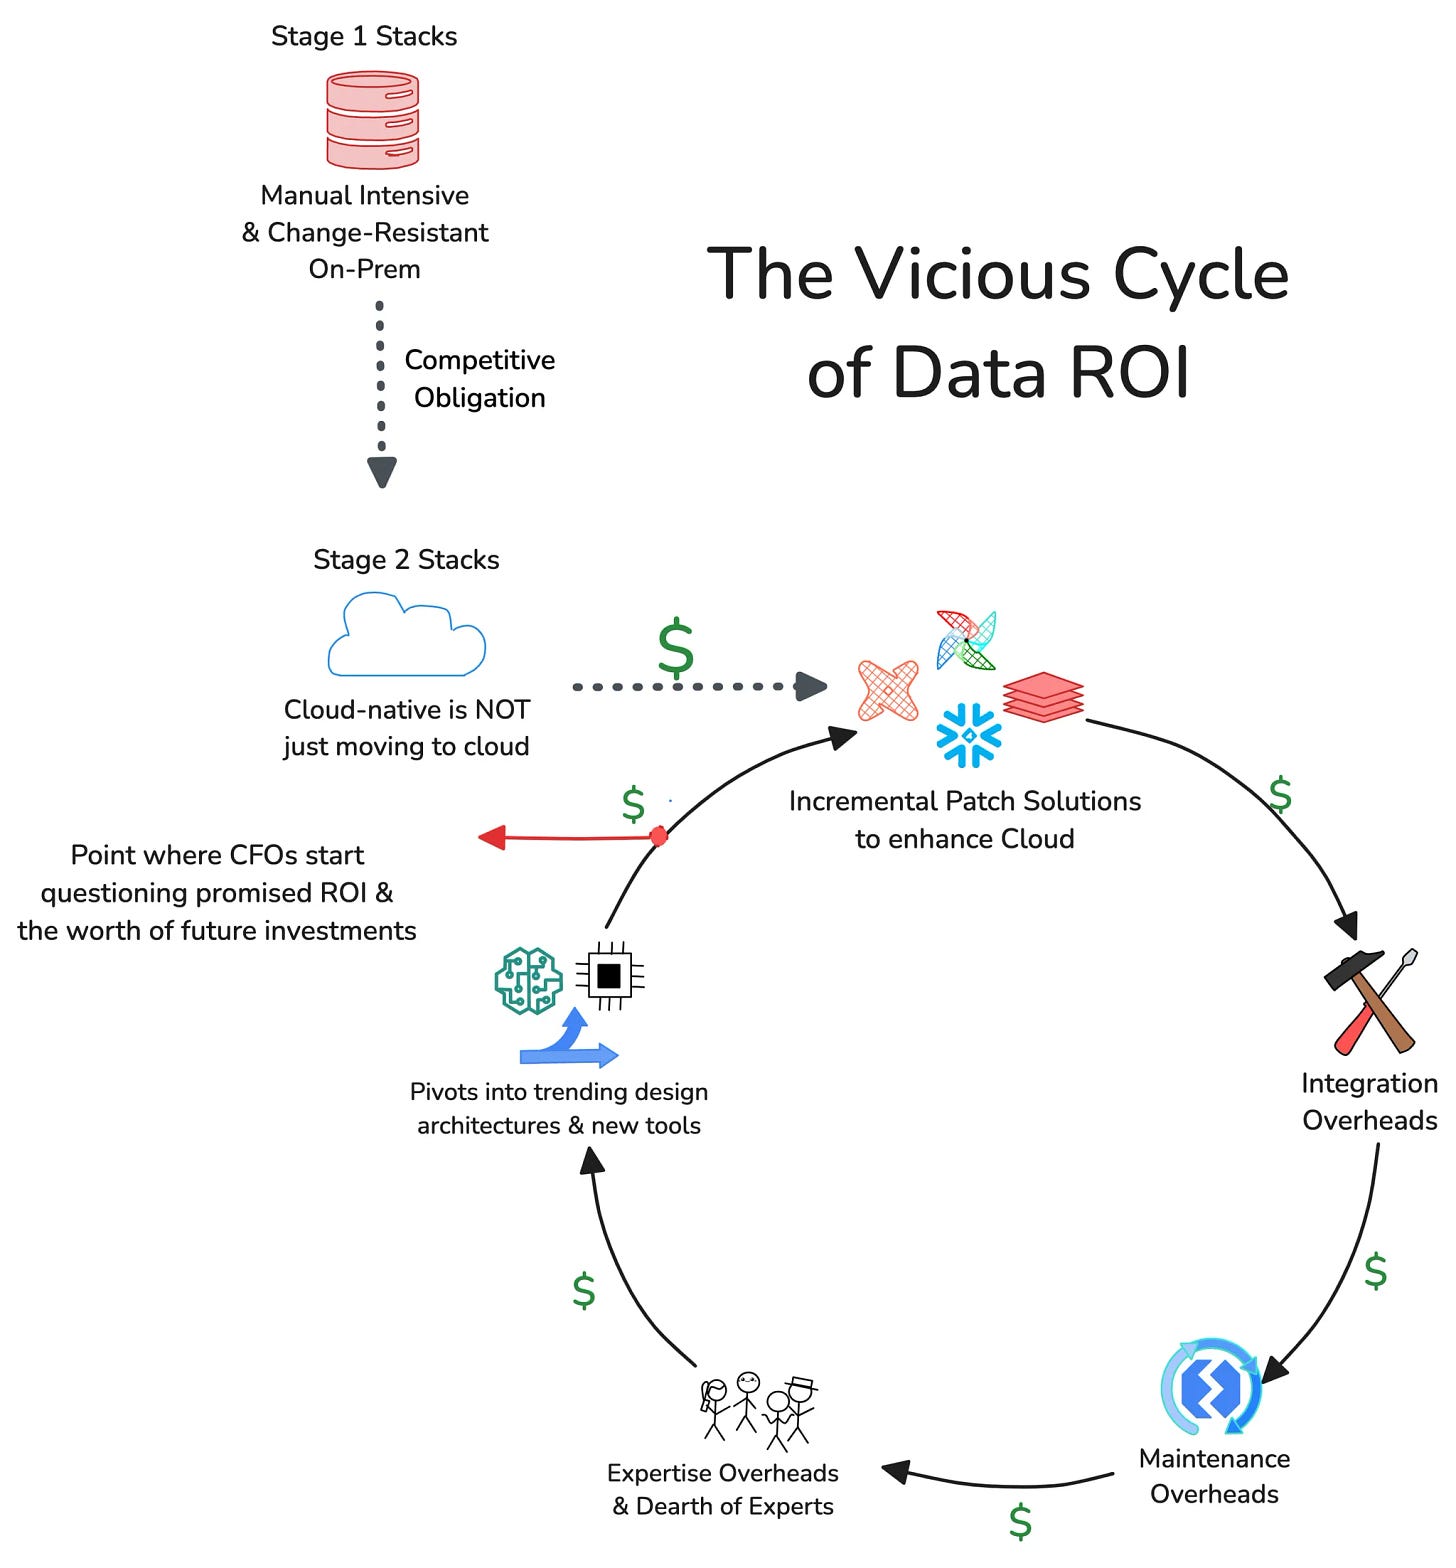
Для принятия решений требуется время. Каждый инструмент требует терпения и вложения не только ресурсов, но, что более важно, времени. Чтобы решения вступили в силу, требуется время. Каждый инструмент требует вложения ресурсов, терпения и, самое главное, времени.
Но, учитывая фундаментальный недостаток разработки - “добавление еще одного инструмента”, за этим следуют накладные расходы на обслуживание, интеграцию, лицензирование и альтернативные издержки, связанные с затратами времени.
В конечном счете, конечная цель - повышение эффективности бизнеса - отодвигается на второй план, когда поддержка и интеграция предшествуют разработке основных данных. Для устранения пробелов в уравнении добавляются дополнительные инструменты интеграции данных, и цикл продолжается.
Ловушка рентабельности инвестиций в инструменты обработки данных | Впервые опубликовано на KDnuggets
И представьте себе — с каждой итерацией новых нишевых инструментов, помимо затрат на лицензирование каждого инструмента, возникают дополнительные скрытые (огромные) затраты на покупку дополнительных функций в приложении. Но гораздо более проблематичным является увеличение затрат на техническое обслуживание каждого инструмента.
Стоимость владения инструментом значительно возрастает, когда помимо лицензирования и сервисного обслуживания дополнительные 15-18% составляют расходы на техническое обслуживание. Если вы тратите $2 млн на контракт, а затем тратите $300 тыс. на дополнительные расходы на обслуживание, это оказывает огромное негативное влияние на рентабельность инвестиций.
Около 40% опрошенных считают, что поддержание интеграции между различными инструментами обработки данных приводит к самым высоким затратам. ~Modern Data Survey (Совместная инициатива Modern Data 101 и The Modern Data Company)
Команда обработки данных становится операционным подразделением: Основное - обслуживание, вторичное - получение ценности из данных.
При наличии большого количества инструментов, как показывает MAD Landscape или MDS, организациям становится все труднее сосредоточиться на разработке решений, которые действительно приносят бизнес-результаты, из-за постоянного внимания к заявкам на техническое обслуживание. Инженеры по обработке данных и аналитике придерживаются культуры, согласно которой сначала требуется обслуживание, затем интеграция, а данные - в последнюю очередь. Это требует бесчисленных часов, затрачиваемых на устранение недостатков инфраструктуры и поддержание в рабочем состоянии конвейеров передачи данных. Не менее сложной задачей является создание инфраструктуры, необходимой для размещения и интеграции нескольких инструментов.
Надежность: Экспоненциальный рост объема данных усложняет доверие и удобство использования
Я думаю, что многие команды, занимающиеся обработкой данных, сталкиваются с проблемой создания показателей в рамках своего бизнес-инструмента, например, HubSpot, или, возможно, другого инструмента для роста или маркетинга, такого как Google Analytics. И тогда у вас есть три разных ответа на один и тот же вопрос.
Заинтересованные стороны просто теряют доверие к данным, потому что они не понимают, почему на один и тот же вопрос есть три разных ответа. Они не знают, на что полагаться.
~ Мэдисон Шотт, старший инженер Convertkit
При передаче данных (читай: дублировании) между несколькими инструментами в разных доменах (предпочтительные собственные стеки) происходит неконтролируемое повреждение, и по мере дальнейшего распространения инструментов становится все труднее отследить происхождение и первопричину. Чаще всего, чтобы облегчить себе жизнь, бизнес-пользователи предпочитают просто дублировать данные, вместо того чтобы тратить часы или недели на ожидание исправления или обновления интеграционного моста. Это связано с недостаточной осведомленностью о последствиях дублирования или искажения данных, а также с разочарованием из-за временных задержек и неэффективного предоставления данных для бизнес-приложений.
А без надлежащих интеграционных мостов не существует стабильной модели, на которую могли бы положиться разработчики данных и бизнес-пользователи. Вместо этого, унаследованная модель, в лучшем случае, с непонятными ответвлениями, расширялась каждый раз, когда поступало новое требование, что облегчало немедленную необходимость в разработке нового инструментария или ответе на новый бизнес-запрос.
Перегруженность: Принудительное подчинение различным этапам обучения различным инструментам
Каждый инструмент имеет свой собственный язык проектирования, основанный на его собственной философии проектирования и подходе. Это подразумевает различные языки, форматы, фреймворки или жизненные циклы. Что значительно усложняет взаимодействие и делает его более избирательным, а также требует интенсивного изучения для обеспечения согласованности работы.
Ожидается, что конечные пользователи, которые ожидают полезности от инструментов, или инженеры по обработке данных, ответственные за взаимодействие инструментов, изучат подходы к проектированию каждого из них. Которые часто не просты. Даже если бы это было так, необходимость изучить обходные пути для 5-7 инструментов и интегрировать их удобным для пользователя способом нарушает все законы простоты и увеличивает когнитивную нагрузку.
- Проблемы совместимости заставляют компании внедрять больше инструментов для устранения пробелов.
- Сложность эксплуатации из-за управленческих издержек, связанных с интеграцией, обслуживанием и оптимизацией этих инструментов, растет в геометрической прогрессии.
- Проблемы с прозрачностью из-за большого количества инструментов часто приводят к фрагментации данных, что усложняет управление и принятие решений.
Инфляция инструментов: Фрагментированный ландшафт поставщиков и постепенное дублирование собранных систем
Кроме того, существовал социально-политический фактор, связанный с конкуренцией между поставщиками, который привел к появлению схожих функций у разных поставщиков, претендующих на то, чтобы одна из них превосходила другую. Кроме того, по мере появления новых инструментов у них все чаще возникала потребность в независимой работе, часто основанной на отзывах пользователей.
POV: Техническая неизбежность фрагментированного стека
Например, к вашим стекам данных подключены два разных точечных инструмента, скажем, один для каталогизации, а другой для управления. Это порождает необходимость не просто изучать различные концепции инструментов, интегрировать и поддерживать каждый из них с нуля, но и в конечном итоге создавать полностью параллельные треки. Инструменту управления начинает требоваться собственный каталог, а инструменту каталогизации требуются политики, управляемые в рамках его системы.
POV: Это неизбежность бизнес-стратегии нишевых поставщиков решений
Поставщики начали перекрывать друг друга по функционалу, конкурируя за долю рынка, что усложняло организациям консолидацию своих пакетов. Например, поставщик, который начинал с предложений по хранению данных, начал предлагать варианты каталогизации, повышения качества данных, преобразования и т.д.
Теперь рассмотрим ту же проблему в масштабе, не ограничиваясь двумя решениями. Даже если мы рассматриваем стоимость этих параллельных дорожек как второстепенную, по сути, это существенный конструктивный недостаток, который приводит к разделению топологии одной уникальной возможности на неуправляемые дубликаты.
Более того, многие возможности нишевых инструментов остались неиспользованными из-за дублирования или просто из-за отсутствия требований (слишком нишевые для 80% случаев использования). К сожалению, это также означало, что пользователи должны были продолжать платить, скажем, за 100 функций инструмента, в то время как они использовали только 5 из них.
Завышенные требования: Постоянное и растущее стремление к децентрализации!
Когда системы объединяются по частям без единой стратегии, управление их многочисленными движущимися частями становится непосильной задачей. Эта сложность возрастает, затрудняя конечным пользователям доступ к необходимым им данным.
Таким командам, как отдел маркетинга, продаж и технической поддержки, часто приходится преодолевать трудности, чтобы получить хотя бы базовую информацию. В то же время отдел обработки данных перегружен запросами, из-за чего организации приходится преодолевать узкие места и распределять нагрузку между доменами.
Именно здесь зарождающееся движение Data Mesh привлекло внимание к вопросам владения доменами — сдвигу в сторону децентрализации. Идея привлекательна: позволить отдельным командам управлять своими собственными данными. Но насколько практичен такой подход в реальном мире? При применении к функционирующему бизнесу начинают возникать несколько ключевых проблем:
Недостаточно квалифицированных специалистов для работы в каждой отдельной области. На практике, насколько экономически оправдана идея создания групп обработки данных и изолированных стеков данных для каждой области?
- Недостаточно специалистов или бюджета, чтобы нарушить существующие процессы, распутать конвейеры и внедрить совершенно новую инфраструктуру.
- Не хватает специалистов, которые могли бы помочь в обучении и адаптации в процессе культурной миграции.
Это проблема как нехватки навыков, так и ресурсов. Более того, из-за десятилетий, потраченных на разработку стеков данных, которые не приносят особой пользы, организации в идеале не склонны вкладывать больше инвестиций и усилий для сокращения и замены своей работы. По сути, автономия имеет более высокий приоритет, чем децентрализация, если конечная цель - независимость домена.
Решение проблемы перегруженности инструментов: Исправьте подход к модульности, вместо того чтобы добавлять еще один инструмент.
Целью разрозненных инструментов, нацеленных на конкретные проблемы, было создание модульной сети решений, которую пользователи могли бы использовать для решения более масштабных задач…
В чем недостаток этого подхода?
Модульность заключается в том, что простейшие решения доступны в виде независимых строительных блоков, которые могут быть объединены в желаемую комбинацию для создания более крупных решений. Как и при модульном подходе к программированию, простейшие функции могут использоваться повторно в рамках проекта в виде классов или даже в других проектах в виде библиотек.
Инструменты, нацеленные на решение конкретных проблем, не являются простейшим набором решений, а сами по себе являются крупными решениями, непосредственно ориентированными на большие части проблемы, например, качество данных или ETL.
Каждый компонент этого и без того крупного решения (инструмента) не знает, как напрямую взаимодействовать с другими крупными решениями (базовые компоненты одного инструмента не могут быть повторно использованы в других приложениях или решениях). Вместо этого весь инструмент должен использоваться посредством комплексной интеграции со всеми его очень специфическими особенностями дизайна и рабочего процесса.
Правильный подход: Модульная обработка стека данных без сбоев
У этого решения есть два ключа:
- Без сбоев: Как мы можем сократить потери от перегрузки инструментария, не создавая дополнительных проблем для команды обработки данных или команды домена? Другими словами, как мы можем улучшить работу с существующими нативными стеками?
- Модульность: как обеспечить возможность междоменного повторного использования и сократить накладные расходы на интеграцию. Другими словами, как нам унифицировать подход к работе и инструментам?
Интересно, что модульность, которая означает разделение большой задачи на минимальные формы независимых решений, позволяет унифицировать стек данных. Обратите внимание, что “разделение” и “унификация” используются в одном предложении. С другой стороны, крупные решения (нишевые инструменты) создают больше изолированных ресурсов, удерживая данные и базовые компоненты в более жестких рамках.
В результате тщательного анализа многих реализаций мы обнаружили, что модульность, подобная lego, обеспечиваемая унифицированными платформами данных, такими как Data Developer Platform standard, приводит к:
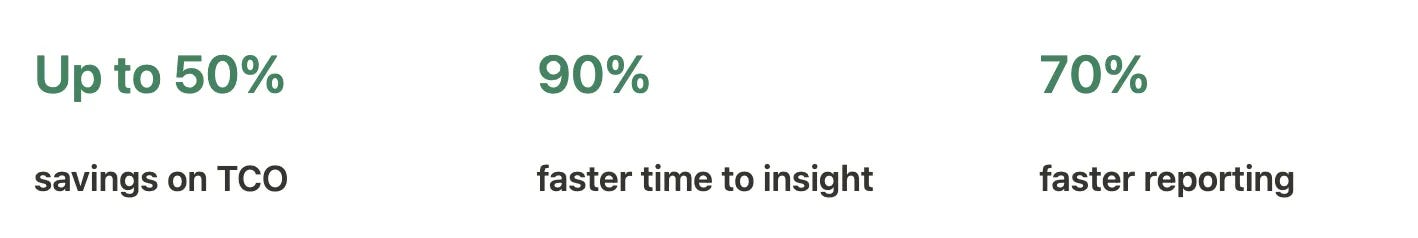
Это сильно отличается от традиционных стеков данных, которые представляют собой набор инструментов, вынужденных взаимодействовать друг с другом посредством сложных и требующих много времени интеграций. В результате мы получаем следующий опыт специалистов по обработке данных в отрасли:
- 70% респондентов вынуждены использовать более 5-7 различных инструментов или работать с 3-5 поставщиками для решения различных задач, таких как качество данных и создание информационных панелей.
- Около 10% используют более 10 инструментов, что свидетельствует о растущей сложности структуры данных.
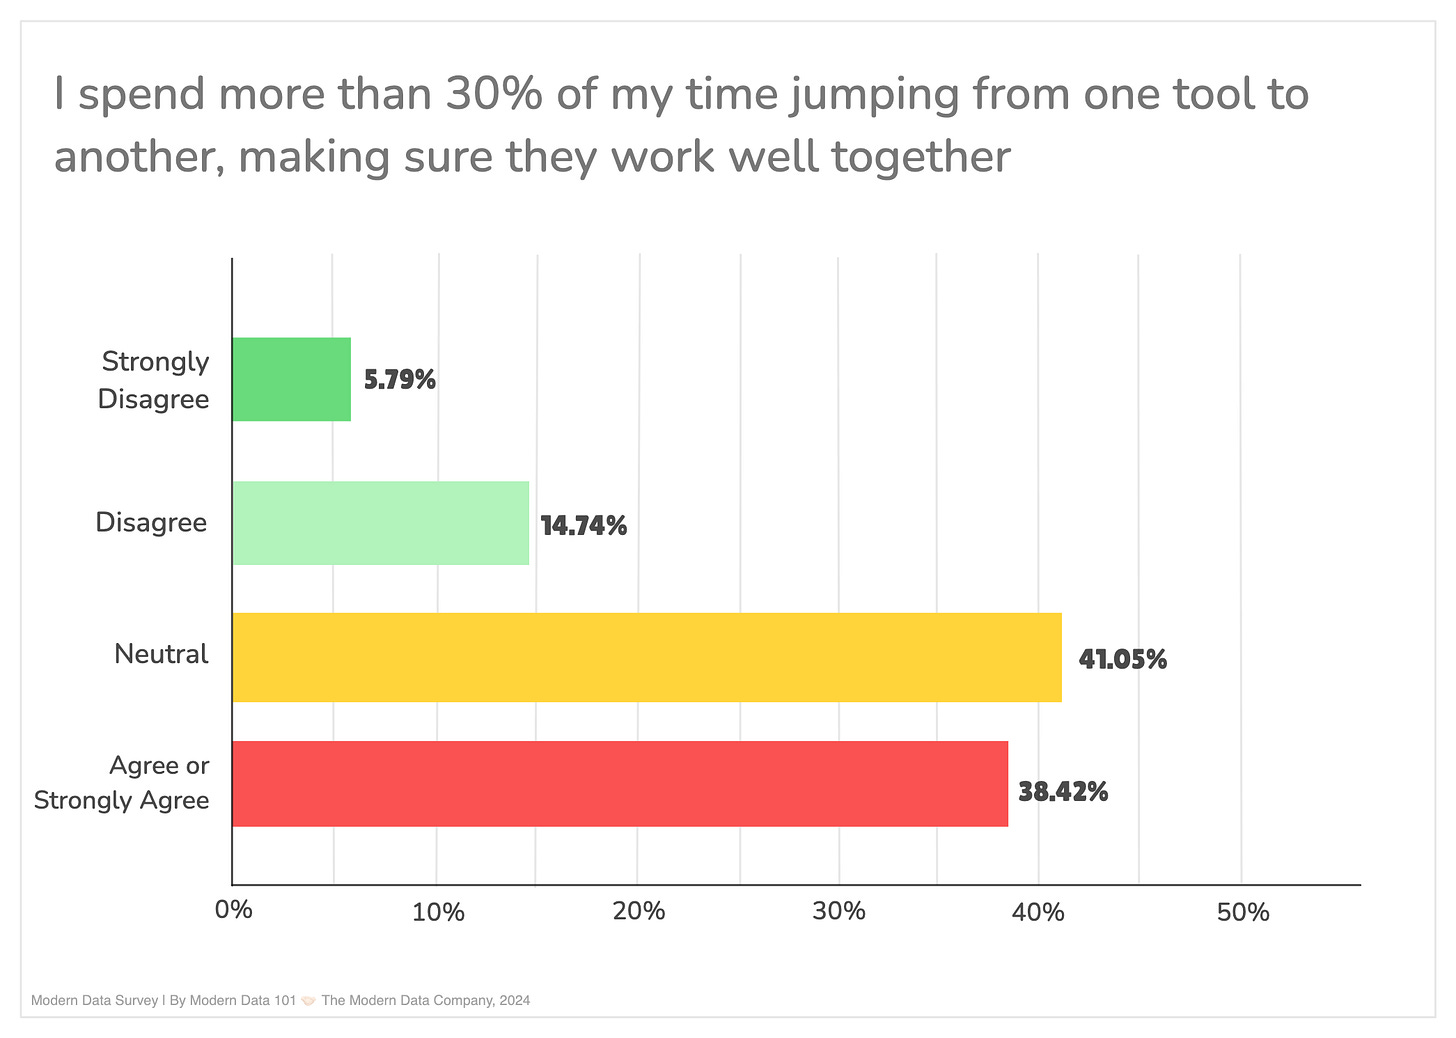
- Около 40% респондентов тратят более 30% своего времени на переключение с одного инструмента на другой, чтобы убедиться, что они хорошо работают вместе.
Создание служебной плоскости для упрощения модульной архитектуры
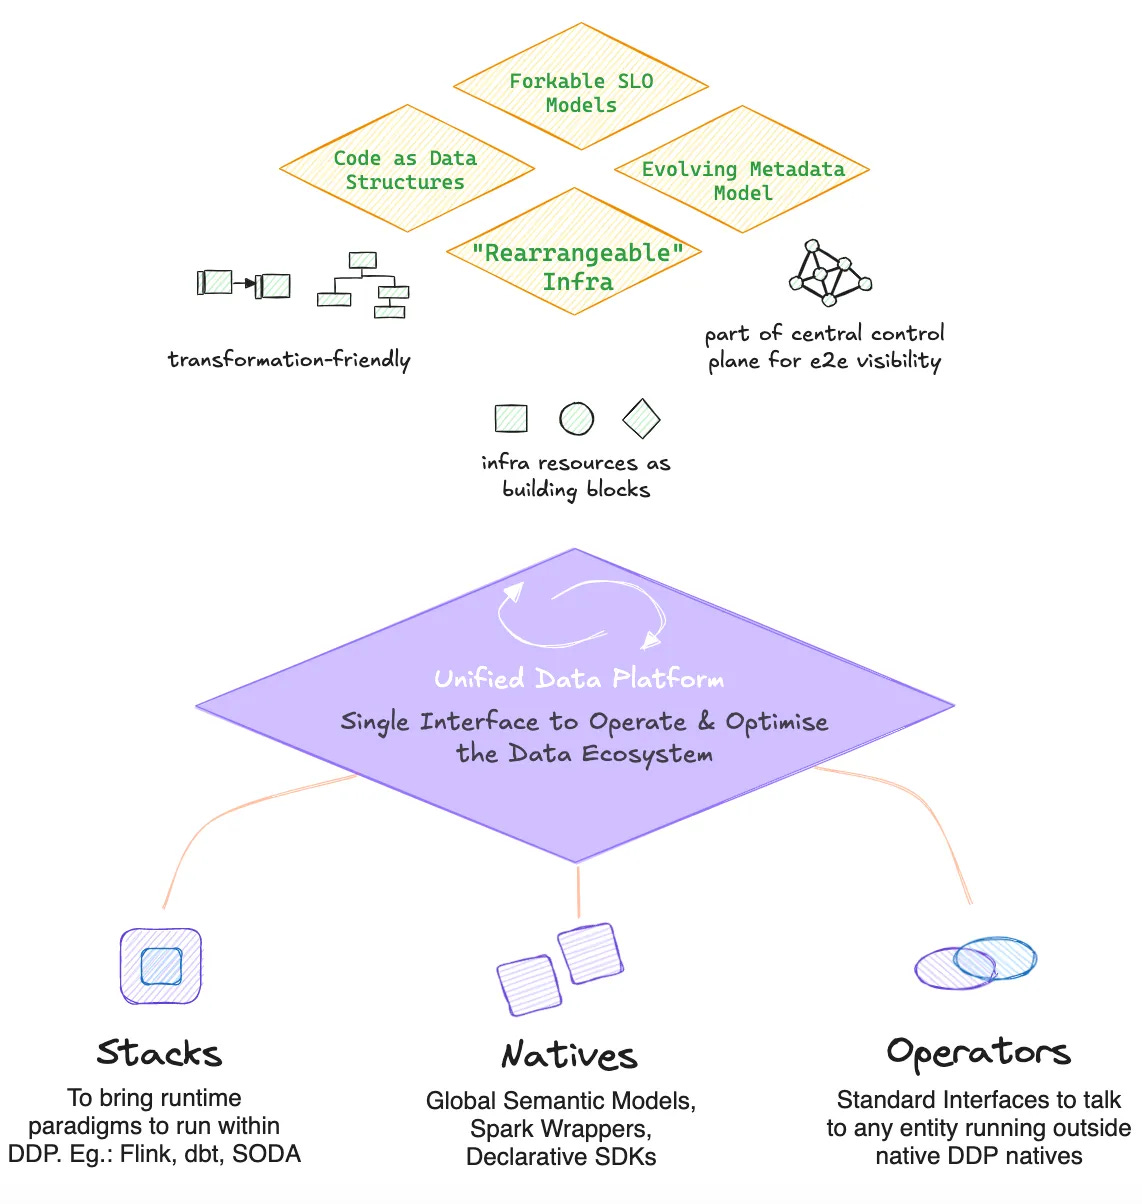
Служебная плоскость выступает в качестве основы для обеспечения модульности, предоставляя набор основных утилит и сервисов, которые являются легкими, пригодными для повторного использования и совместимыми со всем стеком данных.
В отличие от традиционных инструментов, предназначенных для конкретных ниш, utility plane фокусируется на предоставлении атомарных, стандартных возможностей, которые могут быть составлены и организованы для решения различных задач.
Основные принципы Utility Plane
Атомарность и детализация
Utility plane предлагает минимально возможные функциональные возможности — рассматривайте их как “функции” при разработке программного обеспечения. Примерами могут служить правила проверки данных, функции преобразования или механизмы поиска метаданных. Они предназначены для решения микропроблем и при необходимости могут быть объединены в более крупные рабочие процессы.
Совместимость
Все компоненты в рамках utility plane спроектированы таким образом, чтобы беспрепятственно взаимодействовать с помощью стандартизированных протоколов или API, избегая жестких границ, часто устанавливаемых монолитными инструментами. Это позволяет инструментам и командам работать сообща, не требуя значительных усилий по индивидуальной интеграции.
Нейтральный уровень
Он служит нейтральной основой, лежащей в основе решений, относящихся к конкретной предметной области, и позволяет командам создавать свою пользовательскую логику или рабочие процессы без привязки к поставщику или инструментам.
Постепенное внедрение
Уровень полезности не разрушает существующие системы, а, скорее, улучшает их. Команды могут постепенно внедрять отдельные утилиты, исходя из своих насущных потребностей, без необходимости замены или пересмотра существующих инструментов или рабочих процессов.
Преимущества единой системы управления утилитами
- Гибкость: Команды могут использовать только те утилиты, которые им нужны, что сокращает накладные расходы и сложность.
- Возможность повторного использования: Утилиты, разработанные один раз, могут быть повторно использованы в разных командах, доменах или даже организациях.
- Сокращение дублирования инструментов: благодаря использованию модульных возможностей уменьшается потребность в специализированных инструментах, которые решают дублирующие друг друга задачи.
- Масштабируемость: Уровень полезности масштабируется как по горизонтали (за счет добавления дополнительных утилит), так и по вертикали (за счет создания сложных решений из простых строительных блоков).
Расширяя тему “Уменьшение перегрузки и перекрытия оснастки”
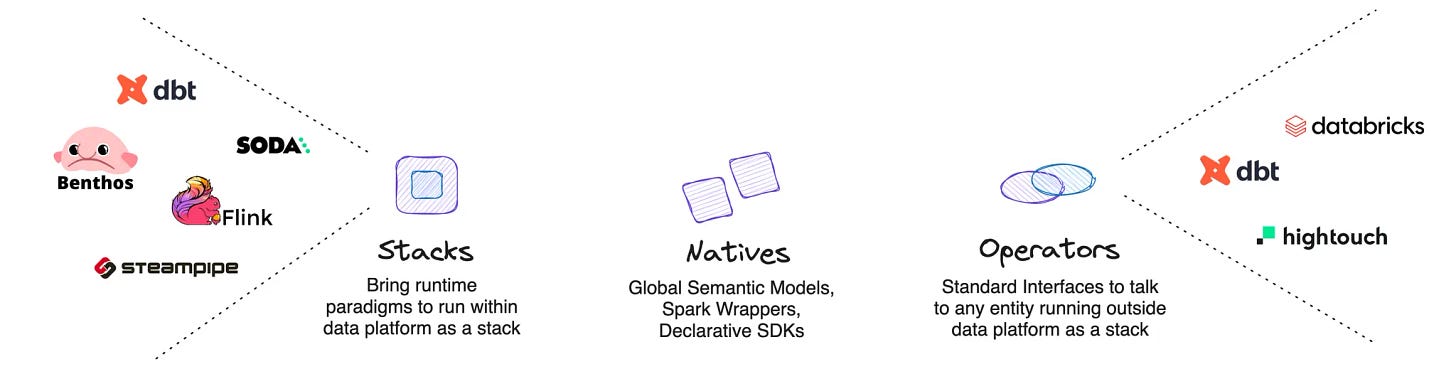
Создавая модульную и унифицированную архитектуру Utility Plane, мы сокращаем количество отделений, ориентированных на инструменты. Это особенно важно благодаря трем парадигмам проектирования Utility Plane:
Собственные ресурсы как строительные блоки
Ресурсы, такие как хранилище, вычислительные ресурсы, рабочие процессы, службы, политики, кластеры и модели, доступны в виде модульных решений, которые разработчики могут создавать и повторно использовать в различных решениях и продуктах данных.
Внешние ресурсы - это строительные блоки: операторы
Операторы работают как модульные интерфейсы, взаимодействующие со средствами, работающими за пределами единой платформы. Оператор регистрирует ресурсы, которые не являются встроенными в платформу, и позволяет (внешнему или встроенному) организатору управления идентифицировать и управлять этими ресурсами. Ресурсы оператора делают платформу по-настоящему расширяемой и настраиваемой.
Внешние ресурсы - это строительные блоки: стеки
Utility plane обеспечивает модульность существующих стеков инструментов, таких как dbt, Flink или SODA. Это позволяет интегрировать различные парадигмы среды выполнения, такие как dbt, Flink и SODA, в экосистему, не требуя их перезаписи.
Как это помогает? Разовая разработка интеграции и непрерывное управление здоровьем делегированы платформе на декларативной основе. Более того, эти зарубежные парадигмы инкапсулированы таким образом, чтобы соответствовать единым стандартам платформы, позволяя пользователям получать доступ к различным стекам и управлять ими через общий интерфейс и шаблон (сокращая когнитивную перегрузку и кривые обучения, которые возникают при использовании различных инструментов).
Со временем наличие общего операционного интерфейса помогает организации выработать более унифицированную стратегию обработки данных, позволяющую объединить не только набор инструментов, но и подход к работе в целом. Возможность четкого объединения “строительных блоков” для конкретных решений в рамках доменов дает организациям возможность распределять затраты по доменам, а также понимать влияние различных существующих инструментов на общую эффективность затрат времени.
Например, универсальная способность унифицированных платформ управлять жизненными циклами информационных продуктов и оптимизировать ценность и производительность информационных продуктов за счет:
- Мониторинг использования и внедрения различных информационных продуктов.
- Отслеживание производительности и затрат для каждого продукта обработки данных (включая затраты на инструменты и ресурсы)
- Измерение отдачи от бизнеса и рентабельности инвестиций.
Внедрение единого уровня полезности с помощью платформ для разработчиков данных
Платформы данных, созданные по образцу стандарта Data Developer Platform (DDP), служат надежным уровнем полезности, легко интегрируемым в существующую инфраструктуру данных. Выступая в качестве важнейшего вспомогательного средства, этот уровень утилит обеспечивает модульность и соответствие конкретным бизнес-целям, сохраняя при этом целостность текущих операций. Архитектура обеспечивает единый подход к управлению рабочими процессами обработки данных в рамках сквозного стека продуктов обработки данных.
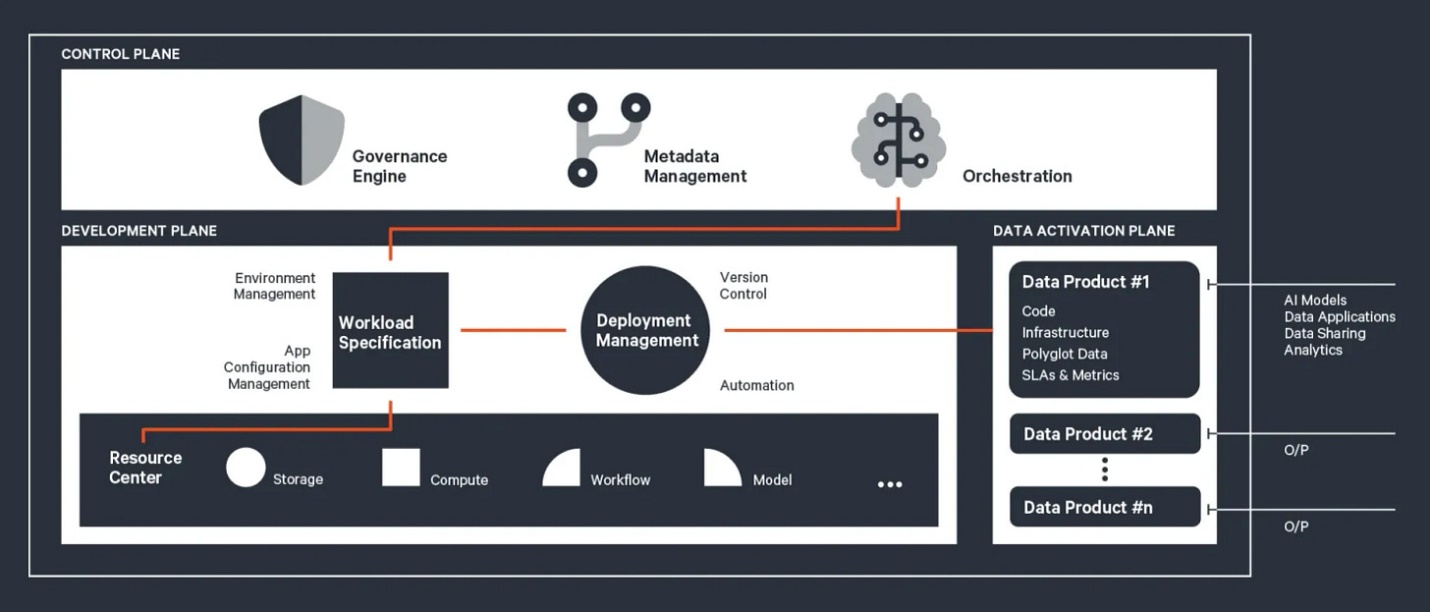
Центральная панель управления: объединение видимости, доступа и управления
Когда какой-либо инструмент или стек подключается к платформе, центральная панель управления получает полную видимость и закрепляет систему, обеспечивая сквозной доступ к другим интегрированным инструментам и стандартизацию с помощью трех основных движков:
Унифицированная оркестровка: автоматизирует рабочие процессы, обеспечивая бесперебойное выполнение задач на всех конвейерах.
- Унифицированные метаданные: устанавливают четкую структуру, контекст и уровень обнаружения для ресурсов данных, повышая эффективность и соответствие требованиям.
- Унифицированное управление: Многоразовые модульные модели политик, которые могут быть применены к различным вариантам использования или продуктам данных в зависимости от стандартных требований к предметной области полностью или частично.
- Эта модель основана на принципах гибридной децентрализации, которая направлена на обеспечение управляемой предметной областью децентрализации в разумных пределах. Вы можете узнать больше о нашем подходе к гибридной децентрализации здесь и здесь.
План разработки: Модульный дизайн с использованием стандартных блоков
Платформа разработки предназначена для модульного использования кода, рабочих процессов и ресурсов, представляя их в виде многоразовых строительных блоков. Эти строительные блоки могут быть адаптированы к конкретным вариантам использования, что позволяет создавать компонуемую архитектуру. Именно здесь разработчики данных могут использовать три парадигмы проектирования (собственные ресурсы, стеки и операторы) для создания модульных решений для продуктов данных, конкретных бизнес-запросов, глобальных моделей показателей и многого другого.
Поддержка целевых вариантов использования: подход справа налево
В дизайне платформы подчеркивается последовательность действий справа налево, начиная с бизнес-результата и прослеживая его в обратном направлении для определения технического исполнения. Например:
- Согласуйте конкретные продукты обработки данных, инфраструктуру и процессы для решения этой задачи.
- Определите бизнес-проблему или вариант использования, например, для улучшения сегментации клиентов или повышения операционной эффективности.
- Используйте модульные ресурсы и конфигурации на этапе разработки для быстрого развертывания решений.
Эта методология обратной инженерии гарантирует, что все технические усилия будут направлены на достижение ощутимого эффекта для бизнеса.
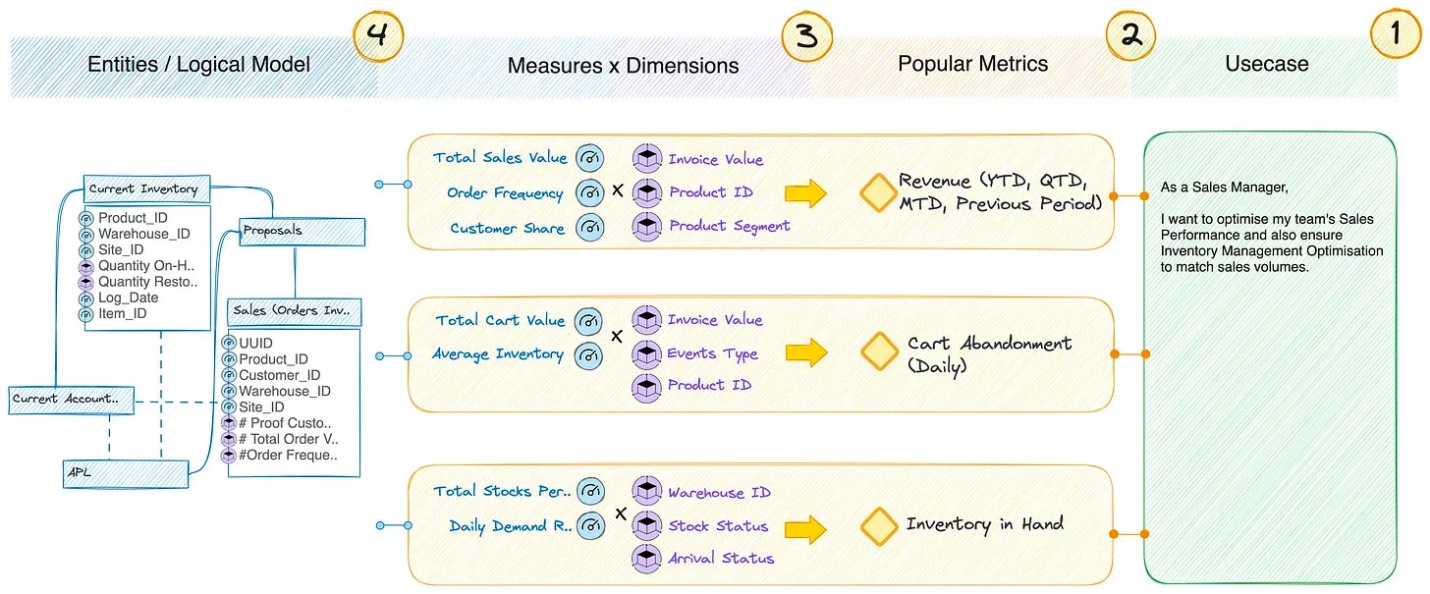
Семантические модели: обеспечение функциональной совместимости и возможности повторного использования
Семантические модели играют ключевую роль в преодолении разрыва между техническими уровнями и бизнес-результатами. Выступая в качестве общего словаря для заинтересованных сторон, эти модели:
- Обеспечивают взаимодействие между продуктами данных за счет стандартизации структуры информации и доступа к ней.
- Расширяют возможности повторного использования, позволяя применять ресурсы данных и рабочие процессы в различных контекстах без дублирования.
- Упрощает совместную работу, обеспечивая ясность как для технических групп, так и для бизнес-пользователей.
Интегрируя семантические модели в архитектуру, DDP преобразует необработанные данные в полезную информацию, обеспечивая соответствие бизнес-задачам.