

Как мы создали внутреннее хранилище данных в ClickHouse
Мы в ClickHouse видим свою миссию в том, чтобы предоставить нашим заказчикам и пользователям невероятно быструю облачную аналитическую базу данных, которую можно использовать для внутренней аналитики и анализа работы с клиентами. ClickHouse Cloud позволяет нашим клиентам хранить и обрабатывать практически неограниченные объемы данных, что помогает им принимать решения, основанные на данных. Принятие решений, основанных на фактах, а не на предположениях, имеет решающее значение для большинства успешных компаний сегодня.
Конечно, мы придерживаемся такого же подхода в нашей команде. Разработка и эксплуатация нашей облачной базы данных позволяет генерировать огромный объем данных, которые могут быть использованы для планирования производственных мощностей, ценообразования, лучшего понимания потребностей наших клиентов и составления финансовой отчетности. Десятки источников данных, сотни терабайт и около сотни пользователей для бизнес-анализа и ad-hoc… И знаете что - мы используем ClickHouse Cloud для решения этой задачи :)
В этом посте я расскажу о том, как построено наше внутреннее хранилище данных (DWH), какой стек мы используем и как будет развиваться наше хранилище данных в ближайшие несколько месяцев.
Требования и источники данных
Мы запустили ClickHouse Cloud в режиме приватного просмотра в мае 2022 года, и в то же время мы поняли, что хотим лучше понять наших клиентов: как они используют наш сервис, с какими трудностями они сталкиваются, как мы можем им помочь и как мы можем сделать наши цены доступными и обоснованными для них. Для этого нам нужно было собрать и обработать данные из нескольких внутренних источников: Data Plane, который отвечает за запуск клиентских модулей баз данных, Control Plane, который отвечает за пользовательский интерфейс и операции с базами данных, ориентированные на клиента, и AWS Billing, который дает нам точные данные о затратах на выполнение рабочих нагрузок клиентов.
В течение короткого периода времени наш вице-президент по продуктам Таня Брагин ежедневно проводила ручной анализ рабочей нагрузки наших клиентов в Excel с использованием поисковых запросов. Мне, как бывшему архитектору DWH, было стыдно, что ей пришлось так тяжело, и в результате родилась первая концепция внутреннего DWH.
При разработке системы перед нами стоял ряд важных задач, направленных на поддержку наших внутренних заинтересованных сторон, некоторые из которых перечислены ниже.
Примечание: в нашем внутреннем хранилище данных мы не собираем, не храним и не обрабатываем какую-либо часть данных наших клиентов (большая часть которых зашифрована), таких как табличные данные, текст запроса, сетевые данные и т.д. Например, для анализа запросов мы собираем только список используемых функций, время выполнения запроса, используемую память и некоторую другую метаинформацию. Мы никогда не собираем данные запроса или текст запроса.
Для достижения этой цели мы разработали план сбора данных из десятков источников, включая следующие.
Учитывая наши основные задачи, мы сделали несколько предположений:
- На данном этапе достаточно детализации наших данных за один час. Это означает, что мы можем собирать и хранить сводные данные за каждый час.
- На данный момент нам не нужно использовать подход CDC (или “сбора данных об изменениях”), поскольку это значительно удорожает инфраструктуру DWH. Традиционная прямая загрузка / ETL должна удовлетворить наши потребности. Если эти источники данных подлежат обновлению, мы можем выполнить полную перезагрузку данных.
- Поскольку у нас отличная масштабируемая и быстрая база данных, нам не нужно выполнять преобразования ETL за пределами базы данных. Вместо этого мы используем ClickHouse напрямую для выполнения преобразований с использованием SQL. Это прекрасно работает.
- В ClickHouse мы по своей природе работаем с открытым исходным кодом, поэтому хотим, чтобы весь наш стек содержал только компоненты с открытым исходным кодом. Мы также любим вносить свой вклад.
- Поскольку у нас очень разные типы источников данных, нам потребуется множество инструментов и подходов для извлечения данных из этих источников. В то же время нам необходимо стандартизированное промежуточное хранилище.
Однако одно из наших первоначальных предположений оказалось неверным. Мы предполагали, что, поскольку наша структура данных не такая сложная, нам будет достаточно иметь только два логических уровня в DWH - необработанный уровень и уровень “витрины данных”. Это было ошибкой. На самом деле нам нужен был третий промежуточный уровень, хранящий внутренние бизнес-объекты. Мы объясним это ниже.
Архитектура
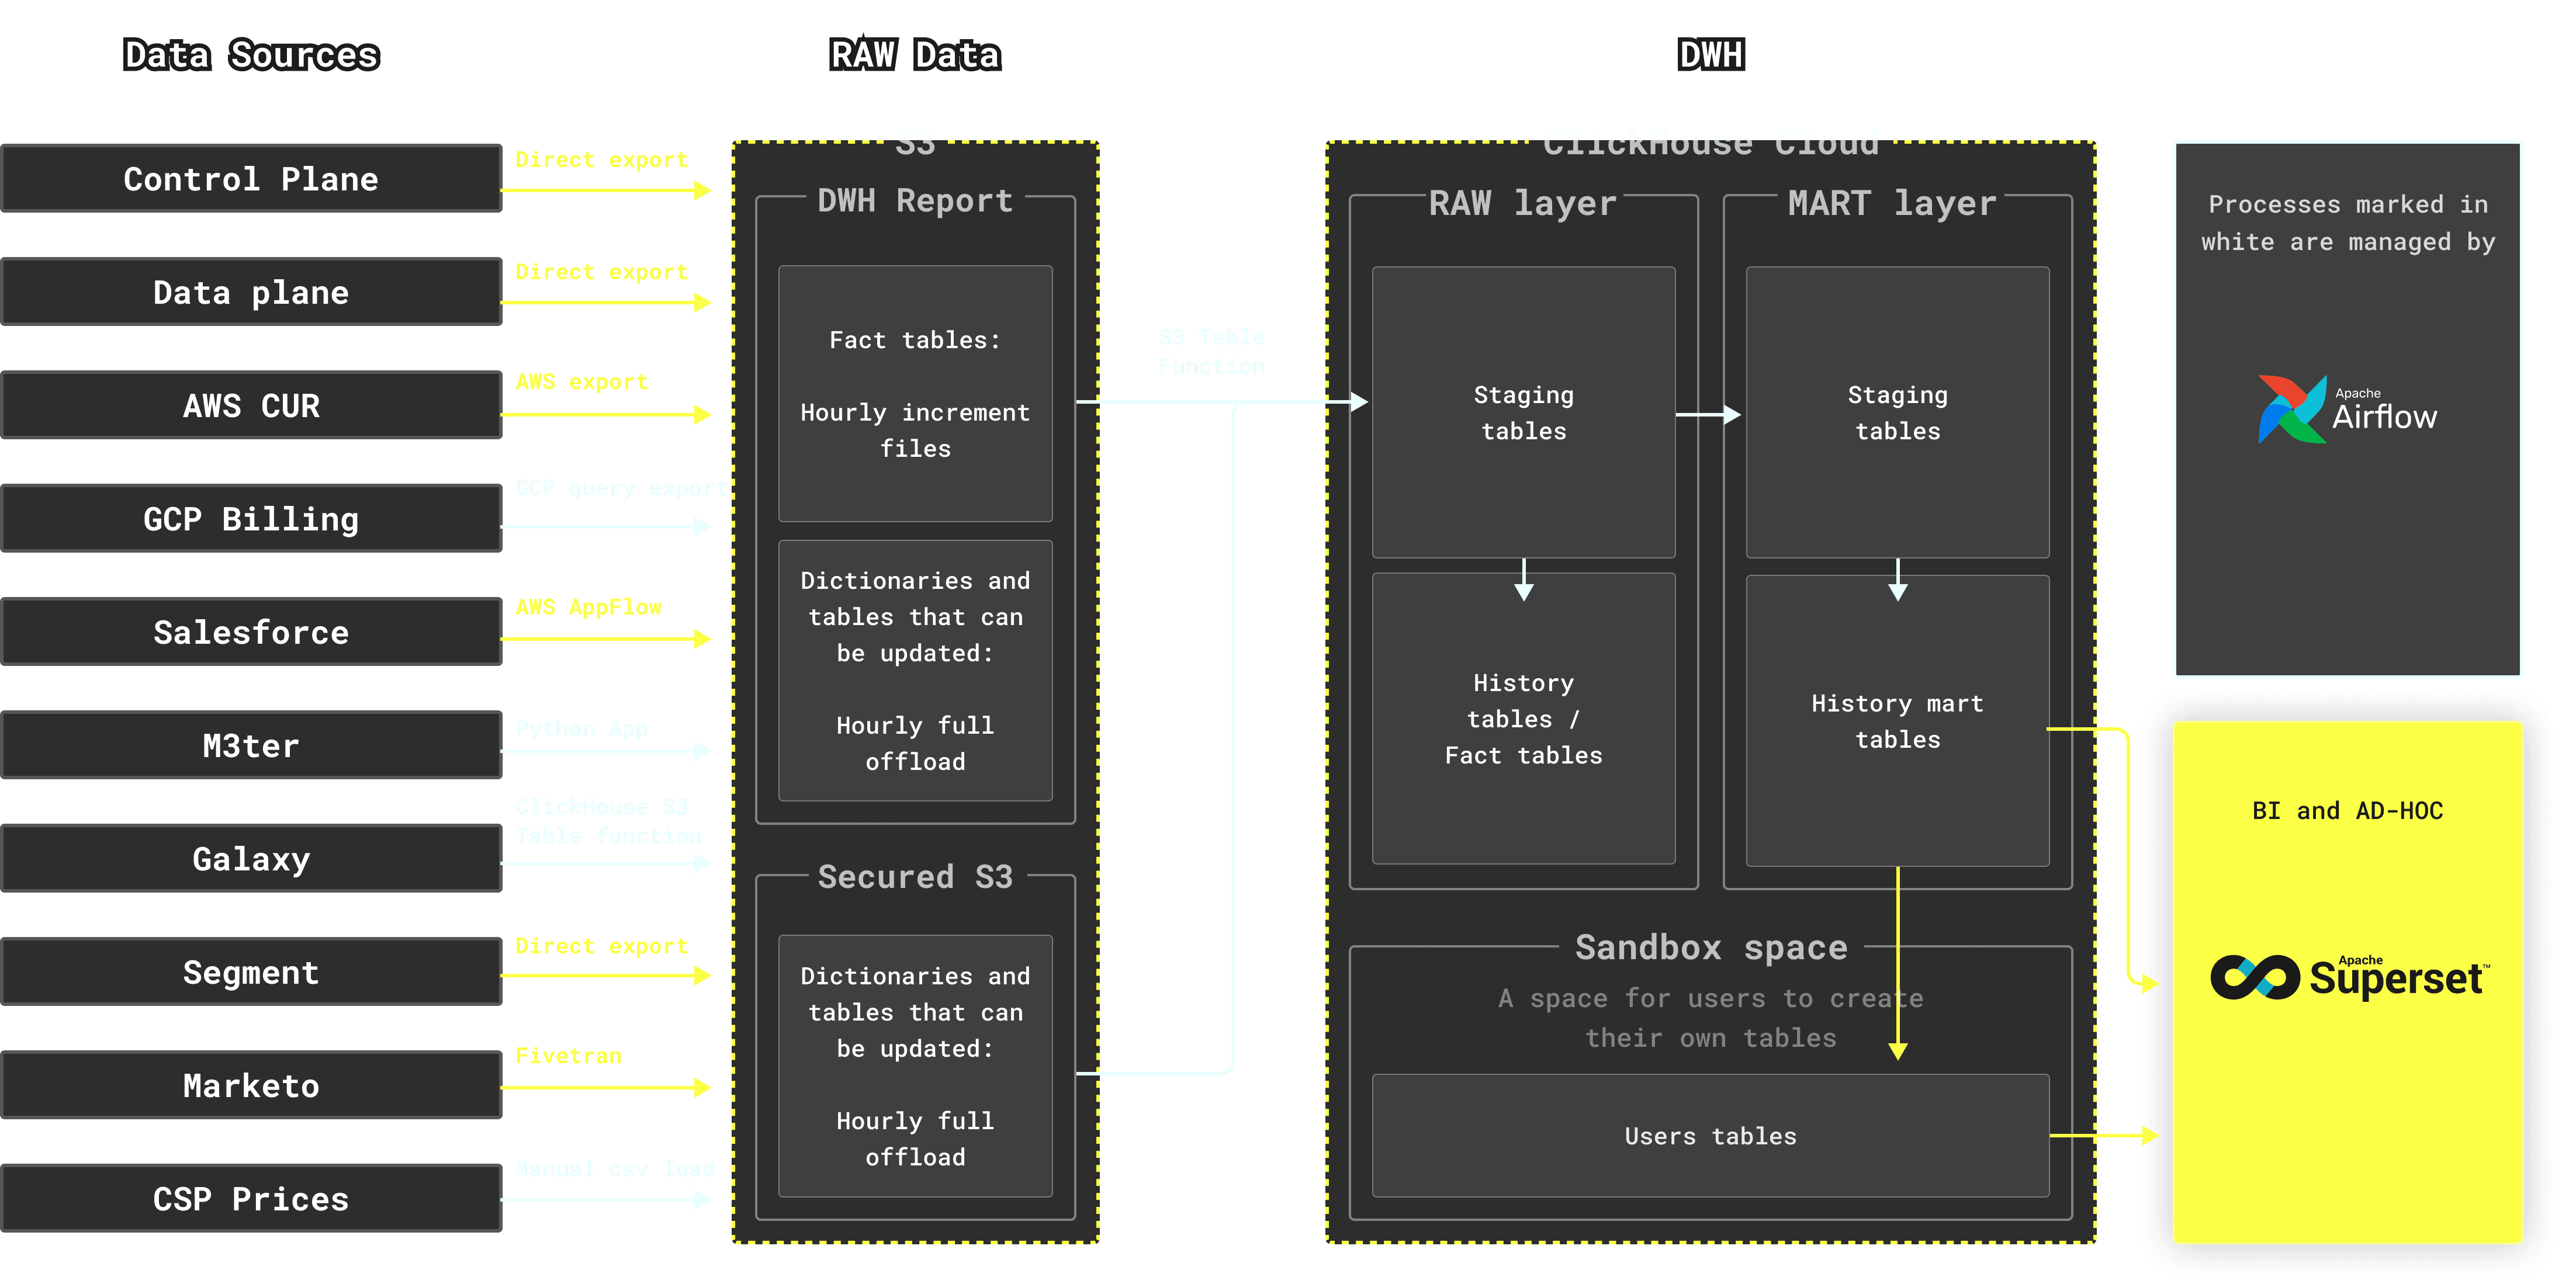
В результате мы пришли к следующей архитектуре:
-
На высоком уровне наш стек можно описать следующим образом:
- ClickHouse Cloud - основная база данных
- Airflow - планировщик (инструмент планирования с открытым исходным кодом)
- AWS S3 - промежуточное хранилище необработанных данных
- Superset - внутренний инструмент BI и AD-HOC
- Мы используем различные инструменты и подходы для сбора данных из источников в несколько сегментов S3:
- Для Control Plane, Data Plane, Segment и AWS CUR мы используем встроенную функциональность источника данных для экспорта данных
- Для выставления счетов GCP мы используем экспортные запросы BigQuery для экспорта данных в GCS, откуда они могут быть получены с помощью функции ClickHouse S3 table
- Для Salesforce мы используем AWS AppFlow
- Для сбора данных из M3ter мы написали собственное приложение. Изначально он был написан на Kotlin, позже мы перенесли его на Python
- Для Galaxy (который представлен облачным кластером ClickHouse) мы используем табличную функцию ClickHouse S3 для экспорта данных в S3
- Для Marketo мы используем Fivetran
- Наконец, поскольку цены AWS и GCP меняются очень редко, мы решили не автоматизировать их загрузку, а создали несколько скриптов, которые при необходимости помогают нам вручную обновлять цены CSP
- Для больших таблиц фактов мы собираем данные с почасовым приращением. Для словарей и таблиц, которые могут получать не только новые строки, но и обновления, мы используем подход “замены” (т.е. загружаем всю таблицу каждый час).
- Как только данные за каждый час будут собраны в корзине S3, мы используем функцию ClickHouse s3 table для импорта данных в базу данных ClickHouse. Функция S3 table масштабируется по репликам и отлично работает с большими объемами данных.
- Из корзины S3 данные вставляются в необработанный слой базы данных. Этот слой имеет ту же табличную структуру, что и исходные данные.
- После серии преобразований, выполненных Airflow (включая объединения), данные из необработанных таблиц вставляются в таблицы MART - эти таблицы представляют бизнес-объекты и удовлетворяют потребности наших внутренних заинтересованных сторон.
При выполнении преобразований используется множество временных таблиц. На самом деле, большинство преобразованных результатов сначала записываются в промежуточную таблицу, и только затем они вставляются в целевую таблицу. Хотя такой подход создает некоторую сложность, он также дает нам необходимую гибкость при повторном использовании данных приращения. Это позволяет многократно использовать одну и ту же инкрементную часть без ее пересчета или повторного сканирования целевой таблицы. Промежуточные таблицы имеют уникальные имена для каждого запуска Airflow DAG (Направленных ациклических графиков).
Наконец, инструмент Superset BI позволяет нашим внутренним пользователям запрашивать таблицы на витрине, а также создавать диаграммы и информационные панели:
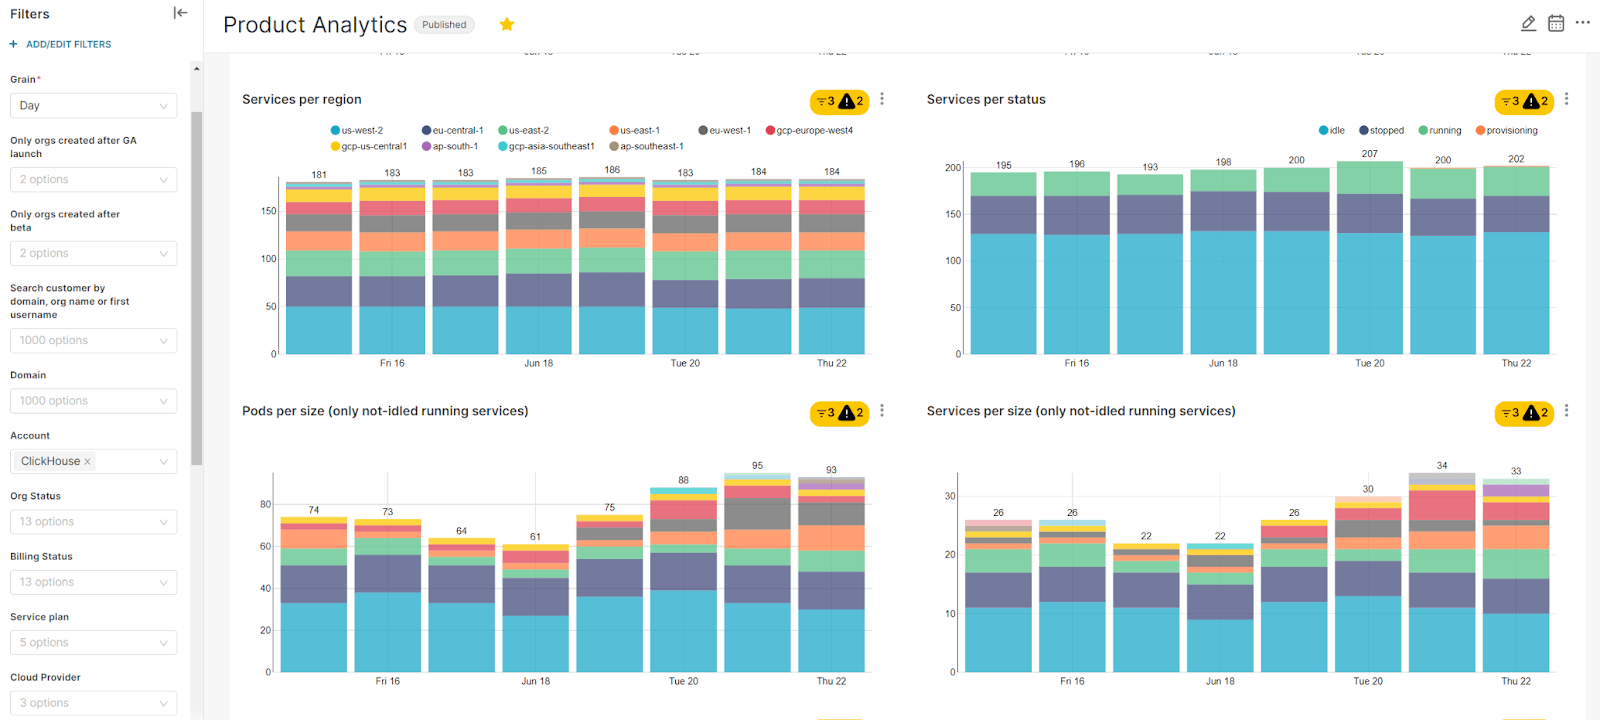
Пример панели мониторинга Superset. Примечание: в целях иллюстрации приведены примеры данных с поддельными числами.
Идемпотентность
Большинство таблиц, которые мы используем в ClickHouse, используют механизмы ReplicatedReplacingMergeTree. Этот движок позволяет нам не беспокоиться о дубликатах в таблицах - записи с одинаковым ключом будут удалены, и сохранится только последняя запись. Это также означает, что мы можем вставлять данные за один конкретный час столько раз, сколько потребуется - сохранится только одна последняя версия каждой строки. Мы также используем функцию ClickHouse “FINAL”, когда таблица используется в дальнейших преобразованиях для достижения согласованности, так что, например, функция sum() не вычисляет строку дважды.
В сочетании с заданиями Airflow/DAG, которые допускают многократное выполнение в течение одного и того же периода, наш конвейер полностью идемпотентен и может быть безопасно повторно выполнен без дублирования. Более подробная информация о конструкции внутреннего воздушного потока будет приведена ниже.
Консистенция
По умолчанию ClickHouse обеспечивает конечную согласованность. Это означает, что успешный запуск запроса insert не гарантирует, что новые данные будут во всех репликах ClickHouse. Этого достаточно для аналитики в реальном времени, но неприемлемо для сценария DWH. Представьте, например, что вы вставляете данные в промежуточную таблицу. Вставка успешно завершается, и ваш ELT-процесс начинает выполнять следующий запрос, который считывается из промежуточной таблицы… и вы получаете только частичные данные.
Однако ClickHouse предлагает другой режим для случаев использования, когда согласованность более важна, чем мгновенная доступность вставленных данных на первом узле. Чтобы гарантировать, что запрос insert не вернет результат “успешно” до тех пор, пока все реплики не получат данные, мы запускаем все запросы insert с параметром insert_quorum=3 (в нашем кластере три узла). Мы не используем настройку “автоматически”, потому что, когда один узел выходит из строя (например, при выполнении обновления ClickHouse), два оставшихся узла все равно смогут принимать вставки. Как только перезапущенный узел станет доступен, в течение некоторого времени в нем могут отсутствовать вставленные данные. Поэтому для нас лучше получить сообщение об ошибке (количество активных реплик (2) меньше запрашиваемого кворума (3/3).. (TOO_FEW_LIVE_REPLICAS) при вставке данных менее чем в трех репликах. Поскольку перезапуски из-за обновлений выполняются довольно быстро, запросы обычно выполняются успешно, когда Airflow повторяет попытку после ошибки.
Конечно, такой подход не гарантирует, что незафиксированные части из предыдущих неудачных вставок не будут видны для запроса, но это не проблема, поскольку мы поддерживаем идемпотентность, как описано в предыдущей части. Другим решением было бы запустить все процессы ELT, используя только одну реплику, но это может ограничить производительность.
Разработка внутренней инфраструктуры
Учитывая наш масштаб, нам необходимо, чтобы наша инфраструктура DWH была простой в эксплуатации и масштабировании. После запуска внутреннего PoC непосредственно в AWS EC2 мы перенесли все компоненты нашей инфраструктуры в Docker.
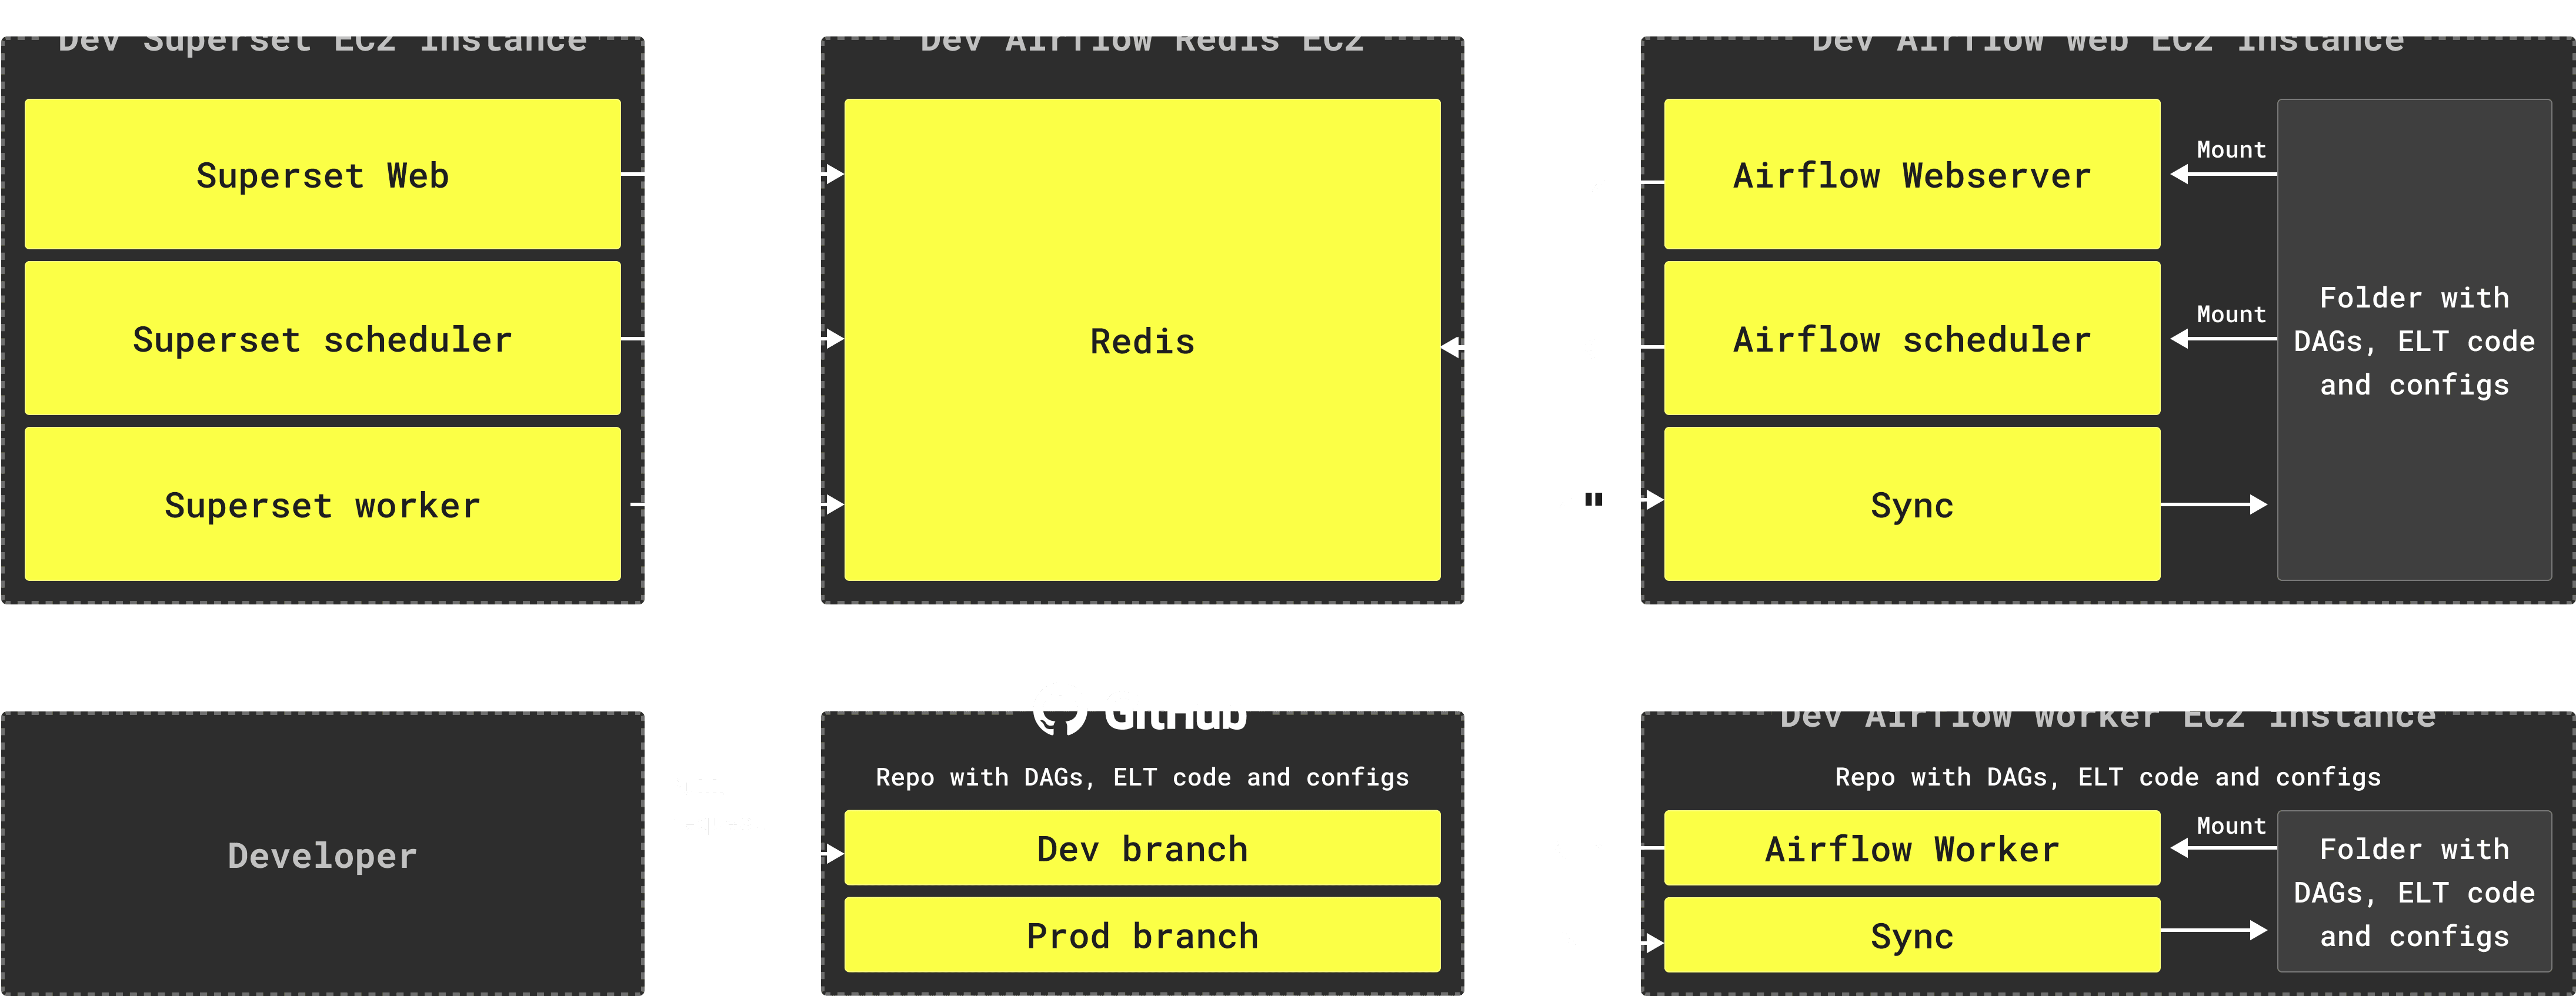
- У нас есть отдельные компьютеры для веб-сервера Airflow, Airflow worker и Superset. Все компоненты упакованы в контейнеры Docker
- На компьютерах Airflow мы дополнительно запускаем контейнер каждые 5 секунд, который синхронизирует репозиторий, содержащий наш код DAGs, запросы ELT и некоторые файлы конфигурации, с папкой, расположенной на компьютерах
- Мы используем панели мониторинга Superset и функции оповещений, поэтому у нас есть планировщик и рабочие контейнеры для Superset
- Все компоненты Airflow и Superset синхронизируются через экземпляр Redis, который выполняется на отдельном компьютере. Redis хранит состояние выполнения заданий и рабочий код для Airflow, кэшированные результаты запросов для Superset и некоторую другую служебную информацию
- Мы используем AWS RDS для PostgreSQL в качестве внутренней базы данных для Airflow и Superset
- У нас есть две независимые среды с собственными экземплярами ClickHouse Cloud, установками Airflow и Superset в разных регионах
- Хотя одна среда называется Preprod, а другая - Prod, мы поддерживаем согласованность Preprod, чтобы иметь возможность переключаться, если Prod недоступен.
Такая настройка позволяет нам легко и безопасно выпускать релизы:
- Разработчик создает ветку из ветки разработки или производства
- Разработчик вносит изменения
- Разработчик создает PR для ветки Preprod
- Как только PR проверяется и утверждается, изменения отправляются в экземпляр Preprod Airflow, где они тестируются
- Как только изменения будут готовы к внедрению в prod, будет выполнен переход от Preprod к Prod-ветви
Внутренний дизайн Airflow
Изначально мы думали о создании сложной системы DAG с большим количеством зависимостей. К сожалению, ни один из существующих вариантов механики зависимостей DAG не может работать с требуемой архитектурой (что является довольно распространенной проблемой в Airflow):
- Airflow не позволяет изменять имена наборов данных при выполнении. Поэтому новые наборы данных не могут использовать временные имена. Если мы используем статическое имя набора данных, то нижестоящая группа обеспечения доступности базы данных будет запущена только один раз для последнего приращения.
- Триггеры могут работать для нас, но использование триггеров слишком усложнит нашу настройку. Наличие 10-20 групп доступа с триггерами с операционной точки зрения выглядит как кошмар зависимостей.
Таким образом, мы получили следующую структуру:
- Отдельные группы доступа для загрузки данных из источника данных в S3 (например, M3ter -> S3)
- Единая огромная основная группа DAG, которая выполняет все преобразования при доставке данных в S3
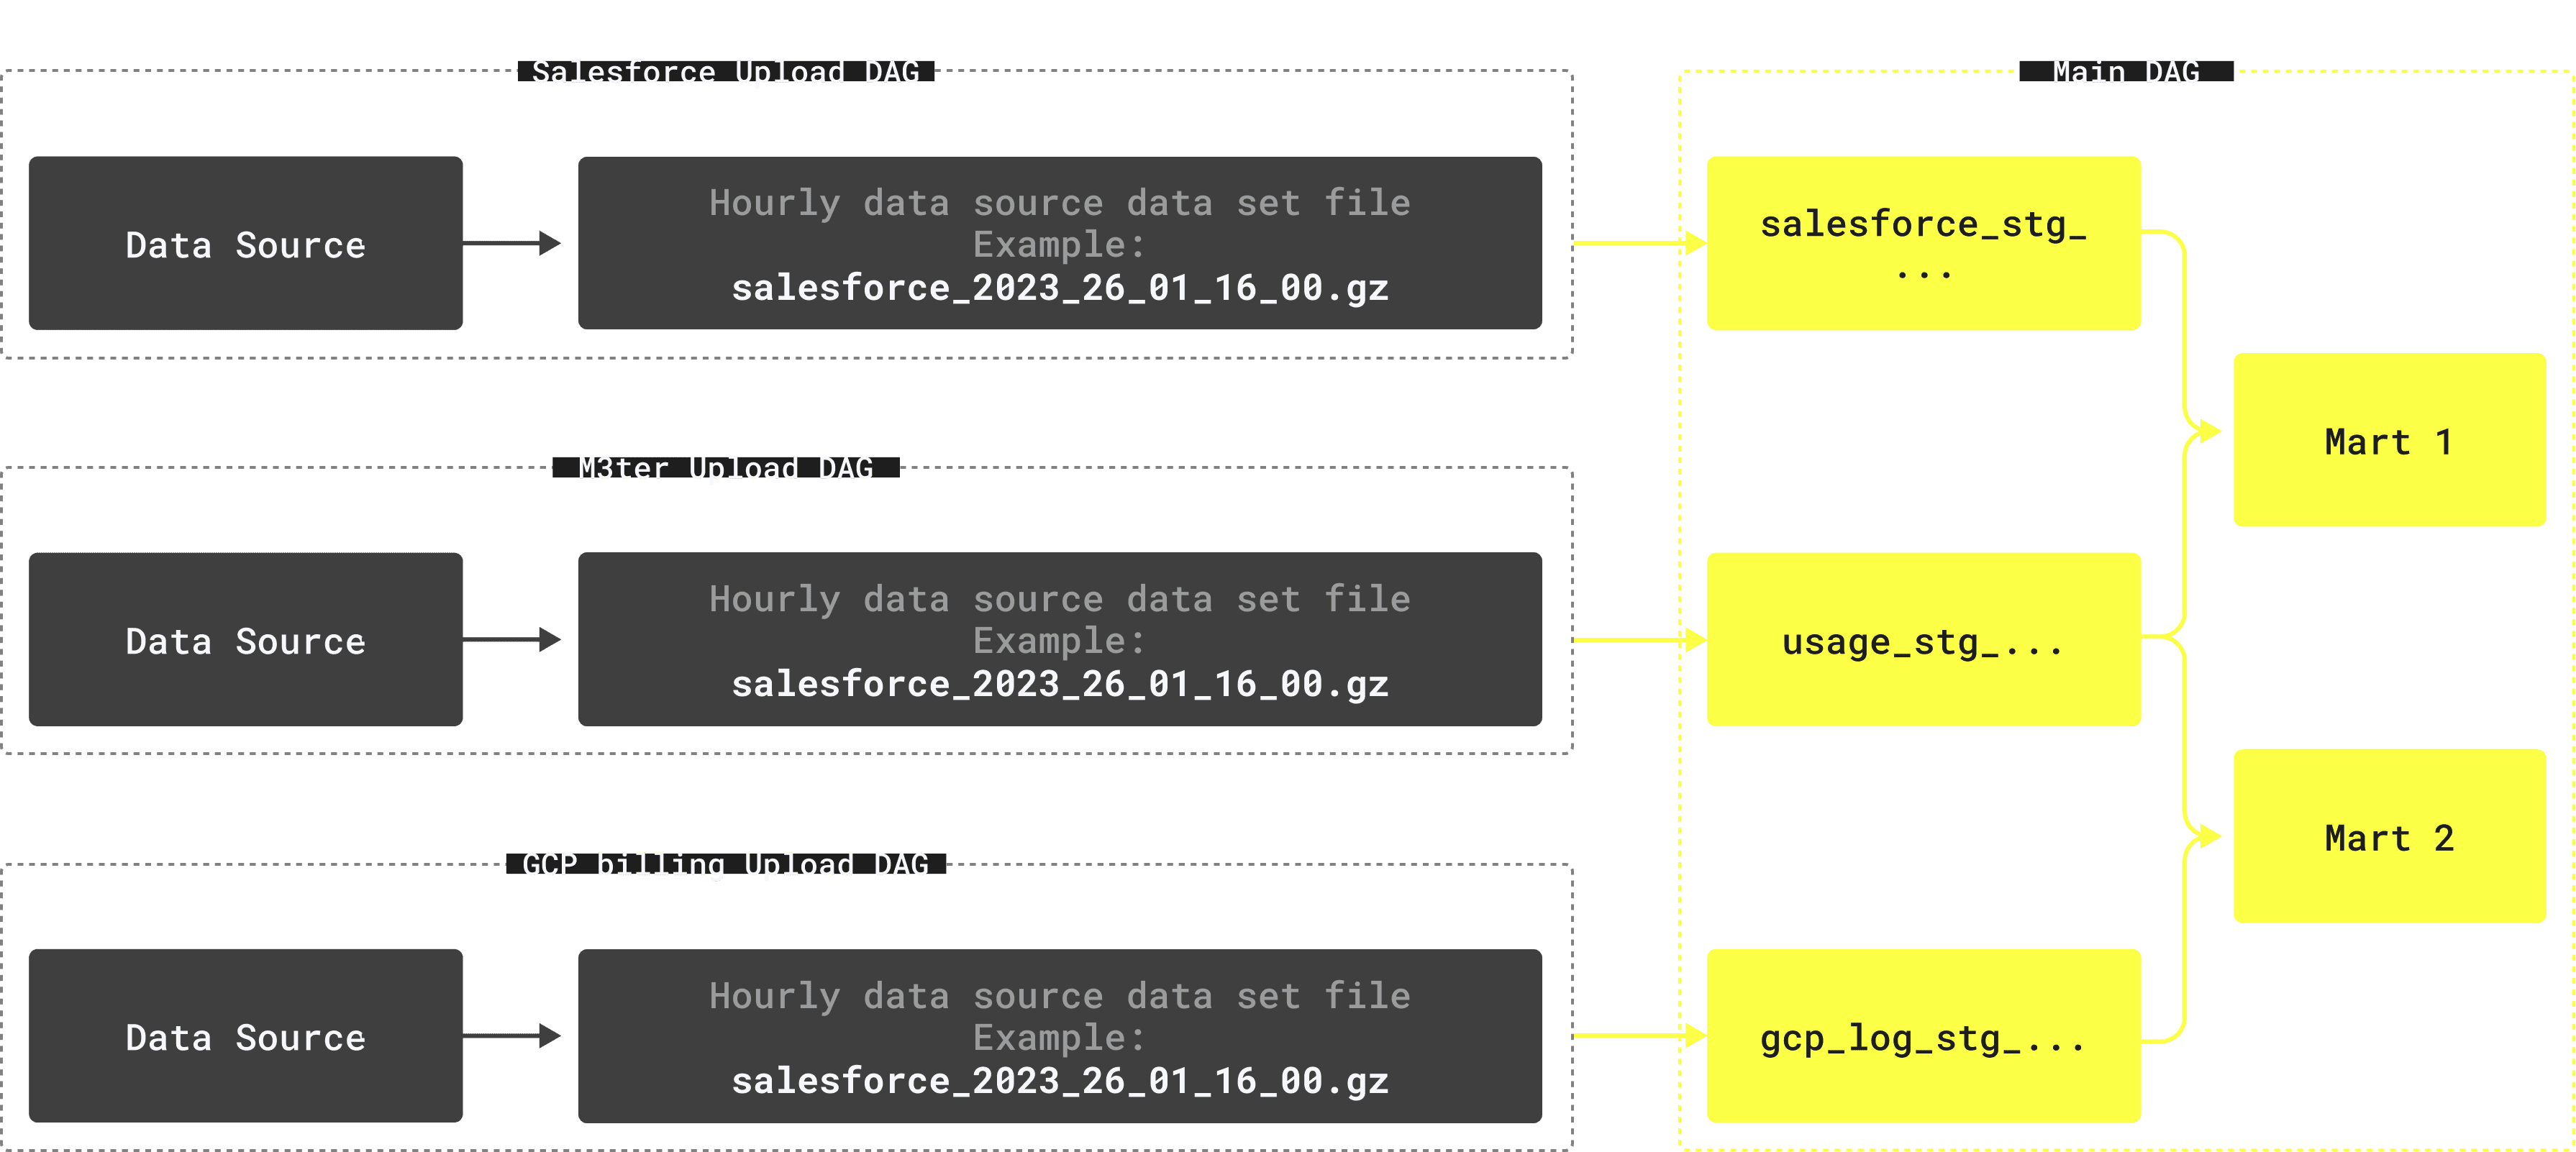
Основное преимущество такого подхода заключается в том, что он сочетает в себе как наличие всех необходимых зависимостей, четко перечисленных в основных задачах DAG, так и возможность создавать объекты, не подключенные к сбойному набору данных.
Безопасность
Поскольку в нашей внутренней системе DWH хранятся конфиденциальные данные, включая личные данные и финансовую информацию, безопасность должна быть основой нашей архитектуры. Для этого мы внедрили некоторые базовые правила и набор рамок для работы с DWH.
Общие правила
- Разные пользователи должны иметь доступ к разным данным в соответствии с ролевой моделью компании, и это должно быть сделано автоматически
- Разделение разрешений должно осуществляться на уровне базы данных (а не на стороне BI!).
- Ограничения доступа к сети должны быть представлены на всех уровнях (от использования Okta в качестве инструмента BI до IP-фильтрации).
Реализация
Мы используем Google groups для контроля внутренних разрешений пользователей. Это позволяет нам использовать существующие внутренние группы компании, а также позволяет владельцам групп (которые могут быть представлены нетехническим специалистом, не интересующимся SQL) контролировать доступ к различным данным. Группы могут быть вложенными. Например:
Для сопоставления групп Google с точными правами доступа мы используем системную таблицу, которая связывает:
- Название группы Google
- Имя базы данных
- Имя таблицы
- Массив столбцов
- Фильтр (например, “where organization=’clickhouse’)
- Тип доступа (ВЫБРАТЬ, ВСТАВИТЬ)
У нас также есть скрипт, который выполняет следующее:
- Получает рекурсивный список групп и пользователей
- Создает (фактически, заменяет) этих пользователей в базе данных с уникальным паролем
- Создает роли, соответствующие группам Google
- Назначает роли пользователям
- Предоставляет разрешения ролям в соответствии с таблицей разрешений с предложением “WITH REPLACE OPTION” - это приведет к удалению всех других разрешений, которые по какой-либо причине могли быть предоставлены вручную.
Что касается надмножества, мы используем функцию DB_CONNECTION_MUTATOR, чтобы заменить имя пользователя базы данных на имя пользователя надмножества при отправке запроса в базу данных. У нас также включен Google Oauth в надмножестве. Это означает, что в DB_CONNECTION_MUTATOR у нас есть все, что нам нужно, чтобы заставить Superset подключаться с желаемым именем пользователя и паролем:
def DB_CONNECTION_MUTATOR(uri, params, username, security_manager, source):
    # Only enable mutator on clickhouse cloud endpoints
    if not uri.host.lower().endswith("clickhouse.cloud"):
        return uri, params
    user = security_manager.find_user(username=username)

    generated_username = str(user.email).split('@')[0] + '--' + str(user.username)
    uri.username = generated_username
    # Password generation logic - hidden in this example
    uri.password = ...
   return uri, params
Вышесказанное означает, что Superset использует уникальное имя пользователя в базе данных для каждого пользователя с уникальным набором разрешений, которые контролируются Google groups.
Соответствие требованиям GDPR
Пользователи ClickHouse Cloud могут попросить нас удалить все их персональные данные, включая имя, адрес электронной почты и другую информацию. Разумеется, в этом случае мы также удаляем эту информацию из DWH. Самое замечательное здесь то, что нам не нужно выполнять никаких обновлений или удалений в таблицах ClickHouse. Поскольку наш движок оставляет только одну последнюю запись для каждого значения ключа, все, что нам нужно сделать, это вставить новую версию строки с данными удаленных пользователей. Для удаления старых строк потребуется несколько часов, но стандарты GDPR дают вам от 3 до 30 дней на удаление данных в зависимости от сценария. Итак, полный алгоритм таков:
Найдите в одной из исходных систем специальный флажок, указывающий на то, что этот идентификатор должен быть замаскирован/удален
- Выберите все записи из таблицы с этим идентификатором
- Замаскируйте обязательные поля
- Вставьте данные обратно в таблицу
- Запустите команду “оптимизировать таблицу ... окончательно”, чтобы убедиться, что старые записи удалены с диска
- Когда появится новое почасовое увеличение, мы выполним объединение со списком удаленных идентификаторов. Это означает, что если по какой-либо причине личная информация пользователя еще не была удалена полностью, мы автоматически замаскируем эти данные
Улучшения и планы на будущее
Хотя в целом мы довольны нашим DWH, есть некоторые вещи, которые мы планируем изменить в ближайшие месяцы:
Третий логический уровень
Идея иметь только два логических уровня, к сожалению, не работает. Мы обнаружили, что для вычисления действительно сложных показателей, которые могут быть заполнены и для которых требуются данные из более чем 5 источников данных, нам приходится создавать зависимости между различными витринами. Иногда это даже включает рекурсивные зависимости. Чтобы решить эту проблему, нам нужно ввести промежуточный уровень, называемый хранилищем подробных данных, или DDS. В нем будут храниться некоторые внутренние бизнес-объекты, такие как учетная запись, организация, сервис и т.д. Этот уровень будет недоступен для конечных пользователей, но он поможет нам устранить зависимости между витринами.
DBT
Airflow - хороший планировщик, но нам нужен инструмент, который при необходимости позаботится о многих других вещах: полной перезагрузке витрин данных, контроле качества, описании данных и документации и т.д. Для этого мы планируем интегрировать Airflow с DBT. Поскольку мы используем всю нашу инфраструктуру обработки данных в контейнерах Docker, для наших нужд довольно просто создать отдельный контейнер DBT, который будет запускаться с помощью DAGs Airflow.
Соглашения об именовании
Хотя с самого начала мы знали, что должны следовать некоторым правилам при присвоении имен таблицам, полям и диаграммам, мы не вкладывали в это слишком много ресурсов. В результате у нас сейчас довольно запутанные названия, которые не позволяют пользователям понять назначение конкретной таблицы или поля. Нам нужно внести в это ясность.
Ресурсы
ClickHouse - относительно молодая компания, поэтому наша команда DWH относительно невелика и состоит всего из 3 человек:
- Инженер по обработке данных - создает и обслуживает инфраструктуру
- Продуктовый аналитик - помогает пользователям получать аналитические данные, строить диаграммы и разбираться в данных
- Руководитель команды - тратит всего ~30% времени на задачи по удаленному хранению данных
Что касается инфраструктуры, мы используем две среды с отдельными облачными сервисами ClickHouse. У каждого сервиса есть 3 узла (они же реплики, но все реплики принимают запросы). Объем используемой памяти для наших сервисов ClickHouse составляет ~200 Гб. Хотя мы не платим за эти услуги, поскольку являемся частью команды ClickHouse Cloud, мы изучили цены и производительность конкурентов и считаем, что в нашем случае другая облачная аналитическая база данных была бы намного дороже.
Кроме того, наша инфраструктура включает в себя 8 машин EC2 и модуль S3 с необработанными данными. В общей сложности стоимость этих услуг составляет около 1500 долларов США в месяц.
Общие результаты
Наш ЦОД работает уже более года. У нас более 70 активных пользователей в месяц, сотни информационных панелей и тысячи диаграмм. В общей сложности пользователи выполняют около 40 000 запросов в день. На этой диаграмме показано количество запросов в день в разбивке по пользователям. За исключением пользователей системы и ELT:
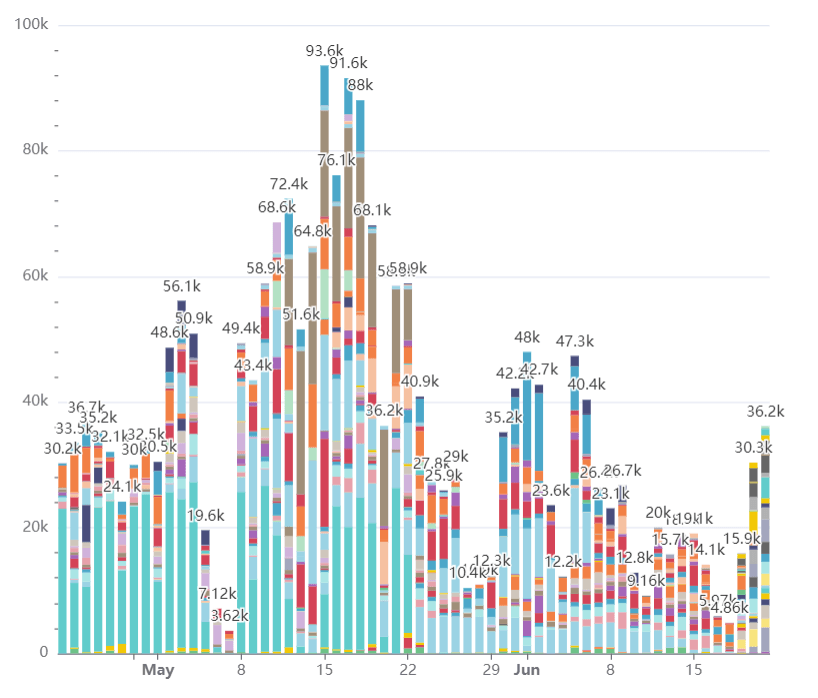
Да, наши пользователи тоже работают по выходным
Мы храним ~115 Тбайт несжатых данных в ~150 таблицах, но из-за эффективного сжатия ClickHouse фактический объем хранимых данных составляет всего ~13 Тбайт.
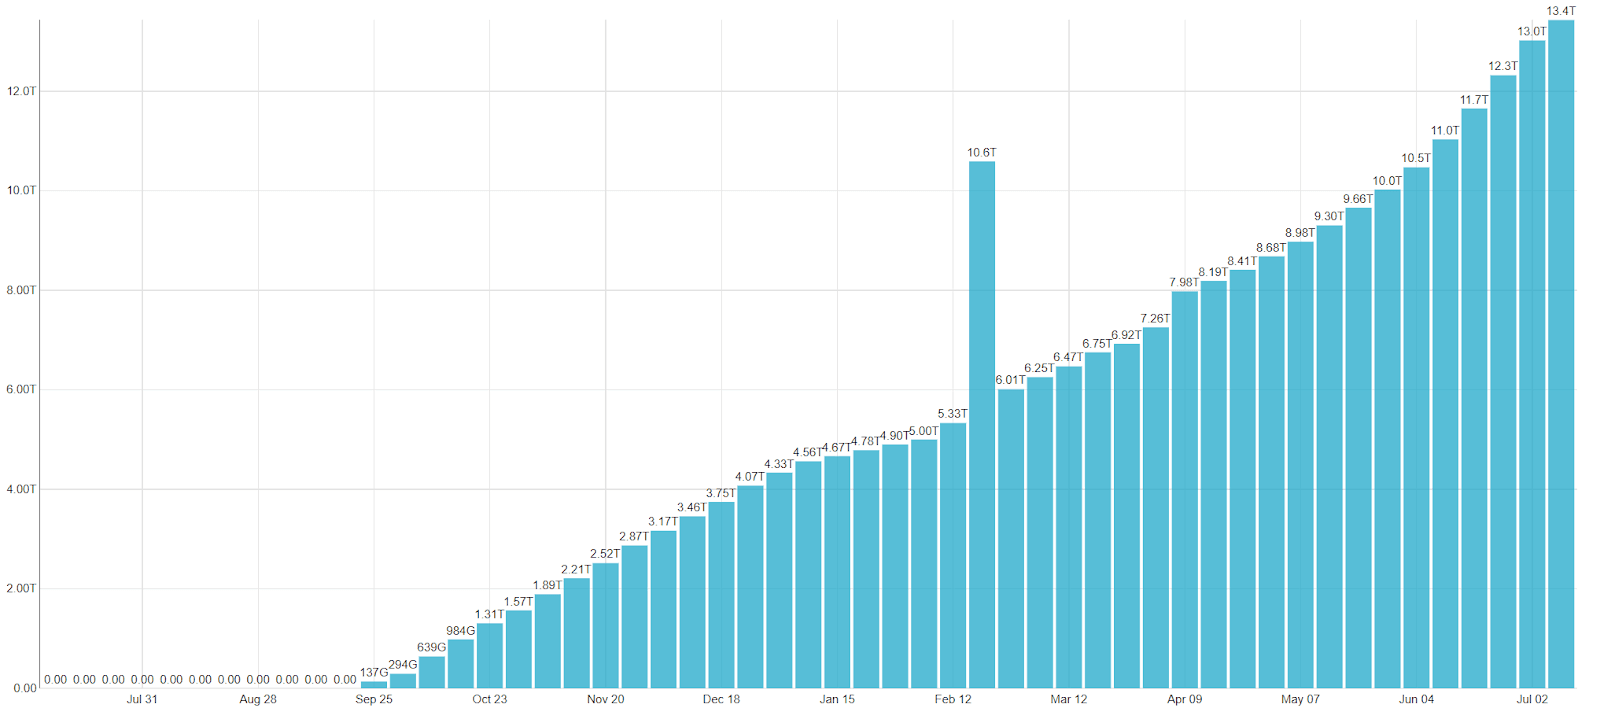
Объем данных в нашем DWH растет с каждой неделей. Февральский всплеск представляет собой внутренний эксперимент, в ходе которого требовалось дублировать все данные.
За один год мы внедрили DWH, основанную на технологии с открытым исходным кодом, которая обеспечивает удобство работы, которое нравится нашим пользователям. Несмотря на то, что наш DWH упрощает работу с данными, мы также видим множество улучшений и изменений, которые нам необходимо внести для продвижения вперед. Мы считаем, что использование ClickHouse Cloud доказывает, что его можно использовать для создания надежной системы DWH.


