

Мониторинг данных и оповещения
Мониторинг данных и оповещения — жизненно важная часть любой современной Data-продукта. Для новых сотрудников это не просто техническое задание: это гарантия того, что данные, которыми пользуются бизнес-аналитики, продуктовые команды и руководители, корректны, своевременны и понятны. Мониторинг позволяет увидеть сбои на ранних стадиях, обнаружить деградацию качества данных и предотвратить паралич бизнес-процессов из-за неработающего пайплайна. В этой главе мы разберём, что именно считать мониторингом данных, какие методологии применяются на практике, какие инструменты подойдут для open-source-подхода и для российских решений, какие риски и ограничения существуют и как минимизировать их. Мы начнём с теоретических основ, затем перейдём к практическим примерам, техническим деталям и завершим раздел FAQ, чтобы вы могли быстро применить полученные знания на реальных задачах.
Теоретическая часть
Что такое мониторинг данных и зачем он нужен
Мониторинг данных — это систематический сбор, агрегация, визуализация и оповещение по ряду метрик, связанных с данными в рамках данных продуктов и пайплайнов. Цель — раннее обнаружение отклонений, проблем с качеством, задержек в обработке и нарушений договорённостей об уровне сервиса (SLA). Мониторинг данных имеет свою специфику по сравнению с мониторингом инфраструктуры: в данных часто участвуют несовпадения во времени, дрифт распределений, пропуски и изменения схем, которые не всегда приводят к падению сервиса, но существенно влияют на решения, принятые на основе данных.
Термины и концепции
- Данные как продукт: каждый набор данных, отчёт, дашборд или срез пользовательской аналитики рассматривается как продукт; в нём должны быть понятны качество, актуальность и пригодность для пользователя.
- Данные observability (наблюдаемость): понятие, которое расширяет мониторинг за счёт трёх «опор»: метрики (числа, скорости), логи (попытки, ошибки, сигналы о состоянии) и трасировки (путь данных через систему; позволяют понять, где именно произошла задержка или сбой).
- Data quality monitoring (DQM): мониторинг качества данных по таким измерениям, как полнота, корректность, своевременность, целостность, уникальность, согласованность и валидность.
- SLA, SLO, SLI для данных: договорённости о том, какой уровень доступности и качества данных мы гарантируем. SLI измеряется по конкретной метрике, SLA — целевой уровень, а SLO — целевой уровень сервиса, который мы стремимся держать.
- Data lineage (происхождение данных): карта того, откуда берутся данные, как они трансформируются и куда попадают. Лайнжинг помогает выявлять источник проблемы, когда возникают аномалии.
- Data contracts (контракты данных): формальные соглашения об ожидаемом формате, типах и свойствах данных между источниками данных и потребителями.
Методы мониторинга и подходы к оповещения
- Пороговый мониторинг (threshold-based): базовый и часто первый этаж мониторинга. Устанавливаются границы по метрикам (например, задержка обработки больше 5 минут, пропуск данных более 2% за час). Оповещение приходит, если порог нарушен. Недостаток — порог может быть неадекватно установленным, и часть событий остаётся незамеченной.
- Ассоциации и аномалии (anomaly detection): автоматическое выявление необычных паттернов в данных по времени. Для этого применяют статистические методы, модели машинного обучения или эвристики на основе истории метрик. Преимущество — лучше ловит редкие и неожиданные проблемы; недостаток — требует поддержки и калибровки, риск ложно-положительных сбоев.
- Детектор дрейфа (drift detection): контроль за дрейфом распределения данных и схем. В частности: дрейф распределения признаков, дрейф форматов и изменений в частоте событий. Влияет на точность моделей и отчётов.
- Data contracts и валидаторы: при изменениях в схеме или формате данных контракт проверяет соответствие. При нарушении — уведомление и откат изменений, если это возможно.
- Многоуровневое оповещение: alerting на уровне инфраструктуры, на уровне потоков данных (пайплайнов), на уровне бизнес-метрик. Часто используются разные каналы уведомлений и задержки, чтобы не сыпались ложные тревоги.
- Runbooks и инцидент-менеджмент: каждый инцидент должен сопровождаться подробной инструкцией по реагированию, ответственностью, шагами по исправлению и восстановлению. Это снижает MTTR (mean time to repair) и ускоряет возвращение сервиса в нормальное состояние.
- Контракты между командами: четкое определение, какие данные и какие показатели обязаны предоставлять источники данных и потребители, какие уровни качества являются допустимыми в рамках конкретного продукта.
Архитектура мониторинга данных
Обычно мониторинг данных строится вокруг трёх слоёв:
- Источники и сбор телеметрии: из пайплайнов ETL/ELT, баз данных, потоков данных (Kafka, Kinesis), логов приложений и систем.
- Хранилище телеметрии и метрик: база метрик (Prometheus-compatible), логи (ELK/EFK, Loki), трасировки (OpenTelemetry, Jaeger, Zipkin).
- Инструменты визуализации и алертинга: Grafana или аналогичные панели, Alertmanager/платформенные механизмы оповещений, интеграции с каналами связи (Slack, Telegram, Email).
Ключевые метрики и показатели
- Данные о времени задержки и покрытии: задержка доставки данных (data latency), время обработки (processing time), задержка между событием и его попаданием в хранилище.
- Пропуск и полнота данных: количество успешно обработанных записей, процент пропусков, пропуски по ключам, полнота по указанным временным окнам.
- Стабильность и качество данных: корректность форматов, валидность значений, уникальность ключей, дубликаты, константные или нулевые значения там, где их быть не должно.
- Дефекты схемы: изменения в схеме полей, изменение типов данных, появление/удаление обязательных столбцов.
- Зависимости и lineage: как данные переходят между слоями системы, какие источники влияют на конкретный набор данных и какие пайплайны являются узкими местами.
- Надёжность пайплайнов: уровень ошибок обработки, проценты повторных запусков, длительность очередей и задержки в очередях.
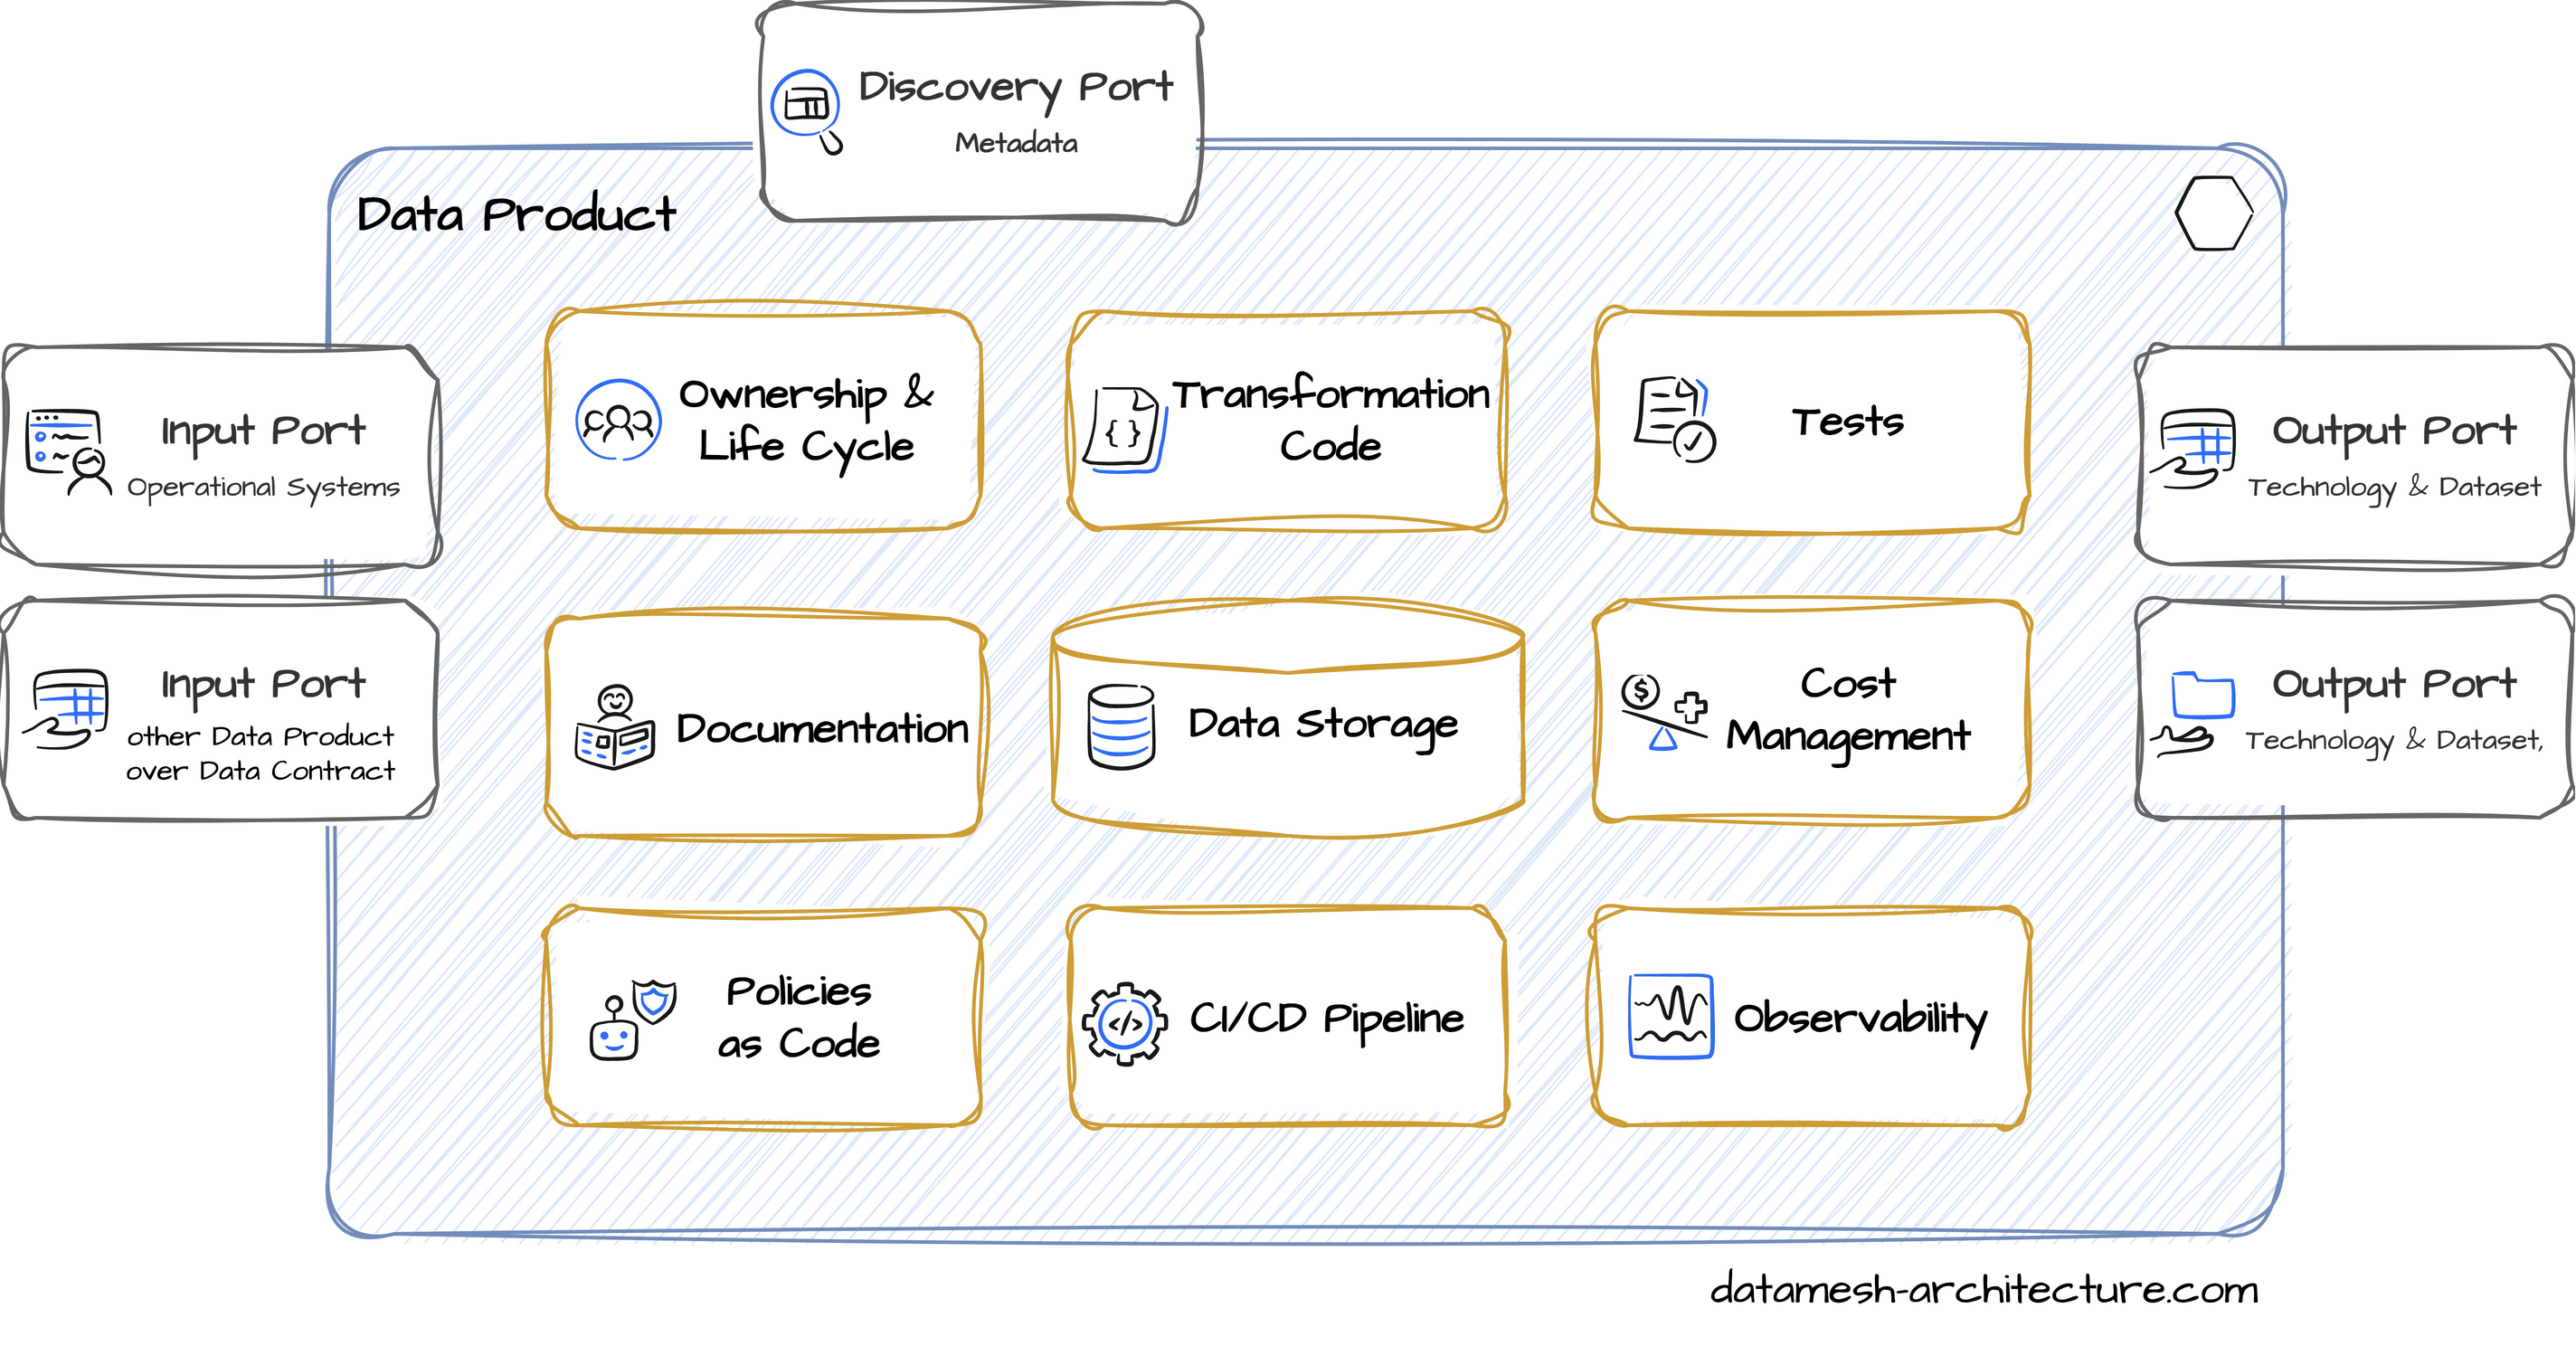
Практические принципы внедрения
- Начинайте с малого, потом расширяйтесь: выберите 2–3 критичных набора данных и разрабатывайте для них набор метрик и alerts. По мере взросления расширяйте coverage на другие наборы.
- Инструментальная независимость: используйте стандартизированные форматы и открытые протоколы (OpenTelemetry, OpenMetrics, OpenLineage), чтобы не попадать в зависимость от одного производителя.
- Включайте качество данных в процесс разработки: добавляйте проверки качества как шаг в CI/CD пайплайна данных; используйте тестовую среду для отработки изменений.
- Учитывайте регуляторику и безопасность: данные, особенно персональные, должны мониториться осторожно, с маскированием и соблюдением локальных норм.
Практические примеры
1) Пример мониторинга пайплайна ingestion в open-source стекe
Предположим, у вас есть пайплайн, который собирает события с веб-приложения в Data Lake. Основные метрики: ingest_rate (событий в минуту), latency_ms (средняя задержка), error_rate (процент ошибок обработки). Три простых alert'а:
- Alert: IngestRateTooLow — если ingest_rate падает ниже заданного порога на протяжении более 10 минут.
- Alert: IngestLatencyHigh — если latency_ms превышает порог 2x среднего значения за последние 30 минут.
- Alert: IngestErrors — если error_rate выше порога за 5 минут.
Инструменты: Prometheus собирает метрики из экспортеров на каждом узле пайплайна, Alertmanager отправляет уведомления в Slack/Teams, Grafana отображает дашборды. OpenTelemetry может использоваться для трассировки отдельных шагов пайплайна, чтобы видеть, на каком этапе задержка.
2) Пример мониторинга качества данных с Great Expectations (open-source)
Создается набор тестов качества для критических таблиц: users, events, transactions. В тестах проверяем: отсутствие null в ключевых полях, уникальность идентификаторов, валидность дат. Интегрируем шаг тестов в оркестрацию (Airflow или Dagster). При нарушении тестов — отправляем уведомление через Slack, и данные обновления помечаются как невалидные, что приводит к остановке или откату в конвейере. Это помогает ранжировать проблемы по приоритету и не использовать некорректные данные в аналитике.
3) Дорожная карта для дата-продукта с использованием OpenLineage и данных контрактах
OpenLineage позволяет собирать информацию о происхождении данных и трансформациях в пайплайнах. Это упрощает аудит и диагностику. Контракты данных устанавливают ожидаемые форматы и ограничения на входных и выходных данных для каждого компонента. При изменении схемы система автоматически уведомляет потребителей и предупреждает об отклонениях, чтобы минимизировать риск форс-мажора.
4) Российские решения и локальные практики
- Яндекс.Облако: предлагает мониторинг и логирование в рамках облачной платформы. Инструменты позволяют собирать метрики, логи и трасировки, строить дашборды и настраивать оповещения через различные каналы. В рамках российских реалий это помогает сохранять данные внутри территории и соответствовать локальным требованиям.
- СберОблако: аналогично имеет инструменты мониторинга, алертинга и визуализации, интегрируемые с предприятиями. Для Data-продуктов это позволяет держать под контролем качество данных и своевременность их обновления, используя локальные каналы уведомления и хранение телеметрии.
- Локальные решения и стили внедрения: часто используются open-source стеки с локальным хранением логов и метрик, а в качестве телеметрии применяют OpenTelemetry и OpenLineage, чтобы обеспечить совместимость с российскими требованиями к хранению данных и безопасности.
Технические детали
Инструменты и экосистема
- Метрики и алертинг: Prometheus + Alertmanager + Grafana. Prometheus собирает метрики с экспортеров по пайплайнам и базам данных. Alertmanager управляет правилами оповещений и маршрутизацией уведомлений через Slack, Teams, Email и другие каналы. Grafana отображает дашборды, где можно видеть зависимые метрики, тенденции и др.
- Логи: Loki или ELK/EFK стек (Elasticsearch, Logstash, Kibana). Логи пайплайна и системных сервисов помогают глубже понять причины проблем.
- Трассировка и производительность: OpenTelemetry, Jaeger, Zipkin. Трасировки позволяют увидеть путь данных по микросервисам и этапам обработки, что особенно полезно для сложных стриминговых пайплайнов.
- Контроль качества данных: Great Expectations, Deequ (Java/Scala). Great Expectations устанавливается как часть пайплайна и запускается как тестовый шаг перед публикацией данных. Deequ можно использовать в Spark-пайплайнах для качественных проверок.
- Контекст и линейка происхождения: OpenLineage, DataHub, Amundsen (для каталогов данных). Эти инструменты помогают строить карту зависимостей и линейку данных.
- Контракты данных: формальные спецификации, которые описывают схемы, правила и валидность данных, например через JSON Schema, Parquet схемы и тестовые наборы в Great Expectations.
Пример конфигурации оповещений (концептуально, без кода)
Пороговые правила:
- IngestRateBelowThreshold: если ingest_rate за 5 минут ниже порога x% от среднего за предыдущие 24 часа.
- LatencyAboveThreshold: если latency_ms выше среднего на 2x в течение 15 минут.
- ErrorRateRise: если процент ошибок превышает порог y% за 10 минут.
Аналитика аномалий:
- Применение простой модели сезонности и тренда к метрикам ingest_rate и latency; при отклонении на более чем 3 сигм ALERT.
Контроль качества данных:
- Валидации через Great Expectations: отсутствие NULL в ключевых столбцах, уникальность ключей, соответствие формату даты, диапазона значений.
Каналы уведомлений:
- Slack для оперативных оповещений, Email для руководителей, Teams для интеграции в рабочие процессы.
Стратегии внедрения и развёртывания
- Инструменты под ваши требования: начните с базового набора метрик и алертов, затем добавляйте слои наблюдаемости и качества по мере роста продукта.
- Автоматизация и CI/CD: внедрите тесты качества данных в CI/CD пайплайна. Разработайте шаблоны runbooks и инструкции по реагированию на типовые инциденты.
- Контроль доступа и безопасность: настройте ограничение доступа к данным телеметрии; используйте маскирование и анонимизацию там, где возможно; храните телеметрию внутри локального региона или в соответствии с регуляторикой.
- Права пользователей: ваши потребители данных должны иметь ясную картину того, какие данные мониторятся, какие пороги применяются и какие действия будут предприняты в случае отклонения.
Риски и ограничения
- Ложные тревоги и alert fatigue: слишком агрессивные пороги приводят к усталости команды, что снижает оперативность реакции. Решение: настройка порогов по историческим данным, калибровка аномалий, уровни критичности и фильтры по контексту.
- Неполная и задерживающаяся телеметрия: если данные телеметрии поступают с опозданием или пропадают, мониторинг становится менее надёжным. Решение: резервирование источников данных, репликации, мониторинг на нескольких уровнях (инфраструктура, пайплайн, качество данных).
- Ложные отрицания и ложные положительные: слишком строгие правила могут пропускать реальные проблемы или наоборот отправлять тревогу на пустом месте. Решение: итеративная настройка на основе ретроспектив, включение алгоритмов машинного обучения для детекции аномалий, A/B-тесты порогов.
- Сложность инфраструктуры и рост объёма данных: по мере роста количество пайплайнов, наборов данных и метрик увеличивается; поддержка может потребовать дополнительного времени на конфигурацию и обучение персонала. Решение: модульность архитектуры, выделение «платформы мониторинга» как отдельной команды-центра компетенций.
- Безопасность и соответствие требованиям: обработка и хранение телеметрии может затрагивать конфиденциальные данные. Решение: минимизация личной информации, маскирование, регламенты по хранению и удалению данных, аудит доступа.
- Зависимость от инструментов и вендоров: выбор closed-source решений может привести к зависимости и росту стоимости. Решение: сочетать открытые стандарты с локальной реализации, избегать «затыкания» в одном стеке, поддерживать экспорт и миграцию данных.
Мониторинг данных и оповещения — это не просто набор графиков и алертов. Это системная практика управления качеством данных как продукта, которая требует ясной роли, процессов и инструментов. Ваша задача как члена команды Data-продукта — построить устойчивый, прозрачный и безопасный механизм наблюдения за данными, который обеспечивает раннее выявление проблем, помогает принимать обоснованные решения и минимизирует бизнес-риски. Начните с базовых метрик и проверок качества, постепенно расширяя охват на новые данные и пайплайны; внедряйте единые контракты и lineage, чтобы понять, где возникают проблемы; используйте как open-source инструменты, так и российские решения для локализации и соответствия требованиям. Надёжный мониторинг позволяет не просто замечать проблемы — он помогает предотвращать их и обеспечивает уверенность бизнесу в том, что данные работают на благо продукта и клиента.
Вопрос–Ответ (FAQ)
1) Чем отличается мониторинг данных от мониторинга инфраструктуры?
Мониторинг инфраструктуры следит за состоянием серверов, сетей, баз данных и сервисов в целом. Мониторинг данных фокусируется на качествах самих данных: их своевременности, полноте, корректности, согласованности и на том, как данные проходят через пайплайны. В идеальном случае оба типа мониторинга работают в связке: инфраструктура обеспечивает стабильность работы систем, а мониторинг данных гарантирует, что данные, которые эти системы выпускают и обрабатывают, пригодны к использованию.
2) Что такое SLI/SLO для данных и зачем они нужны?
SLI — сервисная метрика, указывающая на конкретное качество данных (например, процент полноты данных за последние 24 часа). SLO — целевой уровень сервиса для этой метрики (например, 99.9% полноты). SLA — юридически закреплённые требования к качеству данных. Эти концепции помогают управлять ожиданиями бизнес-подразделения, планировать ресурсы и устанавливать приоритеты в работе над пайплайнами.
3) Какие инструменты лучше начать использовать в качестве базового набора?
Начните с Prometheus и Grafana для метрик и визуализации, Alertmanager для маршрутизации оповещений, Loki или ELK для логов, OpenTelemetry для трасировок, Great Expectations для контроля качества данных, и OpenLineage для lineage. Эти инструменты хорошо сочетаются и позволяют построить основанный на открытых стандартах стек наблюдаемости.
4) Какие типы метрик важны для пайплайна данных?
К критическим относятся: ingestion rate, latency, processing time, error rate, data freshness (время обновления данных), completeness (полнота), schema changes и drift в распределении значений. Также важны показатели задержек на каждом этапе пайплайна, чтобы выявить узкое место.
5) Как избежать перегрузки уведомлениями в процессе инцидентов?
Используйте многоуровневое оповещение: предупреждения на ранних этапах (warning) и критические оповещения (critical) только тогда, когда проблема требует немедленной реакции. Привязывайте оповещения к конкретным подмоделям и наборам данных, используйте фильтры по контексту и настройте MTTR-ориентированные runbooks. Регулярно проводите ретроспективы по инцидентам и корректируйте пороги.
6) Какие риски связаны с мониторингом данных и как с ними бороться?
Основные риски: ложные тревоги, пропуски телеметрии, сложности с масштабированием, безопасность и конфиденциальность. Борьба: тестирование порогов, внедрение аномалийной детекции, набор повторяемых проверок качества в CI/CD, маскирование чувствительных данных, хранение телеметрии в регионе, дисциплина в доступе и аудит.
7) Какие российские решения стоит учитывать при внедрении мониторинга?
Рассмотрите использование Яндекс.Облако для мониторинга и логирования, а также СберОблако с их инструментами мониторинга и оповещений. В сочетании с открытыми стековыми решениями (Prometheus, Grafana, Loki, OpenTelemetry, OpenLineage) вы сможете обеспечить локализацию данных, соответствие требованиям и адаптацию под локальные регуляторные условия.
8) Как интегрировать мониторинг данных в процесс разработки дата-продукта?
Включайте тесты качества данных в этапы CI/CD, добавляйте контрактные тесты для наборов данных, внедряйте мониторинг как часть инфраструктурной части проекта, создайте платформу мониторинга как сервис для повторного использования в нескольких проектах, и обучайте команду реагированию на инциденты с использованием готовых runbooks.
9) Что такое data lineage и зачем он нужен в мониторинге?
Data lineage — карта того, как данные движутся через систему: какие источники, какие преобразования и куда попадают данные. Это помогает быстро определить источник проблемы, понять воздействие проблемы на downstream-потребителей и обеспечить прозрачность для регуляториков и бизнес-аналитиков.
10) Какие шаги для начала внедрения мониторинга данных в моей компании?
Начните с проведения аудита текущих пайплайнов и набора критичных данных; выберите 2–3 набора данных, определите ключевые метрики и контракты; настройте базовый стек инструментов (Prometheus, Grafana, Loki, Great Expectations); внедрите простые alert’ы; создайте runbooks; по мере роста расширяйте охват, добавляйте линейку данных и методы аномалийной детекции, включайте российские решения для локализации и соответствия требованиям.


