

Горизонтальное масштабирование баз данных: полное руководство по репликации, партиционированию и шардированию от экспертов в области высоконагруженных систем
В современном мире цифровой трансформации данные стали ключевым активом любой компании. Объемы информации растут каждый день, а вместе с ними растет и нагрузка на системы хранения и обработки данных. Когда одиночный сервер перестает справляться с растущими запросами, перед бизнесом встает критический вопрос выбора стратегии масштабирования.
Вертикальное масштабирование (увеличение мощности существующего сервера) имеет очевидные ограничения по производительности и стоимости. Горизонтальное масштабирование — распределение нагрузки между множеством серверов — стало отраслевым стандартом для построения высокодоступных и отказоустойчивых систем.
Наша компания, как ведущий эксперт в области проектирования и реализации масштабируемых data-решений, подготовила детальное руководство по трем ключевым техникам горизонтального масштабирования: репликации, партиционированию и шардированию. Мы не только рассмотрим теорию, но и поделимся практическим опытом, примерами реализации и управлением рисками, основанными на наших реальных проектах.
Репликация: обеспечение отказоустойчивости и производительности
Репликация базы данных — это процесс автоматического копирования и синхронизации данных между несколькими серверами. Основная цель — создание избыточности данных для повышения доступности системы и распределения нагрузки.
Master-Slave репликация представляет собой архитектуру с одним главным сервером (Master), который обрабатывает все операции записи, и одним или несколькими подчиненными серверами (Slaves), которые реплицируют данные с Master и обслуживают запросы на чтение.
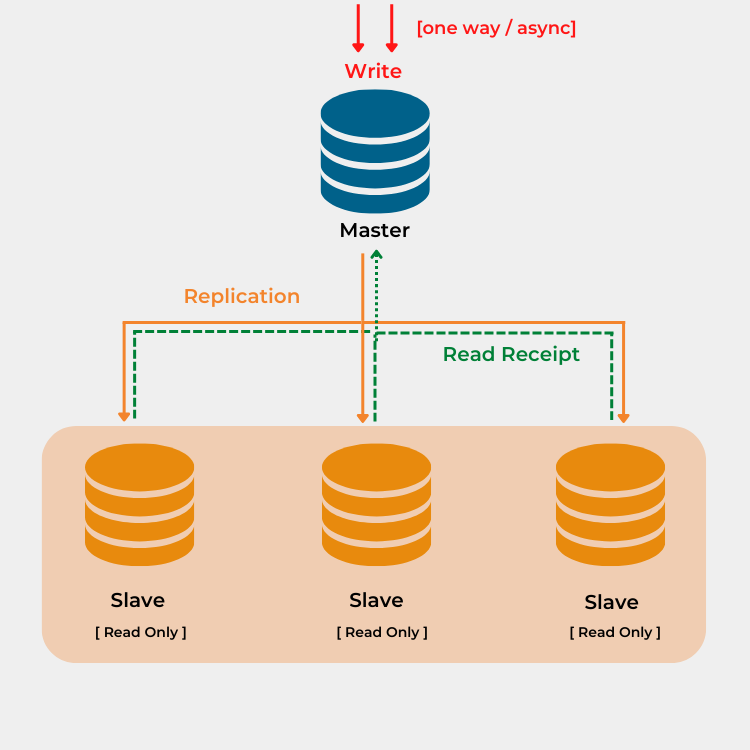
Пример: интернет-магазин с высокой нагрузкой на чтение каталога товаров. Master обрабатывает обновления цен и наличия, в то время как десятки Slave-серверов обслуживают запросы пользователей, просматривающих каталог.
К ключевым преимуществам в первую очередь стоит отнести значительное снижение нагрузки на Master-сервер за счет распределения запросов на чтение, а также повышенную отказоустойчивость — при сбое Master можно оперативно переключиться на Slave. Также стоит отметить и упрощенное масштабирование — добавление новых Slave-серверов не требует остановки всей системы.
К минусам стоит отнести задержку репликации (данные на Slave могут отставать от Master). В данном случаем самым оптимальным решением может стать мониторинг lag и настройка параметров репликации. Еще одним важным риском является выбор нового Master при отказе (необходимо реализовать механизм автоматического failover). Решением в данном случае является использование специализированных инструментов типа Patroni или встроенных механизмов СУБД. Также не стоит забывать и об ограничении производительности записи (все операции записи проходят через один узел). Решение в данном случае заключается в комбинировании с другими методами масштабирования.
Примечание:
Patroni — это мощный фреймворк с открытым исходным кодом для управления репликацией и отказоустойчивостью кластеров PostgreSQL. Он разработан для полной автоматизации процесса поддержания высокой доступности (High Availability, HA) вашей базы данных, минимизируя необходимость ручного вмешательства при сбоях.
Сердце Patroni — это использование распределенного хранилища для координации состояния кластера. Он поддерживает несколько бэкендов: etcd (наиболее популярный и рекомендуемый); ZooKeeper; Consul и Kubernetes API (через Custom Resource Definitions - CRDs). Это хранилище служит источником истины о том, какой узел является текущим лидером (мастером). Благодаря консенсусу, Patroni избегает ситуации "split-brain" (когда два узла считают себя мастерами).
Более того, Patroni работает как демон (агент) на каждом сервере в кластере PostgreSQL — как на мастере, так и на всех репликах. Каждый агент управляет жизненным циклом локального экземпляра PostgreSQL (запуск, остановка, перезагрузка), постоянно мониторит здоровье своего PostgreSQL, общается с другими агентами через центральное хранилище консенсуса.
Каждый экземпляр Patroni предоставляет REST API, который дает исчерпывающую информацию о состоянии узла и позволяет управлять им. Это открывает возможности для интеграции с системами мониторинга (например, Prometheus) и оркестрации.
Master-Master репликация — архитектура, где несколько серверов могут одновременно принимать операции записи и чтения, автоматически синхронизируя данные между собой.
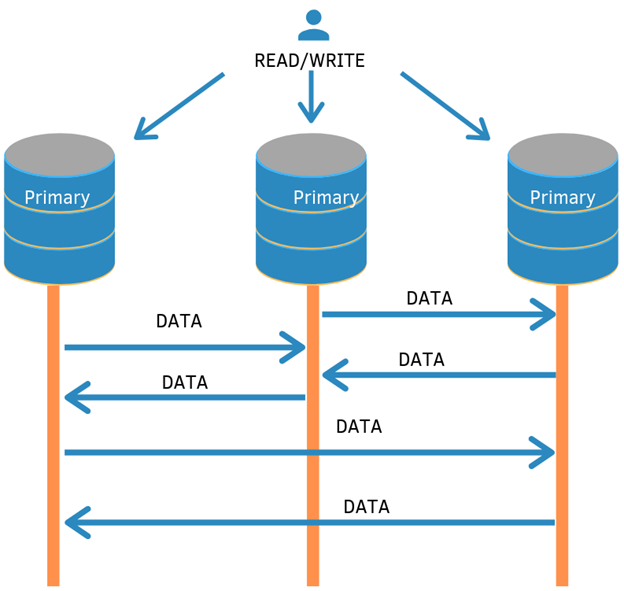
Пример: географически распределенная SaaS-платформа, где пользователи из разных регионов работают с ближайшим к ним сервером, уменьшая задержки и улучшая пользовательский опыт.
К преимуществам данной репликации в первую очередь стоит отнести высокую доступность — система продолжает работать при отказе любого из серверов. Еще одним весомым преимуществом является географическое распределение нагрузки (снижение latency для пользователей в разных регионах), а также балансировка нагрузки записи (возможность распределять операции записи между узлами).
Минусы данной схемы заключаются в конфликтах данных - одновременное изменение одних и тех же данных на разных серверах. Решением в данном случае может стать реализация механизмов разрешения конфликтов на уровне приложения или использование СУБД с встроенной поддержкой. Также стоит отдельно выделить сложность обеспечения консистентности (согласно CAP-теореме, приходится жертвовать либо согласованностью, либо доступностью). Решение - тщательный анализ требований бизнеса к консистентности данных. Наконец, поговорим о задержке синхронизации -рассинхронизации при сетевых проблемах. Решением в данном случае является настройка мониторинга и оповещений о расхождении данных.
Партиционирование — метод логического разделения больших таблиц на меньшие, более управляемые части без физического разделения между серверами.
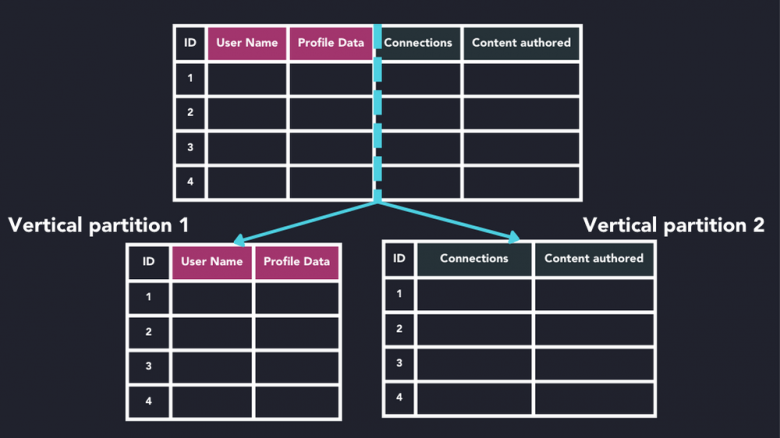
Вертикальное партиционирование предполагает разделение таблицы по столбцам. Например, разделение таблицы пользователей на основную информацию (ID, имя, email) и редко используемые данные (настройки, предпочтения, история активности).
Пример: социальная сеть, где основные данные пользователя запрашиваются постоянно, а подробная статистика активности — редко. Разделение этих данных ускорило основные запросы в 3 раза.
Ключевой риск состоит в неправильном проектировании схемы разделения, ведущем к необходимости частых JOIN-операций и снижению производительности. Решение - тщательный анализ паттернов доступа к данным перед проектированием.
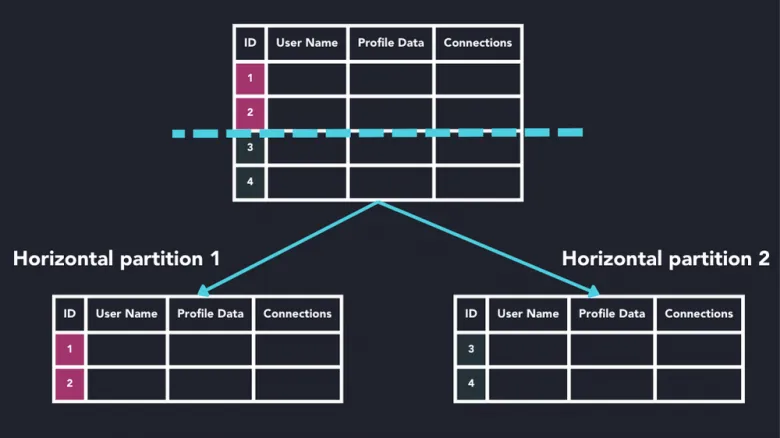
Горизонтальное партиционирование разделяет таблицу по строкам на основе определенного критерия. Например, разделение данных по дате (ежемесячные партиции) или по географическому признаку.
Успешная реализация: финансовый сервис с партиционированием транзакций по месяцам. Запросы к данным за конкретный период выполняются в 10 раз быстрее, а управление архивными данными упростилось.
Основные риски заключаются в дисбалансе нагрузки (неравномерном распределении данных между партициями) и в сложности запросов, затрагивающих многочисленные партиции. Решением в данном случае может стать оптимизация запросов и использование специализированных индексов.
Шардирование — метод горизонтального масштабирования, предполагающий физическое разделение данных между независимыми серверами (шардами). Каждый шард содержит часть данных, а вместе они образуют базу.
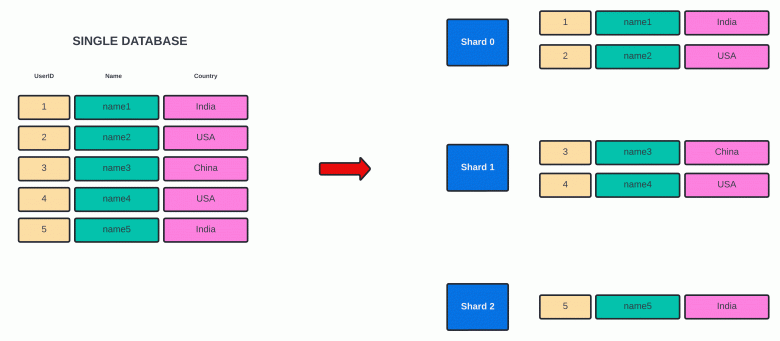
Range-Based шардирование распределяет данные в зависимости от диапазонов значений. Например, пользователи с ID от 1 до 1000000 на шарде 1, от 1000001 до 2000000 на шарде 2 и т.д.
Пример: e-commerce платформа с шардированием заказов по диапазонам order ID. Это позволило равномерно распределить нагрузку между 20 шардами.
Основной риск в данном случае - hotspot-эффект при неравномерном распределении запросов по диапазонам. Решением в данном случае может стать комбинирование с другими методами или динамическое изменение диапазонов.
Key-Based шардирование использует хеш-функцию для определения местонахождения данных. Например, shard_id = hash(user_id) % number_of_shards.
Пример: мессенджер с 50 миллионами пользователей, где шардирование на основе хеша user_id обеспечило равномерное распределение нагрузки.
Основной риск в данном случае заключается в необходимости решардинга при изменении количества шардов. Решение - использование консистентного хеширования или виртуальных шардов.
Directory-Based шардирование происходит на отдельном сервисе-каталоге, который хранит mapping между ключами данных и шардами.
Пример: multi-tenant SaaS решение, где данные каждого клиента размещаются на определенном шарде в зависимосте от договоренностей о качестве сервис.
Примечание:
Multi-tenant SaaS (программное обеспечение как услуга с мультитенантностью) — это архитектурный подход к разработке и предоставлению программного обеспечения, при котором единый экземпляр приложения и его база данных обслуживают множество клиентов («арендаторов» или «тенантов»).
Каждый клиент (тенант) — это обычно отдельная компания, организация или группа пользователей, которые используют приложение. Ключевая особенность в том, что они делят общие ресурсы (серверы, базу данных, код приложения), но при этом их данные и конфигурация изолированы и невидимы друг для друга.
Представьте себе большое бизнес-здание (это ваше приложение). В этом здании много отдельных офисных помещений, которые сдаются в аренду разным компаниям (это ваши тенанты). Все компании пользуются общей инфраструктурой: лифтами, электричеством, системой кондиционирования (вычислительные ресурсы, сеть), но при этом у каждой свой закрытый офис со своей мебелью и документами (данные и настройки), и они не имеют доступа к офисам друг друга.
Методы routing: клиентский, proxy и coordinator
Выбор метода routing критически влияет на производительность и надежность системы.
Клиентский routing предполагает, что приложение знает, куда направлять запросы. Хотя это исключает single point of failure, это усложняет логику приложения и затрудняет изменения в схеме шардирования.
Proxy-based routing использует промежуточный сервер для перенаправления запросов. Это значительно упрощает логику приложения, но создает дополнительный узел и потенциальную single point of failure.
Coordinator-based routing — рекомендованная версия proxy, где координатор может спокойно обработать достатчно сложные запросы, агрегировать результаты с нескольких шардов и предоставлять унифицированный интерфейс.
Наши рекомендации, основанные на опыте, следующие: для простых систем мы рекомендуем client-side routing, а для систем посложнее — coordinator с надлежащей репликацией и мониторингом.
Решардинг — один из самых сложных аспектов управления шардированными базами.
Мы разработали несколько стратегий для различных сценариев:
- Double-write - запись данных и в старый, и в новый шард в процессе миграции с последующей проверкой консистентности;
- Backfill-миграция - постепенное копирование данных и переключение трафика после завершения;
- Инструменты автоматизации: использование специализированных инструментов, таких как gh-ost, Pt-online-schema-change или сложных кастомных решений.
Пример: миграция 100 ТБ данных между шардами для крупного проекта без особого downtime благодаря тщательному планированию и автоматизации.
Примечание:
gh-ost и pt-online-schema-change (pt-osc) — это утилиты для изменения структуры таблиц в MySQL без блокировки записи, при этом gh-ost обеспечивает лучшую производительность, безопасность и контроль, а pt-osc предлагает простоту и совместимость с внешними ключами (FK).
Обе утилиты создают новую пустую копию таблицы, в которую вносятся необходимые изменения структуры (например, добавление или удаление колонок, индексов).
При синхронизации данных gh-ost использует специальные триггеры для отслеживания и копирования изменений из оригинальной таблицы в новую, а pt-osc использует триггеры, чтобы синхронизировать изменения, происходящие в оригинальной таблице, пока данные копируются в новую.
Когда копирование завершено и синхронизация поддерживается, оригинальная таблица заменяется новой с помощью команды RENAME TABLE.
В процессе работы утилит, оригинальная таблица остается доступной для операций чтения и записи, минимизируя простой.
В целом, gh-ost предпочтителен для критичных производственных сред с высокими требованиями к производительности и безопасности, а также для минимизации рисков.
pt-online-schema-change подходит для сценариев, где важна простота использования, поддержка внешних ключей, а также для проектов, где требуется максимальная совместимость.
Для минимизации рисков при изменении количества шардов мы рекомендуем несколько продвинутых методов хэширования.
Консистентное хеширование минимизирует количество данных, которые должны быть перемещены при добавлении или удалении шардов. Это достигается с помощью распределения данных и шардов на виртуальном кольце.
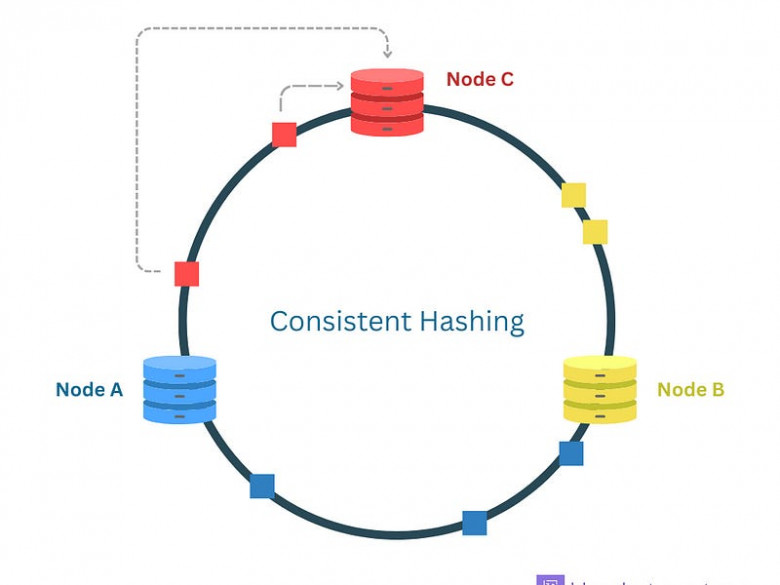
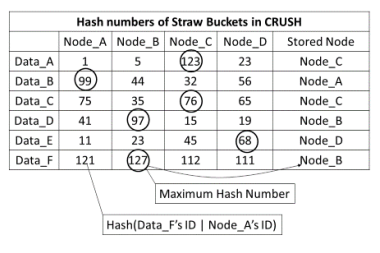
Рандеву-хеширование дает еще более равномерное распределение и минимальное перемещение данных при изменениях топологии.
При данном подходе, наша хеш-функция принимает 2 аргумента - pivot поле и номер шарда. Комбинация, при которой хеш будет наибольшим и будет указывать нужный шард.
shard := 0 // assume that hash_func(any) > 0for i := 0; i < len(shards); i++ {shard = max(hash_func(user_id, i), shard)}
После указанных команд, в переменной shard будет храниться номер нужного узла. Если сервер выйдет из строя, только те ключи, которые были привязаны к нему, перераспределяться, остальные останутся на месте.
Виртуальные шарды создают дополнительный уровень абстракции между данными и физическими серверами, позволяя гибко управлять размещением данных.
Реализация: социальная сеть с 100+ шардами использует виртуальное шардирование с коэффициентом 256 виртуальных шардов на физический сервер, что позволяет добавлять новые серверы с минимальными затратами.
Итак, горизонтальное масштабирование — сложная, но необходимая практика для современных приложений. Сегодня это не опция, а необходимость для любого серьезного современного сервиса, который рассчитывает на рост. Это сложный путь, связанный с принятием компромиссов (например, между согласованностью и доступностью), но он является краеугольным камнем для построения систем, способных выдержать нагрузки миллионов пользователей и обработать экзабайты данных.


