

Типы каталогов Iceberg: GlueCatalog
Типы каталогов Iceberg: GlueCatalog — это один из основных вариантов организации метаданных для Iceberg Lakehouse. Каталог в Iceberg служит центральной опорой для описания баз данных, таблиц, схем, версий и эволюции данных. GlueCatalog использует AWS Glue Data Catalog в качестве хранилища метаданных, где Iceberg хранит свои таблицы и их структуры, а сами данные остаются в хранилищах объектов (чаще всего в S3). Выбор GlueCatalog означает, что метаданные Iceberg отделены от файлов данных и управляются централизованно через Glue Data Catalog, что даёт устойчивый контроль версий, схему эволюции и единый доступ к данным из разных сервисов экосистемы AWS.
Цель этой главы — дать новичку полное представление о GlueCatalog в составе Iceberg: теорию, термины, методологии внедрения, практические примеры как на open-source стеке, так и в российских условиях, технические детали настройки и эксплуатации, а также риски и ограничения. В конце глава будет раздел FAQ с 7–10 вопросами и развёрнутыми ответами, которые опираются на описанный материал.
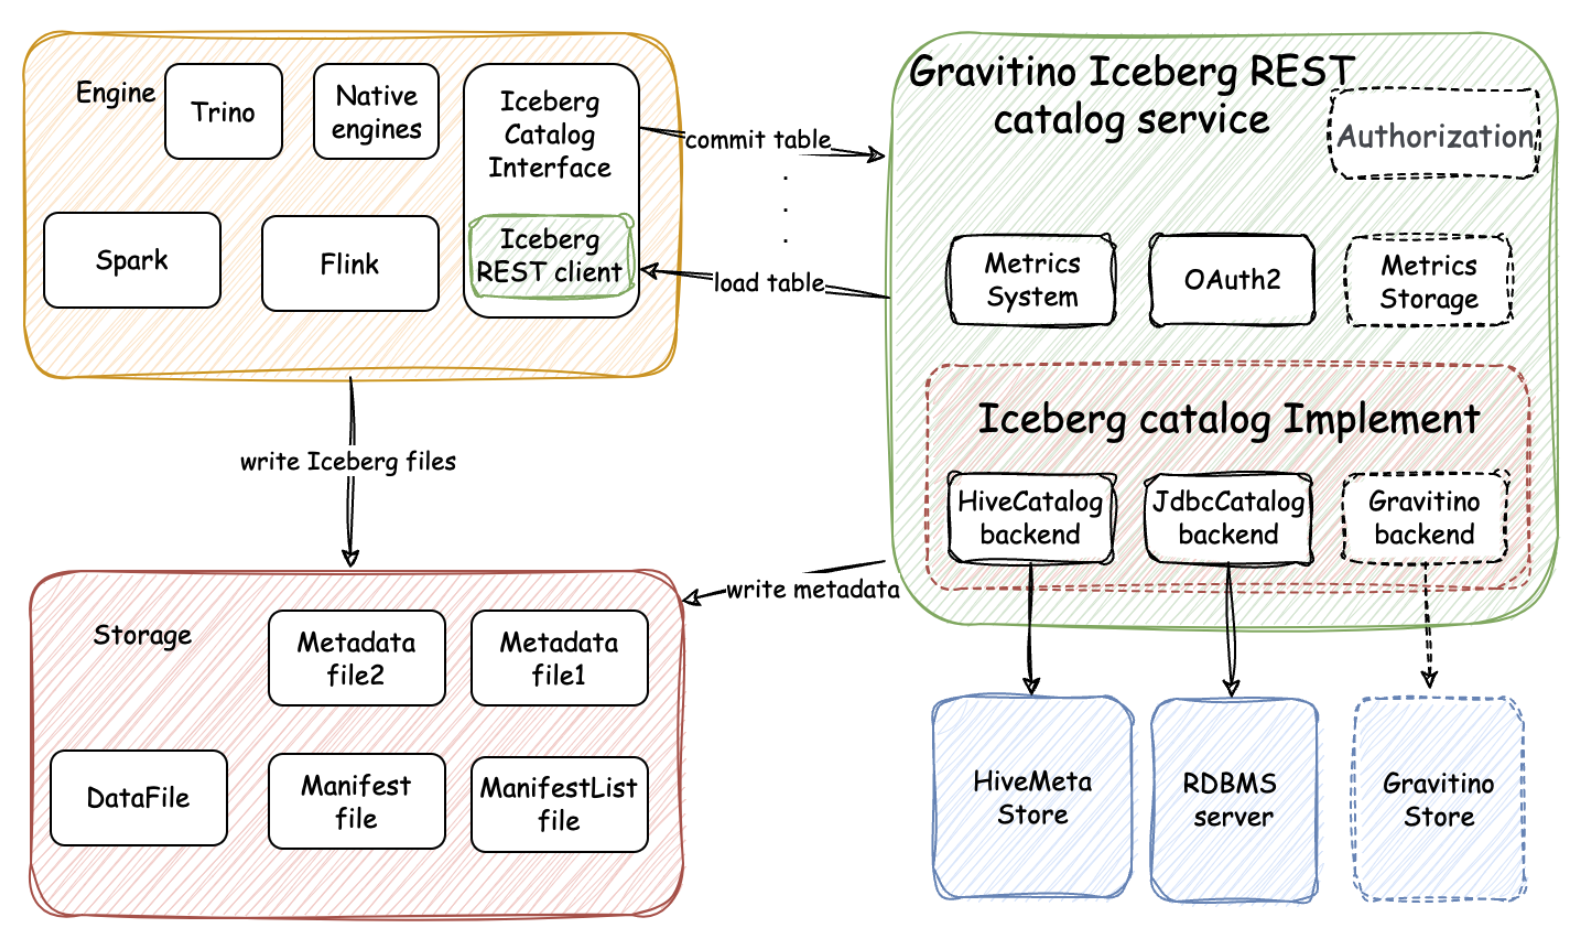
Что такое Iceberg и зачем нужен каталог
Iceberg — это открытая автономная таблицная формат-архитектура для больших данных, которая хранит данные в колонно-ориентированном виде и ведёт согласованную версию (snapshots) данных. Основная идея Iceberg — разделить физическое место хранения данных и метаданные таблицы, чтобы обеспечить эффективное чтение, масштабируемость и поддержку сложной эволюции схем и partitioning. Каталог в Iceberg — это механизм, который хранит ссылки на базы данных, таблицы и их параметры, а также хранит соответствие между именами и местоположением файлов в хранилище. В Iceberg есть несколько реализаций каталогов: HadoopCatalog, HiveCatalog (через Hive Metastore), GlueCatalog (через AWS Glue Data Catalog) и другие camel-каталоги. GlueCatalog является особенно удобным в контексте AWS, когда вы хотите централизовать метаданные и единообразно ими управлять.
GlueCatalog — что это и как он работает
GlueCatalog — это реализация Iceberg Catalog, которая использует AWS Glue Data Catalog в качестве центрального хранилища метаданных. AWS Glue Data Catalog (GDC) — это управляемый сервис метаданных, который хранит схемы баз данных, таблиц и параметры их хранения. Iceberg в GlueCatalog хранит свою схему, список столбцов, типы данных, пути к данным и другие свойства в Glue Data Catalog. При этом сами данные таблиц Iceberg по-прежнему хранятся в объектном хранилище (например, S3, HFS, MinIO и т. п.). GlueCatalog обеспечивает доступ к этим данным через единый интерфейс Iceberg и позволяет использовать Glue Data Catalog как единый реестр для разных проектов и инструментов.
Архитектура Glue Data Catalog в контексте Iceberg выглядит так: Iceberg — это клиент, который читает и обновляет метаданные Iceberg через Glue Data Catalog. Glue хранит базу данных и таблицы, Iceberg хранит версионную структуру таблиц (манифесты, snapshot’ы, схемы) и физические данные, которые лежат в хранилище. Влияние на разработку и операции оказывает то, что многие сервисы AWS могут работать с Glue Data Catalog напрямую, а Iceberg обеспечивает удобство чтения/записи и прослеживаемость изменений.
Преимущества GlueCatalog
- Единый источник правды: для Big Data-подразделения в рамках AWS Glue Data Catalog можно держать все таблицы Iceberg в одном месте, независимо от того, кто и где выполняет операции (Spark, Flink, Trino и т. п.).
- Интеграция с AWS-сервисами: Glue Data Catalog хорошо интегрируется с Athena, EMR, Redshift Spectrum и другими сервисами AWS, что позволяет строить конвейеры и аналитические задачи без сложной интеграции между инструментами.
- Управление доступом: через IAM и политики Glue можно централизованно управлять доступом к метаданным.
- Версии и эволюция схем: Glue Catalog поддерживает эволюцию схем Iceberg и отслеживание версий таблиц.
- Консистентность и безопасность метаданных: AWS умеет обеспечивать надёжное хранение и аудит изменений в метаданных.
Ограничения и риски GlueCatalog
- Зависимость от облака AWS: GlueCatalog привязан к AWS и региональной инфраструктуре. В случаях, когда данные должны строго локализоваться в РФ или в другой публичной облачной среде, GlueCatalog может быть неприемлемым выбором или потребует сложной архитектуры гибридного решения.
- Стоимость и провайдинг: Glue Data Catalog — платный сервис. При больших объёмах метаданных и частых обновлениях стоимости могут накапливаться. Кроме того, некоторые операции могут иметь лимиты по частоте запросов (API rate limits) и по одновременному доступу.
- Зависимость от сети к AWS: задержки вызовов к Glue Catalog зависят от сетевой доступности и латентности к регионам AWS. В некоторых случаях это может повлиять на скорость миграций и обновлений схем.
- Миграции и совместимость: переход с GlueCatalog на другой каталог может потребовать перенастройки конвейеров и миграции метаданных. В случае потребности в кросс-региональной репликации Glue Data Catalog предоставляет механизмы репликации в другие регионы, но они потребуют дополнительных затрат и проектирования.
- Специфичность к инструментарию: хотя GlueCatalog поддерживается несколькими движками (Spark, Flink, Trino и пр.), конкретные версии и интеграции должны проверяться на совместимость с используемой версией Iceberg и инструментами.
Сравнение типов каталогов
- GlueCatalog (AWS Glue Data Catalog): централизованный сервис метаданных в AWS, идеален для инфраструктурной архитектуры на AWS. Ограничение — привязка к AWS и возможное увеличение затрат; преимущество — тесная интеграция с экосистемой AWS.
- HiveCatalog (Hive Metastore): локальная или управляемая Hive Metastore, может размещаться в вашем дата-центре, на локальном кластере или в Kubernetes. Преимущество — гибкость и соответствие требованиям локализации; риск — администрирование, масштабирование и высокая стоимость поддержки.
- HadoopCatalog: проще по архитектуре, но менее распространён в современных архитектурах Iceberg, потому что требует локального хранения и не поддерживает такие же обширные механизмы эволюции, как HiveCatalog или GlueCatalog.
- Другие каталоги: иногда в рамках специализированных решений встречаются каты, интегрированные с конкретной экосистемой (например, через JDBC к сторонним реестрам) — чаще как обходные пути, чем как основной способ.
Термины и базовые понятия (для закрепления)
- Каталог (Catalog): слой, который регистрирует базы данных и таблицы Iceberg и обеспечивает доступ к ним через интерфейс выбранного движка (Spark, Flink, Trino и т. п.).
- База данных (Database) и таблица (Table) Iceberg: логические сущности для организации данных. Таблица Iceberg включает схему, разделы (partitions), манифесты и версии данных.
- Метаданные Iceberg: информация о схеме, разделах, столбцах и версиях. Хранится в каталоге и дополнительно в файлах данных Iceberg.
- Glue Data Catalog: сервис AWS, который хранит метаданные баз данных и таблиц.
- Миграция схем: процесс эволюции схемы таблиц без потери совместимости с существующими данными.
- Файлы данных и путь к ним: данные Iceberg physical files обычно хранятся в объектном хранилище (S3, ADLS, GCS и т. п.).
- Версии (snapshots): Iceberg сохраняет версии данных, позволяя откатываться к конкретной точке времени и отслеживать изменения.
Методологии внедрения GlueCatalog
- Определение требований: решите, нужен ли GlueCatalog в рамках AWS и соответствует ли политика безопасности вашего бизнеса. Оцените требования к локализации данных, доступу, аудитам и затратам.
- Выбор стека инструментов: GlueCatalog хорошо сочетается с Spark, Flink и Trino. Определите, какие движки вы будете использовать в целях аналитики, потоков данных и интерактивных запросов.
- Архитектурные принципы: разделение хранилища данных и метаданных по разным слоям, централизованный доступ к метаданным и возможность совместного использования таблиц из разных приложений.
- Проектирование схемы каталогов: продумайте схему именования баз данных и таблиц в Glue Data Catalog. Введите правила именования, версиирования и эволюции схем.
- Безопасность и доступ: настройте IAM-политики, роли и политики для сервисов, которые будут обращаться к Glue Catalog и к данным. Включите контроль доступа для чтения/записи к метаданным и к данным.
- Производительность: учитывайте задержки при обращении к Glue Data Catalog; используйте кэширование на уровне приложений и настройку параллельности запросов к Glue Catalog.
- Мониторинг и аудит: используйте доступные сервисы AWS (CloudWatch, CloudTrail) для аудита использования Glue Data Catalog, мониторинга задержек и ошибок.
- Резервное копирование и восстановление: планируйте бэкап конфигураций каталогов, миграцию между регионами (при необходимости) и сценарии отказоустойчивости, включая репликацию метаданных.
Практические примеры
Open-source стек: Spark + Iceberg + GlueCatalog (AWS)
Контекст: компания размещает обработку датасетов на AWS, использует Apache Spark для пакетной обработки и анализа, а метаданные Iceberg — в Glue Data Catalog. Данные хранятся в S3. Это позволяет единообразно управлять таблицами Iceberg и использовать Glue Data Catalog как централизованный реестр.
Шаги внедрения (практический ориентир)
Подготовка аккаунта AWS и Glue Data Catalog
- Создать Glue Data Catalog в нужном регионе.
- Создать базу данных в Glue Data Catalog, например glace_db.
- Назначить IAM-ролям доступ к Glue Data Catalog и к S3 с данными.
Настройка Spark для использования GlueCatalog
В начале сессии Spark:
- Указать SparkCatalog как GlueCatalog:
      spark.sql.catalog.glue = org.apache.iceberg.spark.SparkCatalog
      spark.sql.catalog.glue.type = glue
      spark.sql.catalog.glue.glue.catalog-id = "123456789012"  (AWS account id)
spark.sql.catalog.glue.warehouse = s3://iceberg-warehouse/ (путь к хранилищу для данных Iceberg)- Пример командной строки:
    spark.sql("CREATE TABLE glue glace_db.my_table (id int, name string) USING ICEBERG")
    spark.sql("ALTER TABLE glace_db.my_table ADD COLUMN age int")  // пример эволюции
Работа с таблицами
- Запросы через Spark:
spark.sql("SELECT * FROM glace_db.my_table WHERE id = 1")- Запись данных:
df.write.format("iceberg").mode("append").saveAsTable("glace_db.my_table")
Мониторинг и администрирование
- Логирование через CloudWatch и Glue Data Catalog API.
- Отслеживание задержек и квот Glue Data Catalog.
Open-source стек: Flink + Iceberg + GlueCatalog
Контекст: потоковая обработка с использованием Flink. Glue Data Catalog хранит метаданные, Iceberg управляет таблицами, данные — в S3. Привлекательность: Flink обеспечивает низкую задержку обработки и поддержку микро-пакетов.
Шаги внедрения
Конфигурация среды
- Настройка клиента AWS в окружении кластера Flink.
- Конфигурация Iceberg для GlueCatalog в приложении Flink.
Пример кода (Java/Scala) для потоковой записи
Включите Iceberg Flink соединение и укажите GlueCatalog в конфигурации, например:
    Properties props = new Properties();
    props.setProperty("iceberg.catalog", "org.apache.iceberg.spark.SparkCatalog");
    props.setProperty("iceberg.catalog.glue.type", "glue");
    props.setProperty("iceberg.catalog.glue.catalog-id", "123456789012");
    props.setProperty("iceberg.catalog.glue.warehouse", "s3://iceberg-warehouse/");
Реализация стрима с записью в Iceberg таблицу и чтение из неё.
Пример чтения
  DataStream<Row> stream = env.fromSource(...);
  stream.addSink(...), где путь к Iceberg таблице определяется через GlueCatalog.
Trino/Presto и GlueCatalog
Контекст: аналитика через интерактивные запросы в кластере Triо/Presto. GlueCatalog может использоваться как метаданные Iceberg, чтобы обеспечивать кросс-платформенный доступ к одной и той же таблице через интерактивные SQL-запросы.
Шаги конфигурации
Конфигурация каталога Iceberg в Trino:
В файле catalog/glue.properties:
    connector.name=iceberg
    iceberg.catalog=glue
    iceberg.glue.catalog-id=123456789012
    iceberg.glue.warehouse=s3://iceberg-warehouse/
Пример запросов:
  SELECT * FROM glace_db.my_table WHERE id = 42;
  INSERT INTO glace_db.new_table VALUES (1, 'data');
Российские решения и альтернативы GlueCatalog
Российские и локальные подходы к управлению метаданными Iceberg чаще ориентированы на Hive Metastore (HMS) как локальный или частный каталог. Причины включают требования локализации данных, контроль над инфраструктурой, юридические и регуляторные ограничения. Практически это выглядит так:
Hive Metastore (HMS) в локальном кластере
- Iceberg может использовать HMS в качестве каталога, позволяя работать без зависимости от облачных сервисов.
- Преимущества: локализация, независимость от AWS, гибкость административного контроля.
- Применимо к: локальные дата-центры, гибридные облака и российские облачные провайдеры, использующие HMS.
Специализированные локальные решения на базе HMS
- Контейнеризация HMS в Kubernetes (K8s HMS), интеграция с Iceberg через Spark/Flink/Trino.
- Преимущества: управляемость, мониторинг, совместная работа с существующими инструментами в российском стеке.
- Ограничения: необходимость администрирования кластера HMS и обеспечения масштабирования.
Гибридные конфигурации
- В некоторых случаях возможно использовать GlueCatalog как метаданные, но хранить данные на российском объектном хранилище (локальные решения, отечественные облачные провайдеры) через совместимый интерфейс S3-совместимого хранилища, что требует проверки совместимости и сетевых ограничений.
- При этом GlueDataCatalog может быть недоступен в рамках российского юрисдикции; гибридная архитектура требует особо продуманной стратегии безопасности и доступов.
Российские инфраструктурные практики
- Локальные кластеры Spark/Flink с HMS: база данных и таблицы Iceberg регистрируются в HMS, данные — в локальном объектном храниле или в локальном HDFS/ADLS-подобном слое.
- Архитектурные паттерны: единый доступ к данным через Spark/Flink, централизованный контроль доступа, локализация ключей шифрования, аудит и соответствие требованиям регуляторов.
Практические примеры в российских условиях
Пример 1: локальная HMS и Iceberg
Архитектура: локальный дата-центр, HMS в Kubernetes, Iceberg таблицы участвуют через Spark и Flink, данные в локальном хранилище (HDFS/NFS) или в отечественном объектном хранилище.
Преимущества: соблюдение локализации, контроль над инфраструктурой, отсутствие зависимости от AWS.
Ограничения: требует админ-ресурсов на поддержание HMS, обновления, мониторинг.
Пример 2: гибридная архитектура с Hive Metastore и Cloud-ресурсами
Архитектура: HMS в частном дата-центре, Glue Catalog может использоваться для некоторых проектов, где есть законные основания для работы в AWS, но основная работа по данным выполняется в локальных сервисах.
Преимущества: возможность распределённых вычислений и совместное использование данных.
Ограничения: сложная интеграция и требования к сетевым каналам между регионами и провайдерами.
Пример 3: открытые решения и российские вендоры
Открытые инструменты Spark/Flink с HMS в локальном кластере, поддержка Iceberg и Glue Catalog через адаптации к HMS.
Практическая польза: исследование и пилоты в рамках научно-образовательных проектов, локальные соответствия требованиям.
Настройка окружения и инфраструктуры
Общие требования
- Iceberg версия, поддерживающая GlueCatalog (проверьте совместимость версий Spark/Flink/Trino с вашей версией Iceberg).
- AWS-аккаунт и Glue Data Catalog в регионе, доступный из вашего сетевого окружения.
- Объектное хранилище (S3 или совместимое) для данных Iceberg.
- Правильные IAM-политики и роли: доступ на чтение/запись к Glue Data Catalog и к бакету с данными.
- Сетевые требования: разрешение доступа к Glue Data Catalog, минимизация задержек.
Конфигурация Spark для GlueCatalog
Пример конфигурации:
    spark.conf.set("spark.sql.catalog.glue", "org.apache.iceberg.spark.SparkCatalog")
    spark.conf.set("spark.sql.catalog.glue.type", "glue")
    spark.conf.set("spark.sql.catalog.glue.catalog-id", "123456789012")
    spark.conf.set("spark.sql.catalog.glue.warehouse", "s3://iceberg-warehouse/")
Пример создания таблицы:
spark.sql("CREATE TABLE glue glace_db.my_table (id INT, name STRING) USING ICEBERG")
Пример чтения:
spark.sql("SELECT * FROM glace_db.my_table").show()
Конфигурация Flink для GlueCatalog
В файл конфигурации Flink добавляем параметры:
    iceberg.catalog.glue.type: glue
    iceberg.catalog.glue.catalog-id: 123456789012
    iceberg.catalog.glue.warehouse: s3://iceberg-warehouse/
В коде указываем, что используем Iceberg как источник/плот IcebergTables через GlueCatalog.
Конфигурация Trino/Presto для GlueCatalog
В каталоге каталога Iceberg добавляем файл glue.properties:
    connector.name=iceberg
    iceberg.catalog=glue
    iceberg.glue.catalog-id=123456789012
    iceberg.glue.warehouse=s3://iceberg-warehouse/
Далее можно выполнять интерактивные запросы к Iceberg таблицам через Trino/Presto.
Безопасность и управление доступом
Управление доступом к метаданным
- Используйте IAM-политики для ролей, которые позволяют Glue Data Catalog и S3 (или другое хранилище) только необходимый набор действий (например, Glue:GetTable, Glue:GetDatabase, s3:GetObject, s3:PutObject).
- Разделение ролей по функциям: аналитика, инженеры по данным, администраторы.
Ключи и шифрование
- Используйте KMS для защиты ключей, шифрования данных и метаданных.
- Опционально — включение серверного шифрования на S3 и на Glue (если доступно).
Мониторинг и аудит
- Включите CloudWatch для монитора latency, ошибок и использования Glue Catalog.
- Включите CloudTrail для аудита вызовов к Glue Data Catalog и к S3.
Производительность и эксплуатация
Производительность доступа к метаданным
Glue Data Catalog имеет SLA и лимиты по запросам. При больших нагрузках применяйте параллельные запросы, кэширование в приложениях, а при необходимости — настройку повторных попыток и ретраев.
Эволюция схем
Iceberg поддерживает эволюцию схем. Используйте подход версионирования и обратной совместимости. В тестовой среде проверяйте миграцию схем перед применением в прод.
Уведомления и управление версиями
- Используйте процессы CI/CD для обновления схем Iceberg.
- Регулярно тестируйте миграции схем на тестовых данных.
Риски и ограничения
Зависимость от AWS и Glue Data Catalog
- В случае политик, локализации данных и регуляторных требований GlueCatalog может быть неприемлемым решением в российских условиях; тогда целесообразнее рассмотреть HMS или локальные каталог-решения.
Стоимость и квоты
- Траты на Glue Data Catalog и на запросы к нему могут быть существенными на больших объёмах запросов и частых изменениях метаданных.
Проблемы сетевой доступности
- В регионах с высокой задержкой или с ограничениями между вашей локальной сетью и AWS Glue могут возникать задержки и сбои.
Совместимость и миграции
- Миграция между каталогами может быть сложной и потребовать перенастройки процессов данных, миграционных сценариев и изменений в инфраструктуре.
Контроль версий
- Необходимо обеспечить надёжный контроль версий схем и процедур отката. Glue Data Catalog не всегда предоставляет простой механизм миграции между регионами без планирования и консолидации.
Риск vendor lock-in
- При использовании GlueCatalog вы зависите от AWS. Это следует учитывать в стратегиях долгосрочной архитектуры.
GlueCatalog — мощный инструмент для централизованного управления метаданными Iceberg в среде AWS. Он обеспечивает единый реестр таблиц, тесную интеграцию с AWS-сервисами и управляемые метаданные. Однако, как и любой выбор архитектурного решения, GlueCatalog требует внимательного анализа требований к локализации данных, к затратам, к регуляторным ограничениям и к архитектуре интеграций. В рамках российского рынка часто встречаются альтернативы на базе Hive Metastore или локальных HMS-решений, которые обеспечивают локализацию данных и более гибкую админ-модель. В зависимости от контекста вашей компании можно выбрать GlueCatalog как основной вариант для AWS-ориентированной инфраструктуры, или рассмотреть HMS как локальную или гибридную альтернативу. В любом случае важно спроектировать архитектуру заранее, задокументировать политики доступа и план миграций, а также провести пилоты, чтобы проверить поведение каталога в реальных условиях.
Вопрос–Ответ (FAQ)
1) Что такое GlueCatalog и чем он отличается от HiveCatalog?
GlueCatalog — каталожная реализация Iceberg, которая использует AWS Glue Data Catalog в качестве метаданных. HiveCatalog использует Hive Metastore в качестве метаданных. Основное различие — GlueData Catalog хранится в AWS и интегрирован с AWS-сервисами, а Hive Metastore может быть локальным или размещённым в любом дата-центре (напрямую в вашем кластере). GlueCatalog подходит для инфраструктур AWS и упрощает сотрудничество между сервисами, тогда как HMS даёт больше гибкости в локальной среде и гибридных сценариях.
2) Какие основные преимущества использования GlueCatalog в Iceberg?
Ключевые преимущества: единый реестр метаданных, тесная интеграция с AWS сервисами (Athena, EMR, Redshift и т. д.), аудит и контроль доступа через IAM, поддержка эволюции схем Iceberg и версионирования, упрощённая кооперация между разными инструментами в рамках AWS. Кроме того, Glue Data Catalog предоставляет управление таблицами без необходимости держать собственный HMS.
3) Какие риски связаны с GlueCatalog в условиях российского законодательства?
Главный риск — привязка к AWS и зависимость от сетевой доступности к региону AWS, а также вопросы локализации данных и регуляторных требований. В таких условиях организации часто переходят на локальные HMS-решения (Hive Metastore) или разворачивают гибридные архитектуры с локальным HMS и в отдельности Glue Catalog для специфических проектов. В любом случае необходима тщательная оценка соответствия требованиям к локализации, аудиту и доступу к данным.
4) Как настроить GlueCatalog в Spark?
Общая процедура: 1) подготовить AWS-контекст и Glue Data Catalog; 2) в Spark установить конфигурацию: spark.sql.catalog.glue = org.apache.iceberg.spark.SparkCatalog; spark.sql.catalog.glue.type = glue; spark.sql.catalog.glue.catalog-id = "123456789012"; spark.sql.catalog.glue.warehouse = "s3://iceberg-warehouse/"; 3) создать таблицу через DDL: CREATE TABLE glace_db.my_table USING ICEBERG; 4) читать и записывать через стандартные операции Spark с использованием Iceberg. В зависимости от версии Iceberg и Spark команды могут незначительно варьироваться, поэтому рекомендуем сверяться с документацией конкретной версии.
5) Могут ли работать GlueCatalog и локальное хранилище данных в гибридной архитектуре?
Да, можно построить гибридную архитектуру: GlueCatalog как реестр метаданных для таблиц Iceberg, размещённых в AWS (S3) и/или локальном хранилище. Однако для такого подхода нужно согласовать политики доступа, сетевые маршруты и совместимость версий инструментов. Внутренняя логика Iceberg остаётся одной и той же, но нужно удостовериться, что ваши инструменты (Spark, Flink, Trino) правильно обрабатывают путь к данным и метаданные через Glue Catalog в смешанной среде.
6) Какие альтернативы GlueCatalog существуют в российских условиях?
Наиболее типичной альтернативой является Hive Metastore (HMS) в локальном или частном облачном окружении. HMS позволяет держать метаданные внутри российского дата-центра и обеспечивает локализацию данных. Также можно рассмотреть гибридные схемы, где часть каталога — HMS, часть — GlueCatalog, в зависимости от регуляторных требований и архитектурных ограничений. В любом случае, перед внедрением важно проверить совместимость версий Iceberg и ваших движков (Spark, Flink, Trino).
7) Как управлять эволюцией схем в GlueCatalog?
Iceberg поддерживает эволюцию схем, а GlueCatalog хранит метаданные об изменениях в Glue Data Catalog. Чтобы управлять эволюцией: планируйте изменение схем в тестовой среде, применяйте версионирование таблиц, применяйте миграции к таблицам через DDL команды Iceberg (например, ADD COLUMN, CHANGE COLUMN) и следите за совместимостью чтения/записи. Важно держать документацию доступной и иметь тестовый набор, чтобы проверить обратную совместимость на продакшн-данных.
8) Какие практики безопасности особенно важны при GlueCatalog?
Важны: управление ролями и политиками IAM, минимизация привилегий (principle of least privilege), шифрование данных и метаданных с использованием KMS, аудит доступа к Glue Data Catalog и к данным, а также безопасность сетевых подключений (VPC, приватные сервисы, IAM Roles for Service Accounts). Настроить мониторинг и оповещения по подозрительным действиям — это часть устойчивого управления.
9) Что делать, если Glue Catalog недоступен или есть задержки?
Проверьте сетевые пути, задержки к Glue Data Catalog и лимиты по API. Рассмотрите возможность кэширования на уровне клиента (Spark/Flink), параллелизацию запросов к Catalog и использование репликаций в рамках региона (если поддерживается). В случае длительных задержек можно рассмотреть временный переход на HMS (локальный каталог) для критичных процессов, пока Glue Catalog недоступен.
10) Какие шаги для миграции с GlueCatalog на HMS или обратно?
- Оценить совместимость версий и требований по данным.
- Спроектировать миграцию метаданных: экспорт схем, таблиц, partitioning; возможно, потребуется создание зеркал в HMS.
- Пошагово мигрировать данные и метаданные: создать новые HMS-таблицы, перенести данные, обновить конфигурации клиентов и конвейеров на новый каталог, проверить целостность и тестовую выборку.
- Верифицировать процессы чтения и записи, провести нагрузочное тестирование.
- Удалить старый каталог после полной проверки и документирования процесса.
GlueCatalog — мощное решение для организаций, работающих в рамках AWS, которое обеспечивает единый, управляемый реестр метаданных Iceberg и тесную интеграцию с экосистемой AWS. Он упрощает управление также и использованием таблиц Iceberg в разных сервисах и языках. Однако он не универсален, особенно в контексте российского законодательства и локализации данных. В таких условиях гибридные архитектуры на базе HMS и Iceberg часто оказываются более приемлемыми. В любом случае выбор типа каталога следует выполнять на основе регуляторных требований, инфраструктурной стратегии и бизнес-целей. Прежде чем внедрять GlueCatalog, рекомендуется провести пилотный проект, чтобы понять производительность, затраты и требования к безопасному доступу в вашей конкретной среде.
Вопрос–Ответ (FAQ) ч. 2
1) Что именно хранится в Glue Data Catalog в контексте Iceberg?
Glue Data Catalog хранит метаданные Iceberg: базы данных и таблицы Iceberg, их схемы, настройки хранения, свойства таблиц, версии (snapshots) и параметры эволюции схем. Iceberg же хранит в объектном хранилище сами данные и файлы манифестов. Glue Catalog обеспечивает единый реестр для всех клиентов Iceberg в рамках соответствующего AWS-окружения.
2) Какие преимущества GlueCatalog по сравнению с хранением метаданных в локальном HMS?
GlueCatalog даёт управляемость на уровне облака AWS, интеграцию с множеством AWS-сервисов и централизованный доступ к метаданным. HMS — лучше с точки зрения локализации данных, независимости от облака и гибкости в частном окружении. Выбор зависит от регуляторных требований и архитектурной стратегии: для AWS-ориентированных проектов GlueCatalog — естественный выбор; для локальных и гибридных инфраструктур HMS может быть предпочтительнее.
3) Как выбрать между GlueCatalog и HMS для проекта Iceberg?
Определитесь с требованиями к локализации, аудитам и доступу к данным, а также с затратами. Если данные и метаданные будут обрабатываться в AWS и требуется тесная интеграция с сервисами AWS, GlueCatalog — разумный выбор. Если локализация данных критична и вы хотите держать всю инфраструктуру в собственном дата-центре, HMS (локальная или приватная инфраструктура) — предпочтительнее. Также можно рассмотреть гибридную архитектуру, где в целом применяется HMS, а GlueCatalog используется для отдельных проектов в AWS.
4) Какие основные шаги при внедрении GlueCatalog в новый проект?
- Оценка требований и регуляторных ограничений.
- Развертывание Glue Data Catalog в нужном регионе.
- Настройка IAM-политик и доступа к S3/другим хранилищам.
- Настройка Spark/Flink/Trino для использования GlueCatalog.
- Создание баз данных и таблиц в Glue Data Catalog.
- Построение конвейеров обработки и аналитики.
- Мониторинг, логирование и аудит.
- Плавный переход и миграция существующих таблиц.
5) Что делать, если GlueCatalog недоступен или имеет задержку?
Проведите скорректированную диагностику сетевых путей, Latency к сервису Glue Data Catalog, проверьте лимиты и квоты API. Возможно, стоит временно перейти на локальный HMS, пока Glue Catalog не вернёт доступность, а затем вернуться к Glue Catalog после устранения причин. В дальнейшем можно внедрить резервирование, репликацию метаданных в другой регион или кэширование часто используемых запросов к каталогу.
6) Какую роль играет безопасность в GlueCatalog?
Безопасность — критическая. Нужны строгие IAM-политики и роли, ограничение доступа по принципу наименьших привилегий, шифрование данных и метаданных (KMS), аудит и мониторинг вызовов к Glue Data Catalog и к данным, а также сетевые меры защиты (VPC, приватные эндпойнты и т. п.). Включение мониторинга и оповещений — важная часть устойчивости.
7) Можно ли мигрировать существующие Iceberg-таблицы в GlueCatalog?
Да, можно, но потребуется план миграции: экспорт метаданных из существующего каталога, создание аналогичных таблиц в Glue Data Catalog, перенести данные и адаптировать конвейеры. Важно провести тестовую миграцию на ограниченном наборе таблиц и проверить совместимость запросов. В некоторых сценариях миграции с минимальными изменениями можно достигнуть через создание зеркал таблиц и постепенное перенаправление клиентов.
8) Какие практические ограничения стоит учитывать в GlueCatalog?
- Зависимость от AWS и региональной инфраструктуры.
- Стоимость операций с Glue Data Catalog.
- Возможные задержки в доступе к метаданным при больших нагрузках.
- Регуляторные ограничения по локализации данных.
- Необходимость поддержки квалифицированных специалистов для администрирования Glue Catalog и связанных сервисов.
9) Как GlueCatalog влияет на аналитические и потоковые конвейеры?
GlueCatalog обеспечивает единый путь к метаданным, что упрощает координацию между разными стейкхолдерами и инструментами. Это облегчает совместное использование таблиц между Spark, Flink и Trino. В потоковых конвейерах Glue Catalog упрощает настройку и аудит версий данных, что важно для воспроизводимости и соответствия требованиям.
10) Что полезно проверить перед запуском пилотного проекта GlueCatalog?
- Совместимость версий Iceberg, Spark/Flink/Trino и Glue Data Catalog.
- Наличие и корректность IAM-ролей и политик для доступа к Glue Catalog и к данным.
- Настройки сетевого доступа и доступность региона AWS.
- Правильная конфигурация пути к данным (warehouse) и схемы именования.
- Наличие тестового набора данных и сценариев чтения/записи для проверки эволюции схем.
- План мониторинга, аудита и управления изменениями.
Задача главы выполнена: даны теоретические основы Type Iceberg GlueCatalog, практические примеры из open-source и российского стека, технические детали реализации и безопасность, риск-обзор и финальные выводы, завершён блок FAQ с семью вопросами и развёрнутыми ответами.


