

Установка и настройка HadoopCatalog
Цель данной главы – дать четкое и понятное руководство по установке и настройке HadoopCatalog в рамках курса Настройка и использование каталогов для Iceberg Lakehouse. Мы говорим с новой командой: вы пришли работать с Iceberg и должны понять, зачем нужен HadoopCatalog, какие преимущества он дает в простых условиях и почему в некоторых случаях его использование может быть ограничено. HadoopCatalog – это реализация каталога Iceberg, которая хранит метаданные и структуру таблиц прямо в файловой системе, поддерживаемой Hadoop (HDFS или любой совместимый файловый сервис). В отличие от метастора Hive или REST-/catalog-у, HadoopCatalog не требует внешнего метастора и управляет таблицами на уровне файловой системы. Этот подход прост и инвариантен к сетевым задержкам, но имеет ограничения при большом числе таблиц и сложной мультикластерной архитектуре.
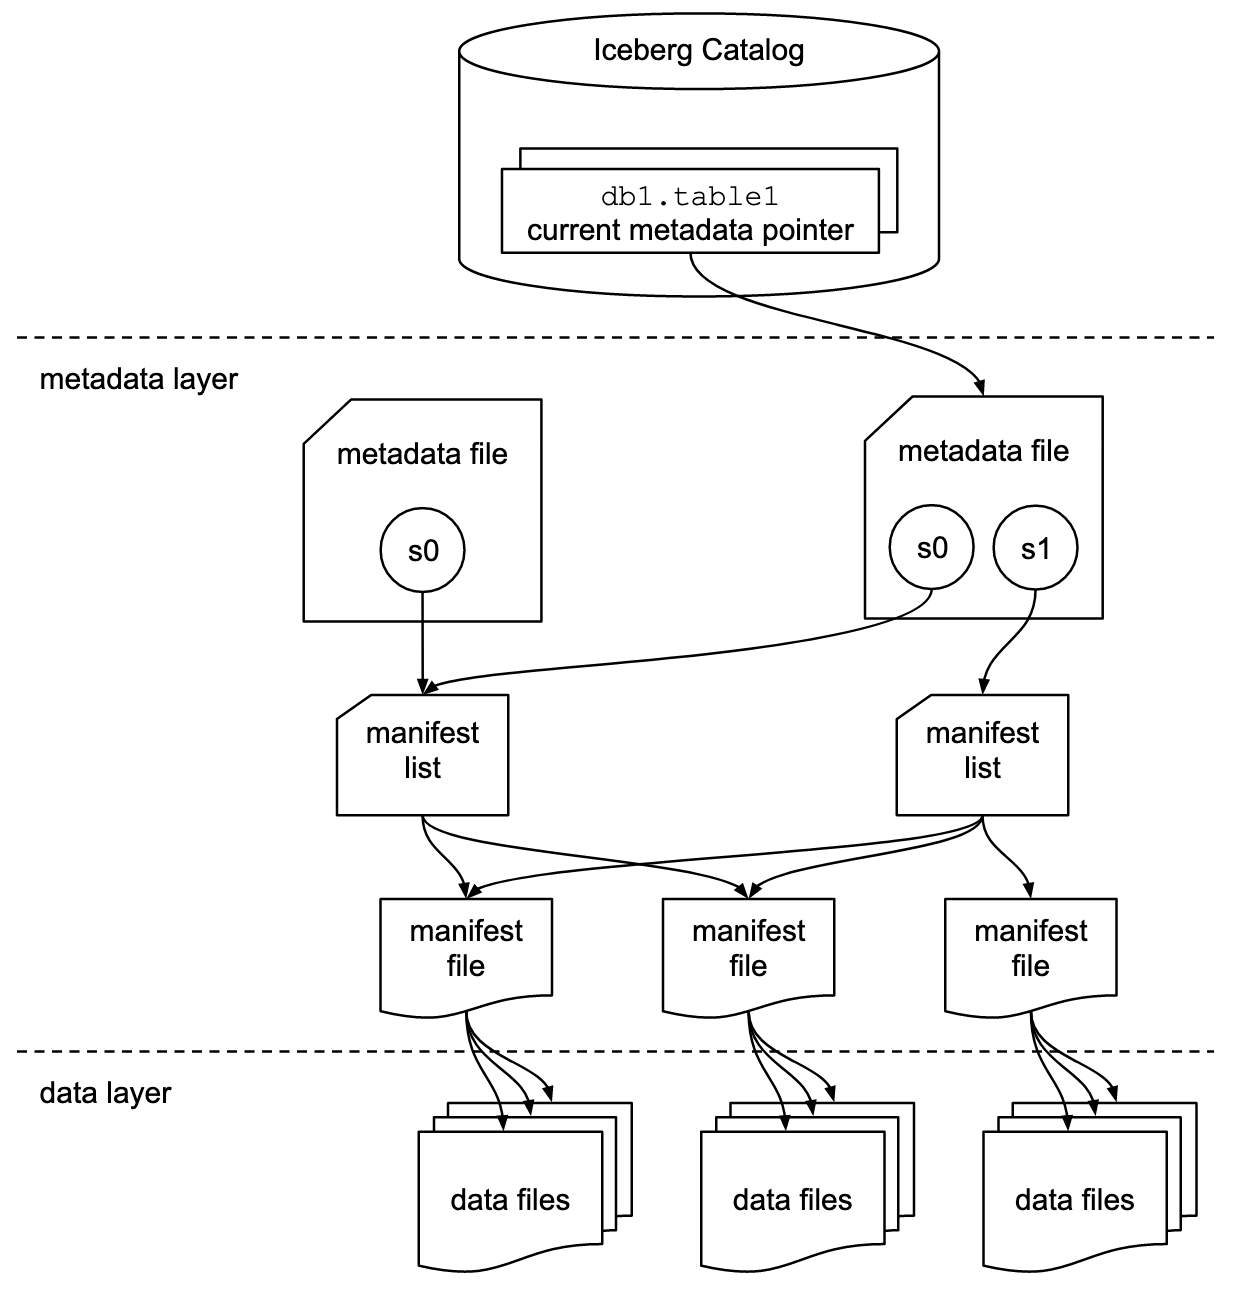
Что такое Iceberg каталог и чем отличается HadoopCatalog
Iceberg использует концепцию каталогов (catalogs) для организации доступа к таблицам. Каталог – это слой, который отвечает за поиск, создание и загрузку таблиц по имени (TableIdentifier). Основные типы каталогов в Iceberg: HiveCatalog, HadoopCatalog, REST Catalog и др. HadoopCatalog работает на основе файловой системы, где корневой путь каталога задается как точка входа. В этом корневом пути Iceberg хранит структуру каталогов для баз данных, таблиц и их метаданных.
Ключевые термины
- Таблица Iceberg (Table): логическая структура данных со схемой (Schema), разделением на разделы (PartitionSpec) и набором файлов данных и метаданных.
- Метаданные Iceberg: серия файлов в каталоге таблицы, включая фреймворк Snapshot, Manifest файлов и Metadata файла. Метаданные эволюционируют по мере изменений таблицы.
- Metadata файлы: содержат снимки состояния таблицы, список манифестов и указания на данные-файлы. Архитектура разделена на несколько уровней: metadata, manifests, data files.
- HadoopCatalog: реализация каталога Iceberg на основе Hadoop FileSystem. Хранит все данные и метаданные таблиц в файловой системе по заданному корню.
- Хранение файлов: в HadoopCatalog данные и метаданные хранятся прямо в директориях таблицы, например /iceberg/catalog/db/table/metadata и /iceberg/catalog/db/table/data.
Когда применять HadoopCatalog
- Простые окружения без внешнего метастора: если у команды нет потребности в глобальном метасторе и необходимо быстро развернуть каталоги без сложной инфраструктуры.
- Низкая скорость изменений числа таблиц: когда количество таблиц не стремительно растет и отсутствуют требования к глобальному управлению схемой.
- Корпоративная инфраструктура с большой долей локальных данных и ограниченным сетевым трафиком между кластерами.
- Необходимость автономности каталогов: независимая работа кластера, возможность копирования каталога между окружениями без синхронной настройки мetastore.
Общие принципы работы HadoopCatalog
- Корневой путь каталога задает базовую директорию, в которой Iceberg хранит таблицы и их метаданные.
- Все операции (создание, загрузка, удаление таблиц) осуществляются через API Iceberg Catalog и требуют согласованности файловой системы.
- Нет внешнего метастора; управление схемой и структура таблицы осуществляется через директории и файлы в файловой системе.
- Безопасность и доступы: для Biden-кластеров с Kerberos и TLS требуется корректная настройка аутентификации и Authorization на уровне HDFS.
- Масштабирование: при большом числе таблиц возможно ухудшение времени скана каталогов и интенсивность операций на метаданных; для крупных бизнес-слоев чаще выбирают HiveCatalog или REST Catalog.
Риски и ограничения HadoopCatalog
- Масштабирование: при большом объеме таблиц у HadoopCatalog может ухудшаться производительность операций навигации по каталогу и обновлениях метаданных.
- Нет глобального метастора: неудобно в средах с несколькими кластерами и требованием консистентного мульти-каталога. Подобное ограничение требует синхронизации вручную.
- Безопасность: все таблицы и их метаданные доступны через файловую систему; требует строгих политик доступа, Kerberos и ACL.Необходимо планировать бэкапы критических каталогов.
- Релокации и миграции: перенос каталога или переход на другой тип каталога может быть сложен и потребовать миграционных шагов.
- Управление правами и версионирование: если в процесс вовлечены разные среды, нужно обеспечить единообразие версий Iceberg и совместимость форматов metadata vX.
- Ограниченная поддержка функций HadoopCatalog в некоторых средах Spark/Flink: в некоторых интеграциях готовые коннекторы могут требовать дополнительных конфигураций.
- Совместимость с безопасными репозиториями: если предприятие использует централизованные репозитории и политическую политику, необходимо учесть требования к сертификатам и прокси.
Сценарии совместимости и сравнение с HiveCatalog
- HiveCatalog использует Hive Metastore или аналогичный внешний метастор для хранения метаданных таблиц. Это обеспечивает централизованное управление схемами и быстрый доступ к информации, особенно когда число таблиц велико и нескольких кластеров есть множество. HiveCatalog хорошо масштабируется, но требует доступности Hive Metastore и корректной настройки сети.
- HadoopCatalog проще в настройке, не требует внешнего метастора, но ограничен конкретной файловой системой и может быть менее удобен в мультикластерной среде.
- В сценариях с ограниченными сетями, автономности и минимальным количеством таблиц HadoopCatalog может быть предпочтительным.
Практические принципы эксплуатации
- Планирование структуры каталога: заранее определить корневой путь каталога, правила именования баз данных и таблиц, политику доступа.
- Мониторинг и аудит: важно внедрить мониторинг состояний каталога и источников ошибок в журналах, чтобы быстро обнаруживать проблемы с доступом к файловой системе.
- Резервное копирование: следует регулярно копировать каталоги Iceberg на уровне файловой системы, чтобы обеспечить восстановление при сбоях.
- Управление версиями Iceberg: следить за версиями форматов metadata и совместимостью версий Iceberg между компонентами.
prerequisites и инфраструктура
- Необходимые компоненты: Java Runtime (совместимо с используемой версией Iceberg), Apache Hadoop или совместимый файловый сервис, доступ к файловой системе (HDFS или локальная файловая система в рамках тестов).
- Безопасность: Kerberos, Kerberos-агент, Kerberos tickets, и настройка ACL на директориях каталога. Для защищенных сред требуется правильная настройка конфигурации Hadoop и Iceberg.
- Совместимость версий: используйте версии Iceberg, совместимые с вашим Hadoop-фреймворком (Spark/Flink). Проверьте требования к метаданным и форматам.
- Конфигурационные параметры HadoopCatalog: параметры зависят от среды и клиента Iceberg. Основное — указать корневой путь каталога и тип каталога как Hadoop.
Файловая структура и хранение метаданных
- Корневой каталог: /path/to/iceberg_catalog
- Структура таблиц: для каждой базы данных и таблицы Iceberg создает поддиректории. В каталоге таблицы присутствуют папки metadata, data (микро-уровни) и другие служебные файлы.
- Метаданные: файл Iceberg Metadata (metadata.json по умолчанию, вместе с версиями), набор Manifest файлов, Snapshot описывает текущее состояние таблицы, а Manifest List указывает на набор Manifest файлов, которые соответствуют конкретному Snapshot.
- Файлы данных: данные могут быть в формате Parquet/ORC/AVRO и сохраняются в data директориях таблицы.
Конфигурация и способы внедрения
Общая конфигурация: для Spring/Java-приложений, Spark или Flink-пайплайнов необходимо указать тип каталога и корневой путь, который будет использоваться Iceberg.
Пример конфигурации через Spark (Open-source подход)
1) Установить зависимости Iceberg и совместимой версии Hadoop/HDFS в проект.
2) Пример конфигурации в Spark:
- задать каталог: spark.sql.catalog.hadoop_catalog.type=hadoop
- задать корневой путь каталога: spark.sql.catalog.hadoop_catalog.warehouse=/iceberg/hadoop_catalog
- указать, что мы используем SparkCatalog: spark.sql.catalog.spark_catalog = org.apache.iceberg.spark.SparkCatalog
3) Создать таблицу через Spark SQL:
CREATE TABLE hadoop_catalog.default.sample_table (id int, name string) USING iceberg;4) Загрузить таблицу:
SELECT * FROM hadoop_catalog.default.sample_table;Примечание: точные параметры конфигурации зависят от версии Iceberg и среды (Spark/Flink). В документации Iceberg приведены актуальные примеры настроек под вашей версией.
Пример конфигурации через Java API (Open-source пример)
1) Создать конфигурацию Hadoop:
Configuration conf = new Configuration();- конфигурации Hadoop, например fs.defaultFS и Kerberos-related настройки, если кластер защищен.
2) Указать корневой путь каталога:
String rootPath = "/iceberg/catalog";3) Создать HadoopCatalog:
HadoopCatalog catalog = new HadoopCatalog(conf, rootPath);4) Определить схему и разделы:
     Schema schema = new Schema(...); (определение полей)
     PartitionSpec spec = PartitionSpec.unpartitioned();
5) Создать таблицу:
     TableIdentifier tid = TableIdentifier.of("default", "sample_table");
     Table table = catalog.createTable(tid, schema, spec);
6) Операции чтения/записи через API Iceberg:
     table.newAppend().appendFile(...).commit();
     Table loaded = catalog.loadTable(tid);
Пример миграции и управления версиями
- Если потребуется мигрировать существующую таблицу из другого каталога или формата, нужно убедиться, что структура таблицы совместима с текущей версией Iceberg.
- Миграцию можно выполнить через создание новой таблицы в HadoopCatalog и перенос данных или через миграцию структуры файлов, но это требует точной проверки совместимости метаданных и версий.
Практические примеры
Open-source решения
Пример 1: Open-source стек на базе Apache Iceberg, Spark и HadoopCatalog
Шаги:
1) Установить Hadoop и HDFS, подготовить кластер.
2) Установить Iceberg и Spark на машины кластера.
3) Создать корневой каталог для HadoopCatalog в HDFS: hdfs dfs -mkdir -p /iceberg/catalog/default; hdfs dfs -chmod 770 /iceberg/catalog/default
4) Настроить Spark-конфигурацию:
     spark.sql.catalog.hadoop_catalog.type = "hadoop"
     spark.sql.catalog.hadoop_catalog.warehouse = "/iceberg/catalog"
5) Создать таблицу через Spark SQL:
CREATE TABLE hadoop_catalog.default.clicks (id int, user string, ts timestamp) USING iceberg;6) Написать данные и прочитать их через Spark:
spark.table("hadoop_catalog.default.clicks").show()Этот сценарий демонстрирует простоту использования HadoopCatalog без внешнего метастора и позволяет быстро начать работу.
Пример 2: HadoopCatalog с Flink
Шаги:
1) Установить Flink и Iceberg соединение.
2) Настроить каталог HadoopCatalog в конфигурации Flink:
     type: "hadoop"
     warehouse: "/iceberg/catalog"
3) Реализовать чтение и запись таблиц Iceberg через Flink.
4) Пример кода на Java/Scala для чтения и записи через протокол Iceberg через Flink API.
Этот пример полезен для потоковой обработки и пакетной аналитики в рамках одного стека.
Российские решения и практики внедрения
Сценарий 1: Локальная инфраструктура с Iceberg и HadoopCatalog в российском дата-центре
В рамках российского дата-центра часто используются локальные кластеры Hadoop/HDFS, а также Kerberos и корпоративные политики доступа. HadoopCatalog здесь хорошо подходит, поскольку не требует внешнего метастора и может строиться вокруг существующей файловой инфраструктуры. Реализация включает:
- Развертывание HDFS и Kerberos-аутентификации.
- Подключение Iceberg к Spark/Flink для обработки данных.
- Настройка корневого каталога Iceberg, например /data/iceberg/catalog.
- Обеспечение резервирования каталога: репликация каталога на другой узел в рамках площадки.
- Контроль доступа: ACL на директории каталога, мониторинг доступа.
Пример конфигурации допускает использование локального Hadoop в рамках внутриоблачной инфраструктуры и обеспечивает простое масштабирование в рамках одного дата-центра.
Сценарий 2: Российские сервис-провайдеры и открытые решения
В рамках сотрудничества с отечественными провайдерами можно использовать открытые технологии (Apache Hadoop, Iceberg, Spark) и адаптировать их под требования локального рынка. Поддержка локализации может включать:
- Локальные зеркала зависимостей и сборок Iceberg и Spark.
- Настройка безопасных каналов связи между компонентами (TLS, Kerberos).
- Внедрение мониторинга и аудита доступа к каталогу на уровне файловой системы.
- Инструменты резервного копирования для директории каталога и таблиц Iceberg.
Такой подход укрепляет соответствие требованиям к хранению и обработке данных в России и упрощает соблюдение регуляторных норм.
Пример архитектурного решения
1) База данных данных на HDFS под Iceberg-такой каталог: /iceberg/catalog/default
2) Spark-пайплайны для пакетной обработки и аналитики.
3) Flink-пайплайны для потоковой обработки, читающей и пишущей в Iceberg через HadoopCatalog.
4) Мониторинг и безопасности: Kerberos, TLS, аудит доступа к каталогу.
5) Резервное копирование каталога, периодический бэкап и возможная репликация каталога между зонами.
Практические наблюдения для российского рынка
- Часто требуется интеграция со специфическими корпоративными политиками безопасности и аутентификации, поэтому настройка Kerberos и доступа к HDFS является ключевым шагом.
- В российском контексте чаще всего есть потребность в локализации данных и минимизации сетевых задержек, поэтому хранение каталога на локальном HDFS может быть предпочтительным.
- В рамках поддержки и эксплуатации важно иметь четкое документирование конфигураций и версий, чтобы обеспечить совместимость между различными пакетами (Spark/Flink/ Iceberg).
Визуализация и мониторинг
- Включайте журналы Iceberg и файловой системы в мониторинг. Следите за количеством таблиц, размером каталога, частотой операций на метаданных.
- Отслеживайте время операций чтения и записи, чтобы выявлять узкие места при работе с большим числом таблиц.
Резюме по практическим примерам
Open-source примеры показывают, как быстро начать работу с HadoopCatalog и Iceberg в рамках Spark или Flink. Российские сценарии фокусируются на локальной инфраструктуре, Kerberos, политике доступа и соответствии требованиям локального рынка. В любом случае необходимо планировать структуру каталога, безопасность, бэкапы и мониторинг.
Технические детали (конкретика и шаги)
Предпосылки:
- Установлен Hadoop/HDFS, Java, Iceberg, Spark/Flink.
- Корневой каталог для HadoopCatalog определен и имеет корректные права доступа.
- В кластере настроен доступ к файловой системе и, при необходимости, Kerberos.
Конфигурация HadoopCatalog:
- Указать тип каталога как Hadoop.
- Указать корневой путь каталога (warehouse) для Iceberg.
- Обеспечить правильную настройку файловой системы и конфигурацию Hadoop в рамках приложения.
Пример файловой структуры:
  /iceberg/catalog/default/db1/table1/metadata/metadata file и т.д.
  /iceberg/catalog/default/db1/table1/data/partitions и т.д.
Взаимодействие через Spark SQL (практический сценарий):
Настроить spark.sql.catalog.hadoop_catalog.type = "hadoop"
  spark.sql.catalog.hadoop_catalog.warehouse = "/iceberg/catalog"
  CREATE TABLE hadoop_catalog.default.user_events (user_id int, event_time timestamp, event_type string) USING iceberg;
  INSERT INTO hadoop_catalog.default.user_events VALUES (1, TIMESTAMP '2024-01-01 12:00:00', 'login');
  SELECT * FROM hadoop_catalog.default.user_events;
Взаимодействие через Java API (практический пример):
Создать Configuration conf.
Указать корневой путь rootPath = "/iceberg/catalog/default".
  HadoopCatalog catalog = new HadoopCatalog(conf, rootPath);
  TableIdentifier tid = TableIdentifier.of("default","user_events");
  Schema schema = new Schema(...);
  PartitionSpec spec = PartitionSpec.unpartitioned();
  Table table = catalog.createTable(tid, schema, spec);
  AppendFiles/OverwriteFiles для записи данных и чтения через API Iceberg.
Рекомендации по производительности
- Организуйте часть данных так, чтобы чтение-селективность была высокой. Разделение схемы на разделы (PartitionSpec) полезно.
- Ограничивайте количество одновременных операций записи, чтобы избежать конфликтов метаданных.
- Регулярно выполняйте очистку устаревших файлов и реорганизацию метаданных, если это поддерживается версией Iceberg.
HadoopCatalog представляет собой простой и эффективный способ использования Iceberg в условиях локальных файловых систем без внешнего метастора. Он подходит для небольших и средних наборов таблиц, для автономных кластеров и сценариев, где важна простая настройка и локальная автономность. В то же время, для предприятий с большим количеством таблиц, множеством кластеров и требованиями глобального управления схемами, HiveCatalog или REST Catalog могут оказаться более подходящими. При выборе HadoopCatalog ключевые факторы включают инфраструктуру хранения, требования к безопасности и масштабируемость, а также планы по backup и миграциям. Важно помнить, что успешное внедрение требует грамотной настройки Kerberos, прав доступа и резервного копирования каталога, а также мониторинга состояния каталога и метаданных.
Вопрос–Ответ (FAQ)
1) Что такое HadoopCatalog и чем он отличается от HiveCatalog?
HadoopCatalog – это реализация Iceberg Catalog, которая хранит все таблицы и метаданные внутри файловой системы, обычно HDFS, без внешнего метастора. HiveCatalog использует внешнее хранилище метаданных (Hive Metastore) для управления схемами и таблицами, что обеспечивает централизованное управление и масштабируемость в больших кластерах. HadoopCatalog проще в настройке, не требует метастора, но может быть менее удобен в мультикластерной среде и при большом количестве таблиц.
2) Какие инфраструктурные требования у HadoopCatalog?
Необходимо иметь работающий Hadoop/HDFS, доступ к файловой системе, совместимую версию Java и Iceberg. При работе в безопасной среде требуется Kerberos и ACL на директориях каталога. Важно иметь стабильный корневой путь каталога и соответствующие политики доступа.
3) Какую роль играют метаданные в HadoopCatalog?
Iceberg хранит метаданные в файловой системе как набор файлов: metadata.json, Snapshot, Manifest и Manifest List. Они эволюционируют с каждой операцией над таблицей (создание, обновление, удаление). HadoopCatalog управляет этими файлами внутри корневого каталога таблицы, а не в отдельном метасторе.
4) Как настроить HadoopCatalog в Spark?
На практике в Spark нужно указать тип каталога как Hadoop и задать корневой путь. Пример:
spark.sql.catalog.hadoop_catalog.type=hadoop
spark.sql.catalog.hadoop_catalog.warehouse=/iceberg/catalog
Далее можно использовать CREATE TABLE и другие команды SQL через Iceberg, где таблицы хранятся в указанном каталоге.
5) Какие ограничения у HadoopCatalog?
Ограничения включают масштабирование при большом числе таблиц, отсутствие глобального метастора, необходимость ручной настройки безопасности и резервного копирования каталога, а также возможные сложности миграции к другому типу каталога.
6) Как обеспечить безопасность и доступ к каталогу?
Обеспечьте Kerberos-аутентификацию, TLS, корректные ACL на директории каталога и минимальные привилегии пользователей. В HDFS используйте подходящие политикл безопасности и аудит действий в каталоге и таблицах Iceberg.
7) Как переносить или мигрировать HadoopCatalog в другой каталог?
Миграция требует планирования: можно создать новую таблицу в целевом каталоге и перенести данные (или часть метаданных) вручную. Важно проверить совместимость версий Iceberg и схем таблиц. В некоторых случаях может потребоваться миграция данных в новую таблицу и повторная запись.
8) Что делать, если у меня большое количество таблиц в HadoopCatalog?
Рассмотрите возможность перехода к HiveCatalog или REST Catalog для лучшей масштабируемости и централизованного управления схемами. В HadoopCatalog можно оптимизировать организацию каталога и уменьшить число одновременных изменений, но при значительном росте таблиц возможно потребуется переосмысление архитектуры.
9) Какие практические шаги при внедрении HadoopCatalog в российском дата-центре?
Определите корневой каталог, настройте Kerberos и ACL, подготовьте резервное копирование каталога, настройте мониторинг и аудиты, протестируйте миграции и обновления версий Iceberg, а затем постепенно переходите на рабочие пайплайны Spark/Flink. Важна документация и обучение команды.
10) Где найти дополнительные примеры и документацию?
Начните с официальной документации Apache Iceberg по HadoopCatalog и примеров использования в Spark и Flink. Также полезны open-source репозитории Iceberg на GitHub, статьи в сообществе и локальные конференции. Для российского рынка ищите региональные сообщества и локальные примеры внедрений, учитывающие требования к безопасности и локализации данных.


