

Метаданные, каталоги данных и прослеживаемость
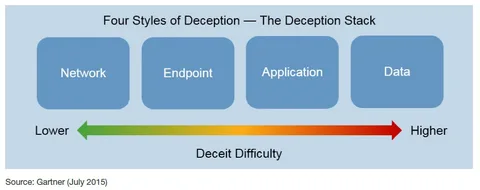
Метаданные — это данные о данных. Они описывают источники, структуры, содержание и контекст информации, которая хранится в системах BI и DWH. В условиях внедрения Distributed Deception Platform DDP роль метаданных особенно важна: платформа должна не только собирать и обрабатывать данные, но и обеспечить прослеживаемость жизненного цикла данных, их происхождение, трансформации и доступность для потребителей. Глава посвящена тому, как проектировать и внедрять системы метаданных и каталоги данных, какие типы метаданных следует учитывать, какие практики применения работают в контексте BI и DWH в сочетании с DDP, а также какие риски и ограничения сопровождают такие внедрения.
Определения и ключевые понятия
Метаданные — это структурированная информация о других данных: технические метаданные описывают источники, схемы, типы данных, форматы, версии, время обновления и прочие характеристики. Бизнес-метаданные — термины, словари, бизнес-правила, связанные с темами данных и их использованием в бизнес-процессах. Операционные метаданные включают логи выполнения процессов, время загрузок, объемы, статистику качества данных и т.д. Каталог данных (data catalog) — система организации и поиска метаданных, которая обеспечивает единый просмотр и доступ к данным, их контексту и правилам использования. Прослеживаемость (data lineage) — карта происхождения и трансформаций данных: от источников до потребителя, включая цепочки ETL/ELT, сквозные преобразования и перенаправления через промежуточные хранилища.
Архитектура и слои
Эффективная система метаданных строится вокруг центрального репозитория метаданных (metadata store) и слоя каталога. Важны следующие элементы: бизнес-глоссарий (glossary) для согласования терминологии; технические метаданные (таблицы, колонки, типы, ограничения, версии схем); операционные метаданные (журналы загрузок, статусы задач, задержки, SLA); линейка данных (data lineage) и карта изменений (change history). Архитектура может включать графовую базу данных для построения графа lineage, полнотекстовый индекс для быстрого поиска, а также хранилища документов для бизнес-правил и справочников. В контексте DDP прослеживаемость становится основой для обнаружения ложных действий и аномалий поведения, поскольку знание траекторий данных позволяет видеть, как данные перемещаются, какие трансформации применяются и кто имеет доступ на каких этапах.
Стандарты и методологии
В качестве базовых стандартов применяются: DCAT (Data Catalog Vocabulary) для описания каталога и его ресурсов; ISO 11179 для определения элементов данных и их семантики; OpenLineage и Marquez как открытые инициативы для обмена информацией о lineage между системами. Эти стандарты позволяют интегрировать каталоги с различными источниками данных и инструментами BI/DWH, что особенно важно при распределённых схемах DDP, где данные проходят через множество контуров, ETL-процессов и сервисов. Важной частью является концепция управляемости данных: ролевая модель (RBAC), политика доступа к метаданным (кто может смотреть, кто может редактировать, кто отвечает за качество), аудит изменений и сохранение версий. В рамках открытых методологий подчёркнута роль steward’ов — ответственных за качество и согласованность данных на уровне домена.
Методы сбора и актуализации метаданных
Метаданные можно получать различными способами: из источников данных (баз данных, хранилищ, файловых систем), из процессов обработки (ETL/ELT, пайплайны в Airflow, Наборы задач в контейнерах), из журналов исполнения и систем мониторинга. В современных подходах применяется автоматическое извлечение схем, аннотации к данным, автоматическое сопоставление терминов бизнес-глоссария с техническими элементами, а также синхронизация с дегустацией данных в BI для быстрого поиска. В контексте DDP возникают дополнительные требования к прослеживаемости: lineage должен отражать не только технические параметры, но и контекст безопасности и поведения системы, чтобы можно было обнаруживать отклонения, попытки манипуляций с данными и тревожные сигналы в ходе внедрения deception-подхода.
Практические примеры реализации
Open-source решения
- Apache Atlas — один из наиболее полнофункциональных инструментов для управления метаданными в экосистемах Hadoop и Spark. Архитектура Atlas предусматривает централизованный метаданных репозиторий, интеграцию с Hive, Spark, Kafka и другими, а также графовую модель для lineage. Пример использования: внедряем Atlas как центральный каталог в DWH-пайплайны; на кластере Spark и Hive автоматически собираются технические метаданные, а бизнес-термины синхронизируются через глоссарий. Lineage понимается как граф: источник данных — этапы обработки — целевые таблицы, включающие версии и правила трансформаций.
- Amundsen — открытый каталог данных, ориентированный на поиск и реальность сопоставлений между бизнес-слоем и техническими объектами. В типичной схеме Amundsen собирает метаданные из Hive/Presto/BigQuery и других источников, строит граф линейности, предоставляет поиск по терминам глоссария и ссылкам на документацию. Применение в DDP позволяет быстро находить источники данных, которые участвуют в операциях deception, и прослеживать, какие данные используются в каких сценариях моделирования угроз.
- DataHub — платформа управления данными с фокусом на графовую модель линейности, расширяемостью через ingestion-connector’ы и поддержкой OpenLineage. DataHub хорошо сочетается с микросервисной архитектурой и служит единым источником истины по метаданным для разных доменов. Пример внедрения: подключение к Snowflake, Postgres, Kafka, Airflow, Grafana для визуализации и мониторинга.
- OpenMetadata — активная платформа управления метаданными с современными интеграциями и поддержкой GraphQL API. Подходит для быстрого старта пилоты в рамках DDP и BI/DWH: сбор метаданных из источников, автоматическое сопоставление терминов, создание линейки данных и интеграцию с BI-инструментами. Преимущества: быстрый разворот, поддержка различных хранилищ и гибкость настройки.
Российские решения и локализация
- В отечественных проектах часто встречается подход построения каталога на базе локального стека и открытых стандартов, с упором на локализацию, соответствие требованиям российского законодательства, логирование аудита и хранение данных внутри территории. Практика включает развертывание централизованного каталога на базе PostgreSQL/Neo4j, интеграцию с локальными системами учета данных, средствами обеспечения безопасности и контроля доступа, а также настройку процессов синхронизации метаданных через ETL/ELT-лоji и коннекторы к отечественным хранилищам (например, к локальным СУБД и дата-центрам).
- Пример архитектуры: единый каталог на базе открытых стандартов, центральное хранение бизнес-глоссария и линейки данных, графовая модель lineage, интеграция с отечественными системами безопасности и мониторинга. Вендорные и интеграционные компании снимают требования к соответствию ФЗ-152, локализации данных, и обеспечивают контроль доступа и аудит. Такой подход позволяет совместить гибкость открытых стандартов с требованиями локализации и регуляторной прозрачности.
Практическая реализация на примере проекта BI и DWH в рамках DDP
- Этап 1. Выбор стратегии каталога: централизованный каталог против федеративной модели. В федеративной модели данные остаются в исходных хранилищах, а метаданные агрегируются через сервисы. Это ускоряет внедрение и снижает риск изменений в источниках.
- Этап 2. Интеграция источников: включение источников данных в каталоги через коннекторы для Hive, Snowflake, PostgreSQL, Kafka, а также систем журналирования и orchestration.
- Этап 3. Глоссарий и бизнес-термины: создание бизнес-терминов и их соответствий к техническим элементам. Это повышает прозрачность и упрощает поиск для бизнес-пользователей и аналитиков.
- Этап 4. Линейка данных: построение графа lineage, где каждый объект данных имеет метки источника, времени загрузки, правил трансформации и пользователей, имеющих доступ.
- Этап 5. Безопасность и аудит: настройка RBAC на уровне каталога, шифрование метаданных в покое и в трасе, аудит изменений и уведомления.
- Этап 6. Встроенная поддержка DDP: линейность и контекст данных используются для обнаружения аномалий, контроля доступа и оперативного реагирования на инциденты, связанных с подменой данных или подозрительным поведением в пайплайнах.
Типы метаданных и их модели
Разделение на технические, бизнес и операционные метаданные позволяет выстроить эффективную прослеживаемость. Технические метаданные описывают структуры таблиц, поля, типы, зависимости между объектами и версии схем. Бизнес-метаданные описывают смысл данных, бизнес-правила, термины, оценку качества и контекст использования. Операционные метаданные фиксируют время выполнения процессов, статусы загрузок, задержки и ошибки. В связке эти слои образуют полноценную картину того, как данные движутся в DWH и как они используются в BI и DDP.
Хранение и технологи
Для метаданных применяются графовые БД (для линейки и зависимостей), документно-ориентированные хранилища (для глоссариев и документов), а также реляционные СУБД (для репозитория метаданных). Часто сочетание PostgreSQL (для общей репозитории), Neo4j или JanusGraph (для линейки) и Elasticsearch (для полнотекстового поиска по терминологии и документам) обеспечивает баланс производительности и функциональности. REST API или GraphQL API позволяют потребителям безопасно взаимодействовать с каталогом.
Интеграция с BI и DWH
Каталог данных должен быть интегрирован с BI-инструментами (Power BI, Tableau, Looker и т. п.) через connectors и встроенный поиск, а также с системами DWH через коннекторы к источникам данных и пайплайнам. OpenLineage или аналогичные протоколы обеспечивают единый стандарт передачи информации о линейности между инструментами: источники данных, этапы трансформаций, целевые таблицы, версии и исполнители. Это позволяет в реальном времени обновлять карту линейки, а также автоматизировать аудит и контроль изменений. В контексте Distributed Deception Platform DDP линейность становится критически важной для отслеживания того, как данные используются в сценариях deception и как возникают следствия в системах реагирования на угрозы.
Безопасность и соответствие
Управление доступом к метаданным должно учитывать регуляторные требования. RBAC на уровне каталога, поддержка шифрования на уровне хранения и транспорта, журналирование доступа и изменений, а также возможность сегментирования по доменам и уровням ответственности. Важно обеспечить отделение обязанностей: бизнес-стeward отвечает за термины и правила, технический steward — за схемы и источники, архитектор — за интеграцию и соответствие стандартах.
Риски и ограничения
- Сложность внедрения. Архитектура каталогов требует усилий по интеграции, сопоставлению терминологии, настройке процессов ETL/ELT и поддержке взаимодействия между различными хранилищами. Неправильно настроенная интеграция может привести к неполным или противоречивым данным в линейке и глоссарии.
- Стоимость и ресурсная нагрузка. Поддержка каталога требует вычислительных ресурсов, адекватного квотирования, мониторинга и обновления версий. Особенно при больших объемах данных и многочисленных источниках нагрузка может расти.
- Риск устаревания metadata. Если данные не обновляются своевременно, каталог может содержать устаревшую информацию, что снижает доверие пользователей и снижает качество принимаемых решений.
- Безопасность и конфиденциальность. Метаданные сами по себе содержат ценную информацию о происхождении и трансформациях данных, поэтому их защита критична. Неправильная настройка доступа может привести к утечкам контекстной информации и обходу контроля доступа к самим данным.
- Ограничения инструментов и совместимости. Не все open-source решения обеспечивают гладкую интеграцию с отечественными системами хранения или с вашей архитектурой DDP. Часто требуется адаптация коннекторов, настройка совместимости и миграционные шаги.
- Управление изменениями и версионностью. В больших организациях изменения в метаданных должны быть версионированы и отслеживаемы, чтобы избежать несовместимости между версиями схем и бизнес-терминов.
- Возможные задержки в обновлениях линейки. В сильно распределенной инфраструктуре синхронизация линейки может занимать время; необходимо проектировать пайплайны обновления так, чтобы задержки не влияли на критичные бизнес-процессы.
Метаданные и каталоги данных — это не просто «кнопки» для поиска. Это фундаментальная часть культуры управления данными, которая обеспечивает прозрачность, согласованность и управляемость в BI и DWH среде, особенно в рамках Distributed Deception Platform DDP. Правильно спроектированная система метаданных позволяет быстро находить источники данных, понимать контекст их использования, отслеживать происхождение изменений и обеспечивать безопасный и контролируемый доступ к данным и их описаниям. Интеграция с открытыми стандартами и гибкая архитектура позволяют сочетать лучшие практики глобального сообщества и требования локальной инфраструктуры, включая отечественные решения и локализацию. В итоге грамотная работа с метаданными становится драйвером качества аналитики, скорости реагирования на угрозы и устойчивости бизнес-процессов.
Вопрос–Ответ (FAQ)
1) Что такое метаданные и зачем они нужны в контексте DDP?
Ответ: Метаданные — это данные о данных: источники, форматы, схемы, трансформации, сроки обновления, контекст использования. Они необходимы для управления данными в BI и DWH, позволяют понять происхождение и путь данных, обеспечивают прослеживаемость и безопасность, особенно в рамках Distributed Deception Platform DDP, где прослеживаемость и контекст критически важны для обнаружения аномалий и корректной реакции на угрозы.
2) Какие типы метаданных существуют и чем они отличаются?
Ответ: Технические метаданные описывают структуры, схемы и версии объектов; бизнес-метаданные — термины, правила использования, контекст для пользователя; операционные метаданные — информация о процессах: тайминги, статусы, качество, аудит. Совокупно они образуют полную картину жизненного цикла данных.
3) Что такое data lineage и почему он важен для DDP?
Ответ: Data lineage — это карта происхождения и трансформаций данных от источников до потребителей. В DDP он необходим для анализа цепочек влияний, обнаружения аномалий, проверки целостности и для аудита действий с данными. Хорошая линейка позволяет точно определить, какие данные были затронуты на каком этапе, кто выполнил трансформации и какие outputs получились.
4) Какие инструменты для каталогов данных выбрать: open-source или российские решения?
Ответ: Выбор зависит от требований к локализации, регуляторике и специфике инфраструктуры. Open-source инструменты, такие как Apache Atlas, Amundsen, DataHub, OpenMetadata, обеспечивают гибкость, активное сообщество и быстрый старт. Российские решения — это путь к локализации, соответствию требованиям ФЗ и регуляторики, а также к поддержке внутри страны. Часто применяется гибридная модель: открытые стандарты с локальной реализацией и локальными адаптациями.
5) Какие типы данных и источники чаще всего интегрируются в каталог?
Ответ: Источники варьируются от баз данных (PostgreSQL, Oracle, Snowflake, Redshift) до файловых систем (HDFS, S3-совместимые) и потоковых систем (Kafka, Event Hubs). Также включаются пайплайны ETL/ELT, журналы выполнения и мониторинг. В DDP особенно важно охватить источники, связанные с защитой и моделированием поведенческих сценариев.
6) Какие риски связаны с внедрением каталогов и метаданных?
Ответ: Основные риски — сложность внедрения, стоимость и ресурсная нагрузка, устаревание метаданных, безопасность и соответствие регуляторике, ограниченная совместимость и задержки обновления линейки. Управлять этими рисками можно через четкую стратегию миграции, планирование обновлений, политики доступа и постоянный мониторинг качества метаданных.
7) Как связать бизнес-термины с техническими метаданными?
Ответ: Важна единая бизнес-глоссарий и правила сопоставления бизнес-терминов с техническими объектами. Регулярные ревизии, участие бизнес-аналитиков и stewards, а также автоматическое сопоставление через правила семантики помогают поддерживать согласованность и облегчает пользователям поиск.
8) Какие требования к безопасности метаданных и как их обеспечить?
Ответ: Требуется RBAC, аудит доступа и изменений, шифрование в покое и в транзите, контроль версий и журналы. За счет сегментирования по доменам и роли можно ограничить доступ к чувствительным описаниям данных и конфиденциальной информации.
9) Какие шаги стоит предпринять для пилота внедрения каталога данных?
Ответ:
- Определить цели пилота: какие бизнес-процессы и какие угрозы DDP требуется поддержать через метаданные.
- Выбрать архитектуру: централизованный или федеративный каталог.
- Подключить ключевые источники данных и пайплайны.
- Создать базовый глоссарий и примеры линейки.
- Обеспечить безопасный доступ и аудит.
- Оценить результаты, собрать обратную связь и планировать масштабирование.
10) Каковы ключевые принципы внедрения каталога в рамках отечественной инфраструктуры?
Ответ: Принципы включают локализацию хранения данных, соответствие требованиям регуляторики, обеспечение доступности и аудит, использование открытых стандартов для совместимости, а также разумную архитектуру взаимодействий с DDP, чтобы линейность и контекст данных поддерживали сценарии deception без угрозы производительности.
Глава охватывает основные концепции, методологии и практические аспекты работы с метаданными, каталогами и прослеживаемостью в контексте BI и DWH при внедрении Distributed Deception Platform DDP. Приведённые примеры демонстрируют как применить открытые решения в сочетании с отечественными подходами, сохранив гибкость, безопасность и соответствие требованиям. Успешное внедрение требует ясной стратегии управления метаданными, согласованных бизнес-терминов и устойчивых процессов обновления линейки, что обеспечивает качество аналитики, прозрачность и эффективную поддержку защиты данных.


