

Управление качеством данных
Управление качеством данных лежит в основе любой попытки внедрить Process mining в компании. Process mining берет на вход данные о событиях из информационных систем и превращает их в процессные модели, чтобы увидеть реальное поведение бизнес-процессов, выявлять отклонения, дубликаты и узкие места. Но если сами данные, из которых строится модель процесса, некачественные, то результаты окажутся недостоверными: модель может показывать неэффективности там, где их нет, или скрывать критические проблемы, завуалированные шумом. Поэтому управление качеством данных в контексте Process mining — не просто этап подготовки данных, а фундаментальная часть методологии внедрения, без которой нельзя гарантировать устойчивые результаты и управляемость процесса.
В теоретическом плане качественные данные определяют доверие к выводам, которые получаются из анализа. В практической плоскости это означает создание повторяемых процессов профилирования и очистки данных, выработку правил формирования логов, мониторинг качества логов в режиме реального времени и интеграцию проверки качества в процессы управления данными и управления изменениями. В этом разделе мы последовательно рассмотрим фундаментальные концепции, методологии и практические подходы, которые помогут вам выстроить устойчивую систему качества данных для Process mining в вашей компании.
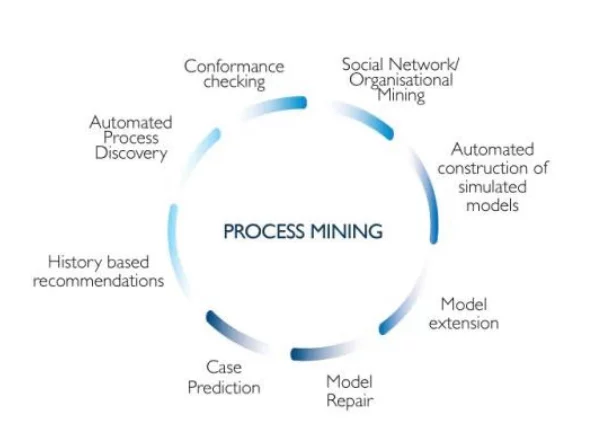
Основные понятия и терминология
- Process mining: область, которая извлекает знания о реальных бизнес-процессах из событийных журналов (логов) информационных систем. Основные задачи: константация моделей процессов (discover), сравнение моделей с реальностью (conformance checking), улучшение процессов через анализ вариантов исполнения.
- Данные качества (data quality): совокупность характеристик данных, которые определяют их пригодность к использованию в конкретной задаче. В контексте Process mining речь чаще идет о качестве логов событий: корректность записей, полнота, непротиворечивость, своевременность, уникальность и согласованность между системами.
-
Ключевые размерности качества данных:
- Полнота (completeness): наличие всех необходимых записей и атрибутов; отсутствие пропусков в критичных полях.
- Точность (accuracy): соответствие записей действительности; ошибки в значениях атрибутов.
- Согласованность (consistency): единообразие форматов и правил между различными источниками данных.
- Своевременность (timeliness): актуальность и своевременная доступность данных, правильная временная шкала.
- Уникальность (uniqueness): отсутствие дубликатов и повторных записей, корректная идентификация кейсов.
- Валидность (validity): соответствие данным допустимым значениям и бизнес-правилам.
- Интерпретируемость (interpretability): понятность данных и их атрибутов для специалистов по процессам.
- Лог событий (event log): структурированная запись, включающая как минимум идентификатор кейса, наименование активности и временную метку; в реальных системах часто встречаются дополнительные атрибуты: ресурс, место, стоимость, версия процесса, подразделение и т. п.
- XES/MXML: форматы обмена логами между инструментами process mining. XES — расширяемый формат XML для логов, принятый в большинстве открытых инструментов; MXML — старое, но все еще встречающееся представление логов.
- Границы качества и риска: качество логов напрямую влияет на точность модели, на выводы об узких местах, вариантах исполнения и возможностях оптимизации.
Как связаны качество данных и результаты Process mining
- Базовое допущение: качественные логи позволяют построить корректную модель, которая отражает реальное поведение пользователей, бизнес-правила и ограничения.
- Неполнота и дубликаты приводят к искажению длительностей и гипотезам об узких местах.
- Непоследовательность атрибутов может затруднить сопоставление событий между системами (например, время события может быть в разных часовых поясах, что нарушает хронологию кейса).
- Правила обработки и очистки должны быть документированы: какие именно изменения делаются с данными, чтобы повторно воспроизвести процесс анализа.
Методологии и подходы к управлению качеством данных
- Фаза определения требований к данным: какие атрибуты критичны для целей анализа процесса; какие данные нужны для конверсии лога в XES.
- Фаза профилирования данных (data profiling): систематический анализ исходных источников данных для оценки качества по вышеупомянутым размерностям; выявление пропусков, аномалий, несовместимостей и дубликатов.
- Фаза очистки и нормализации: исправление ошибок, исключение шумов, приведение значений к единым стандартам, устранение дубликатов, синхронизация временных меток.
- Фаза обогащения данных: добавление недостающих атрибутов, нормализация кодов, сопоставление между системами (match-merge), привязка к организационным единицам.
- Фаза проверки качества после трансформаций: повторное профилирование, чтобы убедиться, что внесенные изменения действительно повысили качество и не нарушили целостность лога.
- Непрерывный мониторинг качества: внедрение автоматических проверок и алертинга по ключевым правилам, чтобы поддерживать качество на приемлемом уровне по мере роста данных.
- Управление качеством как часть корпоративного управления данными: роли, ответственность, процессы контроля изменений, классификация данных по уровням доверия, политики доступа и приватности.
Практические ориентиры: что считать «хорошим» качеством для Process mining
- Наличие минимального набора ключевых атрибутов: case_id, activity, timestamp; дополнительные атрибуты по бизнес-потребности, например ресурс, подразделение, стоимость.
- Учитывать временные поля: единый формат времени, учёт временной зоны, корректная локализация.
- Отсутствие критических пропусков в ключевых атрибутах; пропуски должны быть валидируемыми и управляемыми: например, если case_id пропущен, запись исключается.
- Отсутствие массовых дубликатов, а также корректное слияние повторяющихся событий, если они предполагаются бизнес-логикой.
- Согласованность между системами: сопоставление событий, например между ERP и CRM, чтобы не высвечивались противоречивые кейсы.
- Документация происхождения данных (data lineage): откуда взялись данные, какие преобразования применялись, какие правила применялись к очистке и нормализации.
Что взять на вооружение в вашей организации
- Нормирование атрибутов: рекомендуется устанавливать единый набор названий полей и единиц измерения, а также единый формат идентификаторов кейсов.
- Правила обработки ошибок качества: заранее определить, как действовать с пропусками и аномалиями (например, пометка таких записей как «нулевой доверие» и явная дисквалификация из анализа).
- Метрики качества как часть бизнес-роудмапа: ставить цели по улучшению полноты и точности по каждому процессу/подразделению и регулярно отслеживать прогресс.
- Инструменты контроля: внедрить инструменты профилирования и проверки качества логов, а также механизмы повторной генерации и верификации логов при изменениях в системах.
Практические примеры
Ниже приведены конкретные сценарии, которые помогут вам увидеть, как на практике реализуется управление качеством данных в контексте Process mining.
Пример 1: открытое ПО для профилирования и очистки логов
Предположим, у компании есть набор логов из нескольких систем: ERP, CRM и складская система. Логи имеют различный формат, отсутствуют общие атрибуты и есть дубликаты. Команда выбирает open-source инструменты PM4Py для процесса mining и Great Expectations для проверки качества данных. Шаги:
- Импорт данных из CSV/BD с использованием PM4Py: вы приводите к единому форматированию, нормализуете названия полей (case_id, activity, timestamp, resource).
- Приводите временные метки к единому часовому поясу; преобразуете дату и время в ISO 8601.
- Выполняете профилирование данных с помощью Great Expectations: создаете набор проверок на полноту полей, форматы, типы данных и уникальность case_id.
- Выявляете дубликаты кейсов и записей; используете правила сопоставления для устранения дубликатов на основе идентификаторов и близких дат.
- Приводите атрибуты к единым кодам: например, сопоставляете названия статусов и активностей между системами.
- Восстанавливаете недостающие поля там, где это допустимо (например, добавляете продуктовую категорию по правилу через сопоставление по артикулу).
- Запускаете процесс mining в PM4Py для проверки, что модель процесса стала более устойчивой и не содержит «мелких» отклонений, связанных с неподготовленными данными.
Результат: более точная модель процесса, меньше шумов и ошибок в выводах, прозрачная процедура качества данных, понятная для аудитории анализа.
Пример 2: интеграция 1C:Enterprise с инструментами процессного майнинга
Российская компания использует 1C:Enterprise, а для анализа процессов применяются открытые инструменты. Потребность: извлекать логи активности из 1C и приводить их к формату логов, пригодному для PM4Py или ProM. Шаги:
- Экспорт событий из 1C в формате CSV с полями: doc_id (case_id), operation (activity), date_time (timestamp), user (resource), сумма, статус.
- Приводим формат к единообразному: приводим timestamp к ISO 8601, единицы измерения к стандартным.
- Применяем базовые правила очистки: удаляем тестовые записи, фильтруем записи с нулевой длительностью, исправляем некорректные даты.
- Преобразуем CSV в XES через конвертер PM4Py.
- Запускаем анализ процессов: обнаружение процесса, проверка конформности с бизнес-правилами.
- Визуализируем результаты в отечественной BI-системе или в графических отчётах, встроенных в 1C.
Результат: устойчивое взаимодействие между 1C и инструментами процессного майнинга; возможность проводить повторную генерацию логов и восстановления качества данных внутри российской IT-инфраструктуры, не отправляя данные за пределы страны.
Пример 3: использованием открытых инструментов с акцентом на качество данных
Компания исследует процесс обработки заявок в службе поддержки. Логи содержат множество пустых и частично заполненных полей, а время реакции клиентов не синхронизировано между системами. Шаги:
- Сбор логов из разных источников и приведение к общему формату.
- Применение PM4Py для конвертации в XES и проведения базового анализа.
- Профилирование данных: выявление пропусков в поля "customer_id" и "timestamp", поиск дубликатов записей.
- Очистка данных: устранение дубликатов в соответствии с бизнес-правилами, нормализация статусов и названий активностей.
- Обогащение: добавление информации о приоритетах заявок и временем обработки посредством сопоставления с дополнительными таблицами.
- Мониторинг качества: внедрение Great Expectations для повторной проверки логов при каждом обновлении данных.
Результат: качественные логи позволяют точнее определить цикл обработки заявок, выявить узкие места и задержки в конкретных операциях.
Архитектура и пайплайны
Архитектура качества данных в Process mining часто строится вокруг ETL/ELT-пайплайнов: источники данных → слой профилирования и очистки → нормализация и приведение к единым форматам → конвертация в лог процесса (XES/MXML) → анализ и визуализация. Важные компоненты:
- Источники данных: ERP, CRM, WMS, BPM-системы, службы поддержки и т. д.
- Инструменты профилирования и проверки качества: PM4Py, Great Expectations, другие open-source инструменты для качества данных.
- Инструменты конверсии в лог: конвертеры PM4Py, ProM.
- Инструменты анализа и визуализации: PM4Py, ProM, Apromore, open-source BI-витрины.
- Системы контроля изменений и мониторинга: Airflow, Apache NiFi, Prefect, Kubernetes для развёртывания и масштабирования.
Контроль версий и воспроизводимость: хранение конфигураций, скриптов обработки, версий логов, параметры очистки и правила в Git, DVC; фиксирование зависимостей и окружения через виртуальные окружения, conda, Docker.
Конвертация данных и требования к логам
- Базовый минимальный набор: case_id, activity, timestamp. Эти три поля лежат в основе большинства методологий.
- Наличие атрибутивной информации: ресурс, подразделение, стоимость, статусы; эти данные усиливают выводы и позволяют проводить сегментацию.
- Стандарты времени: единый формат времени и учет часовых поясов; соблюдение последовательности временных меток по каждому кейсу.
- Форматы экспорта из систем: CSV, JSON, SQL-дампы; для Process mining лучше приводить к формату, который поддерживает конвертеры в XES.
- Поддержка качества: реализовать валидаторы на этапе загрузки данных.
Правила и техники очистки
- Удаление дубликатов: определение критериев дубликатов (совпадение case_id, activity, timestamp, и/или совпадение других атрибутов) и применение соответствующих правил объединения.
- Корректировка временных меток: устранение неверных дат, поправка часовых поясов, выравнивание по единому часовому поясу.
- Заполнение пропусков: если пропуски в критических полях допустимы только с флагом; если нет — исключение записей.
- Нормализация значений: приведение к единому набору кодировок и форматов, привязка к единой терминологии в рамках организации.
- Обогащение данных: связывание событий с контекстом (партнёры, изделия, операции) для повышения анализируемости.
Практические техники в конкретных инструментальных средах
PM4Py: мощный open-source пакет на Python для импорта, некоторая очистка и конвертация в XES, последующий анализ и моделирование процессов. Примерные шаги в PM4Py:
- загрузить данные в DataFrame;
- привести к требуемым колонкам: case_id, activity, timestamp;
- преобразовать в формат логов: log = pm4py.convert_to_log(df);
- применить фильтры на временные рамки и уникальность;
- провести анализ и визуализацию.
ProM: графический инструмент, особенно полезный для конформанс-анализа и проверки соответствия моделей и логов; требует подготовки логов в поддерживаемом формате. Apromore: современная платформа с открытым кодом и коммерческими версиями; поддерживает визуальные анализы и мониторинг качества логов.
Great Expectations: инструмент для декларативного описания ожиданий к данным и автоматических проверок; особенно полезно для фазы профилирования и постоянного контроля качества.
В России и локализация: 1C:Enterprise как источник данных; интеграция через экспорт-импорт, конвертация в XES, поддержка локального хранения данных и KPI-дэшбордов в отечественных BI-системах.
Примеры для мониторинга и автоматизации: настройка рабочих процессов через Airflow или Prefect для повторной загрузки и сверки качества логов; использование Docker/Kubernetes для развёртывания и масштабирования.
Риски и ограничения технического характера
- Некоторые ограничения Process mining: результаты зависят от качества входных данных; сложно валидировать модели без контекста бизнес-правил.
- Риск приватности и соответствия требованиям: обработка персональных данных требует соблюдения законов и регуляций. В России действуют требования по локализации данных и защитe персональных данных; при использовании облачных решений возможно ограничение по передаче данных за пределы страны.
- Ограничения на качество логов: в реальности события могут записываться с задержками, пропусками, разной детализацией, что влияет на точность моделирования.
- Стоимость и сложность внедрения: на старте требуется значительная настройка и аудит имеющихся систем, чтобы привести данные к качеству, необходимому для анализа.
- Зависимость от отдельных инструментов: открытые решения дают свободу, но требуют технических специалистов; проприетарные решения могут быть проще в развёртывании, но требуют лицензий и зависят от поставщиков.
- Риск «перепроизводства» данных и шума: не всегда качественные данные должны приводиться к большому объему информации — задача состоит в фокусировании на наиболее значимых атрибутах и управлении шумами.
- Ограничения в контексте российского рынка: локализации и интеграции с отечекими системами требуют особого внимания к совместимости форматов, лицензий, и политикам по обработке ПД и данным внутри страны.
Риски и ограничения внедрения
- Неполный охват данных и их несоблюдение регламентов: если логи не попадают со всех ключевых систем, процессность анализа может оказаться неполной, что приведет к неверным выводам.
- Неправильное трактование калибровок и правил очистки: автоматизация не снимает ответственность специалистов; нужно документировать каждое изменение и его влияние на анализ.
- Сложности с данными в ретроспективных логах: исторические логи иногда не соответствуют текущим структурам, что требует адаптации и возможной реконструкции событий.
- Вопросы конфиденциальности и приватности: обработка персональных данных может потребовать обособления данных, анонимизации, и соблюдения законов о локализации.
- Ограничения по компетенциям: подготовка персонала к использованию инструментов и пониманию качественных методик требует времени и инвестиций в обучение.
- Зависимость от внешних поставщиков решений и технологий: в случае использования проприетарных компонентов заметны риски по лицензированию и доступности обновлений.
Управление качеством данных в контексте Process mining — это не одноразовая задача, а непрерывный цикл, включающий определение требований, профилирование, очистку, нормализацию, обогащение и мониторинг. Чистые и структурированные логи повышают точность обнаружения процессов, помогают выявлять реальные узкие места и предотвращать ложные выводы. Важна горизонталь интеграции между IT и бизнес-единицами: ответственность за качество данных должна отражаться в ролях (Data Owner, Data Steward, аналитик Process mining), а процессы контроля изменений и обновления логов должны быть формализованы и документированы. В современных условиях эффективное управление качеством данных требует сочетания открытых инструментов, локальных решений и грамотной архитектуры данных, которое обеспечивает прозрачность, воспроизводимость и соответствие требованиям регуляторов. При правильной организации качественные данные становятся сильной стороной для процесса майнинга, позволяют достигать устойчивых улучшений и демонстрируют реальную ценность внедрения Process mining в бизнес-процессы.
- Качество данных — фундамент Process mining: без качественных логов трудно получить достоверное представление о реальных процессах.
- Необходимо строить системный подход: профилирование, очистка, нормализация, обогащение, мониторинг и регуляторная совместимость.
- Важна интеграция инструментов: open-source решения (PM4Py, ProM, Apromore, Great Expectations) в комбинации с отечественными решениями (1C, локальные BI-платформы) для достижения эффективной и безопасной реализации.
- Риски должны быть заранее приняты и минимизированы через политики данных, соблюдение законодательства, документирование и обучение сотрудников.
- Постоянный мониторинг и улучшение — ключ к поддержанию качества данных на уровне, достаточном для устойчивых и полезных выводов Process mining.
Вопрос–Ответ (FAQ)
1) Что такое управление качеством данных в контексте Process Mining и зачем он нужен?
Ответ: Управление качеством данных в Process Mining — это системный набор практик по обеспечению корректности, полноты, согласованности и своевременности логов событий, необходимых для надежного извлечения реальных бизнес-процессов. Это обеспечивает достоверность моделей процессов, точность выявления узких мест и устойчивость выводов в условиях изменений в системах. Без хорошего качества данных анализ теряет доверие и может привести к неверным управленческим решениям.
2) Какие основные размерности качества данных важны для Process Mining и как их измерять?
Ответ: Основные размерности — полнота, точность, согласованность, своевременность, уникальность, валидность и интерпретируемость. Их измеряют через профилирование данных, проверку наборов правил (валидаторы и тесты), сравнение между источниками, выявление пропусков и дубликатов, анализ согласованности между системами и оценку воспроизводимости записей. Метрики могут включать долю заполненных значений, процент уникальных кейсов, долю корректных временных меток, число конфликтов между системами и т.д.
3) Какие практические шаги ввести, чтобы улучшить качество логов перед Process mining?
Ответ: Практические шаги включают: определение набора критических атрибутов для логов (case_id, activity, timestamp), унификацию форматов времени, устранение дубликатов, заполнение пропусков там, где это возможно, нормализацию кодировок, сопоставление между системами, обогащение данных и документирование происхождения данных (data lineage). Затем следует выполнить повторное профилирование и тесты качества.
4) Какие инструменты и технологии можно использовать для обеспечения качества данных?
Ответ: В открытом доступе полезны PM4Py, ProM, Apromore для процесса майнинга; Great Expectations для декларативного определения ожиданий к данным и их проверки; Pandas для обработки данных; OpenRefine для очистки неструктурированных данных; для автоматизации пайплайнов — Airflow, Apache NiFi, Prefect. Для российского контекста полезно использовать 1C:Enterprise в связке с открытыми инструментами — экспорт логов (CSV) в единый формат и конвертация в XES, хранение и анализ в локальной инфраструктуре.
5) Какие риски связаны с внедрением управления качеством данных и как их снижать?
Ответ: Риски включают нарушение приватности данных и требования законодательства, сложности с локализацией данных, неполное покрытие источников, шум и шумопроизвольные аномалии в логах, высокую стоимость и длительность внедрения, зависимость от конкретных инструментов. Их снижают через соблюдение регламентов обработки ПД, документирование политики качества, многоступенчатые проверки, внедрение мониторинга и автоматических тестов качества, а также обучение сотрудников и формализацию процессов управления данными.
6) Как интегрировать российские решения с открытыми инструментами Process mining?
Ответ: Взаимодействие строится через экспорт данных из отечественных систем (например 1C:Enterprise) в единый формат (CSV) и последующую конвертацию в формат логов Process mining (XES) с помощью конвертеров и адаптеров. Затем логи анализируются в PM4Py/ProM/Apromore, а результаты визуализируются в локальной BI-системе. Важно сохранять локальность данных и обеспечить интервалы обновления логов, согласование версий и контроль доступа в рамках отечественной инфраструктуры.
7) Какие ограничения чаще всего встречаются на практике?
Ответ: Частые ограничения — неполнота данных, несогласованность структур между системами, пропуски в критических полях, шум и дублирование, задержка в обновлениях логов, трудности в управлении персональными данными, сложности в поддержании инфраструктуры для анализа в рамках регуляторных требований. Также ограничение может быть связано с дефицитом квалифицированных специалистов, способных работать как с данными, так и с инструментами Process mining и контролем качества.
8) Каковы лучшие практики для поддержания качества данных в течение времени?
Ответ: Регулярное профилирование данных, внедрение автоматических тестов качества на этапе загрузки, документирование правил очистки и нормализации, поддержка data lineage, мониторинг качества логов и уведомления об отклонениях, периодическая повторная обработка данных, обновление процессов в соответствии с изменениями систем. Важна роль Data Steward и Data Owner, ответственных за поддержание качества и соблюдение требований.
9) Что лучше использовать: Open-source или проприетарные решения для качества данных в Process mining?
Ответ: Выбор зависит от конкретных целей, требований регулирования, бюджета и компетенций команды. Open-source решения дают гибкость, прозрачность и возможность адаптации под отечественные требования и интеграции с 1C и локальными BI-платформами. Проприетарные решения могут обеспечить более удобный пользовательский интерфейс и сильную техподдержку, но требуют лицензий и часто зависят от поставщиков. В идеале — сочетать подходы: использовать open-source инструменты для профилирования, очистки и анализа, а локальные сервисы для контроля доступа, приватности и регуляторной совместимости.
10) Какие есть примеры успеха при внедрении управления качеством данных в Process mining?
Ответ: Успешные кейсы включают снижение времени обработки заявок за счет корректной логики и уменьшения шумов в логах; повышение точности обнаруживаемых узких мест и сокращение затрат на процессы за счет правильной идентификации истинных отклонений; увеличение доверия к выводам анализа со стороны бизнеса благодаря прозрачности контроля качества данных и документированному процессу обработки логов. Успешные кейсы поддерживают идею о том, что качественные данные позволяют выявлять реальные проблемы и демонстрировать ROI от внедрения Process mining.


