

Архитектурные варианты внедрения: локально vs в облаке
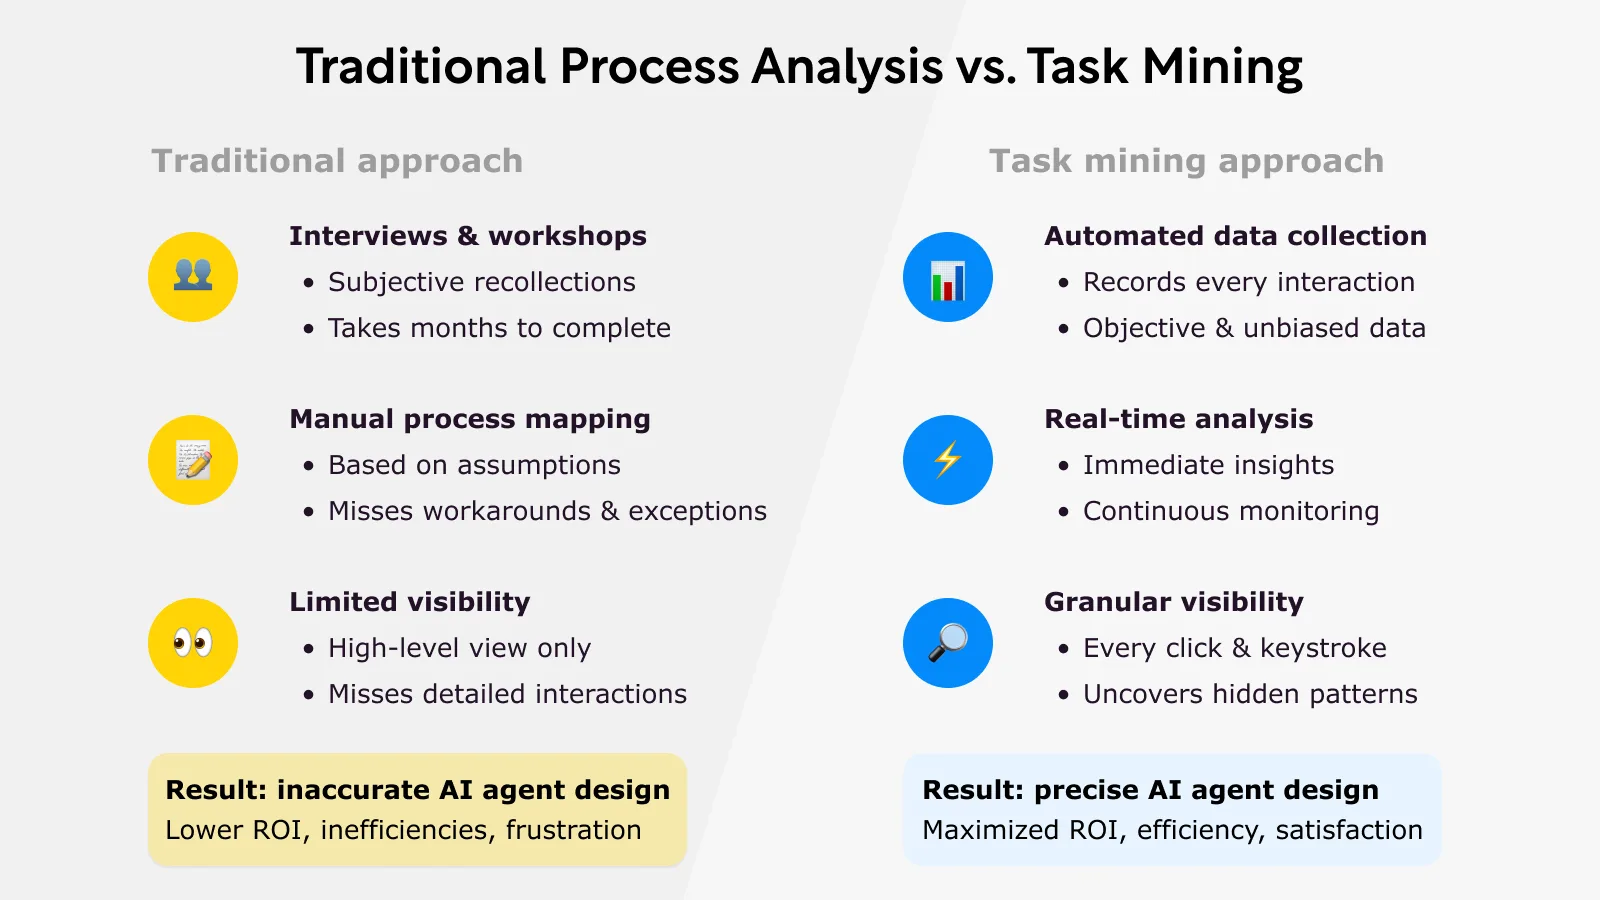
Задача главы — рассмотреть архитектурные варианты внедрения Task mining в компании с разных точек зрения: локальное развёртывание на внутренней инфраструктуре и использование облачных сервисов. Task mining — это подход к анализу рабочих задач через наблюдение за действиями пользователей в различных информационных системах и за взаимодействиями между людьми и приложениями. Цель такого анализа — выявить повторяющиеся задачи, узкие места, задержки и способы автоматизации без необходимости радикально менять существующие процессы. В современной практике многие организации выбирают гибридные решения, когда часть данных обрабатывается локально для соответствия требованиям безопасности или локализации данных, а остальные функции предоставляются через облако для масштабируемости и ускорения развёртывания.
Основные понятия и термины
- Task mining: процесс извлечения информации о задачах и рабочих действиях пользователей из их взаимодействий с системами (экранные записи, клики, отклики приложений, журналы операций) с целью идентификации повторяющихся паттернов и рационализации рабочих процедур.
- Process mining: область анализа бизнес-процессов, опирающаяся на лог-файлы и события, чтобы восстанавливать модели процессов, проверять соответствие реальности утверждённым моделям и измерять производительность.
- Event log (событийный журнал): структурированная последовательность записей, каждая запись отображает событие в рамках конкретного кейса (рабочего задания), с данными о активности, времени, исполнителе и контексте.
- Case, Activity, Trace: кейс — конкретная рабочая задача, состоящая из последовательности задач (Activities); Trace — последовательность активностей по одному кейсу.
- Data provenance и data lineage: происхождение и путь данных в системе, что особенно важно для аудита и соответствия требованиям.
- Data localization и data sovereignty: требования по локализации хранения данных в рамках конкретной юрисдикции.
- Governance и compliance: набор политик, стандартов и процедур по управлению данными, доступом и безопасностью.
- On-prem (локальное развёртывание) vs cloud (облако): разные архитектурные подходы к размещению вычислительных ресурсов и хранения данных.
Архитектурные варианты
- Локальная архитектура (on-prem): база решений развёрнута на собственной инфраструктуре компании — сервера, хранилища, сеть, средства защиты. Преимущества: полный контроль над данными, возможность строго локальной локализации, соответствие внутренним политикам и требованиям регуляторов. Недостатки: капитальные вложения в оборудование, необходимость поддержки, обновления и масштабирования, зависимость от внутренних систем безопасности.
- Облачная архитектура: решение размещается в облаке (платформа как услуга или программный сервис). Преимущества: масштабируемость, быстрые итерации, обновления, гибкость резерва и высокой доступности, меньшие затраты на капитальные вложения на старте. Недостатки: зависимость от поставщика, вопросы приватности и локализации данных, требования к сетевым соединениям, соответствие регуляторным требованиям по хранению данных в конкретной юрисдикции.
- Гибридная архитектура: сочетает локальные компоненты и облачные сервисы. Такой подход часто применяется, когда критичные данные обрабатываются локально, а аналитические вычисления, визуализация и модельные сервисы — в облаке. В гибридной модели важна эффективная схема передачи данных между локальной инфраструктурой и облаком, а также строгий контроль доступа и шифрования.
Методологический подход к внедрению
- Цели и рамки: формулируют задачи, которые должны решать Task mining-проекты (например, сокращение времени обработки заявок на X%, увеличение доли автоматизации в ручных операциях, выявление узких мест в процессе обработки заказов).
- Область охвата: какие процессы и подсистемы будут включены (ERP, CRM, DMS, BPM, 1C и т. п.). Важно определить границы и запросы руководства.
- Архитектурная карта перемещений данных: какие данные будут собираться, как они будут защищаться, где будут храниться и как передаваться между компонентами.
- Этапы реализации: сбор данных, их нормализация и обогащение, построение логов событий, аналитика и обнаружение процессов, валидация моделей, внедрение изменений и автоматизация.
- Гибкость к изменениям: подходы к обновлениям моделей и интеграций, чтобы не задерживать бизнес-процессы при миграциях.
- Метрики успеха: например, точность выявления задач, доля автоматизированных шагов, ROI, время цикла внедрения.
Роли и ответственность
- Архитектор решений: выбирает архитектурный стиль (локальное, облако или гибрид), обеспечивает соответствие политик безопасности.
- Инженер по интеграции: отвечает за каналы данных, коннекторы к ERP/CRM/1C, обработку данных и их качество.
- Аналитик процессов: интерпретирует результаты, строит модели, определяет точки улучшения.
- Специалист по безопасности: аудит доступа, шифрование, управление ключами, защита PII.
- Менеджер проекта: контроль сроков, координация с бизнес-подразделениями, управление рисками.
Практические примеры
1) Open-source решения и подходы
- Инструменты: pm4py, ProM, другие библиотеки Python/Java для обработки логов и моделирования процессов.
- Типичный сценарий внедрения: сбор логов действий пользователей из нескольких систем (ERP, HRIS, CRM, BPM), приведение данных к общему формату (event logs с полями case_id, activity, timestamp, resource, additional attributes), сохранение в формате XES или CSV, применение алгоритмов автоматического открытия процесса (process discovery) и затем анализ соответствия (conformance) и производительности.
- Пример рабочих шагов без кода: подготовить набор файлов лога в структурированном виде, импортировать их в инструмент анализа (например, pm4py), преобразовать логи в формат XES, применить алгоритм process discovery для получения модели процесса, визуализировать модель и идентифицировать узкие места и задержки в отдельных шагах, затем оценить потенциал автоматизации конкретных задач.
- Что это даёт: независимая верификация текущих процессов, прозрачная карта реальных действий сотрудников, база для определения мест, где можно внедрить роботизацию или автоматизацию рутины.
2) Российские решения и локальные кейсы
- ABBYY Timeline: зрелое решение для анализа бизнес-процессов и выявления возможностей автоматизации. В российских реалиях Timeline часто применяется для анализа процессов в финансовой, логистической и операционной сферах. Архитектура допускает интеграцию с локальными системами через коннекторы к ERP и BPM, а также использование облачных сервисов ABBYY Timeline или развёртывание в рамках локальной инфраструктуры по требованиям заказчика. В практике внедрения Timeline помогает выявлять повторяющиеся задачи на уровне сотрудников и отделов, затем предлагает варианты автоматизации (RPA или совершенствование процессов), а также позволяет держать данные под контролем внутри корпоративной сети при необходимости локализации.
- Локальные коннекторы и интеграционные схемы: интеграция с 1C, SAP/ERP, системами документооборота и CRM может осуществляться через API, ETL-процессы и файлообмен. Для российских компаний, где важна локализация данных и соответствие требованиям регуляторов, такие интеграции часто проходят в рамках гибридной архитектуры: критичные данные хранятся локально, аналитика может выполняться в облаке или на локальном кластере, в зависимости от политики безопасности.
- Практический эффект: выявление «ручных» участков в обработке счетов, заявок на сервисное обслуживание, цепочек согласований документов; после анализа формируются планы по автоматизации, улучшению порядка документооборота и устранению дублирующих действий.
3) Сравнение по типичным критериям
- Скорость развёртывания: облако обычно даёт более быструю постановку инфраструктуры и доступ к обновлениям, локальная архитектура требует планирования аппаратной части и регламентов по безопасности.
- Масштабируемость: облако лучше для быстрого масштабирования по количеству процессов и объёму данных; локальная инфраструктура требует дополнительных инвестиций на рост.
- Контроль над данными: локальная архитектура предпочтительна при строгих требованиях к локализации, шифрованию и аудиту; облако — если политика допускает передачу данных и есть требования наличия копий в отдельных зонах доступности.
- Стоимость: начальные затраты на локальную инфраструктуру выше, чем у облачных сервисов, но совокупная стоимость владения может быть разной в зависимости от длительности проекта и объёмов данных.
- Безопасность и комплаенс: в обеих моделях необходимы политики IAM, шифрование, мониторинг и управление уязвимостями; важно наличие механизма аудита и возможности реагирования на инциденты.
Архитектурные составляющие локального развёртывания
- Инфраструктура: выделенный серверный кластер, хранилище для журналов событий, сеть с сегментацией, средства мониторинга и резервного копирования.
- Коннекторы к источникам данных: ERP (1C, SAP), CRM, DMS, BPM-системы; необходимость поддержки протоколов API, файловых обменов и баз данных.
- Компоненты Task mining: агент для фиксации действий (если требуется запись на рабочих станциях), движок обработки логов, хранилище для журналов, аналитический модуль для построения моделей, средства визуализации и отчетности.
- Безопасность: шифрование данных в состоянии покоя и в транзите, управление ключами, контроль доступа по ролям, аудит операций, режимы минимизации доступа к персональным данным (PII).
- Управление данными: хранение в приватной сети, локальная копия резервов, политики срока хранения логов, процедура удаления данных по запросу.
Архитектура в облаке
- Облачная платформа: выбор между общедоступным облаком (AWS, Azure, Google Cloud) или локальными облачными провайдерами (Яндекс.Облако, Selectel и др.). В гибридных сценариях это позволяет держать часть данных в локальной инфраструктуре, а вычисления — в облаке.
- Коннекторы и интеграции: облачные коннекторы к ERP/CRM через API, инфраструктура как код (IaC) для развёртывания сервисов, очереди сообщений (Kafka или аналог), обработка потоков данных.
- Хранилища: data lake в облаке (S3-совместимое хранилище), аналитические кластеры (Spark/Databricks) для обработки больших массивов лога; опциональная визуализация и дашборды.
- Безопасность и комплаенс: настройка IAM, ролей, политики доступа, шифрование на уровне хранилища и канала связи, сетевые фильтры, мониторинг инцидентов.
- Архитектурная гибкость: легко добавить новые источники данных, расширить коннекторы и разворачивать новые аналитические сервисы без крупных капитальных вложений.
Технические детали реализации
- Структура данных: event log часто строится как набор записей с полями: case_id, activity, timestamp, resource (пользователь), source_system, additional_attributes (контекст операции), результат. Форматы: XES, JSON, CSV. Для Task mining могут потребоваться дополнительные поля, такие как duration между шагами или загрузка документов.
- Этапы обработки: сбор данных → нормализация → обогащение контекстом → построение журналов событий → применение алгоритмов обнаружения процессов → анализ производительности и путей улучшения → формирование рекомендаций по автоматизации.
- Инструменты анализа: pm4py (Python), ProM (Java), другие библиотеки для обработки XES/CSV логов; визуализация паттернов через встроенные инструменты или внешние BI-платформы.
- Пример типовой задачи: собрать логи обработки заявок из 1C и CRM, нормализовать поля, сформировать XES-лог, применить алгоритм α-метода или inductiveMiner для обнаружения модели, сравнить с текущей реальной моделью процесса, выявить шаги с задержками и потенциальные точки автоматизации.
Практические технические шаги внедрения
- Подготовка инфраструктуры: выбрать между on-prem или облаком, определить требования к хранению, вычислениям и сетевой архитектуре.
- Определение источников данных и коннекторов: согласовать набор систем, доступы, формат экспорта логов.
- Настройка безопасности и соответствия: определить зоны ответственности, изгородить доступ по ролям, определить политики хранения и удаления данных.
- Запуск пилота: выбрать ограниченный набор процессов, собрать данные, запустить анализ и построить первый набор рекомендаций.
- Этап внедрения: внедрить улучшения, автоматизировать повторяющиеся задачи, расширять охват на другие процессы.
- Контроль и эволюция: мониторинг показателей, обновление моделей и коннекторов, планирование обновлений инфраструктуры.
Примеры конкретных сценариев
- Пример 1: В рамках локальной инфраструктуры компания анализирует обработку счетов в ERP и документообороте через DMS. Локальный Task mining помогает выявить повторяющиеся шаги в согласовании платежей, что приводит к автоматизации на уровне RPA и сокращению цикла оплаты.
- Пример 2: В гибридной архитектуре предприятие хранит чувствые логи внутри своей сети, а аналитическую обработку выполняет в облаке у поставщика. Такая архитектура обеспечивает соответствие локализации данных и ускоряет анализ больших наборов логов.
- Пример 3: Российский кейс с ABBYY Timeline: сбор данных из локальных систем через коннекторы, анализ процессов в рамках корпоративной безопасности, визуализация узких мест и предложение путей оптимизации с акцентом на локализации данных и соблюдении регуляторных требований.
Риски и ограничения
Приватность и регуляторика
- В Task mining собираются данные, которые могут содержать персональную информацию (PII). Необходимо обеспечить анонимизацию, минимизацию данных и строгие политики доступа.
- Непрерывная аудиторская активность и журналирование доступа требуют прозрачности для сотрудников и соответствия нормам, включая требования национального законодательства и регуляторов.
Качество данных и интерпретация
- Данные из разных систем приходят в разных форматах; их для анализа нужно нормализовать, и ошибки в нормализации могут привести к неверной интерпретации моделей процессов.
- Автоматизированные выводы требуют валидации людьми. Модель может показывать гипотезы по автоматизации, но реальную пользу нужно подтверждать бизнес-обоснованием.
Интеграционная сложность
- Подключение к различным ERP/CRM/DMS систем требует согласования API, а иногда — разработки кастомных коннекторов, что увеличивает сроки внедрения.
- В облаке возникают зависимости от поставщиков, что может привести к задержкам из-за изменений в API, обновлений или сбоев сервиса.
Безопасность и управляемость
- Потенциальные уязвимости при передаче и хранении данных, риск утечки, если доступ не будет должным образом ограничен.
- В гибридной архитектуре сложнее управлять политиками безопасности и соответствием, так как данные перемещаются между локальной инфраструктурой и облаком.
ROI и устойчивость
- Внедрение Task mining требует инвестиций в инфраструктуру, интеграцию и обучение персонала. ROI оценивается по экономии времени, снижению ошибок и повышению эффективности, но результаты требуют измерения и дисциплины в исполнении.
- Сложности устаревания технологий и зависимости от отдельных поставщиков могут повлиять на долгосрочную устойчивость решений.
Выводы
- Выбор архитектуры должен опираться на реальные требования к безопасности, локализации данных, скорости внедрения и бюджету. Локальная архитектура предпочтительна при строгих требованиях к данным, высоким уровнях контроля и необходимости соответствия регуляторике, тогда как облако обеспечивает масштабируемость, скорость старта и гибкость.
- Гибридная модель часто становится оптимальной для крупных компаний с разделением данных по чувствительности и необходимости быстрого анализа. В любом случае важна продуманная стратегия управления данными, коннекторами и политиками безопасности.
- Практическое внедрение требует поэтапности: пилот, валидацию результатов, масштабирование на другие процессы и непрерывный мониторинг показателей. Важны вовлеченность бизнеса, прозрачность процессов и ответственность за данные.
- В качестве инструментов и решений для открытых проектов можно опираться на pm4py и ProM для анализа логов и построения моделей процессов; для российских клиентов — ABBYY Timeline и локальные коннекторы к 1C/SAP/CRM с учётом локализации данных и требований к хранению.
FAQ — Вопрос–Ответ
1. Что такое Task mining и чем он отличается от Process mining?
Ответ: Task mining — это фокус на действиях конкретных сотрудников и задачах, которые они выполняют в своей повседневной работе, с целью выявления повторяемых задач, задержек и возможностей автоматизации. Process mining же смотрит на бизнес-процессы в целом через журналы событий и пытается реконструировать потоки работ на уровне процессов. Task mining дополняет process mining, добавляя детализацию на уровне задач и действий сотрудников.
2. Какие архитектурные варианты существуют для внедрения — локальное vs облако?
Ответ: Локальное развёртывание даёт полный контроль над данными и может быть предпочтительным при строгой локализации и аудите. Облачное развёртывание обеспечивает масштабируемость, быструю доступность сервисов и упрощённое обновление. Гибридная архитектура сочетает оба подхода: чувствительные данные хранятся локально, вычисления и аналитику можно выполнять в облаке, что даёт баланс между безопасностью и масштабируемостью.
3. Что выбрать для малого бизнеса?
Ответ: Для малого бизнеса чаще всего оптимальна облачная архитектура или гибридное решение с минимальными локальными компонентами. Это позволяет быстро запустить пилот, уменьшить первоначальные затраты и постепенно расширять охват. Но если бизнес обрабатывает персональные данные и подвержен строгим регуляторным требованиям, стоит оценить требования к локализации и рассмотреть локальное развёртывание или гибрид.
4. Какие данные нужны и какие источники стоит подключать?
Ответ: Нужны журналы действий пользователей и операций в системах, таких как ERP (1C, SAP), CRM, DMS, BPM и прочие; контекстные данные (пользователи, роль, время, источник), а иногда текстовые данные документов. Важна корректная идентификация кейсов и последовательностей действий. Необходимо обеспечить качество данных, их корректную агрегацию и нормализацию между системами.
5. Какие риски связаны с приватностью и как их минимизировать?
Ответ: Риск утечки PII и чувствительных данных повышен при сборе логов. Для минимизации рисков применяются анонимизация, маскирование, минимизация объёма данных, политика доступа по ролям, шифрование на устройстве и в процессе передачи, аудит доступа и регламент по удалению данных после окончания проекта.
6. Какие технические шаги нужно выполнить для перехода к Task mining?
Ответ: Определить цели и области охвата, выбрать архитектуру (локальное, облако или гибрид), выбрать источники данных и коннекторы, настроить безопасность и доступ, собрать пилотные логи, запустить анализ и построение процессов, проверить результаты совместно с бизнесом, внедрять улучшения и расширять охват по мере устойчивости проекта.
7. Какие открытые инструменты можно использовать?
Ответ: Открытые инструменты включают pm4py и ProM для анализа журналов событий и построения моделей процессов. Они позволяют исследовать данные без зависимости от одного коммерческого продавца, поддерживают форматы XES/CSV и позволяют создавать визуализации и метрики.
8. Какие российские решения существуют и чем они полезны?
Ответ: Одно из известных вендорских решений с российскими корнями — ABBYY Timeline. Оно ориентировано на анализ и визуализацию процессов, поддержку локализации данных и интеграцию с локальными системами (ERP, DMS, BPM) через коннекторы. Преимущество — сильная поддержка русского языка, локализация интерфейсов и возможностей интеграции в отечественную ИТ-инфраструктуру. В крупных компаниях Timeline часто используется в рамках гибридной архитектуры для удовлетворения требований по безопасности и регуляторам.
9. Как оценивать ROI внедрения Task mining?
Ответ: ROI оценивается по сокращению цикла обработки задач, снижению ошибок и задержек, росту доли автоматизации, экономии времени сотрудников, а также по экономии затрат на исправление дефектов и ускорению бизнес-операций. Важно задать базовую метрику до проекта, фиксировать достижения после пилота и валидации, а затем продолжать мониторинг после внедрения.
10. Как обеспечить безопасность и соответствие требованиям в гибридной архитектуре?
Ответ: Важно определить политику хранения данных, установить строгие правила доступа и аудит, использовать шифрование данных на уровне хранения и канала связи, применять управление ключами (KMIP/KMS), внедрить мониторинг и управление инцидентами, осуществлять регулярные аудиты и соответствовать требованиям регуляторов в вашей юрисдикции. В гибридной архитектуре требуется обеспечить согласование политик между локальным сегментом и облаком, а также контроль за передачей данных через безопасные каналы.
Архитектура внедрения Task mining — вопрос практического баланса между безопасностью, масштабируемостью, стоимостью и скоростью реализации. Выбор локального, облачного или гибридного подхода должен базироваться на регуляторных требованиях, политике безопасности, потребностях бизнеса и бюджете. В ходе проекта важно обеспечить прозрачность данных, вовлеченность бизнес-подразделений и ясную дорожную карту внедрения: от пилота к масштабируемому решению. Открытые инструменты в сочетании с отечественными решениями дают широкие возможности для анализа рабочих задач, выявления узких мест и планирования автоматизации, что в конечном итоге приводит к сокращению времени обработки, росту эффективности и улучшению качества процессов.


