

Архитектура Greenplum: мастеры, сегменты и зеркала
В этой главе мы подробно разберём архитектуру Greenplum Database (GPDB): какие роли выполняют мастера, сегменты и зеркала, как устроен межузловой обмен данными, какие термины и концепции лежат в основе моделирования обработки запросов, а также рассмотрим практические аспекты развертывания, мониторинга и устойчивости к сбоям. Мы будем двигаться от теории к практике, приводя примеры и рекомендации как для открытых, так и для российских решений в контексте эксплуатации и администрирования хранилища данных.
Для начала кратко сформулируем базовые понятия, чтобы мы говорили на одном языке.
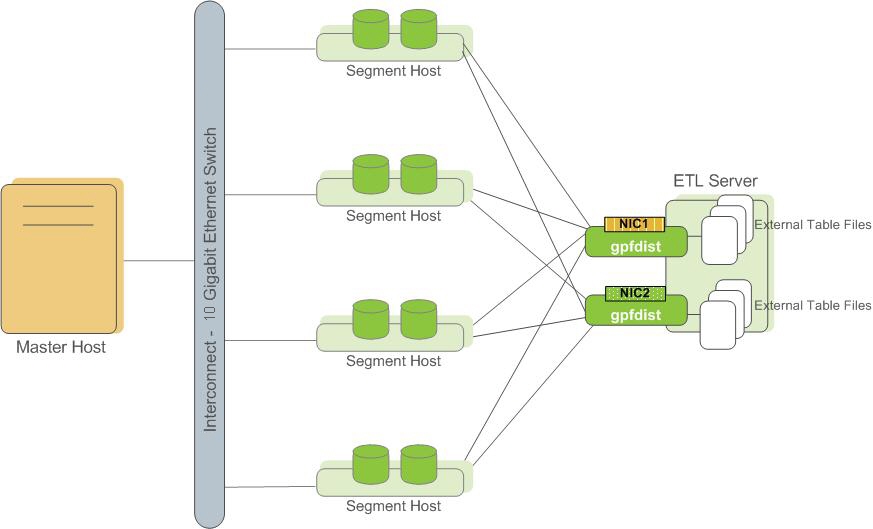
- Мастер (QD, Query Dispatcher) — центральный управляющий процесс кластера. Он принимает SQL-запросы от клиентов, планирует выполнение и распределяет работу между сегментами.
- Сегменты — вычислительные узлы кластера, где сохраняются данные и выполняется часть вычислений. Каждый сегмент может иметь одну или несколько копий (первичные и зеркальные) для обеспечения отказоустойчивости.
- Зеркала (mirrors) — копии первичных сегментов, которые поддерживают согласованность данных и позволяют продолжать работу при сбое первичных сегментов.
- Распределение данных — способ указания, по какому ключу данные попадают на сегменты. Наиболее распространён подход — DISTRIBUTED BY на основе хеширования одного или нескольких столбцов (hash-распределение).
В Greenplum архитектура строится на принципах MPP (Massively Parallel Processing) — параллельной обработки на большом количестве сегментов. Это значит, что одна и та же команда запроса может выполняться параллельно на множестве сегментов, а результаты собираются и агрегируются мастером. Такой подход обеспечивает масштабируемость и высокую пропускную способность аналитических нагрузок.
В следующих разделах мы разложим: как устроен кластер в продакшн-условиях, какие практики выбора конфигурации полезны на разных стадиях жизненного цикла, и какие риски требуют внимания при проектировании архитектуры.
- Введение
- Теоретическая часть
- Практические примеры
- Технические детали
- Риски и ограничения
- Выводы
- Вопрос–Ответ (FAQ)
Введение
Greenplum задумывался как многопроцессорная аналитическая БД, оптимизированная под большие объёмы данных и сложные аналитические запросы. Архитектура в первую очередь ориентирована на параллелизм на уровне сегментов: данные не хранятся на одном монолитном узле, а распределяются по набору сегментов, что позволяет разделять нагрузку и ускорять выполнение запросов. Мастер отвечает за планирование, координацию и инструктаж к исполнению, но сама работа по сканированию и обработке данных идёт на сегментах.
Основные понятия теоретической части
- Каталог данных и мастер: Мастер (QD) хранит метаданные кластера, схемы и статистику, необходимые для планирования запросов. Он не содержит больших объёмов пользовательских данных; данные живут на сегментах.
- Сегменты и их копии: Каждый сегмент – это экземпляр PostgreSQL-подсистемы, адаптированной под GPDB. На практике по умолчанию создаются первичные сегменты и зеркальные копии (mirrors) для обеспечения нулевого простоя при сбоях.
- Распределение данных: Таблицы, созданные в GPDB как DISTRIBUTED BY, формируют способ перемещения записей между сегментами. Правильный выбор ключа распределения критически влияет на производительность соединений, сортировок и операций агрегации.
- Motion и параллелизм: Во время выполнения запросов GPDB может перемещать (motion) данные между сегментами для оптимального выполнения операций (join, group by и пр.). Это один из главных источников параллелизма.
- Репликация и отказоустойчивость: Зеркала синхронно/асинхронно дублируют данные первичных сегментов, обеспечивая защиту от отказов и возможность быстрого восстановления после сбоев. В продвинутых конфигурациях поддерживаются режимы высокой доступности.
- Мониторинг: GPPerfMon (и связанные проекты) позволяют отслеживать метрики кластера: загрузка CPU, использование памяти, задержки межузлового соединения, состояние зеркал и т.д. Российские решения мониторинга часто интегрируются через Zabbix или Prometheus/Grafana с русифицированными дашбордами.
Теоретическая часть
- Архитектура кластера GPDB
Классическая архитектура GPDB включает в себя:
- Один мастер (QD) — управляющий процесс, отвечающий за планирование, распределение запросов и координацию.
-
Несколько сегментов — обычно разбиты на группы на разных физических узлах:
- Первичные сегменты (Primary)
- Зеркальные сегменты (Mirror) — копии первичных сегментов, которые помогают в флоу-устойчивости.
- Механизм межузлового обмена данными — высокопроизводительный сетевой транспорт, часто основанный на специализированных сетевых интерфейсах и протоколах, обеспечивающих низкую задержку и высокую пропускную способность.
- Каталог данных — хранение системных метаданных и статистик на мастере.
Ключевые принципы:
- Распределение рабочих нагрузок в GPDB основано на разделении данных по распределению.
- Планировщик мастера составляет план, который затем выполняется множеством сегментов параллельно.
- В зависимости от конфигурации кластера, зеркало может участвовать в записи и синхронном копировании изменений для обеспечения отказоустойчивости.
- Роли мастера, сегментов и зеркал
-
Мастер (QD)
- Принимает входящие запросы клиентов.
- Планирует выполнение и координирует отправку задач на сегменты.
- Хранит системный каталог, статистику, данные о планах выполнения и конфигурациях.
-
Первичные сегменты
- Хранят реальные данные базы.
- Выполняют часть вычислений и операций в рамках параллельного выполнения.
-
Зеркальные сегменты
- Копии соответствующих первичных сегментов.
- Позволяют без потери данных продолжать работу в случае сбоя первичных сегментов; репликация актуальна на момент сохранения, и иногда зеркала используются для быстрого восстановления данных.
- Распределение данных и их влияние на производительность
- DISTRIBUTED BY (ключ распределения) — основной механизм распределения строк по сегментам.
- Хеш-подбор ключа распределения может привести к равномерному распределению нагрузки, но если запросы часто выполняются с операциями join по полю, не равномерно распределённому между сегментами, можно столкнуться с "data skew" (незбалансированной нагрузкой), что ухудшает производительность.
-
Поддерживаемые стратегии:
- Хеширование по одному столбцу ( DISTRIBUTED BY (customer_id) ).
- Распределение по нескольким столбцам ( DISTRIBUTED BY (region_id, customer_id) ).
- RANDOM DISTRIBUTED (DISTRIBUTED RANDOMLY) — подходит для нагрузок без явной корреляции.
- Репликация, зеркала и отказоустойчивость
- Зеркала реплицируют данные первичных сегментов, что обеспечивает защиту от аппаратных сбоев и позволяет продолжить работу кластера без потери данных.
- В зависимости от версии GPDB и выбранной конфигурации зеркал, режимы репликации могут быть синхронными или асинхронными. В некоторых сценариях применяется режим "до подтверждения зеркала" для обеспечения согласованности, но это может влиять на задержки записи.
- Важности обеспечения совместимости между мастер-узлами, репликацией и сетью: сетевые задержки и варианты переналадки могут влиять на время восстановления после сбоя.
- Мониторинг и управление
- GPPerfMon (Performance Monitor) — готовый набор метрик и дашбордов, ориентированный на GPDB. Он помогает администратору следить за загрузкой сегментов, балансировкой, состоянием зеркал и производительностью запросов.
- Интеграции с внешними системами мониторинга: Prometheus, Zabbix, Grafana. В российской практики широко используются локальные решения мониторинга и локализация дашбордов на русском языке для удобства работы персонала.
- Важность планирования и автоматизации операций: gpstart, gpstop и gpconfig являются ключевыми инструментами управления кластера. Автоматизация через скрипты и планировщики (Cron, системный планировщик задач) снижает риск человеческой ошибки.
- Среда хранения и команда администратора
- Каталог данных мастера и сегментов: GPDB использует специально настроенные директории для хранения данных и WAL. В продвинутых конфигурациях часто применяются отдельные диски или массивы для данных сегментов и журналов WAL.
- Управление безопасностью: настройка доступа через pg_hba.conf, а также аутентификация через Kerberos или LDAP в рамках архитектуры GPDB.
- Резервное копирование и восстановление: ключевые инструменты gpbackup/gprestore, а также инструменты для резервного копирования каталога метаданных (например, pg_dump в отдельных случаях, но основное внимание уделяется gpbackup).
Практические примеры
Ниже приводим практические примеры, иллюстрирующие применение теоретических принципов на реальных сценариях. В качестве примера мы разделим на три блока: базовые операции, backup/restore и мониторинг/обслуживание.
Пример 1. Базовая структура кластера и создание распределённой таблицы
-
Типовая топология:
- 1 мастер (QD)
- 4 сегмента (первичные) на двух узлах
- 4 зеркала (по одному зеркалу на каждом сегменте)
-
Примечание по версии и инструментарию: используем GPDB совместимую с gpbackup/gprestore и gpstart/gpstop.
Код (условный сценарий, команды для иллюстрации):
# На мастере: создание базы и пользователя
psql -d template1 -c "CREATE ROLE gpadmin WITH LOGIN SUPERUSER CREATEDB;"
psql -d template1 -c "CREATE DATABASE analytics_owner;"
psql -d analytics_owner -c "CREATE USER gpadmin WITH SUPERUSER;"

# Пример создания таблицы с DISTRIBUTED BY
psql -d analytics_owner -c "
CREATE TABLE sales (
  sale_id BIGINT,
  customer_id INT,
  amount NUMERIC(12,2),
  sale_date DATE
) DISTRIBUTED BY (customer_id);
"

# Вставка данных (упрощенная)
psql -d analytics_owner -c "
INSERT INTO sales
SELECT generate_series(1, 1000000) AS sale_id,
       (random()*1000)::int AS customer_id,
       (random()*1000)::numeric(12,2) AS amount,
       CURRENT_DATE - (random()*365)::int AS sale_date
FROM generate_series(1, 1000000);
"

# Проверка плана выполнения
psql -d analytics_owner -c "EXPLAIN ANALYZE SELECT customer_id, SUM(amount) FROM sales GROUP BY customer_id;
"
Пример 2. Резервное копирование и восстановление с gpbackup/gprestore
- gpbackup/gprestore — открытое ПО для GPDB, поддерживает параллельное резервное копирование и восстановление по таблицам, схемам или базам данных.
Код:
# Бэкап всей базы данных analytics_owner
gpbackup -d analytics_owner -a

# Бэкап конкретной таблицы
gpbackup -d analytics_owner -t public.sales

# Восстановление в ту же базу
gprestore -d analytics_owner -i /path/to/backup_directory

# Восстановление таблицы
gprestore -d analytics_owner -t public.sales -i /path/to/backup_directory
Пример 3. Мониторинг кластера: GPPerfMon + Prometheus/Grafana + российские решения
- GPPerfMon предоставляет набор метрик, интегрируемых с Prometheus или напрямую с графическими дашбордами.
- В российских условиях часто применяется Zabbix или локализованные панели Grafana на русском языке.
Пример конфигурации Prometheus (yaml-спрос):
scrape_configs:
  - job_name: 'gpperfmon'
    static_configs:
      - targets: ['master-host:9091', 'segment-host1:9091', 'segment-host2:9091']
Пример настройки Zabbix (простая идея):
- Создать хосты для каждого узла GPDB.
- Собрать метрики через экспортер GPPerfMon или через HTTP-ендпойнты GPDB.
- Настроить триггеры на перегрузку CPU, память и задержки сети.
Пример 4. Российские решения в контексте мониторинга и эксплуатации
- Российские инструменты мониторинга, например Zabbix, используются на предприятиях для локализации инцидентов и обучения сотрудников на русском языке.
- Локализованные дашборды Grafana с русскими подписями по метрикам производительности GPDB позволяют оперативно диагностировать «узкие места» в запросах и репликации.
-
Примеры внедрения включают интеграцию GPPerfMon с Prometheus и построение дашбордов по:
- загрузке CPU на сегментах
- задержкам межузлового обмена
- состоянию зеркал
- размеру WAL-архивов
- скорости записи (throughput) и чтения (read latency)
Технические детали
- Устройство кластера и физическая топология
- Master-сервер (QD): хранит каталог и метаданные, принимает клиенты.
- Серверы сегментов: размещаются на физических узлах или виртуальных машинах. На каждом узле может быть несколько сегментов, если архитектура поддерживает параллелизм на уровне CPU и дисковых каналов.
- Зеркала: копии соответствующих сегментов, размещаются на отдельных узлах, чтобы минимизировать влияние сбоя оборудования на доступность данных.
- Хранение данных и конфигурация
- Данные сегментов физически хранятся в директориях данных, которые обычно монтируются на отдельные диски или массивы.
- Конфигурационные файлы GPDB включают настройки мастер-сервера, настройки сегментов и параметры межузловых сетевых соединений.
-
Важные параметры для настройки:
- количество сегментов на каждом узле
- режим зеркалирования (synch/async, если доступен)
- параметры сетевого времени ожидания и повторных попыток соединения
- Контроль доступа и безопасность
- Настройка pg_hba.conf на мастер-узле и сегментах для ограничения доступа по IP-адресам и методам аутентификации.
- Поддержка LDAP/Kerberos для централизованной аутентификации.
- Разграничение прав доступа к схемам, таблицам и функциям.
- Взаимодействие с инструментарием администрирования
- gpstart и gpstop: запуск и остановка кластера.
- gpconfig: управление параметрами конфигурации кластера (например, количество сегментов, размер памяти на сегмент и пр.).
- gpcreatebasis: создание базовые схем и объектов (примеры зависят от версии GPDB).
- gpbackup/gprestore: резервное копирование и восстановление данных.
- gpperfmon: мониторинг и визуализация метрик.
- Производительность и настройка
- Выбор правильного ключа DISTRIBUTED BY — один из главных факторов в производительности. Неправильный выбор может привести к перегрузке ограниченного набора сегментов и узким местам в выполнении.
- Анализ планов запросов: EXPLAIN/ANALYZE позволяет понять, как план распределяется между сегментами, где происходят перемещения (motion) и какие таблицы участвуют в операциях join.
- Параллелизм и ресурсы: размер пула памяти, количество рабочих процессов на сегменте и настройки параллелизма должны соответствовать нагрузке и размеру данных.
- Репликация зеркал и задержка записи: зеркальные копии добавляют защиту, но могут влиять на задержку записей в зависимости от режимов репликации и сетевых характеристик.
- Риски и ограничения, связанные с архитектурой
- data skew: дисбаланс в распределении данных по сегментам, ведущий к узким местам и падению производительности.
- Зависимость от interconnect: низкая скорость сети или её нестабильность напрямую влияет на время выполнения запросов, особенно тех, которые требуют перемещения данных между сегментами.
- Ограничения масштаба: добавление сегментов требует перераспределения данных, что может временно снизить производительность; это требует планирования и мониторинга.
- Управление зеркалами: синхронная репликация может влиять на задержки записи, если зеркала находятся на удалённых узлах или в условиях перегрузки сети.
- Обновления и миграции: апгрейды GPDB требуют планирования, тестирования на стендах и аккуратного переноса данных, чтобы не потерять совместимость и не нарушить работу зеркал.
- Риски операционной деятельности: неверная настройка резервного копирования, нехватка места на диске, несогласованность обновлений и конфигураций между мастером и сегментами.
- Правила безопасности и соответствие требованиям: в организациях, особенно в России при работе с персональными данными, важно обеспечить соответствие законодательству и регуляторным требованиям. Это включает хранение данных в рамках контролируемых сетей, аудит доступа, шифрование и т.д.
- Подходы к внедрению и миграциям
- Пошаговый подход к развёртыванию: начать с минимальной конфигурации (один мастер, несколько сегментов) и постепенно наращивать сегменты, тестируя на каждом шаге распределение данных и производительность.
- Тестирование планов запросов: заранее проверять планы выполнения при типичных нагрузках.
- Резервное копирование и аварийное восстановление: заранее подготовить процедуры gpbackup/gprestore и план аварийного восстановления, включая тестовые сценарии.
- Мониторинг и реагирование: внедрить дашборды мониторинга и установить пороговые значения для триггеров на аномалии (включение оповещений).
Выводы
Архитектура Greenplum, основанная на мастере, сегментах и зеркалах, обеспечивает масштабируемость и отказоустойчивость для аналитических нагрузок. Правильный выбор распределения данных, грамотная настройка параметров кластера и продуманная стратегия резервного копирования обеспечивают эффективную работу больших дата-матриц. Важно учитывать риски, связанные с межузловыми сетями, сбоями дисков и несбалансированным распределением, а также следовать методикам мониторинга и регламентам безопасности, особенно в российских реалиях, где требования к локализации и аудиту значительно возрастают.
FAQ (Вопросы и ответы)
- Что такое мастер (QD) и зачем он нужен?
- Мастер — это управляющий процесс, который принимает SQL-запросы, планирует их выполнение и координирует работу между сегментами. Он хранит каталог и метаданные кластера и отвечает за глобальное планирование запросов.
- Чем отличаются сегменты от зеркал?
- Сегменты — вычислительные узлы, на которых хранятся данные и выполняются вычисления. Зеркала — копии соответствующих сегментов, используемые для обеспечения отказоустойчивости. При сбое первичного сегмента зеркальная копия может продолжить обслуживание запросов, а затем произвести восстановление данных.
- Как данные распределяются между сегментами?
- Данные распределяются по сегментам через ключ DISTRIBUTED BY. Правильный выбор ключа распределения критически важен: он должен минимизировать перерасход движений данных между сегментами и предотвращать data skew.
- Какие инструменты используются для резервного копирования и восстановления?
- Open-source инструменты gpbackup и gprestore — позволяют параллельно копировать базы, схемы и таблицы, а также восстанавливать данные на нужном окружении. В практике часто используют их в сочетании с планами аварийного восстановления и документированными процедурами.
- Как мониторинг помогает управлять кластером?
- Мониторинг позволяет отслеживать загрузку CPU, использование памяти, задержки в межузловом обмене, состояние зеркал, скорость записи и чтения. Интеграции с Prometheus/Grafana и российскими решениями мониторинга (например, Zabbix) позволяют оперативно реагировать на отклонения и планировать масштабирование.
- Какие риски связаны с масштабированием кластера?
- Основные риски — data skew, сетевые задержки, влияние зеркал на задержку записи, перераспределение данных при добавлении сегментов и сложность миграций версий GPDB. Важно тестировать миграции на стендах и планировать перераспределение данных заранее.
- Какие сценарии подходят для Open-source решений и что можно использовать из российских решений?
- Open-source: gpbackup/gprestore, GPPerfMon, Prometheus/Grafana, Zabbix, psql-управление, EXPLAIN ANALYZE для анализа планов. Российские решения: локальные системы мониторинга на базе Zabbix или Grafana с русифицированными дашбордами, локальные консолидированные панели и обучение сотрудников на русском языке, что упрощает работу администраторов и повышает оперативность реакции на инциденты.
- Какую роль играет выбор ключа распределения?
- Ключ распределения определяет, как данные будут консолидироваться по сегментам. Неправильный выбор может привести к перегрузке отдельных сегментов и снижения производительности. Нужно проводить анализ реальных сценариев запросов и тестирования под нагрузкой.
- Какую роль играет мастер-узел в процессе обновления и обслуживания кластера?
- Мастер-узел обеспечивает координацию, планирование и контроль за выполнением операций. При обслуживании и обновлениях важно сохранить согласованность между мастером и сегментами, планировать простои и тестировать обновления на стендах.
- Какие шаги рекомендованы для начинающего администратора GPDB?
- Начать с простой и устойчивой конфигурации: один мастер, несколько сегментов, с зеркалами на отдельных узлах. Освоить gpstart/gpstop, gpconfig, gpbackup/gprestore, psql-операции по созданию таблиц и анализу планов запросов. Внедрить мониторинг (GPPerfMon + Prometheus/Zabbix) и постепенно расширять кластер, проводя тесты нагрузки и миграции версий в тестовом окружении перед рабочим переходом.
Практический вывод
Архитектура Greenplum с мастером, сегментами и зеркалами — это мощная базовая концепция для построения аналитических хранилищ на больших объемах данных. Важно помнить о ключевых практиках: грамотный выбор ключа распределения, обеспечение отказоустойчивости через зеркала, регулярное резервное копирование, мониторинг и тестирование планов запросов. В контексте российского рынка и регуляторных требований особое внимание следует уделять локализации мониторинга, аудиту доступа и локальным инструментам интеграции, что позволяет эффективнее обучать персонал и повысить устойчивость к авариям.
Вопрос–Ответ (FAQ)
- Что такое мастер (QD) и зачем он нужен?
- Мастер — управляющий процесс кластера, который принимает SQL- запросы, планирует их выполнение и координирует работу сегментов. Он хранит каталог кластера, статистику и планы выполнения.
- Как работают зеркала и зачем они нужны?
- Зеркала — копии сегментов, которые обеспечивают отказоустойчивость. При сбое первичных сегментов зеркала позволяют продолжить работу. Восстановление после сбоя позволяет вернуть данные в рабочее состояние без потери данных.
- Что влияет на производительность распределения данных?
- Важен выбор ключа DISTRIBUTED BY. Неправильный выбор может привести к data skew — неравномерной загрузке сегментов, что уменьшает параллелизм и ухудшает время выполнения запросов.
- Какие инструменты использовать для резервного копирования?
- gpbackup/gprestore — открытое ПО для резервного копирования и восстановления. Оно поддерживает параллельность и удобные режимы по таблицам, схемам и базам данных.
- Как организовать мониторинг кластера в российских условиях?
- Применяются Zabbix или Prometheus/Grafana, с русифицированными дашбордами. GPPerfMon часто интегрируется как источник метрик. Мониторинг помогает быстро выявлять перегрузки, задержки и статус зеркал.
- Какие риски наиболее критичны при внедрении GPDB?
- Data skew, задержки между мастером и сегментами, ограничения по месту на диске, сложности миграций версий, требования к безопасной аутентификации и соответствию требованиям.
- Как начать развёртывание GPDB в продакшене?
- Рекомендуется начать с минимальной топологии (1 мастер, 2–3 сегмента) и постепенно добавлять сегменты, проводя тесты планов и нагрузок. Включите резервное копирование и мониторинг на первом этапе, чтобы получить ранние сигналы об узких местах.
- Какую роль играет конфигурация сети?
- Очень важна: задержки и пропускная способность межузловой сети существенно влияют на время выполнения запросов с большим количеством перемещаемых данных. Рекомендуется выделить сеть с низкой задержкой и достаточной пропускной способностью.
- Можно ли обновляться на новую версию GPDB без простоя?
- Вопрос миграций зависит от версии. Обычно обновления требуют планирования и тестирования на стенде, а затем аккуратного переноса данных и планов выполнения. Рекомендуется иметь тестовую копию кластера и провести проверку совместимости перед обновлением.
- Что отличает GPDB от обычного PostgreSQL?
- GPDB — это MPP-система, где данные распределяются между сегментами и обрабатываются параллельно. PostgreSQL — монолитная СУБД, где все данные обычно находятся на одном узле. Greenplum добавляет механизм распределения, параллельного исполнения и зеркал, что делает её подходящей для аналитических нагрузок и больших дата-матриц.


