

Кейсы, лабораторные задания и итоговый проект
Эта глава посвящена практическим кейсам, лабораторным заданиям и итоговому проекту по эксплуатации Lakehouse-платформы с упором на мониторинг, контроль затрат, безопасность, контроль доступа и соответствие регуляторным требованиям. Мы разберем, как теоретические принципы перехода к lakehouse-архитектуре применяются на практике: от выбора технологий до реализации политик доступа, аудита и управления стоимостью. В тексте сочетаются понятные объяснения терминов, методологий и конкретные примеры реализации на базе open-source решений и отечественных российских сервисов.
- Цель главы: дать инструментарий для быстрого старта, но и глубоко погрузиться в вопросы устойчивости, рисков и ограничений внедрения.
- Формат: теория + практические примеры + технические детали + риски + выводы. В конце — FAQ.
Основные термины и концепции
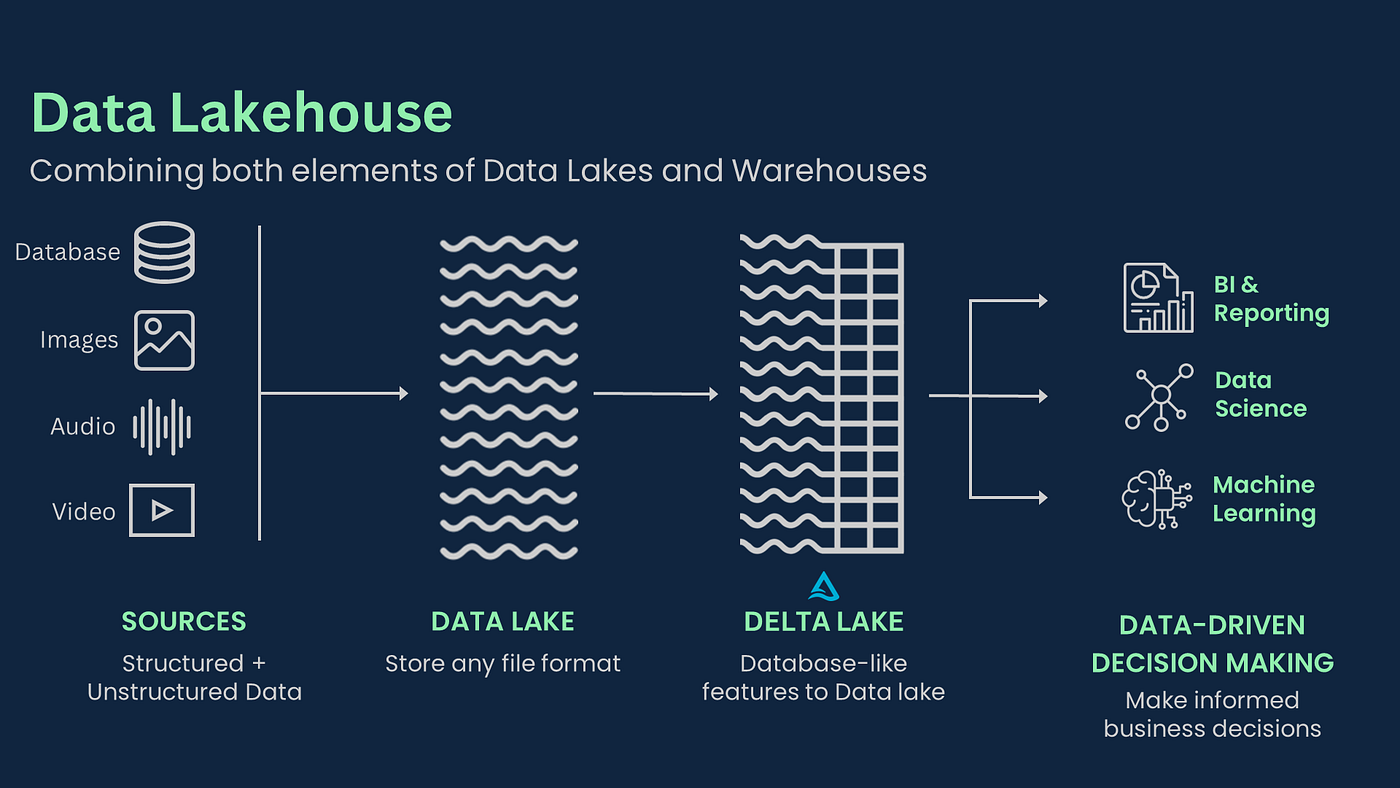
- Lakehouse: объединение сильных сторон data-lake и data-warehouse — хранение нативно структурированных и полуструктурированных данных с поддержкой транзакций, схем и версий (ACID) на уровне хранителя данных.
- Мониторинг: сбор, агрегация, хранение и визуализация метрик, логов и трассировок для работоспособности кластера, затрат и безопасности.
- Управление затратами: управление потреблением вычислительных и хранилищевых ресурсов, прогнозирование расходов, контроль несанкционированного использования и оптимизация архитектуры.
-
Безопасность и контроль доступа:
- RBAC (Role-Based Access Control) — доступ по ролям.
- ABAC (Attribute-Based Access Control) — доступ по атрибутам объектов и субъектов.
- IAM (Identity and Access Management) — единая идентификация и контекст прав.
- Policy as Code — описание политик в виде кода (например, OPA).
- Соответствие регуляторным требованиям: требования по защите данных, аудиту, хранению и обработке PII/PII-like данных, регламентам по хранению данных в РФ (регистрация данных в локальных дата-центрах, контроль копий и шифрование).
- Data governance и метаданные: каталог данных, линейность (data lineage), качество данных и управление версиями.
- Политики доступа как код: использование Open Policy Agent (OPA), Rego-политики, интеграция с IAM и системами аудита.
- Хранение и шифрование: шифрование данных на покоя и в передаче, ключи, HSM/KMS, управление жизненным циклом ключей.
- Резервное копирование и восстановления: планы DR, RPO/RTO, трафики копирования и хранение версий.
Методологии эксплуатации Lakehouse
- DevSecOps для Lakehouse: включение процессов разработки, тестирования, внедрения политик и аудита на каждом этапе цикла жизни данных.
- Постоянная соответствие: автоматизация сборки политик, аудит безопасности и регуляторных требований в процессе CI/CD.
- Архитектура слоёв данных: сырые данные (raw), очищенные (cleansed), подготовленные (curated) — с ясной версионизацией и инструментами контроля качества.
- Управление затратами как часть архитектуры: использование метрик затрат, алертов, лимитов для предотвращения перерасхода, анализ пайплайнов на предмет дорогих операций.
- Метаданные и каталог: обеспечение полноты lineage, автоматическое индексирование изменений схем и источников, поддержка бизнес-слоя.
- Безопасность и аудит: централизованный сбор и нормализация логов доступа, детальное журналирование операций над данными, мониторинг попыток несанкционированного доступа.
- Контроль данных и соответствие требованиям: политики доступа, мониторинг политик, хранение журналов доступа и изменений в течение установленного срока.
Практические примеры
В этом разделе приведены две группы примеров: (A) open-source решения и подходы к их интеграции, (B) российские/отечественные сервисы и варианты внедрения на базе отечественных технологий.
Практические примеры на базе open-source
Архитектура мониторинга и контроля доступа для Lakehouse
Компоненты:
- Хранилище: объектное хранилище (S3-совместимое или MinIO) для raw/cleansed/curated слоёв.
- Метаданные и управление версиями: Apache Iceberg или Delta Lake.
- Безопасность: Open Policy Agent (OPA) для политик доступа, Apache Ranger как дополнительный слой аудита и управления доступом (опционально).
- Мониторинг и логирование: Prometheus + Grafana для метрик, Loki или OpenSearch для логов, OpenTelemetry для трассировок.
- Контроль затрат: подсчет стоимости хранения и вычислений по метрикам и данным журнала (cost-aware dashboards).
Пример кода: политика доступа в OPA (пример на Rego)
package lakehouse.auth

default allow = false

# Разрешение для чтения таблицы по роли
allow {
  input.method = "GET"
  input.role = "data_viewer"
  input.table = t
}
Пример Terraform/Helm-манифеста для разворачивания RBAC в Kubernetes
apiVersion: rbac.authorization.k8s.io/v1
kind: Role
metadata:
  namespace: lakehouse
  name: data-reader
rules:
- apiGroups: ["data.example.org"]
  resources: ["datasets"]
  verbs: ["get", "list"]

---
apiVersion: rbac.authorization.k8s.io/v1
kind: RoleBinding
metadata:
  name: bind-data-reader
  namespace: lakehouse
roleRef:
  apiGroup: rbac.authorization.k8s.io
  kind: Role
  name: data-reader
subjects:
- kind: User
  name: alice
  apiGroup: rbac.authorization.k8s.io
Пример PySpark-задания для расчета затрат по датасету (упрощённо)
from pyspark.sql import SparkSession
spark = SparkSession.builder.appName("cost-estimator").getOrCreate()

# Пример: таблица logs_cost (dataset, storage_gb, compute_hours, price_per_gb, price_per_hour)
df = spark.read.parquet("s3://lakehouse/raw/logs_cost.parquet")
df = df.withColumn("cost", df.storage_gb * df.price_per_gb + df.compute_hours * df.price_per_hour)
df.groupBy("dataset").agg({"cost": "sum"}).orderBy("sum(cost)", ascending=False).show()
Таблица (табличная) — примеры метрик и показатели
| Метрика | Описание | Инструменты |
|---|---|---|
| storage_cost | стоимость хранения данных | Prometheus, Grafana |
| compute_cost | стоимость вычислений пайплайнов | Prometheus, Grafana |
| access_count | количество операций доступа | Loki/OpenSearch + Grafana |
| policy_violations | число нарушений политик доступа | OPA, Audit log |
| lineage completeness | полнота lineage данных | Apache Atlas / Amundsen |
Пример SQL-запроса lineage (упрощённый)
SELECT
  source_table, target_table, operation, timestamp
FROM lineage_events
ORDER BY timestamp DESC;
Практический подход к тестированию политик и соответствия
CI/CD для политик: хранение Rego-файлов в git, автоматический прогон тестов политик на выборке данных. Пример теста OPA (валидация политики)
# Пример теста с использованием OPA test
package lakehouse.auth

test_read_access {
  input := {"method": "GET", "role": "data_viewer", "table": "sales"}
  allow with input
}
Мониторинг затрат и производительности пайплайнов (open-source)
- Инструменты: Prometheus + Grafana + OpenTelemetry.
- Архитектура: экспорт метрик из Spark/ETL-пайплайнов в Prometheus, дашборды в Grafana показывают cost-by-pipeline, time-to-inspect, failure_rate.
Практические примеры на базе российских решений
Важно учитывать, что отечественные сервисы активно развиваются как инфраструктурный фундамент для дата-экосистем, включая Lakehouse-подобные архитектуры. Ниже приведены ориентировочные варианты внедрения с опорой на отечеేతехнологии и сервисы.
Архитектура на базе российского облака и локальных решений
Компоненты:
- Объектное хранилище отечественного провайдера (аналоги S3): хранение raw/cleansed/curated данных в локальных дата-центрах.
- Управление и аудит: локальные средства политики доступа и журналирования, интеграция с OPA и локальными SIEM/лог-системами.
- Мониторинг: отечественные решения для мониторинга и алертинга, интегрированные с безопасностью и логами.
- BI и аналитика: отечественный инструмент визуализации и построения дашбордов, интеграция с данными lakehouse.
Пример сценария внедрения:
- Развернуть кластер обработки (Kubernetes) в РФ-облаке.
- Развернуть Iceberg/Delta как слой хранения поверх локального Object Storage.
- Интегрировать OPA-политики для определения доступа к данным по ролям и атрибутам.
- Настроить централизованный сбор логов и метрик в локальный SIEM/кортеж логов.
- Визуализация затрат и аудита через локальные дашборды.
Яндекс.Облако как реальная платформа (пример интеграции)
Яндекс.Облако имеет набор сервисов, которые можно сочетать для реализации lakehouse-подобной архитектуры:
- Object Storage (для raw/cleansed/curated).
- Managed сервисы для аналитики и визуализации (например, DataLens для BI-слоя, DataSphere как платформа подготовки данных).
- Мониторинг и логирование через Яндекс.Облако Monitoring и Logging.
- Безопасность и доступ: интеграция с локальными политиками доступа, OPA-логика в рамках CI/CD, аудит через локальные логи и сбор в централизованный хранилище.
Вариант реализации:
- Данные загружаются в Object Storage Яндекс.Облако.
- Iceberg/Delta слой на базе открытых форматов управляется в кластере Kubernetes, развёрнутом в регионе.
- Политики доступа реализуются через OPA + интеграцию с IAM Яндекс.Облако.
- Мониторинг затрат: сбор метрик через Prometheus/Grafana и Cost-Analytics от облака.
- Визуализация: DataLens/BI через DataSphere для бизнес-пользователей.
Примеры лабораторных заданий с отечественными сервисами
Лабораторное задание 1: настройка RBAC и политики доступа
- Цель: ограничить доступ к конкретным датасетам по ролям и атрибутам.
- Инструменты: OPA + Kubernetes RBAC + Яндекс.Облако IAM.
- Шаги: развёрнуть OPA sidecar, определить политики в Rego, применить политики к пайплайнам и данным, проверить логирование попыток доступа.
Лабораторное задание 2: мониторинг затрат
- Цель: собрать и визуализировать затраты по пайплайнам.
- Инструменты: Prometheus + Grafana + локальные источники логов и метрик.
- Шаги: экспортировать метрики затрат из пайплайнов, настроить дашборд, alert-правила на превышение лимитов.
Лабораторное задание 3: аудит и соответствие
- Цель: обеспечить аудит действий над данными и соответствие требованиям.
- Инструменты: журналирование, OPA, отчёты об аудитах, хранение журналов в локальном хранилище.
- Шаги: активировать аудит на уровне доступа к данным, хранить копии журналов на длительный срок, генерировать регламентные отчёты.
Технические детали
Архитектура Lakehouse:
- Слои данных: raw -> cleansed -> curated. Версионирование через Iceberg/Delta.
- Метаданные: каталог данных, lineage, качество данных.
Безопасность:
- Доступ к данным по RBAC/ABAC.
- Шифрование на покоя и в передаче.
- Управление ключами через KMS/HSM.
Контроль доступа и политики:
- OPA + Rego для политики доступа.
- Интеграция с IAM провайдера.
- Политики должны быть тестируемы и версионируемы.
Мониторинг и аудит:
- Метрики по затратам, производительности, доступам.
- Логи доступа, изменения схем, операций над данными.
Регуляторные требования:
- Хранение данных в рамках РФ при необходимости.
- Соблюдение требований по защите персональных данных (PII/GPDR- аналог и т.д.) и аудита.
Резервное копирование и DR:
- Регулярное создание копий слоёв данных и журналов.
- Восстановление тестируется на регулярной основе.
Риски производительности и масштабирования:
- Сложность политик и их влияние на latency.
- Размер журналов аудита и требования к хранению.
- Проблемы совместимости между компонентами open-source и отечественными сервисами.
Риски и ограничения внедрения
- Компонентная сложность: координация между множеством инструментов ( Iceberg/Delta, OPA, мониторинг, SIEM, IAM) требует грамотной архитектуры и команды с опытом.
- Вендорная ловушка и зависимость от конкретной экосистемы: миграции между открытым и проприетарным ПО могут быть дорогими.
- Производительность политик доступа: обилие политик и частое их выполнение могут влиять на задержки запросов к данным.
- Масштабируемость аудита: журналирование больших объёмов операций требует эффективной инфраструктуры хранения и анализа.
- Соответствие требованиям локализации данных: хранение данных в РФ или в регионе, соответствующая сертификация дата-центров.
- Стоимость реализации: инфраструктура мониторинга, аудита и политики доступа требует затрат на оборудование/облако, обслуживание и обновления.
- Риск ошибок в политиках: неверно сформулированные политики могут блокировать легитимный доступ или, наоборот, пропускать доступ к конфиденциальным данным.
- Обновления регуляторных требований: регуляторы могут менять требования к аудитам, хранению данных и обработке PII — требуется адаптация политик и процессов.
- Безопасность конфигураций: misconfigurations в IAM, политике доступа и сетевой сегментации могут привести к утечке или несанкционированному доступу.
- Обучение и компетенции персонала: для эффективной эксплуатации нужны специалисты по Data Governance, SRE, DevSecOps и аналитику по затратам.
Выводы
- Эффективная эксплуатация Lakehouse-платформы требует сочетания теоретических знаний и практических навыков: грамотной архитектуры, политики доступа, мониторинга и контроля затрат.
- Open-source решения позволяют гибко строить архитектуру, но требуют внимательного подхода к интеграции, тестированию и поддержке.
- Российские сервисы и техническая инфраструктура дают возможность реализации соответствия требованиям локализации, аудита и экранной защиты, но их выбор следует обосновывать конкретными бизнес-целями и регуляторными требованиями.
- Главная идея: безопасность, прозрачность и стоимость должны быть встроены в процесс на ранней стадии проекта, а не добавлены позднее.
FAQ — Вопросы и ответы
1) В чем преимущество Lakehouse по сравнению с традиционными хранилищами данных?
- Lakehouse сочетает гибкость data-lake (масштабируемость, хранение полуструктурированных данных) с поддержкой транзакций и схем как в data-warehouse, что позволяет быстрее разворачивать аналитические пайплайны и сохранять согласованность данных. Это облегчает мониторинг и соблюдение регуляторных требований за счет единых версий и lineage.
2) Какие политики доступа вы рекомендуете для начинающего проекта?
- Начните с RBAC на уровне кластера и хранения данных, затем добавьте ABAC по атрибутам пользователей и объектов. ВEEDEDите политики как код через OPA, чтобы обеспечить повторяемость и тестируемость. Включите аудит в централизованную систему логирования.
3) Какие инструменты для мониторинга затрат подходят для Lakehouse?
- Лёгко адаптируемый набор: Prometheus для сбора метрик, Grafana для дашбордов и алертов, а также журналы и метрики затрат из облака. Для локальной инфраструктуры можно добавлять скрипты расчета стоимости по объему хранения и вычислений, как в примере PySpark.
4) Какие риски связаны с внедрением политик доступа и аудита?
- Главное — неверные политики block access, leading to user friction, или наоборот, пропуск доступа к чувствительным данным. Тестирование политик, тестовые окружения и CI/CD для политик помогают снизить риски.
5) Как обеспечить соответствие регуляторным требованиям в РФ?
- Размещайте данные в региона РФ (при необходимости), применяйте шифрование и управление ключами, реализуйте детальный аудит и хранение журналов на срок, соответствующий регуляторным требованиям, и следите за обновлениями требований.
6) Что делать, если команда не знакома с Open Policy Agent?
- Начните с основ Rego и простых политик, затем разворачивайте OPA в тестовом окружении, создайте набор тестов для политик и постепенно добавляйте более сложные правила.
7) Какой подход к миграции на Lakehouse безопаснее?
- Итеративный подход: заменить поэтапно пайплайны, сохранить существующие источники и шаги миграции, пилотные проекты с ограниченным набором данных, мониторинг и аудит на каждом этапе, чтобы выявлять проблемы до масштабирования.
8) Какие открытые форматы хранения лучше выбрать?
- Iceberg и Delta Lake — популярные форматы, поддерживающие транзакции и версионирование. Выбор зависит от ваших инструментов анализа и экосистемы: Iceberg часто выбирают для гибкой архитектуры, Delta Lake — для экосистем Delta и интеграции в Spark.
9) Что особенности российского внедрения стоит учитывать?
- Не забывайте о локализации данных, совместимости сервисов и сертификациях дата-центров. Внедрения на отечественных платформах часто требуют специфической интеграции политик доступа и локальных инструментов мониторинга и аудита.
10) Что важнее на старте: безопасность или функциональность?
- Баланс: на старте заложите базовую безопасность и контроль доступа, затем наращивайте функциональность: мониторинг, аудит и соответствие. Наличие базовых политик и журналов поможет избежать серьезных проблем на поздних стадиях проекта.
Lakehouse — это основа современной data-стратегии и масштабируемой аналитики. Узнайте, как мы внедряем Lakehouse-архитектуру, которая объединяет данные, снижает издержки и ускоряет принятие управленческих решений.


