

Data-каталоги: эволюция архитектур, управление данными и метаданными, безопасность и внедрение в BI, ML и DataOps
Данные сегодня выступают в роли стратегического актива организаций. Их ценность растет пропорционально объему, разнообразию источников и скорости их обращения. Однако скорость извлечения нужной информации из множества баз данных, хранилищ и сервисов существенно ограничена без единой надстройки над источниками данных. В этом контексте data-каталоги выступают как центральное хранилище сведений о структуре, свойствах и отношении между данными, обеспечивая единый вход в мир данных для разнородных ролей: от инженеров данных до руководителей data-направлений и ИТ-директоров.
Цель данной статьи — систематизировать представления о data-каталогах, их сущностях, функциональности и архитектурных эволюциях. Особое внимание уделяется трех поколениям каталогов, их сильным и слабым сторонам, а также практике внедрения в рамках BI, машинного обучения (ML/AI) и DataOps. Мы — архитекторы образовательных программ и практики корпоративного обучения в области данных и цифровой трансформации — предлагаем структурированное руководство, которое помогает выбрать инструменты, определить стратегию интеграции и выстроить управляемые процессы качества и безопасности данных.
Ключевые идеи этого раздела:
- data-каталоги выступают как «единую точку входа» к данным и их метаданным, уменьшающие фрагментацию горизонтов и ускоряющие поиск, понимание и воспроизводимость.
- они охватывают две доменные области применения: (1) построение пайплайнов ETL/ELT и управления дата-инфраструктурой и (2) исследование данных, аналитическую работу и научные проекты.
- эволюция каталогов проходит через три поколения, каждое со своими архитектурными паттернами, технологиями и бизнес-помощниками, а выбор конкретного решения должен опираться на сценарий, требования к безопасности, размер экосистемы и способность к автоматизации.
В контексте корпоративной трансформации data-каталоги становятся не просто инструментами каталогизации, но базовой платформой для согласования между бизнесом и ИТ, обеспечения прозрачности происхождения данных, мониторинга качества и обеспечения воспроизводимости аналитических и ML-проекта. В последующих главах мы детализируем эти аспекты и приводим практические рекомендации по реализации, интеграциям и выбору решений.
Определение data-каталога: сущности, функции и аудитория
Data-каталог — это централизованное хранилище информации о данных: их структурах, свойствах, зависимостях и контекстах использования. Он фиксирует не только технические характеристики наборов данных, но и правила поведения, контракты загрузки, требования к качеству и разрешение доступа. Основная идея состоит в том, чтобы преобразовать фрагментарные, разобщенные источники знаний в единое и доступное полотно, которое поддерживает исследование, управление рисками и оперативную работу команд.
Ключевые сущности data-каталога:
- активы данных: датасеты, таблицы, представления, файлы, метаданные API и витрины данных;
- схемы и поля: структуры, типы данных, ограничения, теги и описания;
- пайплайны и процессы: задачи ETL/ELT, DAG-структуры, зависимости;
- метаданные об использовании: запросы, частота обращений, профили данных, качество;
- политики и контракты загрузки: правила добавления, обновления, удаления данных, требования к правам доступа;
- данные о пользователях и ролях: идентификаторы, группы, правила аутентификации и авторизации;
- линейность и происхождение: цепочка источников, выполнение пайплайнов, трассируемость до источников.
Функциональности, которые обычно предоставляют data-каталоги:
- поиск и исследование данных: полнотекстовый поиск по названиям, тегам, описаниям и полям;
- управление доступом: политики на основе ролей, атрибутов и директив;
- отслеживание происхождения и линейности данных: трассировка от источника до потребителя;
- конфигурация источников и загруженных данных: настройка коннекторов, контрактов, схему и трансформации;
- обеспечение качества данных: правила валидации, мониторинг показателей качества, уведомления;
- поддержка воспроизводимости: фиксация версий наборов данных, история изменений;
- интеграции с инструментами BI/аналитики и ML/AI: коннекторы к дашбордам, испытаниям, экспериментам и моделям.
Аудитория data-каталога в организациях обычно мультиуровневая:
- дата-инженеры и инженеры данных: поиск источников, загрузка метаданных и поддержка контрактов;
- дата-аналитики и бизнес-аналитики: быстрая идентификация доступных наборов данных, понимание контекста и ограничений;
- лидерство по данным и менеджеры проектов: контроль рисков, соответствие требованиям и прозрачность процессов;
- специалисты по качеству данных и steward-руководители: мониторинг правил, дефектов и планов улучшения;
- специалисты по безопасности и ИТ-директора: управление доступами, соответствие политикам и аудит изменений.
С учетом разнообразия ролей и задач, в современных архитектурах актуален баланс между гибкостью и управляемостью: каталоги должны быть достаточно формализованы для сценариев контроля и аудита и в то же время понятны операторам и исследователям.
Каталоги данных: две доменные области и их сценарии использования
Современные data-каталоги охватывают две доменные области и соответствуют различным сценариям использования.
Каталоги для построения пайплайнов ETL/ELT (data-engineering oriented):
- ориентированы на точное местоположение и формат данных;
- обеспечивают ускорение разработки и эксплуатации пайплайнов, репликацию и консолидацию метаданных;
- поддерживают строгие контракты загрузки и обратную совместимость;
- сценарии: обнаружение источников, конфигурация источников данных, мониторинг этапов консолидации, управление удалением данных по политике.
Каталоги для исследования данных (data-analyst и data-science oriented):
- сфокусированы на исследовании схем, полей, тегов, схемах API и использованиях;
- обеспечивают богатый поиск, профилирование наборов данных и визуализацию зависимостей;
- поддерживают потоковую и историческую составляющую изменений метаданных;
- сценарии: поиск и исследование данных, обзор тэгов, отслеживание изменений и версий, подготовка наборов для анализа и моделей.
Понимание этих двух доменных областей позволяет выбрать подход к архитектуре каталога, определить границы ответственности команд и выработать контрактные соглашения между дата-аналитиками, дата-инженерами и службами безопасности. Важной является не только техническая реализация, но и управляемость процессов, которые обеспечивают единое восприятие и единое лицо к данным во всей организации.
4. Эволюция data-каталогов: поколения и их ключевые особенности
Современная практика выделяет три поколения data-каталогов, каждое из которых характеризуется уникальным набором архитектурных паттернов, контрактов и автоматизаций. Понимание этой эволюции помогает не только выбрать инструмент под текущие потребности, но и спроектировать дорожную карту роста каталога.
Поколение 1: простейшие реализации, «здесь и сейчас»
- базовые компоненты: источники данных, индекс-поиск, приложение-клиент;
- архитектура основана на pull-модели: данные запрашиваются из внешних систем и копируются в слой метаданных;
- примеры инструментов на рынке: Amundsen, Lexikon, Artifact, DataPortal;
- сильные стороны: минимальные требования к инфраструктуре и оперативность развёртывания;
- ограничения: отсутствие стабильной истории изменений, ограниченная поддержка описательных метаданных, риск устаревшей информации и «хрупкость» обновления источников; отсутствие масштабируемости в контексте множества источников и запросов.
Поколение 2: углубленная интеграция и управляемость
- архитектура строится вокруг push-модели: данные и метаданные поступают в каталог через управляемые загрузки с контрактами;
- включает полнотекстовый поиск по наборам данных и более глубокую структуризацию;
- преимуществами являются наличие готовых API для загрузки и возможности планирования и автоматизации процессов очистки и нормализации;
- недостатки: отсутствие журналирования изменений, ограниченная поддержка потоковых изменений и зависимостей между источниками, плотная зависимость от центральной команды по метаданным, потенциал трудностей с масштабированием и консистентностью между источниками.
Поколение 3: продвинутое управление данными и детальная синергия модульной архитектуры
- используются потоковые API (или CRUD через сервисные API каталога) и создания журнала изменений метаданных;
- индексы и хранилища изменений способны поддерживать различные типы индексов: поисковые, графовые и временные версии;
- строгая типизация метаданных и взаимосвязей, обеспечивающая обратную совместимость и предсказуемость поведения потребителей;
- примеры решений третьего поколения: DataHub, Apache Atlas, Egeria, Uber DataBook;
- преимущества: независимость от центральной команды, возможность автономной разработки и расширяемой архитектуры, поддержка автоматизированного редактирования и синхронизации;
- ограничения: развёртывание большого набора микросервисов, требовательность к стеку технологий и комплексность эксплуатации.
Эта эволюционная цепочка демонстрирует, как переход от простого к сложному сопровождается ростом функциональности, управляемости, масштабируемости и способности к автоматизации. В реальной практике выбор поколения должен соответствовать зрелости организации, масштабу экосистемы данных, потребностям в автоматизации и скорости внедрения изменений.
Поколение 1: архитектура, примеры и ограничения
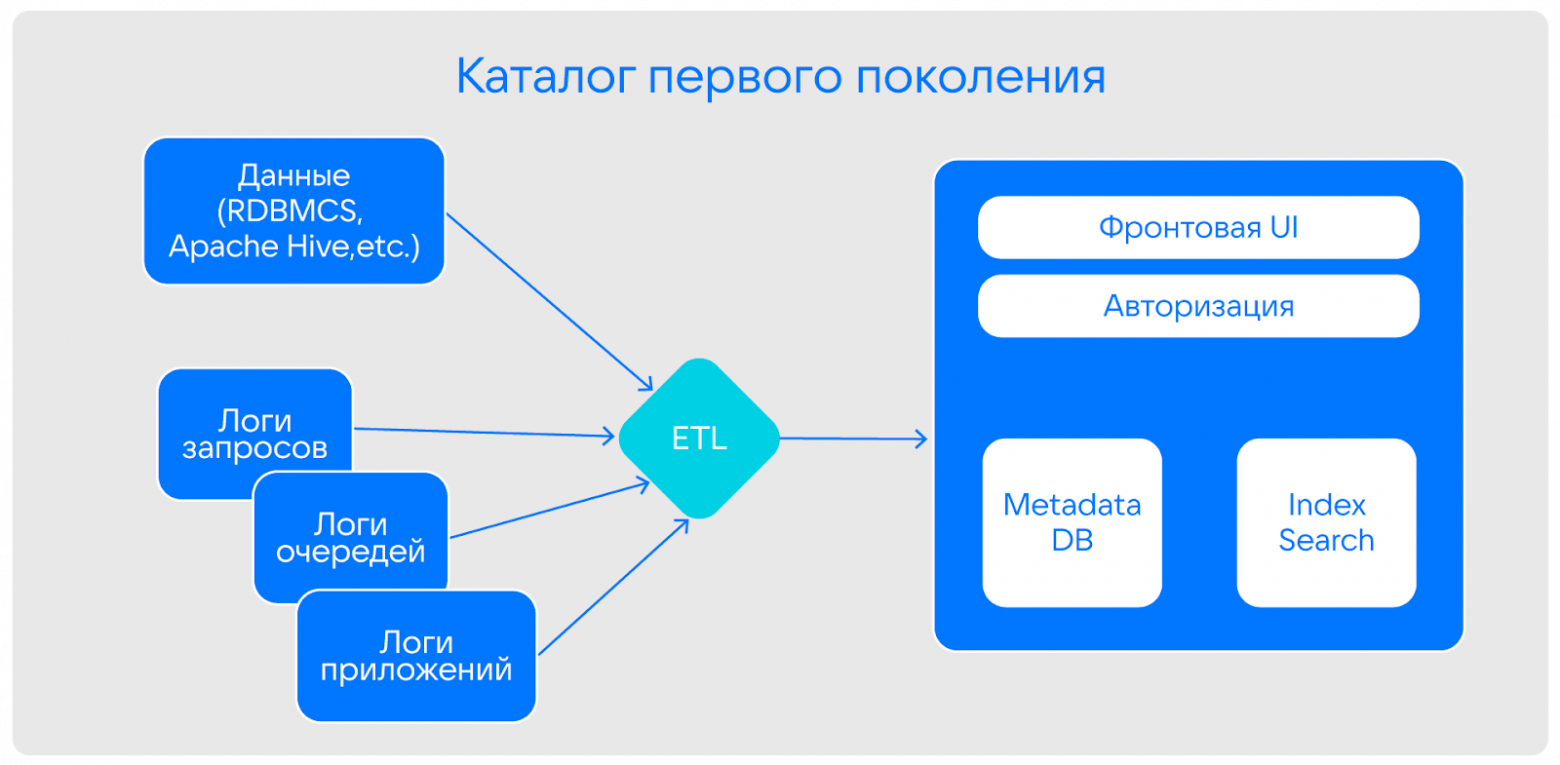
Первые поколения каталогов подошли к задаче как «надстройка» над существующими хранилищами без глубокой переработки инфраструктуры. Архитектура таких систем обычно выглядит как набор трёх компонентов: источники данных, ETL-инструмент для индексирования (или полнотекстовый поиск) и клиентское приложение, обращающееся к данным «под капотом».
Архитектура:
- источники данных: базы данных, логи, очереди, приложения;
- слой индексации: простой индекс или полнотекстовый поиск по именам объектов и полям;
- приложение-плейсхолдер: интерфейс доступа к разрозненным данным.
Примеры решений: Amundsen, Lexikon, Artifact, DataPortal.
- Amundsen предлагает механизмы обнаружения данных и метаданных, поддерживает OIDC для авторизации и имеет широкий набор коннекторов к BI-инструментам. Однако полнотекстовый поиск ограничен тегами, таблицами и полями в целом, без описания колонок и без истории изменений наборов данных.
- Lexikon, Artifact и DataPortal отражают схожую концепцию: минимальные требования к инфраструктуре, но ограниченная функциональность в части живой истории изменений и в части расширенной метаинформации.
Преимущества поколение 1:
- низкие затраты на внедрение и эксплуатацию;
- быстрый старт и простота поддержки;
- возможность быстрого прототипирования.
Ограничения: -pull модель означает, что данные часто устаревают и индексация может быть не своевременной;
- необходимо вручную добавлять источники и коннекторы при росте экосистемы;
- нет достаточной поддержки версий и журнала изменений;
- ограниченная способность к сложной аналитике по зависимостям между наборами данных.
Практические выводы:
- для старта проекта в рамках ограниченной команды и небольшого числа источников такие решения подходят;
- при росте числа источников требуется переход к более автоматизированной архитектуре и модели изменения метаданных.
6. Поколение 2: архитектура, примеры и ограничения
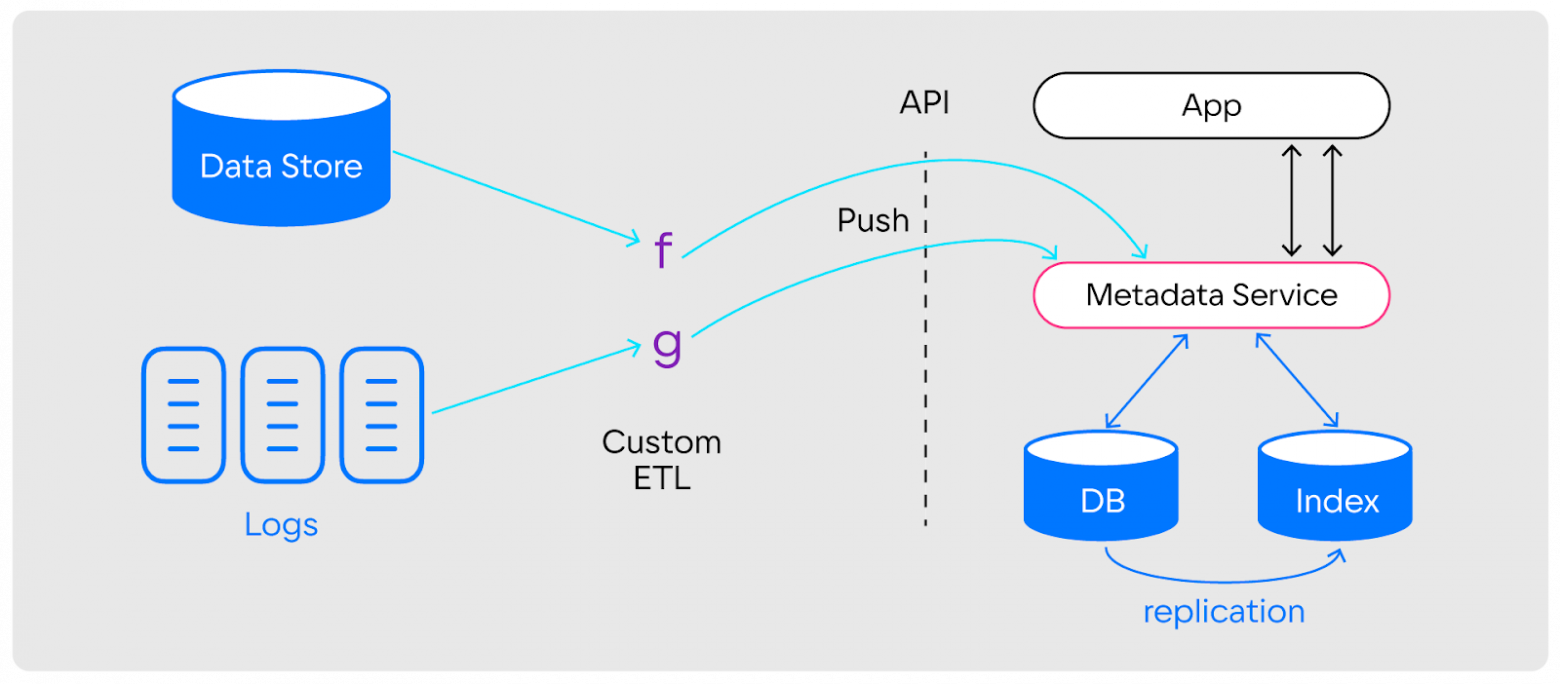
Поколение 2 вводит более функциональные механизмы интеграции и управления данными. Архитектура становится более «продуманной» за счёт перехода к push-модели, контролируемым контрактам и более глубокой структуры метаданных.
Архитектура:
- источники данных и сервисы отправляют метаданные и данные об изменениях в каталог через управляемые загрузки (Push API);
- слой обработки и очистки данных (ETL/ELT-процессы) фильтруют и нормализуют данные для индекса;
- Хранилище метаданных с индексируемым полнотекстовым поиском и кластером реплицируемых БД;
- интеграция с приложением через унифицированный API и поддержка рабочих контрактов на читаемость и запись.
Примеры решений: ряд проектов с более полной реализацией форматов и контрактов, которые переходят к push-модели и более надежной обработке данных. Преимущества: - более предсказуемая доставка метаданных и данных; - упрощение взаимодействия между командами разработчиков и командами по данным благодаря четким контрактам; - возможность более легкой автоматизации (сквозная диагностика, мониторинг, журнал изменений).
Ограничения:
- отсутствуют универсальные механизмы полного журнала изменений: иногда отсутствует потоковая передача изменений метаданных;
- зависимость от центральной команды по метаданным может сохраняться; не всегда можно вписать все процессы обработки данных из разных источников в существующую архитектуру.
Практические выводы:
- поколение 2 лучше подходит для компаний, которым требуется более глубокая интеграция источников, повышение качества и стабильности загрузки метаданных;
- оно полезно при необходимости начать централизованное управление, не выходя за рамки существующей инфраструктуры.
Поколение 3: архитектура, примеры и ограничения
Поколение 3 представляет собой наиболее развитую и амбициозную конфигурацию каталога данных, где автоматизация, гибкость, масштабируемость и совместимость становятся основными требованиями. Эти каталоги могут обслуживать потоковые обновления и управлять сложной зависимостью между данными и процессами.
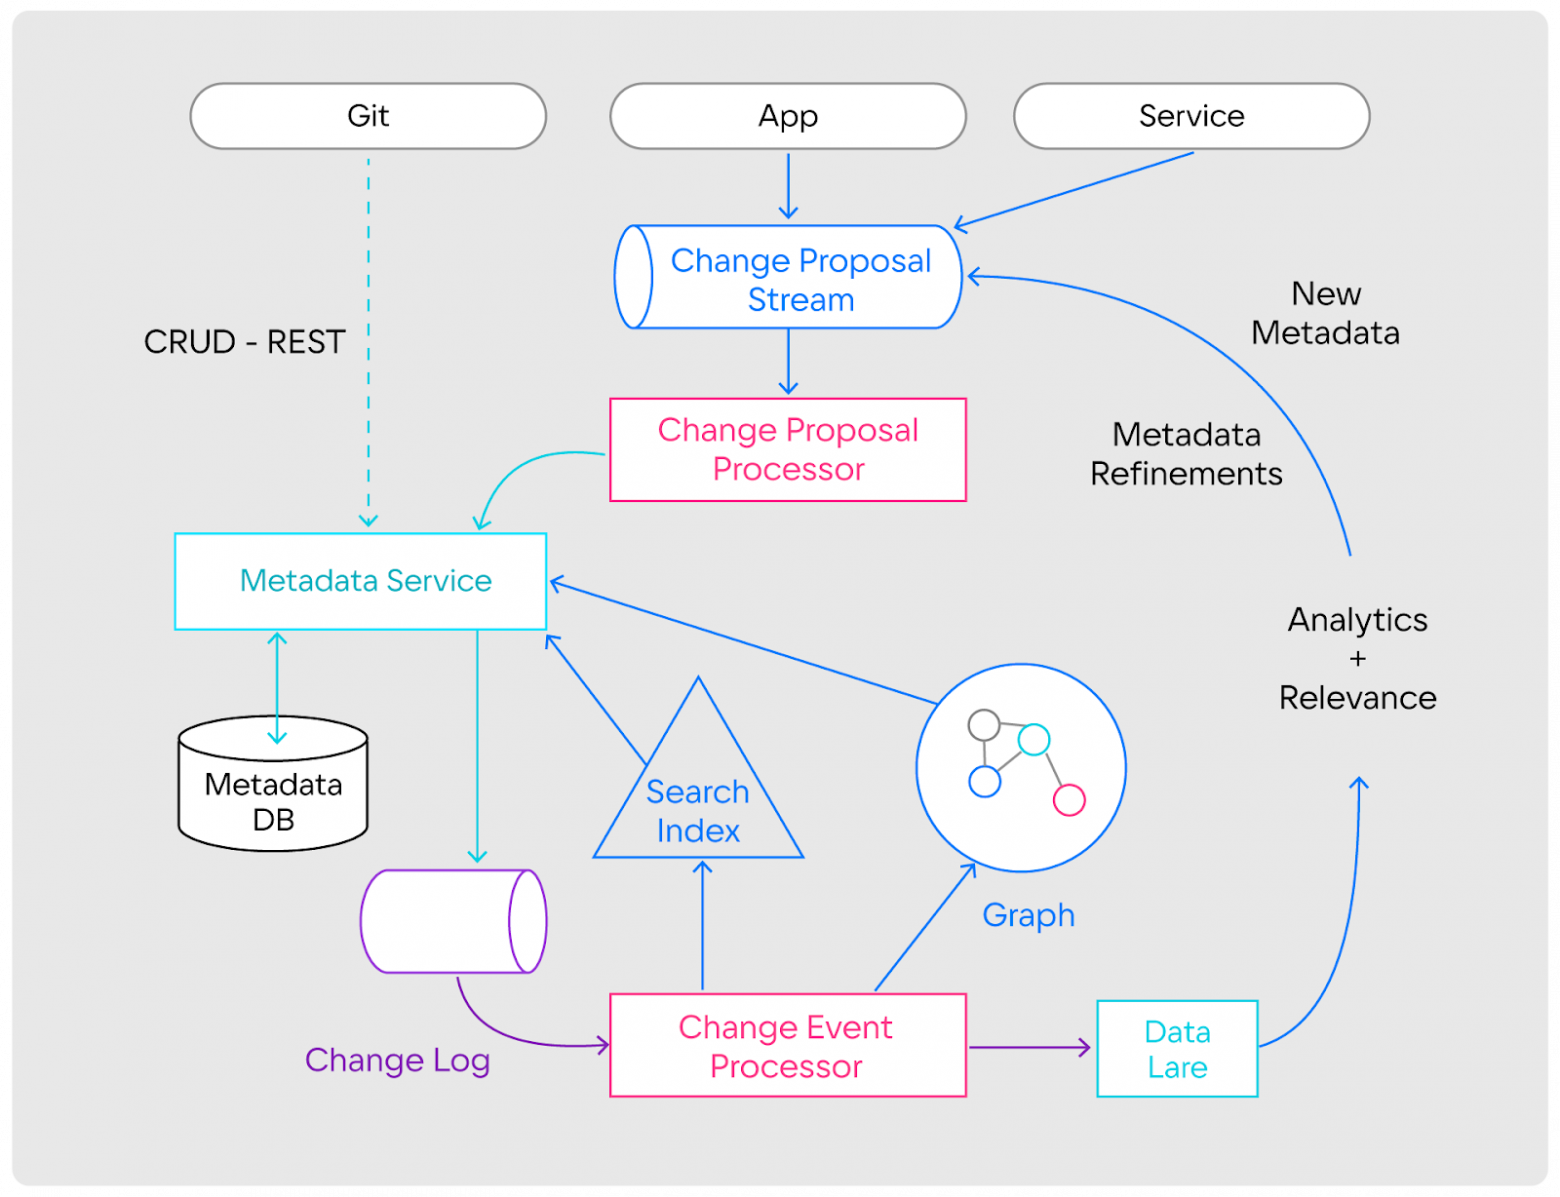
Архитектура:
- поддержка потоковых API и CRUD-операций на уровне сервисов каталога;
- журнал изменений метаданных, который может доставляться в поисковый индекс, графовый индекс, озеро данных (data lake) и OLAP-хранилище;
- разветвленная архитектура БД метаданных с поддержкой различных хранилищ и индексов;
- строгая типизация и расширяемые модели метаданных для обеспечения совместимости и предсказуемости поведения потребителей;
- модули для автоматизации редактирования данных и синхронизации между системами.
Примеры решений: DataHub, Apache Atlas, Egeria, Uber DataBook.
- DataHub — один из немногих крупных открытых проектов третьего поколения; обладает широким набором коннекторов, интеграцией с LDAP через Policy Engine, поддержкой MLflow, Spark, Kafka, Kafka Connect и другими инструментами.
- Apache Atlas — фокус на право доступа, линейность и метаданные в рамках экосистем Hadoop.
- OpenMetadata и другие — стремление к модульности и расширяемости, но могут требовать более сложной развертывания и настройки.
Преимущества:
- отсутствие зависимости от единственной команды по данным; возможно распределенное развитие и совместная работа между командами;
- поддержка сквозной автоматизации: от ingestion до индексации и зависимости; возможность подключения ETL-операций поверх метаданных без потери их согласованности;
- расширяемость и гибкость в отношении типов и свойств метаданных.
Ограничения:
- высокая стоимость внедрения: разворачивание большого набора микросервисов, интеграций и инфраструктуры;
- сложность эксплуатации и поддержки, требующая специализированной компетенции;
- необходимость выстраивания политик безопасности, мониторинга и соответствия.
Практические выводы:
- поколение 3 подходит для крупных организаций с обширной экосистемой данных и жесткими требованиями к автоматизации, безопасности и воспроизводимости;
- выбор DataHub и сопутствующих решений в рамках открытого стека может быть оправдан высоким уровнем гибкости и экосистемой интеграций.
Архитектура data-каталога: компоненты, данные и взаимодействия
Современная архитектура data-каталога обычно строится вокруг трех основных слоёв: ingestion и обработка метаданных, хранилище метаданных и потребительский слой с API и UI. Важной частью выступают модули безопасности и управления доступом, а также компоненты для обеспечения линейности и воспроизводимости.
Компоненты ingestion и обработки:
- коннекторы источников: БД, дата-лакты, API, журналы и очереди;
- конвейеры загрузки с контрактами: push-поставки, точные правила трансформации и очистки;
- сервисы совместной обработки и нормализации: унификация форматов, согласование схем, обработка тэгов.
Хранилище метаданных и индексы:
- база метаданных (реляционная БД или специализированное хранилище);
- полнотекстовый поиск и индексы для быстрых запросов;
- графовые индексы для отображения зависимостей и lineage;
- журнал изменений и версии метаданных.
Потребительский слой:
- API для интеграции с BI-системами, инструментами визуализации, ML-экспериментами;
- UI для исследования данных, профилирования и управления данными;
- механизмы уведомлений и мониторинга.
Безопасность и управление доступом:
- политики доступа на основе ролей и атрибутов;
- аутентификация и интеграция с LDAP/Active Directory;
- Policy Engine для централизованного управления правилами и соответствием.
Взаимодействие и взаимодействия:
- событийно-ориентированная архитектура: изменение метаданных порождает события, которые потребляются в редакторы индексов и журналы;
- контракты между системами обеспечивают согласованность данных и их представления;
- совместная работа с инструментами BI, ML и DataOps для полного цикла жизненного цикла данных.
Эта архитектура обеспечивает единое лицо к данным, поддерживает наборы данных и их связи, историзирует изменения и упрощает спрос на данные для аналитиков и ученых. Важно, чтобы архитектура была адаптивной и поддерживала рост экосистемы без потери управляемости и безопасности.
Метаданные и сбор: pull vs push, потоковые обновления, контракты
Управление метаданными требует выбора подходов к сбору и обновлению информации. В современном контексте используются сочетания pull и push моделей, а также потоковые обновления и контракты.
Pull-модель:
- каталог инициирует сбор данных, обращаясь к внешним системам;
- преимущество: простота, меньшая зависимость от источников;
- недостатки: задержки в синхронизации, устаревшие данные и риск несовместимости при изменениях источников.
Push-модель:
- источники данных и сервисы отправляют обновления напрямую в каталог;
- преимущество: своевременность и точность;
- недостатки: необходимость синхронизации контрактов, обработчиков и версий между источниками и каталогом.
Потоковые обновления (streaming):
- метаданные и изменения передаются в каталог как непрерывный поток;
- позволяют поддерживать «живую» видимость и быстрый отклик на события;
- требует инфраструктуры очередей, брокеров и обработчиков.
Контракты:
- формализованные соглашения между источниками и каталогом об формате, частоте обновлений, допустимых изменениях и ответственности;
- помогают обеспечить согласованность и облегчить масштабирование;
- позволяют реализовать политики удаления и псевдонимизации на уровне каталога и источников.
Правильное сочетание этих подходов обеспечивает баланс между своевременностью и надежностью, минимизирует задержки и риск неконтролируемого доступа к данным. В крупных средах рекомендуется внедрять потоковые обновления, поддерживаемые контрактами, чтобы обеспечить прозрачность изменений и возможность быстрого реагирования на инциденты.
Хранение и индексация: хранилища, полнотекстовый поиск, версии изменений
Эффективное хранение и индексирование метаданных — ключ к быстрому поиску и устойчивой навигации в экосистеме данных. Оптимальная конфигурация зависит от объема данных, скорости изменений и требований к доступности.
Хранилища для метаданных:
- реляционные базы данных (PostgreSQL, MySQL) или специализированные хранилища;
- поддержка транзакций, версионирования и журналирования изменений;
- обеспечивают консистентность и точность при обновлениях.
Поисковые индексы:
- полнотекстовый поиск по набору данных, тегам, описаниям и другим свойствам;
- графовые индексы для отображения зависимостей между наборами данных и пайплайнами;
- альтернативные решения: OpenSearch/Elasticsearch для масштабируемости.
Версии изменений:
- фиксирование версий метаданных и изменений в каждом наборе данных;
- возможность «вернуться» к предыдущим состояниям;
- поддержка журналирования событий и аудита;
- псевдонимизированные версии для безопасной обработки чувствительных данных.
Архитектурная практика:
- разделение метаданных и данных об использованию;
- обеспечение согласованности между индексом, графовым лендингом и источниками;
- поддержка таблиц изменения и шардирования в зависимости от объема.
Комбинация хранилища, полнотекстовых и графовых индексов обеспечивает не только эффективный поиск, но и моделирование зависимостей между данными и процессами. Важно, чтобы архитектура поддерживала прозрачность версий и возможность воспроизводимости для исследований и аудитов.
Линейность данных, трассировка и аудит: происхождение, прозрачность, воспроизводимость
Линейность данных и трассировка (data lineage) — критические элементы для доверия к данным и воспроизводимости аналитических моделей. Они позволяют проследить путь данных от источников до конечных потребителей, а также понять, какие пайплайны, какие наборы данных и какие трансформации повлияли на результат.
Источник происхождения:
- фиксирование источников данных, их форматов и изменений;
- документирование пайплайнов: этапы, параметры, версии инструментов.
Трассировка и зависимостей:
- отображение графа зависимостей между наборами данных, задачами ETL/ELT и итоговыми витринами;
- возможность визуализации линейности в UI и через API.
Аудит и воспроизводимость:
- журнал изменений метаданных, включая авторов, временные метки и причины изменений;
- возможность воспроизведения анализа при повторной загрузке данных с теми же параметрами;
- поддержка аудита доступа и изменений, чтобы отслеживать, кто и что изменял.
Важные аспекты:
- обеспечение совместимости между линейностью и безопасностью доступа;
- интеграция lineage с инструментами мониторинга качества данных;
- поддержка моделей для ML/AI, где lineage важна для документовизации обучающих данных и регрессионной верификации.
Эффективная трассировка требует не только технических решений, но и культуры документирования и ответственности команд за данные. Прозрачность происхождения данных и воспроизводимость экспериментов — основа доверия к аналитическим выводам и моделям AI.
Качество данных и контроль: правила качества, мониторинг и отчетность
Качество данных — критический фактор успешности аналитических проектов и ML-инициатив. Каталоги данных должны не только фиксировать качество, но и активно стимулировать улучшение, предлагая правила, правила проверки и механизмы мониторинга.
Правила качества данных:
- наборы правил и пороговые значения для валидности данных (например, диапазоны значений, диапазонные проверки, уникальность ключей);
- политики управления качеством: автоматическая коррекция, пометка некорректных значений, отложенная загрузка;
- поддержка контрактах по качеству на уровне источников и наборов данных.
Мониторинг и отчетность:
- дашборды по качеству данных, которые показывают долю корректных записей, процент пропусков, инциденты;
- уведомления и алерты при нарушениях;
- регламенты и отчеты для аудита соответствия нормативам.
Поддержка автоматизации:
- профилирование данных и анализ статистик на уровне полей и таблиц;
- автоматическое выявление отклонений от норм, ретрансляция данных и исправления;
- интеграция с системами мониторинга и уведомлениями.
Роли и ответственность:
- steward-менеджеры и ответственные за данные следят за соблюдением правил;
- IT-администраторы обеспечивают техническую поддержку и мониторинг инфраструктуры;
- аналитики и учёные должны следовать установленным контрактам и правилам.
Качество данных — это не разовые проверки, а непрерывный процесс управления данными, который требует как статистических методик, так и управленческих процедур. В сочетании с линейностью и трассировкой это создает основу для доверия к данным и моделям.
Управление доступом и безопасностью: политики, аутентификация, LDAP, Policy Engine
Безопасность данных в рамках data-каталога — первостепенная задача. Эффективная политика доступа обеспечивает защиту ценной информации, соответствие требованиям регуляторов и минимизацию рисков утечки.
Политики доступа:
- RBAC (role-based access control) и ABAC (attribute-based access control) — модели управления;
- политики на уровне каталогов, наборов данных, полей и действий (чтение, запись, удаление);
- поддержка континуальных изменений и аудита.
Аутентификация и интеграции:
- поддержка OIDC (OpenID Connect), OAuth 2.0 для внешних аутентификаторов;
- LDAP (Lightweight Directory Access Protocol) и Active Directory для корпоративной аутентификации;
- интеграция с существующими механизмами безопасности в организации.
Policy Engine:
- централизованный движок для применения политик в реальном времени;
- обеспечивает согласованность между запросами пользователей и доступами к данным;
- упрощает управление ролью и доступами при изменении требований.
Безопасность данных и соответствие:
- контроль доступа к данным, включая ограничения на чувствительные данные и персональные данные;
- возможность псевдонимизации и маскирования некоторых наборов данных;
- аудит доступа и мониторинг событий безопасности.
Эти элементы обеспечивают баланс между доступностью данных для аналитиков и защитой критически важных данных. Гибкость в управлении политиками и использование централизации в Policy Engine позволяют быстро адаптироваться к изменениям бизнес-требований и регуляторной среды.
Обеспечение объяснимости и воспроизводимости моделей AI
Объяснимость и воспроизводимость моделей AI являются критическими элементами надёжности цифровой трансформации. Data-каталог выступает как связующее звено между данными, их происхождением и экспериментами, которые приводят к обученным моделям.
Прозрачность источников:
- фиксирование источников данных, их версий и ограничений;
- документирование ограничений и предположений, касающихся данных.
Принципы воспроизводимости:
- хранение версий обучающих наборов данных, параметров экспериментов и используемого кода;
- логирование метрик и результатов по каждому обучающему прогонию;
- возможность повторного запуска обучения с теми же данными и параметрами.
Трассировка и зависимостей для моделей:
- связывание моделей с конкретными наборами данных и пайплайнами;
- фиксация зависимостей между версиями библиотек и фреймворков;
- предоставление метаданных о метриках качества и интерпретации.
Объяснимость моделей:
- включает трактовку признаков, влияние признаков на решения и агрегацию объяснений;
- хранение артефактов объяснимости и политик их использования.
Безопасность и приватность ML-экспериментов:
- управление доступом к обучающим данным и конфиденциальной информации;
- маскирование и анонимизация данных там, где это необходимо.
Обеспечение объяснимости и воспроизводимости моделей AI в рамках data-каталога требует тесной интеграции с инструментами ML/AI, такими как MLflow или аналогичные платформы, а также с процессами DataOps, обеспечивающими повторяемость, версионирование и детальные логи. Это является не только техническим требованием, но и стратегическим элементом доверия к решениям на базе данных и моделей.
Интеграции и синергия: BI/аналитика, ML/AI, ETL, DataOps
Эффективная экосистема каталогов требует тесной интеграции с основными инструментами и процессами, обеспечивающими конвергенцию данных в бизнес-ценности.
BI/аналитика:
- коннекторы к популярным инструментам бизнес-аналитики (Tableau, Power BI, Superset и т. п.);
- поддержка быстрого доступа к наборам данных через единый каталог и метаданные;
- возможность совместного использования данных и понимания ограничений.
ML/AI:
- интеграция с инструментами экспериментов и моделей (MLflow, Kubeflow);
- поддержка трекинга данных и параметров обучения, метрик и версий моделей;
- связь между данными и обучающими артефактами для воспроизводимости.
ETL и DataOps:
- единая платформа для конфигурации источников, контрактов загрузки и мониторинга качества;
- поддержка CI/CD процессов для данных и моделей;
- автоматизация процессов обработки, тестирования и развертывания пайплайнов.
Интеграционная архитектура:
- использование API в качестве основного интерфейса для потребителей и поставщиков данных;
- событийно-ориентированная инфраструктура для передачи изменений;
- политика безопасности, совместимая с DataOps и DevOps практиками.
Синергия между бизнеc-аналитикой, ML/AI, ETL и DataOps обеспечивает не только более быстрый цикл разработки и внедрения, но и улучшение качества принятых решений за счет единообразной платформы для данных и метаданных. В рамках образовательных программ важно обучать специалистов навыкам построения таких интеграций и управления совместной экосистемой.
Обзор решений: Amundsen, Lexikon, Artifact, DataPortal, Marquez, OpenMetadata, DataHub
Разнообразие решений data-каталогов в Open Source и коммерческих продуктах позволяет подобрать инструмент под конкретный контекст. Ниже приводится обзор ключевых решений, их особенностей и типичных сценариев применения.
Amundsen:
- ориентирован на обнаружение данных и метаданных для аналитиков и инженеров;
- имеет три микросервиса и подходящие коннекторы к BI-дашбордам;
- сильные стороны: готовые интеграции с BI-инструментами, простота внедрения;
- ограничения: ограниченный полнотекстовый поиск по колонкам, отсутствие истории изменений наборов данных.
Lexikon:
- простая реализация с базовой функциональностью по каталогизации;
- быстрота внедрения, базовый поиск.
Artifact:
- модульная архитектура и ориентир на управление данными и метаданными;
- упор на гибкость и расширяемость.
DataPortal:
- аналог подхода к каталогу с фокусом на MVP и быстрой реализации.
Marquez:
- модульная система для сбора, агрегирования и визуализации данных и метаданных;
- поддерживает графовую зависимость между заданиями и наборы данных;
- недостатки: ограниченная история изменений, ограниченные механизмы визуализации.
OpenMetadata:
- централизованное управление метаданными, включая данные, процессы и людей;
- поддержка Elasticsearch, MySQL, Kubernetes, и других компонентов;
- визуализация lineage и автоматизированная интеграция с Kafka(Avro) для обновления данных.
DataHub:
- современная платформа третьего поколения с широкими интеграциями;
- поддержка visual lineage, profiling, контрактов, политикам доступа (Policy Engine);
- интеграция с MLflow, Spark, Kafka, Kafka Connect и множеством коннекторов БД и ETL;
- распределённая архитектура, поддержка расширяемых моделей и автоматизированного редактирования данных.
Эти решения различаются по архитектуре (монолит vs микросервисы), уровню автоматизации изменений, поддержке потоковых обновлений, полнотекстовому поиску, версиям и API. В выборе решений для конкретной организации следует учитывать требования к масштабу, устойчивости и интеграциям с существующими инструментами.
Сравнительный анализ решений и выбор DataHub: критерии и обоснование
Сравнительный анализ требует систематического подхода: определить требования, вес параметров и проверить соответствие инструментов.
Ключевые критерии выбора:
функциональность и зрелость поколения:
- поддержка потоковых обновлений, журнал изменений и расширяемые модели метаданных (DataHub и OpenMetadata в числе лидеров);
интеграции и коннекторы:
- широта готовых коннекторов к ETL, BI и ML-инструментам;
безопасность и управление доступом:
- способность интегрироваться с LDAP/AD, Policy Engine и поддержка ABAC/RBAC;
архитектура и масштабируемость:
- микросервисная архитектура и гибкость к модульному расширению;
управляемость и устойчивость:
- поддержка версионирования, аудит и воспроизводимость;
открытость и сообщество:
- наличие активного сообщества, готовность к доработкам и участие в развитии экосистемы.
Обоснование выбора DataHub:
- DataHub относится ко второму и третьему поколения в отношении функциональности и архитектуры, обеспечивая мощную интеграцию с разнообразными источниками, данными и инструментами;
- интеграции с Policy Engine и LDAP позволяют обеспечить безопасную и управляемую среду;
- поддержка сдвига в сторону потоковых изменений и журналирования изменений метаданных помогает обеспечить аудируемость и воспроизводимость;
- наличие большого набора коннекторов к БД, ETL, ML и системам аналитики позволяет оперативно покрыть множество сценариев;
- открытость проекта и активное сообщество снижают риски долгосрочной поддержки и расширения.
Таким образом, выбор DataHub в нашем кейсе отражал сочетание требований к гибкости, безопасности и интеграций, позволяя построить Catalog как третьего поколения во внедрении с открытым стеком.
Реальные кейсы внедрения и практические выводы: отраслевые сценарии и рекомендации
В области внедрения data-каталогов встречаются различные отраслевые сценарии и уровни зрелости. Ниже приведены практические выводы и рекомендации, которые могут обеспечить успешное внедрение и эффективную эксплуатацию.
отраслевые сценарии:
- финансы и страхование: требования к аудиту, соответствию и безопасности данных; необходимость строгой линейности и контроля доступа; автоматизация удаления персональных данных.
- розничная торговля и электронная коммерция: быстрый доступ к данным для аналитики и персонализации; поддержка большого числа источников и витрин данных; возможность массовой обработки тегов и описаний.
- здравоохранение: строгие требования к приватности и аудиту; интеграция с данными пациентов, регламентами и безопасными актами обмена.
- телеком и производство: масштабируемость, интеграция с потоками данных и мониторинг качества.
практические рекомендации:
- начать с определения доменных областей (ETL-пайплайны vs исследование данных) и определить приоритетные источники и наборы данных;
- выбрать поколение каталога, соответствующее зрелости организации и требованиям к автоматизации;
- обеспечить непрерывное управление качеством данных и мониторинг;
- внедрить политики доступа и Policy Engine для обеспечения безопасности и соответствия;
- обеспечить тесную интеграцию с BI и ML для максимального эффекта;
- рассмотреть открытость и сообщество по выбору решения, чтобы снизить издержки и повысить устойчивость.
Резюме выводов:
- data-каталоги — необходимый элемент цифровой архитектуры, который повышает скорость поиска, обеспечивает контроль и воспроизводимость данных;
- эволюция каталога от простого к сложному отражает рост требований к управлению данными, безопасности и автоматизации;
- современные решения, такие как DataHub, предлагают обширный набор коннекторов, поддержку потоковых изменений и политики безопасности, делая их подходящими для крупных организаций;
- внедрение требует стратегического подхода, включающего архитектурную модель, план перехода, обучение сотрудников и устойчивую эксплуатацию.
В заключение следует подчеркнуть, что выбор и реализация data-каталога — это не только выбор технического инструмента, но и формирование управленческой парадигмы, ориентированной на прозрачность, качество и безопасность данных. Эффективная архитектура каталога должна поддерживать стратегические цели организации, обеспечивая единое и доверенное лицо к данным во всех бизнес-подразделениях.
Вопрос-Ответ:
1. Вопрос: Что такое data-каталог и зачем он нужен?
Ответ: Data-каталог — это центральное хранилище метаданных и контекста данных, которое облегчает поиск, понимание, контроль доступа, линейность и качество данных, а также воспроизводимость аналитических и ML-проектов.
2. Вопрос: Какие два домена охватывают каталоги?
Ответ: Каталоги для пайплайнов ETL/ELT и каталоги для исследования данных; первый ориентирован на точность и управление, второй — на исследование, поиск и профилирование.
3. Вопрос: Какие преимущества у поколений каталогов?
Ответ: Поколение 1 обеспечивает быстрый старт и простоту; поколение 2 усиливает интеграцию и контракты; поколение 3 обеспечивает потоковые обновления, журнал изменений и строгую типизацию, расширяемые модели.
4. Вопрос: Почему выбор DataHub оправдан для третьего поколения?
Ответ: DataHub имеет широкие коннекторы, поддержку Policy Engine и LDAP, потоковые обновления метаданных, версионирование и расширяемые модели, что соответствует требованиям третьего поколения.
5. Вопрос: Какие ключевые аспекты интеграции с ML/AI должны присутствовать в каталоге?
Ответ: Связь с данными и экспериментами, хранение версий обучающих наборов, параметры и метрики, трассировка данных и моделей, управление безопасностью и воспроизводимостью.
6. Вопрос: Какие риски связаны с внедрением каталога?
Ответ: Сложность инфраструктуры, требования к компетенциям, потребность в централизованной политике безопасности, необходимость поддержки и обновления коннекторов.
7. Вопрос: Как повысить качество данных в каталоге?
Ответ: Введение правил качества, мониторинг метрик, автоматизация корректировок, интеграция с процессами DataOps и своевременный аудит.
8. Вопрос: Какие шаги стоит предпринять перед выбором решения?
Ответ: Оценить сценарии использования, определить требования к безопасности и интеграциям, определить масштабы и зрелость команды, выбрать поколение и конкретное решение, провести пилотный проект.
9. Вопрос: Какой подход к внедрению каталога наиболее эффективен?
Ответ: Пошаговый подход: обзор текущих источников, планирование интеграций, развертывание базовой функциональности, внедрение политики безопасности, расширение доточных сценариев и мониторинг.
10. Вопрос: Какие отраслевые сценарии особенно чувствительны к каталогам?
Ответ: Финансы и здравоохранение (аудит и безопасность), розничная торговля и телеком (масштабируемость и поиск), производство и логистика (линейность и интеграции).


