

Основы и терминология OpenMetadata
OpenMetadata — платформа открытого типа для управления метаданными и упрощения процессов подготовки, согласования и эксплуатации данных на уровне организации. Она объединяет источники данных, хранилища, пайплайны обработки, а также инструменты управления качеством данных, линейностью и политиками доступа. В данной главе рассмотрены базовые термины, архитектура и модель данных OpenMetadata, принципы интеграций и ключевые сценарии внедрения. Цель — сформировать общее языковое и концептуальное поле, необходимое для дальнейшего углубленного изучения архитектуры, практик эксплуатации и методологии трансформационных проектов.
OpenMetadata позиционируется как единый источник истины по метаданным, который позволяет организациям быстро настраивать и поддерживать каталог активов данных, осуществлять автоматическую инвентаризацию источников, прослеживать линейность данных и управлять доступом к данным. Важной особенностью является поддержка расширяемой модели сущностей, возможности для построения контекстного словаря терминов и взаимосвязей между источниками, таблицами, колонками и бизнес-объектами. Глубинное понимание базовых терминов и архитектурных концепций позволит не только внедрять OpenMetadata, но и выстраивать вокруг него устойчивые управленческие процессы.
Краткое содержание главы
- Архитектура и ключевые сервисы OpenMetadata, их роль в управлении метаданными.
- Модель данных и основные сущности: источники, наборы данных, линейность и словарь терминов.
- Интеграции и коннекторы: типовые источники метаданных и сценарии синхронизации.
- Управление качеством, доступом и аудитом: политика доступа, lineage и мониторинг.
- Практические аспекты внедрения и эксплуатации: шаги, принципы устойчивого развёртывания и организационные изменения.
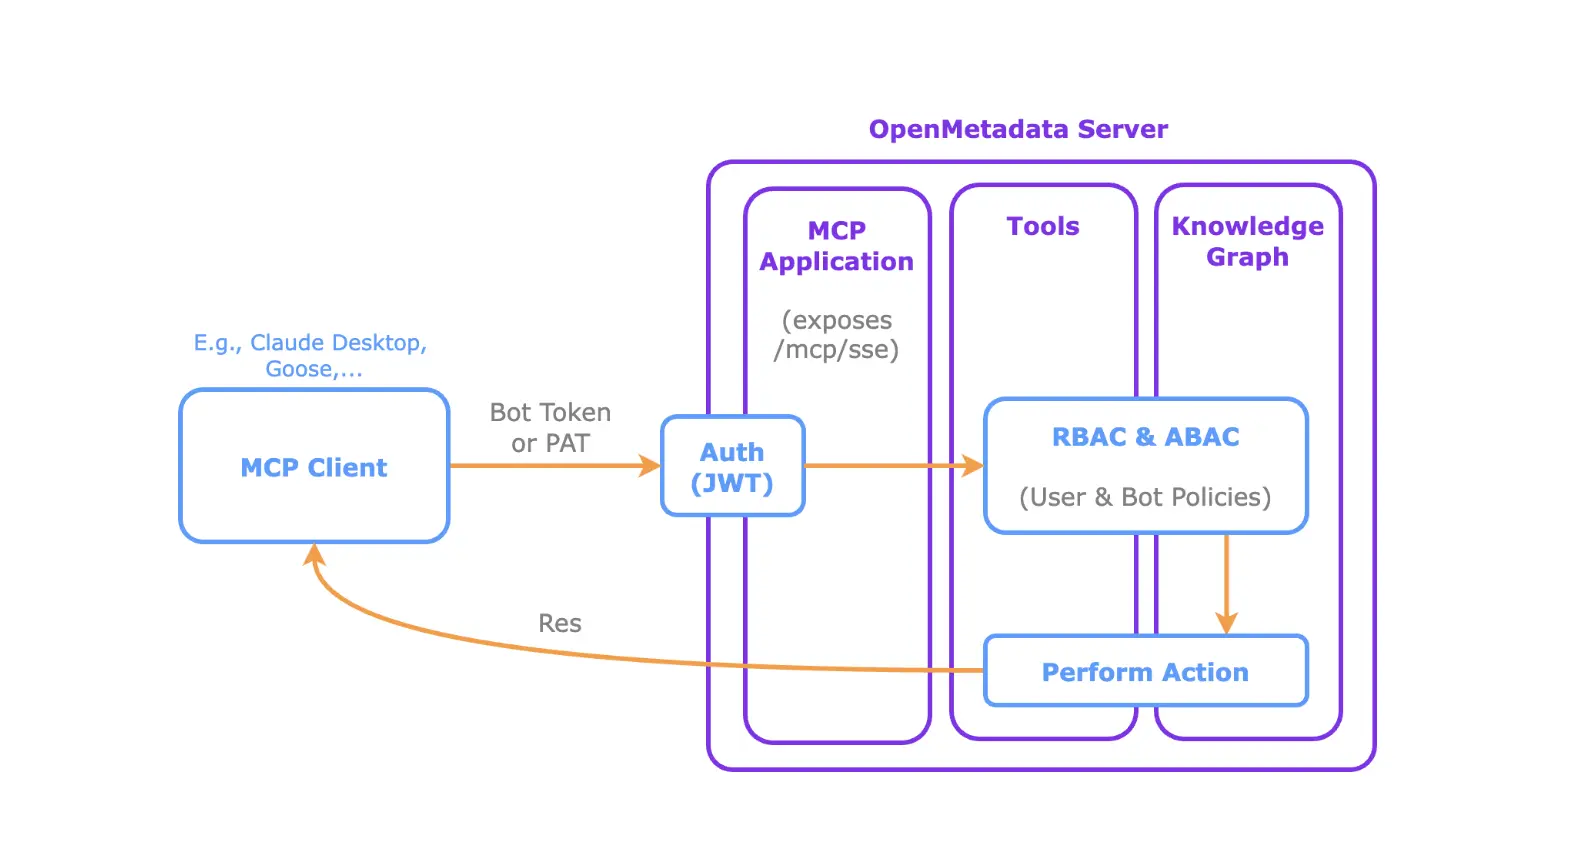
Архитектура OpenMetadata
OpenMetadata строится как набор взаимосвязанных сервисов, каждый из которых отвечает за свою задачу в процессе управления метаданными. Центральной точкой является metadata API, через который внешние клиенты (UI, внешние сервисы и скрипты) получают единый доступ к данным каталога.
- API-сервер и фронтенд: REST/GraphQL API обеспечивает доступ к метаданным; фронтенд (UI) позволяет бизнес-пользователям просматривать каталоги, прослеживать линейность, управлять словарём терминов и назначать владение данными. Архитектура поддерживает разделение слоёв: данные, логика и представление, что упрощает масштабирование и безопасное развёртывание.
- Хранилище метаданных: центральная база данных, которая сохраняет схемы, сущности и их связи. В реальных инсталляциях часто применяется PostgreSQL или эквивалентная РСУБД как устойчивый слой хранения. В крупных развертываниях возможно использование шардирования и резервирования для обеспечения отказоустойчивости.
- Модуль Ingestion и коннекторы: обработка входящих потока метаданных из различных источников. Коннекторы собирают информацию о схемах, таблицах, столбцах, владении, политике доступа и даже о линейности через анализ запросов и зависимостей. Для преобразования и унификации данных между источниками применяется набор процессоров, которые нормализуют данные и обогащают их бизнес-контекстом.
- Очереди и оркестрация: обработка событий и задач изменений, связанных с метаданными, осуществляется через брокеры сообщений или очереди (например, Kafka/RabbitMQ). Это обеспечивает асинхронность и надёжность передачи задач между компонентами.
- Поиск и индексирование: некоторые развёртывания интегрируют полнотекстовый поиск для быстрого доступа к сущностям, терминам и связанным данным. Это упрощает поиск по биг-дате и повышает производительность интерфейсов пользователя.
- Безопасность и аудит: управление доступом строится на принципах ролей и политик (RBAC/ABAC), интеграция с системами идентификации и управления доступом (OIDC), а аудиты изменений позволяют отслеживать историю изменений и соответствие требованиям комплаенса.
- Архитектура развёртывания: OpenMetadata реализуется в контейнеризованном виде и может масштабироваться в Kubernetes. Подход поддерживает отказоустойчивость, горизонтальное масштабирование сервисов и географическое разнесение компонентов для соответствия регуляторным требованиям.
Почему это важно: архитектура, разделение ответственности и модульность позволяют автономно разворачивать и обновлять компоненты, минимизируя влияние изменений на бизнес-пользователей. Гибкость архитектуры особенно критична в контексте разнообразия источников данных и требований к линейности и политике доступа.
Модель данных и сущности OpenMetadata
Ключевым элементом любой системы метаданных является согласованная модель данных. OpenMetadata проектирует сущности так, чтобы отражать реальные бизнес-объекты и их взаимосвязи. Это позволяет строить разрезы на уровне источников, наборов данных и бизнес-терминов, а также объединять их через контекст и политики.
- Источник данных (Source) — внешний контекст, представляющий источник метаданных: базу данных, дата-склад, файловый S3-хранилище и т. п. Источник имеет связь с единицами хранения (Database/Schema) и предоставляет данные для последующей инвентаризации.
- База данных и схема (Database/Schema) — логическая группировка объектов метаданных внутри источника. Они являются контейнерами для таблиц и представлений.
- Набор данных (Dataset) и таблица/колонка (Table/Column) — базовые элементы, описывающие физические или виртуальные данные, их структуру и типы данных. Колонки сопровождаются атрибутами, такими как тип, объемные характеристики и бизнес-описание.
- Словарь терминов (GlossaryTerm) и теги (Tag) — бизнес-лексика, которая обеспечивает единый смысловые коннотации для атрибутов данных. Термины связываются с сущностями (таблицами, колонками) для улучшения поиска и понимания контекста.
- Владелец и ответственность (Ownership) — назначение ответственных за активы данных, что поддерживает культуру ответственности и упрощает эскалацию в случае инцидентов.
- Линейность данных (Lineage) — цепочки зависимости между источниками, трансформациями и целевыми системами. Линейность может быть получена через анализ запросов, логи ETL/ELT, а также через интеграцию с инструментами (dbt, Spark-проекты и др.).
- Контроль доступа и политики (Access/Policy) — поддержка ролей и прав на уровне данных, включая политики маскировки, ограничение чтения и аудит. Это критично для соблюдения регуляторных требований и корпоративной безопасности.
- Качество данных и профилинг (Quality/Profiling) — метрики качества, результат профилирования и набор автоматизированных проверок, направленных на обнаружение аномалий и недостатков данных.
- Прочие справочные объекты (Terminology, Annotations) — дополнительная информация, которая помогает бизнес-пользователям и аналитикам быстрее находить смысловую нагрузку данных.
Связи между сущностями создают единый контекст: например, колонка может принадлежать таблице, таблица — набору данных в конкретном источнике, а к объектам данных привязаны термины словаря и политики доступа. Важно понимать, что модель открыта к расширению: новые типы сущностей могут быть добавлены по мере необходимости бизнеса, сохран preserving обратную совместимость и не нарушая существующие интеграции.
Почему это важно: согласованная модель данных обеспечивает единый язык между техническими и бизнес-слоями. Это облегчает постановку задач по сбору метаданных, настройке линейности и созданию бизнес-словаря, что в итоге повышает прозрачность и управляемость данных.
Интеграции и коннекторы: типовые источники и сценарии синхронизации
Одна из сильных сторон OpenMetadata — широкая экосистема интеграций с источниками метаданных и инструментами эксплуатации. Гибкость коннекторов позволяет централизовать сбор метаданных из различных систем, а унифицированный API обеспечивает единый доступ к ним.
- Коннекторы к базам данных и хранилищам: наиболее распространены коннекторы к реляционным СУБД и облачным дата-складaм. В типичной среде это PostgreSQL, Snowflake, BigQuery и аналогичные системы. Они обеспечивают сбор информации о схемах, таблицах и колонках, а также базовую статистику и владение.
- Интеграция с инструментами трансформации и оркестрации: dbt, Apache Airflow, Dagster — источники линейности и контекстной информации. Интеграция с dbt особенно полезна для поддержки модели линейности через моделей и зависимостей между ними.
- Интеграция с бизнес-инструментами: Looker, Tableau, Power BI — позволяют соединить бизнес-термины и данные каталога с визуализацией, а также обеспечивают доступ к данным через единый слой метаданных.
- Инструменты качества и профилирования: Great Expectations, Great Data Governance-примеры и прочие решения для проверки качества в контексте каталога. Они позволяют автоматически конструировать проверки и связывать их с конкретными наборами данных в каталоге.
- Безопасность и управление доступом: интеграция с системами идентификации и управления доступом (OIDC, LDAP) для синхронизации ролей и удостоверений пользователей.
1–2 примера на раздел достаточно: в области коннекторов чаще встречаются PostgreSQL и Snowflake как базовые источники,=dbt как источник линейности, Looker как пример BI-интеграции.
Примерный сценарий внедрения интеграций:
- определить стек источников и бизнес-объектов, которые требуется каталогизировать;
- выбрать набор коннекторов и собрать минимальный инцидентный пайплайн для инвентаризации;
- настроить профилинг и базовые политики доступа;
- внедрить процедуры обновления и мониторинга изменений;
- расширять покрытие за счет новых источников и более глубоких линейных связей.
Пример конфигурации интеграции (упрощённый)
type: "db"
source_name: "production_postgres"
connection:
  host: "db-prod.example.com"
  port: 5432
  database: "analytics"
  username: "catalog_user"
  password: "••••••••"
include_entities: ["public.*"]
poll_interval_minutes: 60
Этот пример иллюстрирует типовую структуру конфигурации коннектора: указание источника, параметры подключения, фильтры по объектам и расписание обновления. В реальных проектах конфигурации могут быть намного богаче и включать секции профилирования, проверки качества и политики доступа.
Управление данными, линейность и политика доступа
Эффективное управление данными требует интеграции трёх направлений: линейности, качества и политики доступа. OpenMetadata предоставляет инструменты для их реализации в рамках единого каталога.
- Линейность данных (Lineage): позволяет проследить путь данных от исходного источника до целевых систем через трансформации и зависимости. Линейность может строиться на автоматическом извлечении схем из запросов, журналов трансформаций и метаданных инструментов оркестрации (dbt, Spark-проекты). Важной характеристикой является полнота: чем больше источников линейности охвачено коннекторами и чем точнее интерпретация зависимостей, тем более надёжной становится аналитика влияния изменений.
- Контроль качества и профилинг (Quality/Profiling): собирается статистика по колонкам, пропускам, уникальности и другим характеристикам качества. В сочетании с автоматическими проверками это позволяет интегрировать качество данных в жизненный цикл данных и оперативно реагировать на отклонения.
- Политики доступа и аудит (Access/Audit): поддержка ролей, разрешений и политик на уровне объектов. Это включает доступ к таблицам, колонкам и бизнес-терминам, а также аудит изменений в каталоге для соответствия регуляторным требованиям и внутренним политикам безопасности. В современных организациях это критично для соблюдения требований к защите информации и прозрачности использования данных.
- Справочники и бизнес-термины (Glossary/Tagging): единый словарь терминов обеспечивает устойчивый бизнес-язык и упрощает коммуникацию между аналитиками, бизнес-лайн-менеджерами и ИТ-отделами. Привязка терминов к объектам данных улучшает поиск и контекстное понимание.
- Жизненный цикл и управление изменениями: каталоги должны поддерживать версионирование объектов, отслеживание изменений, откат к предыдущим версиям и уведомления об изменениях для заинтересованных пользователей. Это становится основой для управляемой эволюции метаданных в организациях.
Понимание того, как эти направления пересекаются, позволяет строить устойчивые процессы управления данными: от инвентаризации источников и атрибутов до контроля доступа и аудита по всем цепочкам данных.
Внедрение и эксплуатация: практические принципы
Эффективное внедрение OpenMetadata требует не только технического развёртывания, но и выработки управленческих практик, организационных изменений и четкой дорожной карты.
- Стратегия развёртывания: начинать с минимального набора источников и сущностей, которые наиболее критичны для бизнеса (например, ключевые базы данных и ценные наборы данных). Постепенно расширять охват и углублять линейность, чтобы не создавать перегрузку на раннем этапе.
- Управление изменениями: внедрять процессы согласования изменений метаданных, версии объектов и уведомления для заинтересованных сторон. Это обеспечивает прозрачность и снижает риск ошибок в аналитике.
- Организационные роли: определить ответственных за владение конкретными наборами данных, назначить администраторов каталога и представителей бизнес-подразделений, которые будут работать с терминами и политиками доступа. Налаживание взаимодействия между ИТ, данными и бизнес-подразделениями — ключ к устойчивой трансформации.
- Мониторинг и операционная устойчивость: настроить мониторинг загрузки коннекторов, скорости обновления метаданных, ошибок профилирования и инцидентов безопасности. Включение автоматических алёртов и логирования помогает быстро реагировать на сбои и нарушения.
- Производительность и масштабируемость: при росте количества источников и объёмов метаданных следует рассмотреть горизонтальное масштабирование сервисов, резервирование хранилища и географическое распространение компонентов для обеспечения отказоустойчивости и низкой задержки доступа.
- Обучение и поддержка пользователей: создание руководств, примеров сценариев использования и справочных материалов. Важно выстроить процесс поддержки для бизнес-пользователей, чтобы они могли эффективно работать с каталогом, интерпретировать термины и использовать линейность в своей работе.
- Интеграционная дисциплина: документировать набор коннекторов, правила трансформации и критерии включения новых источников. Это упрощает поддержку и расширение каталога в долгосрочной перспективе.
Эти принципы позволяют не только внедрить OpenMetadata как технологическую платформу, но и встроить её в управленческие процессы организации, что приводит к устойчивому росту качества данных, скорости принятия решений и соблюдению регуляторных требований.
Пример сценария внедрения
- Запуск минимального коннектора для критических источников (например, PostgreSQL и Snowflake) и базового набора сущностей (Source, Database, Table, Column, Ownership, GlossaryTerm, Lineage).
- Настройка базовых политик доступа и аудита изменений.
- Внедрение dbt-линкера для расширения линейности, добавление базовых тестов качества.
- Расширение охвата на BI-инструменты и оркестраторы, непрерывное улучшение словаря терминов и бизнес-контекста.
- Мониторинг, совершенствование процессов управления изменениями и документирование для масштабирования.
Key takeaways
- OpenMetadata представляет модульную архитектуру, состоящую из API, UI, ingestion-сервисов и хранилища метаданных, с возможностью горизонтального масштабирования.
- Основные сущности включают Source, Database, Table, Column, GlossaryTerm, Lineage, Ownership и политики доступа. Эти элементы образуют единый контекст данных и бизнес-терминов.
- Интеграции и коннекторы позволяют централизовать сбор метаданных из баз данных, облачных хранилищ, инструментов трансформации и BI-систем, обеспечивая единый взгляд на данные.
- Управление линейностью, качеством и доступом — критически для прозрачности, соблюдения регуляторных требований и управляемости рисками.
- Эффективное внедрение требует постепенного развёртывания, четкой организационной структуры, мониторинга и грамотного управления изменениями.
- Архитектура и модель OpenMetadata должны быть адаптированы под бизнес-задачи: выбираются наиболее ценностные коннекторы и сущности, создаётся бизнес-контекст вокруг данных.
- Важна стратегия сопровождения каталога: версия, аудит, уведомления, обучение пользователей и документирование процессов.
FAQ
1) Что такое OpenMetadata и зачем он нужен в цифровой трансформации?
- OpenMetadata — это открытая платформа для управления метаданными, которая объединяет источники данных, линейность, качество и политику доступа в единый каталог. Она упрощает инвентаризацию активов, ускоряет поиск и понимание данных, а также обеспечивает прозрачность процессов трансформаций и соответствие требованиям безопасности и регуляций.
2) Какие основные сущности есть в OpenMetadata?
- Основной набор сущностей включает Source (источник данных), Database и Schema, Table и Column (структура данных), GlossaryTerm и Tag (бизнес-термины и контекст), Ownership (ответственные лица), Lineage (линейность), и Policy/Access (политики доступа). Эти сущности связаны между собой, создавая единый контекст и позволяя бизнесу быстро ориентироваться в данных.
3) Как работает процесс инвентаризации и интеграции метаданных?
- Интеграции осуществляются через коннекторы к источникам данных и инструментам трансформации. Коннекторы извлекают схему, метаданные и владение, затем отправляют их в централизованное хранилище. В дополнение возможно использование пайплайнов для профилирования данных и формирования линейности через анализ запросов и зависимостей между моделями и трансформациями.
4) Как обеспечивается линейность данных в каталоге?
- Линейность строится за счёт анализа зависимостей между источниками, трансформациями и целевыми системами. Это может включать анализ SQL-запросов, логи пайплайнов и метаданные инструментов трансформации (например, dbt). Правильная настройка линейности помогает управлять воздействием изменений и оценивать риски.
5) Какие принципы безопасности и аудита поддерживаются OpenMetadata?
- Реализуются RBAC/ABAC-подходы, интеграция с OIDC/LDAP, управление правами на уровне объектов (таблицы, колонки, термины), а также аудит изменений и событий доступа. Это обеспечивает соблюдение регуляторных требований и улучшает доверие к данным.
6) Каковы типичные сценарии внедрения и лучшие практики?
- Начинать с критических источников и базовых сущностей, постепенно расширять покрытие, внедрять линейность через интеграцию с dbt и оркестрацию, обеспечивать управление изменениями и учебную поддержку пользователей. Архитектура должна позволять масштабирование и адаптацию к новым источникам без снижения устойчивости.
7) Какие примеры open-source решений и верифицированных интеграций можно учесть при внедрении?
- Практически достаточны коннекторы к PostgreSQL и Snowflake, а также интеграции с dbt и BI-инструментами (Looker, Power BI). В качестве дополнительных примеров можно рассмотреть интеграцию с инструментами профилирования и тестирования качества данных, но следует держать баланс между количеством интеграций и устойчивостью проекта.
8) Какой подход предпочтителен для миграции с другого каталога метаданных?
- Рекомендуется начать с инвентаризации и миграции наиболее критичных активов, а затем постепенно переносить формы описания бизнес-терминов и линейности. Важна тщательная верификация соответствия между двумя каталогами и настройка процедур синхронизации на этапе перехода.
9) Какие эксплуатационные риски следует учитывать?
- Риск неполной линейности из-за ограниченного набора коннекторов, риск устаревших или противоречивых терминов в словаре, риск некорректных политик доступа и недостаточного мониторинга. В целях минимизации следует внедрять регулярные проверки качества данных, аудит изменений и устойчивое управление изменениями.
10) Что считать успехом внедрения OpenMetadata?
- Успех оценивается по росту охвата метаданными, улучшению качества данных, ускорению поиска и согласованию бизнес-языка, снижению времени реакции на инциденты, а также по устойчивости и предсказуемости процессов управления данными. Важно наличие документированной политики, обученных пользователей и активного управления изменениями.


