

Риски качества данных: источники, вероятность, влияние и меры снижения
Качество данных в современных дата-пайплайнах выступает не только технической характеристикой, но и фактором, влияющим на управленческие решения, финансовые показатели и репутацию организации. В условиях цифровой трансформации качество данных становится критическим элементом доверия к аналитике и к принятым на ее основе решениям. Эта глава объясняет, как формируются риски качества данных, какая вероятность их возникновения и каковы масштабы их влияния на бизнес. Она также предлагает системные подходы к снижению рисков через архитектуру контролев, наблюдаемость и процессы управления качеством на протяжении всего цикла жизни данных.
Ключевая идея состоит в том, что риск качества данных — это сочетание вероятности возникновения дефекта в данных и его потенциального влияния на бизнес-контексты. Эффективная работа с рисками требует не только детектирования и исправления ошибок, но и проактивного проектирования пайплайнов так, чтобы дефекты не распространялись в downstream-слоях и не приводили к неверным бизнес-решениям. Баланс между скоростью поставки данных и степенью проверки качества становится частью архитектурного дизайна и операционной культуры.
Разделение на источники, вероятность и влияние позволяет структурировать меры снижения и выстроить управляемую систему наблюдаемости: от контрактного уровня ожиданий до мониторинга реальных дефектов в продакшн-среде. В этой главе рассматриваются архитектурные принципы, методы оценки риска и практические подходы к реализации контроля качества на уровнях входа, обработки и потребления данных. Особое внимание уделено тому, как внедрять наблюдаемость и контракты данных в существующие пайплайны без неоправданной тормозной задержки бизнес-операций.
- Источники риска в дата-пайплайнах и их диагностика
- Оценка вероятности возникновения ошибок и их потенциального влияния
- Архитектурные и операционные меры снижения риска
- Практические паттерны внедрения контроля качества и наблюдаемости
- Реализация управления качеством в рамках DataOps и продуктового подхода к данным
Краткое содержание главы
- Источники рисков качества данных и их классификация; роль схемной и семантической эволюции, задержек и трансформаций.
- Методы оценки вероятности и влияния дефектов: как формировать риск-матрицу, использовать показатели качества и наблюдаемость.
- Архитектура контроля качества: контракты данных, валидации на разных стадиях пайплайна, обработка ошибок и карантин.
- Практические паттерны внедрения и управленческие аспекты: роли, процессы, DataOps, пилоты и эволюция зрелости.
- Роль наблюдаемости и данных об обучении в обеспечении устойчивости систем аналитики.
Источники рисков качества данных
Источники риска распределяются между внутренними процессами организации и внешними взаимодействиями. Их следует рассматривать не изолированно, а в контексте всей цепочки данных — от момента рождения данных в операционных системах до потребления в аналитических моделях и отчетах. В рамках этой главы выделяются основные группы источников и типовые механизмы их возникновения.
Во-первых, внутренняя доменная и операционная неоднородность. Данные приходят из разных систем (ERP, CRM, платформы продаж, логи приложений, IoT-датчики и т. п.), и каждая из них имеет собственные форматы, бизнес-правила и время обновления. Различия в моделях данных, типах полей и валидности значений приводят к несоответствиям уже на входе в пайплайн. Примером служат несогласованные кодировки валют, локализации дат и различия в трактовке статусов или категорий. Налицо необходимость согласования семантики и единых правил проверки на стадии ввода.
Во-вторых, схематическое и семантическое дрейфование. Даже при аккуратной интеграции схемы могут изменяться: новые поля появляются, изменения типов, удаление устаревших атрибутов. Семантика бизнес-правил может обновляться вслед за изменениями в процессах или политиками хранения данных. Без механизмов уведомления об изменениях и контрактов между командами есть риск, что downstream-логика начнет обрабатывать данные с устаревшими предпосылками, что в итоге приводит к неверным выводам.
В-третьих, дрейф времени и задержки. Различие между настоящим временем обработки и реальным временем поступления данных (latenсy) вызывает проблемы синхронности и может приводить к неверной агрегации или истечению временных окон. В потоковых пайплайнах особенно важно учитывать задержки, идущие от источника к потребителю.
В-четвертых, дрейф качества на этапах обработки. Преобразования, объединения, агрегации и фильтрации могут вводить ошибки: дубликаты, пропуски, некорректные обогащения, неконсистентные результаты после joins, ошибки в обработке временных меток. Порядок выполнения операций, параметры и настройки окружения — все это влияет на итоговую качественную характеристику данных.
В-пятых, пропуски, дубликаты и некорректные значения. Это классические источники дефектов на входе и в трансформациях: отсутствующие данные, повторяющиеся записи и значения, выходящие за допустимый диапазон. Без системной идентификации и исправления они быстро накапливаются по цепочке и приводят к «грязной» аналитике.
В-шестых, внешние данные и контракты. data feeds от партнеров, поставщиков данных или открытых источников часто отличаются по качеству и согласованности схем. Непредвиденные изменения форматов, задержки и ошибки передачи требуют контрактной фиксации ожиданий и механизмов обработки отклонений.
Наконец, операционные и управленческие факторы. Конфигурационные изменения, миграции систем, различия между окружениями разработки, тестирования и продакшн, а также недоконтролированные изменения прав доступа могут приводить к непредвиденным последствиям в качестве данных и усложнять диагностику.
Поддержка надлежащей архитектуры требует системной фиксации источников риска, их классификации по доменам и бизнес-ценностям, а также прозрачности по отношению к зависимостям между системами данных. В рамках этой главы предлагаются конкретные подходы к идентификации и документированию источников риска в вашем контексте, включая рекомендации по автоматическим проверкам на уровне входов и трансформаций.
Вероятность и влияние риска
Чтобы управлять рисками качества данных, необходимо не только выявлять дефекты, но и оценивать вероятность их возникновения и потенциальное влияние на бизнес. В этом разделе описываются подходы к оценке вероятностьности дефектов, их частоты и масштаба влияния на решения и операции.
Вероятность возникновения дефекта можно оценивать на основе исторических данных: частота сбоев по доменам, частота пропусков в критически важных наборах данных, доля транзакций с ошибкой, а также времени между инцидентами. В условиях динамики бизнес-процессов полезно использовать дополнительные индикаторы: частота изменений в источниках данных, скорость смещений в валидности значений, темп роста объема пропусков после релизов и миграций. Важна не столько отдельная цифра, сколько тенденция и контекст: увеличение дрейфа в конкретном домене или рост числа дефектов после обновления схемы — сигналы для оперативной реакции.
Влияние дефекта оценивается через бизнес-контексты: качество принятия решений, точность отчетности, соответствие регуляторным требованиям, влияние на финансовые результаты и на репутацию организации. Влияние можно категоризировать по уровням: операционное (производственные решения и операционная эффективность), аналитическое (качество бизнес-объяснений и выводов), финансовое (стоимость исправления и риск ошибок в учете) и регуляторное (риски штрафов и аудиторских замечаний). Часто влияние нелинейно: небольшая ошибка в одном KPI может привести к существенным бизнес-решениям, если она находится на критическом пороге.
Смысл анализа риска заключается в сочетании вероятности и влияния в риск-матрицу. Принятие решений о приоритетности мер снижения лучше всего строить на основе такого баланса: высоковерыоятные и высоковлиятельные дефекты требуют оперативных контролев и автоматизированной диагностики; дефекты с высоким влиянием, но низкой вероятностью — требуют резервирования ресурсов на мониторинг и проверки, но не обязательно мгновенных реаций. Кроме того, в практике управления качеством данных применяются следующие концепции:
-
Data quality metrics как индикаторы риска: точность (accuracy), полнота (completeness), непротиворечивость (consistency), актуальность (timeliness), допустимость значений (validity) и уникальность (uniqueness). Эти параметры позволяют строить количественные рейтинги риска и устанавливать пороги для срабатывания контролев.
-
Метрики наблюдаемости. Эффективная наблюдаемость данных включает не только показатели качества на уровне отдельных наборов данных, но и метрики процессов: задержки, долю пропусков по времени, скорость песочницы изменений (drift rate), частоту отклонений в валидируемых правилах и долю дефектов, которые проходят через все контроли.
-
Важность контрактации и контрактов данных. Контракты данных устанавливают ожидания между поставщиками данных и потребителями. Они служат основой для диагностики и управления дефицитами качества, позволяют заранее оговаривать пороги, правила обработки недостоверных данных и обязательства по уведомлению о изменениях.
-
Роль наблюдаемости в раннем обнаружении риска. Наблюдаемость помогает выявлять дрейф, задержки и пропуски на ранних стадиях, что позволяет снизить инерцию дефектов и уменьшить затраты на их устранение. В рамках архитектуры контроль качества должен быть встроен в пайплайны и подключен к централизованной системе мониторинга.
Практическим guidance является построение риск-ориентированной дорожной карты: сначала сосредоточиться на доменах с наибольшей бизнес-ценностью и на наиболее критических точках пайплайна, затем постепенно расширять зону охвата до менее значимых участков, поддерживая баланс между скоростью поставки данных и качеством.
Влияние риска на бизнес и операционные последствия
Непризнанные или неправильно управляемые риски качества данных немедленно сказываются на принимаемых бизнес-решениях и результатах операционных процессов. Ниже приведены ключевые аспекты влияния и способы их оценки.
Во-первых, качество данных напрямую влияет на качество аналитики и принятие решений. Неправильные или неполные данные приводят к неверным выводам, что может привести к ошибочным стратегиям, неверной ценообразовательной политике, неверной оценке рисков и потерям на операционных процессах. В микропроцессах это может проявляться через неправильную таргетированную маркетинговую аналитику, неэффективное распределение бюджетов на кампании, а также в расчетах KPI и бонусов сотрудников, если данные используются для управленческой отчетности.
Во-вторых, регуляторные и правовые риски. В ряде отраслей корректная обработка и полнота данных критически важны для соблюдения регуляторных требований, аудитов и отчетности. Дефекты данных могут приводить к неверной отчетности, штрафам, недоверию со стороны регуляторов и клиентов. В связи с этим особенно важно поддерживать сертифицируемые процессы, контракты данных и журналирование изменений.
В-третьих, операционные издержки и технический долг. Неразрешенные дефекты на ранних стадиях создают эффект снежного кома: исправление требует дополнительных ресурсов, задержки в разработке, повторное тестирование и переработку исторических данных. Нарастание технического долга снижает гибкость систем, увеличивает стоимость изменений и замедляет внедрение новых возможностей.
В-четвертых, влияние на доверие и репутацию. Аналитическая достоверность, прозрачность происхождения данных и скорость реакции на инциденты влияют на доверие пользователей и клиентов. Постоянные проблемы с качеством снижают принятие решений на основе данных и снижают эффективность цифровой трансформации.
Системный подход требует количественных и качественных индикаторов влияния. К примеру, можно определить экономический эффект ошибок по ошибочно принятому решению, стоимости исправления дефекта, времени простоя аналитических систем, и затратам на аудиты. Важным элементом является прозрачность для бизнес-руководителей: связывание конкретных дефектов с бизнес-рисками и их финансовой оценкой позволяет общаться на языке бизнес-пользователей и обосновывать инвестиции в улучшение качества данных.
Меры снижения и архитектура контроля качества
Эффективное управление рисками качества данных требует сочетания архитектурных решений, контрактов данных и процессов управления. Ниже приводятся основные принципы и подходы, которые применяются в современных дата-пайплайнах.
Во-первых, контрактное проектирование данных (data contracts). Контракты задают ожидаемое поведение источников и потребителей: форматы схем, допустимые диапазоны значений, требования к полноте и актуальности, параметры задержек и правила обработки ошибок. Контракты служат точкой согласования между командами и дают механизм автоматической проверки на входе данных и при трансформациях. Реализация контрактов снижает вероятность неожиданных дрейфов и упрощает диагностику, если что-то идет не так.
Во-вторых, валидации на разных стадиях пайплайна. Вводные проверки должны осуществляться на уровне входных данных, в ходе трансформаций и на выходе в целевые хранилища. Валидации охватывают контроль качества по ключевым метрикам: полноту, точность, непротиворечивость, актуальность и уникальность. В идеале валидаторы должны быть автоматизированы и интегрированы в CI/CD пайплайны, чтобы новые изменения проходили через контроли качества до продакшна.
В-третьих, наблюдаемость данных (data observability). Наблюдаемость — это способность видеть все аспекты качества данных в реальном времени и исторически. В архитектурном плане это включает сбор, агрегацию и визуализацию метрик качества, лейблы по доменам данных, слежение за дрейфом схемы и семантики, мониторинг задержек и ошибок. Эффективная observability требует унифицированной модели метрик, интеграции с инструментами мониторинга (например, Grafana, OpenTelemetry) и четкой сигнализации по порогам.
В-четвертых, устойчивость и обработка ошибок. Контроли должны включать варианты реагирования на дефекты: откат к предыдущему валидному состоянию, карантин дефектных наборов данных, повторная обработка и автоматическое исправление, если возможно. Включение Idempotence и повторного выполнения операций (retries) позволяет уменьшить риск повторной генерации ошибок и корректно восстанавливать пайплайны после инцидентов.
В-пятых, управление данными и конфиденциальность. Контроль доступа, маскирование персональных данных, аудит использования и шифрование — важные элементы, особенно в контексте регуляторных требований и доверия пользователей. Правильная организация прав доступа и политики минимальных привилегий помогают снижать риск ошибок, связанных с обработкой чувствительных данных.
В-шестых, роль инструментов и платформ. Выбор инструментов следует обосновывать бизнес-целями и зрелостью команды. ПримерOpen-Source и коммерческих решений можно упомянуть: Great Expectations позволяет формализовать тесты качества и интегрировать их в пайплайны; dbt предоставляет тестирование моделей и референс Docs, облегчая контроль качества внутри трансформаций. В качестве архитектурного базиса можно рассмотреть использование современных дата-хранилищ и пайплайнов со встроенной поддержкой схемой эволюции и контроля качества, таких как Delta Lake или Apache Iceberg, которые упорядочивают хранение и снимают часть проблем, связанных с дрейфом схемы.
В свете гибридного профиля главы, акцент делается на сочетании архитектурных решений и организационных практик. Важно, чтобы контроли не только существовали как технические проверки, но и были встроены в процессы команд: от определения данных-работников и владения доменами до процессов выпуска и аудита. Внедрение контролев качества — это долгосрочная трансформация, которая требует создания культуры ответственности, развития компетенций в командах и непрерывной адаптации к меняющимся бизнес-условиям.
Практическая реализация и внедрение
Реализация контроля качества в дата-пайплайнах должна опираться на поэтапный подход с фокусом на критические домены и устойчивость к изменениям. Ниже приводятся рекомендуемые этапы и практики внедрения.
Первый этап — подготовка и оценка зрелости. Необходимо определить приоритетные домены данных, которые оказываются в основе бизнес-решений и обладают наибольшим экономическим эффектом от улучшения качества. Проводится карта рисков, где каждому домену сопоставляются источники риска, векторы дрейфа, потенциальные последствия и требования к наблюдаемости. На этом этапе формируются первые проекты контрактов данных и набор минимально жизнеспособных валидаторов.
Второй этап — установка контрактов и базовых валидаторов. В команде формируется договоренность об ожидаемом формате и правилах обработки. Внедряются базовые проверки на входе и минимальные тесты в трансформациях. Важной частью является документирование контрактов и создание общей библиотеки тестов, которая позволяет быстро тиражировать проверки на новые домены.
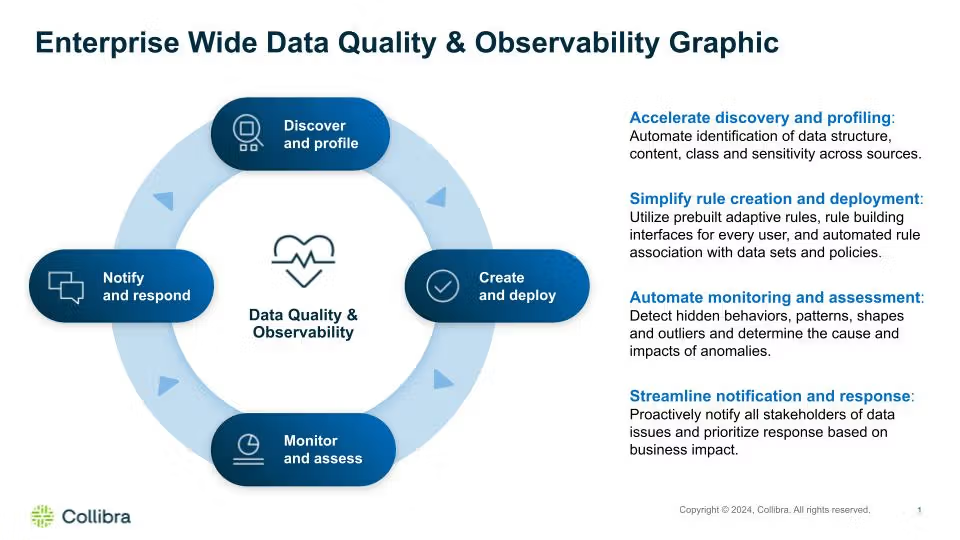
Третий этап — архитектура наблюдаемости и контролев. Разворачивается централизованная платформа мониторинга качества: сбор метрик, хранение исторических данных, алертинг и дашборды по доменам. Введение концепции drift detection (дрейф схемы и семантики) и lag tracking (задержки) позволяет оперативно реагировать на изменения. Параллельно разворачиваются механизмы карантина и повторной обработки для дефектных данных.
Четвертый этап — автоматизация обработки ошибок и устойчивость пайплайнов. Реализуются стратегии обработок ошибок: повторные запуски, очистка и повторная загрузка данных, автоматическое исправление значений там, где это возможно, и автоматическое отклонение дефектных наборов от продакшна. В рамках архитектуры применяются паттерны идепотентности и детерминированности вычислений, чтобы повторения извне не портили консистентность данных.
Пятый этап — интеграция данных и безопасность. Включаются правила управления доступом, маскирование и аудит счетчиков использования данных. Регуляторные требования учитываются на всех стадиях, особенно в доменах, связанных с персональными данными и чувствительной информацией.
На практике для реализации можно опираться на сочетание инструментов и процессов. В качестве примера можно упомянуть использование Great Expectations для описания контрактов и тестирования качества данных, а также dbt для тестирования моделей и обеспечения прозрачности через документацию и декларативные контракты. Для линейной трассировки и управления данными полезны решения для lineage и каталога данных, например, открытые компоненты экосистемы, а также интеграции с существующей системой мониторинга. Важно, чтобы выбранные подходы были совместимы с существующим стеком: оркестраторами (Airflow, Prefect), обработчиками потоков (Kafka, Spark), слоями хранения (Delta Lake, Iceberg) и платформами бизнес-аналитики.
Необходимо обеспечить прозрачность процессов для команд и бизнес-заинтересованных сторон. Модель DataOps и принципы DevSecOps для данных требуют определения ролей: владелец качества данных (data quality owner), стюард данных (data steward), инженер по данным (data engineer), владелец продукта данных (data product owner) и интегрированные команды. Регламентированные процессы выпуска, управление изменениями и аудит должны быть встроены в повседневную практику разработки и эксплуатации дата-пайплайнов.
Key takeaways
- Риски качества данных возникают на стыке источников, трансформаций и потребителей данных, и их управление требует системной архитектуры и организационных практик.
- Оценка риска включает анализ вероятности дрейфа и влияния дефекта на бизнес-контексты, а также использование метрик качества и наблюдаемости для раннего обнаружения.
- Контракты данных и многоуровневые валидаторы на входе, в обработке и на выходе являются базой для устойчивого снижения риска.
- Наблюдаемость данных — критический компонент: сбор метрик, детекция дрейфа, задержек и ошибок позволяет снизить время реакции и стоимость устранения дефектов.
- Архитектурные паттерны: ограничение распространения дефектов, карантин, повторная обработка и идемпотентность операций поддерживают устойчивость пайплайнов.
- Инвестиции в DataOps, роли ответственных лиц и культуру качества данных окупаются снижением регуляторного и операционного риска.
- Привязка контролев к бизнес-целям и прозрачная коммуникация с бизнес-пользователями помогают выстраивать доверие к аналитическим продуктам.
FAQ
- Что такое риск качества данных и почему он важен для Data Observability?
- Риск качества данных — это вероятность того, что дефект в данных или нарушение правил обработки повлияют на бизнес-решение или операционные процессы. Он важен, потому что отсутствие видимости риска и слабые контроли приводят к неверной аналитике, штрафам за регуляторные нарушения и потере доверия клиентов. Data Observability обеспечивает раннее обнаружение дрейфа и ошибок, позволяя быстро реагировать и минимизировать влияние на бизнес.
- Какие источники риска встречаются чаще всего?
- Частые источники включают дрейф схемы и семантики, несовпадение форматов между системами, задержки и задержки во времени обработки, дубликаты и пропуски в данныx, ошибки в трансформациях и неверные обогащения, а также внешние данные с непредсказуемым качеством. Важны также операционные факторы: миграции систем, конфигурационная дрейф и неправильные настройки в окружениях.
- Как определить вероятность возникновения дефекта?
- Вероятность определяется историческими данными о дефектах, частотой срабатывания валидаторов и дрейфами в домене данных. Включаются показатели частоты ошибок на уровне источников, скорость изменений в схемах и валидности значений, а также темпы задержек. Важно рассматривать тенденции: рост дрейфа или нарастающее количество дефектов сигнализирует о повышении риска.
- Как оценивать влияние дефекта на бизнес?
- Влияние оценивается по нескольким канцелям: операционная эффективность, качество аналитики, финансовые последствия и регуляторные риски. Влияние может быть прямым (неточное начисление, неверные KPI) или косвенным (потеря доверия, задержки в принятии стратегических решений). Включение финансовых оценок и сценариев «что если» помогает объяснить риск бизнес-представителям.
- Какие контроли рекомендуется внедрять в пайплайны?
- Рекомендуются: контрактная спецификация данных (data contracts), валидации на входе, во время трансформаций и на выходе, автоматизированный мониторинг и алертинг, карантин дефектных наборов, повторная обработка и идемпотентность операций, а также инструменты для управления дрейфом схем и семантики.
- Что такое data contracts и как их применять?
- Data contracts устанавливают форматы данных, правила валидации и обязанности сторон в партнерстве по данным. Они включают требования к схеме, допустимым диапазонам значений, задержкам и обработке недостоверных данных. Контракты помогают определить ожидания, автоматизировать проверки и улучшить коммуникацию между командами поставщиков и потребителей.
- Как устроить наблюдаемость данных в организации?
- Наблюдаемость требует унифицированной модели метрик данных, сбор, хранение и визуализацию исторических данных по качеству, дрейфу и задержкам. Важно иметь центральную панель мониторинга, сигналы тревоги по порогам и механизмы диагностики причин инцидентов. Интеграция с инструментами (например, Grafana, OpenTelemetry) и наличие политики эскалации способствуют быстрому восстановлению.
- Какие роли и процессы необходимы для устойчивой реализации?
- Необходимы роли: владелец качества данных, data steward, data engineer, data product owner, а также кросс-функциональные команды. В процессах — Create/maintain data contracts, безопасное изменение схем, управление изменениями, регулярные аудит и обучение команд в области качества данных и наблюдаемости. Важно внедрять DataOps-подход, где качество является частью продукта данных и непрерывной поставки.
- Какие риски и ошибки часто встречаются при внедрении контроля качества?
- Частые ошибки: недооценка важности контрактов, установка слишком жестких порогов без учета контекста, избыточное качество на ранних стадиях задержки выпуска, недостаточная интеграция наблюдаемости в существующий стек, игнорирование организационных изменений и сопротивление к изменению процессов. Успех достигается через поэтапное внедрение, устойчивую культуру качества и тесную связь контроля с бизнес-целями.
Если требуется, могу дополнить разделы примерами из реальных кейсов, а также привести схему архитектуры контролев и наблюдаемости в виде ASCII-диаграммы или краткой спецификации контракта данных.


