

Инфраструктурные требования под StarRocks в Kubernetes: сеть, хранилище, вычисления
StarRocks в Kubernetes представляет собой сочетание распределённой вычислительной архитектуры и управляемого окружения, где качество сетевого взаимодействия, надёжность хранения данных и предсказуемость вычислительных ресурсов напрямую влияют на производительность запросов и устойчивость к нагрузкам. Глава затрагивает принципы планирования инфраструктуры, обоснование архитектурных решений и последовательности развёртывания, которые обеспечивают минимальную задержку, высокий throughput и автоматизацию эксплуатации.
Краткое введение
-
В целях эффективной эксплуатации StarRocks в Kubernetes необходимо рассмотреть три взаимосвязанных слоя: сеть, хранилище и вычисления. Только в связке корректно настроенная сеть, качественное хранение и разумное распределение вычислительных ресурсов позволят достичь заявленных SLA и обеспечить масштабируемость кластера.
-
Основная идея заключается в том, чтобы проектировать инфраструктуру под специфические режимы нагрузки StarRocks: OLAP-аналитику с высоким параллелизмом, загрузку данных через BE-узлы и устойчивость к сбоям за счёт управляемых механизмов Kubernetes и отраслевых практик мониторинга и резервирования.
-
Краткое содержание главы
-
Определение архитектурной модели StarRocks в Kubernetes: роли FE и BE, способы связи и топологии развёртывания.
-
Выбор сетевых концепций и настройка сетевой безопасности: DNS-сервисы, политика доступа, скорость обмена между компонентами.
-
Хранение данных: требования к дискам, выбор провайдера CSI, стратегии размещения данных и резервного копирования.
-
Вычисления и ресурсы: планирование CPU, памяти, очередей запросов и NUMA-совместимость; мониторинг и автоматизация распределения ресурсов.
-
Эксплуатация и автоматизация: релизы, обновления, резервное копирование, аварийное восстановление, интеграция с Helm/Operator и CI/CD.
-
Лучшие практики и сценарии развертывания: примеры архитектур, типовые модели масштабирования и устойчивости к сбоям.
Архитектура сети и кластерной топологии
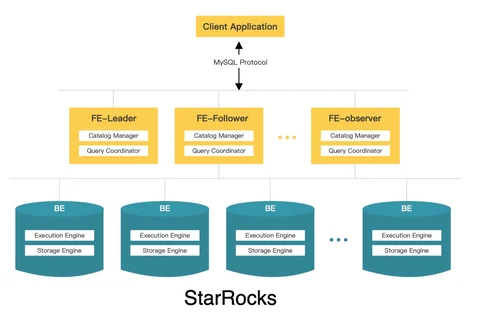
Инфраструктурная архитектура StarRocks в Kubernetes опирается на чёткое разделение ролей между фронтендом (FE) и бэкендом (BE), где FE отвечает за парсинг SQL, планирование запросов и метаданные, а BE — за выполнение аналитических операций, хранение и загрузку данных. В Kubernetes эти роли чаще всего реализуются через отдельные StatefulSet-ы или через разделённые Deployment-ы в зависимости от стратегий управления состоянием и требований к стабильности именованных узлов. Такой подход облегчает локализацию сетевого трафика, упрощает балансировку нагрузки и позволяет обеспечить устойчивость к сбоям через контролируемые обновления.
Ключевые моменты:
- Стабильность идентификации узлов: использование StatefulSet для FE и BE обеспечивает фиксированные имена узлов, предсказуемые DNS-адреса и возможность размещать локальные данные на конкретных узлах.
- Локализация трафика: в идеале FE и BE-узлы размещаются на разных нодах, но при этом между ними должно быть низкозависимое сетевое соединение с низкой задержкой; можно рассматривать стратегию anti-affinity между FE и BE для разделения зон нагрузки.
- DNS и сервисы: каждый StatefulSet сопоставляется с headless-сервисом для прямого обращения к узлу, а общий ClusterIP/Headless сервис обеспечивает балансировку и удобную маршрутизацию внешних запросов. Для внутреннего взаимодействия между FE и BE применяются политики обмена сообщений и мониторинг сетевых задержек.
- Безопасность сети: внедряются сетевые политики (NetworkPolicy) для ограниченного доступа между FE и BE, между внешними клиентами и кластером, а также между отдельными нодами Kubernetes, что снижает поверхность атаки и трафиковые риски.
- Мониторинг сетевой динамики: сбор метрик задержек, пропускной способности и ошибок межузельного обмена в Prometheus; эти данные позволяют оперативно реагировать на задержки кластера и перераспределять нагрузку.
Важно помнить, что цель сетевой архитектуры — обеспечить минимальные задержки и детерминированную маршрутизацию запросов: такие характеристики критичны для исполнения аналитических запросов, где латентность отражается на общих временах выполнения.
Взаимодействие FE и BE: протоколы и схемы коммуникации
FE отвечает за анализ и планирование запросов, BE — за чтение данных и выполнение скриптов. Между этими компонентами устанавливается устойчивый двунаправленный канал, поддерживающий консистентность метаданных и устойчивость к временным сбоям. В Kubernetes проектирование коммуникаций следует базировать на надёжных протоколах передачи и повторной отправке сообщений, чтобы минимизировать влияние сетевых проблем на окончательный ответ запросов.
- Принципы: идентификация узлов через DNS, кэширование метаданных на FE, централизованный доступ к данным BE.
- Практики: настройка тайм-аутов и повторов, отложенная инициализация конвейеров запросов, мониторинг ошибок RPC.
Пример конфигурации сетевых параметров и тайм-аутов следует держать в конфигурационных файлах Helm-чартов или манифестах оператора, чтобы упорядочить обновления и сохранить консистентность между FE и BE при масштабировании.
apiVersion: apps/v1
kind: StatefulSet
metadata:
  name: starrocks-fe
spec:
  serviceName: "starrocks-fe"
  replicas: 3
  selector:
    matchLabels:
      app: starrocks-fe
  template:
    metadata:
      labels:
        app: starrocks-fe
    spec:
      containers:
      - name: starrocks-fe
        image: starrocks/starrocks-fe:latest
        ports:
        - containerPort: 9030
        command: ["/bin/starrocks-fe"]
        args: ["--fe-mem-limit=4G"]
        volumeMounts:
        - name: data
          mountPath: /data
      volumes:
      - name: data
        emptyDir: {}
  volumeClaimTemplates:
  - metadata:
      name: starrocks-fe-data
    spec:
      accessModes: [ "ReadWriteOnce" ]
      resources:
        requests:
          storage: 100Gi
Данная конфигурация демонстрирует концепцию: FE запускается в StatefulSet с устойчивыми именами узлов и заявленным IOPS-уровнем, а данные FE хранятся на PVC, расширяемых через volumeClaimTemplates. В реальной эксплуатации PVC должны ссылаться на дисковую инфраструктуру (SSD/NVMe) через CSI-драйверы, что обеспечивает предсказуемость задержек и производительности.
Хранилище и диск: требования к данным StarRocks
Хранилище играет критическую роль в StarRocks: BE-узлы работают с данными локально и на сетевом хранилище, в зависимости от архитектуры кластера. Реальная задача — подобрать баланс между задержкой доступа к данным, пропускной способностью и устойчивостью к сбоям. В Kubernetes рекомендуются решения, которые обеспечивают:
- Высокую скорость записи/чтения и низкую задержку на случай больших операций загрузки данных.
- Надёжность и возможность масштабирования объёмов в рамках кластера.
- Простоту резервного копирования и санитарные процедуры при обновлениях.
Подходы к хранению
- Локальные SSD/NVMe на узлах BE-узлов: минимальная задержка и максимальная пропускная способность, идеальны для активного хранения данных. В Kubernetes это достигается через StatefulSet с локальными volume-источниками или через CSI-драйвер, который обеспечивает локализацию данных.
- Сетевые блочные хранилища (Ceph/RBD, Longhorn, OpenEBS и т. п.): обеспечивают общую доступность данных и упрощают управление резервными копиями, snapshots и миграциями. Эти решения полезны, когда BE-узлы должны иметь общую точку доступа к данным или когда локальное хранение непрактично из-за ограничений hardware-объёма.
- Облачные блочные хранилища: для облачных развёртываний часто применяют полностью управляемые решения (CSI-драйверы соответствующих облаков). При этом следует учитывать латентность и стоимость операций ввода-вывода.
Стратегии размещения и управление данными
-
Разделение директорий данных: отдельно для BE и каталога метаданных FE; хранение метаданных FE должно быть надёжно защищено и регулярно резервироваться.
-
Резервное копирование и snapshot: регулярно выполнять снимки PVC в случае сетевых сбоев; хранить копии в бакете S3-совместимого хранилища или другом холодном резерве.
-
Управление доступом к данным: настройка RBAC и секретов, чтобы только разрешённые компоненты могли обращаться к PVC и к хранилищу.
-
Способы отказоустойчивости: зеркалирование сегментов данных, настройка multi-AZ развертываний (для облачных сред), планирование процедур обновления без прерываний.
-
Пример применения CSI-драйверов Ceph или Longhorn: создать отдельные StorageClass для BE-узлов с локальными условиями IOPS и высокой пропускной способностью, и соответствующую StorageClass для FE-узлов, где задержки менее критичны, но требуются резервные копии и миграции.
Бэкап и восстановление
Эффективная процедура резервного копирования должна учитывать две стороны: метаданные FE и данные BE. Метаданные FE часто являются относительно небольшими, но требуют консистентного момента времени. Данные BE требуют периодических снимков, которые можно реализовать через CSI-Drivers и внешние сервисы резервного копирования. В идеале резервирование организуется в согласованные интервалы и тестируется на восстановление для минимизации времени простоя.
Пример конфигурации хранилища (PVC)
apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: starrocks-be-data
spec:
  accessModes:
  - ReadWriteOnce
  resources:
    requests:
      storage: 500Gi
  storageClassName: fast-ssd
Эта конструкция иллюстрирует базовый подход к выделению дискового пространства под BE-узлы. В реальном кластере следует связывать PVC с конкретной StorageClass, соответствующей выбранной инфраструктуре хранения (Ceph, Longhorn, облачное блочное хранилище и т. п.), а также учитывать требования к размеру, IOPS и задержкам.
Вычисления и ресурсы: планирование и управление
Корректная конфигурация вычислительных ресурсов критична для высокой производительности StarRocks, поскольку запросы к аналитическим данным требуют параллелизма, памяти и эффективного использования CPU. В Kubernetes это достигается за счёт грамотного распределения ресурсов между FE и BE, а также учётом особенностей самой архитектуры StarRocks.
Планирование ресурсов
- CPU: FE требует устойчивого пул-режима parse-процессов и планирования, BE — вычислительных ядер для обработки агрегаций и сканирования данных. Рекомендуется резервировать базовый запас ядер для каждого компонента, а затем расширять при росте нагрузки.
- Память: StarRocks часто работает с большими кэшами и буферами; для BE критичны буферы чтения и записи, для FE — кэш выполнения планов и сериализацию. В рамках кластерной архитектуры следует выделить память на основе ожидаемой рабочей нагрузки и помнить о Overcommit и swap.
- NUMA и локальность: на серверах с несколькими процессорами полезно учитывать NUMA-структуру; привязка CPU и памяти к узлам может снизить задержки и увеличить пропускную способность при больших запросах.
- Ограничения и квоты: устанавливайте лимиты и запросы (requests/limits) для каждого POD и применяйте горизонтальное масштабирование, когда это поддерживается (или масштабирование через StatefulSet и перераспределение ролей).
Масштабирование и эластичность
- Горизонтальное масштабирование FE и BE: добавление узлов BE позволяет увеличить параллелизм сканирования и хранение большего объема данных; FE-масштабирование улучшает устойчивость к падению конкретных узлов и уменьшает риск узкого горла в парсинге SQL.
- Эластичность к нагрузке: при пиковых нагрузках можно временно увеличить лимиты и перераспределить ресурсы через обновление манифестов, поддерживая минимальный набор реплик, чтобы избежать прерывания сервиса.
- Правила обновления: применяйте стратегии rolling update через StatefulSet/Operator с минимальными простоями; используйте readiness/ liveness probes, чтобы исключить неработающие ноды из кластера.
Конфигурационные практики
- Конфигурационные параметры StarRocks и поведения JVM-подобных окружений (если применимо) следует хранить в ConfigMap/Secret и подставлять через окружение контейнеров. Это позволяет управлять настройками без пересоздания образов.
- Предусмотреть параметры отказоустойчивости: тайм-ауты повторов, retry-политики, и конфигурации потоков, которые адаптируются под текущие показатели сервиса.
Эксплуатация: безопасность, мониторинг, резервирование и обновления
Эксплуатационные практики должны охватывать не только техническую реализацию, но и организационные аспекты: процессы сопровождения, мониторинга, а также регламент по обновлениям и резервированию.
Безопасность и доступ к данным
- Шифрование и TLS между FE и BE, а также между клиентами и кластером для защиты данных и запросов.
- Управление секретами: хранение учетных данных и ключей в Kubernetes Secrets, ограничение доступа к ним через RBAC.
- Сегментация сетей: использование NetworkPolicy для ограничения доступа к компонентам StarRocks и минимизации векторa атак.
Мониторинг и диагностика
- Метрики производительности: задержки,Throughput, частоты ошибок RPC, загрузка CPU и памяти по FE/BE.
- Метрики состояния кластера: статус репликаций, пропускная способность канала между FE и BE, состояние PVC и доступность узлов.
- Логирование: централизованный сбор логов для анализа сбоев и расследования инцидентов.
Резервное копирование и восстановление
- Регулярное создание бэкап-совместимых копий данных BE и метаданных FE, хранение копий в облачном или локальном хранилище.
- План тестирования восстановления: проверка работоспособности после восстановления, оценка времени простоя и степени соответствия SLA.
Обновления и автоматизация
- Helm-чарт или Operator: управляющие механизмы позволят автоматизировать развёртывание и обновления, упрощая развёртывание новых версий StarRocks и обеспечение согласованных конфигураций.
- CI/CD: внедрение пайплайнов для автоматизированных проверок совместимости и безопасного развертывания.
- Автоматизация реагирования на инциденты: применение оповещений, автоматических сценариев перераспределения нагрузки и перераспределения ресурсов.
Интеграции и практики автоматизации
Для эффективной эксплуатации целесообразно использовать готовые механизмы развёртывания и управления жизненным циклом StarRocks в Kubernetes:
- Helm-чарт или Kubernetes Operator: автоматизируют создание FE/BE-подов, настройку PVC, сетевых сервисов и конфигураций.
- Инструменты мониторинга: Prometheus + Grafana для визуализации метрик; сбор трассировок и логов через Jaeger и Elasticsearch-стек.
- Интеграции с системами хранения: использование CSI-драйверов для выбора подходящего хранилища и упрощение массового развёртывания данных.
Ниже приведён концептуальный пример конфигурации StatefulSet, иллюстрирующий базовую схему развёртывания FE-узла с постоянными данными:
apiVersion: apps/v1
kind: StatefulSet
metadata:
  name: starrocks-fe
spec:
  serviceName: "starrocks-fe"
  replicas: 3
  selector:
    matchLabels:
      app: starrocks-fe
  template:
    metadata:
      labels:
        app: starrocks-fe
    spec:
      containers:
      - name: starrocks-fe
        image: starrocks/starrocks-fe:latest
        ports:
        - containerPort: 9030
        volumeMounts:
        - name: data
          mountPath: /data
      volumes:
      - name: data
        emptyDir: {}
  volumeClaimTemplates:
  - metadata:
      name: starrocks-fe-data
    spec:
      accessModes: [ "ReadWriteOnce" ]
      resources:
        requests:
          storage: 100Gi
Важно помнить: такой манифест носит иллюстративный характер. В реальной среде требуется связывать PVC с конкретной StorageClass, обеспечивающей нужный уровень IOPS и задержек, а также настраивать параметры безопасности, масштабирования и обновления.
Эксплуатационные сценарии и лучшие практики
- Планирование масштабирования: заранее рассчитывайте требования к FE и BE в зависимости от рабочих нагрузок, затем применяйте последовательное масштабирование, избегая больших одновременных изменений.
- Обновления и миграции: применяйте rolling-update и blue/green-подходы, чтобы минимизировать downtime; тестируйте обновления в стенде перед релизом в продакшн.
- Управление зависимостями: следите за зависимостями между FE и BE, чтобы обновления не нарушали совместимость протоколов и конфигураций.
- Резервирование и DR: регулярно тестируйте сценарии аварийного восстановления и переносы данных между зонами доступности.
Key takeaways
- Архитектура StarRocks в Kubernetes требует чёткого разделения ролей FE и BE и продуманной сетевой топологии для минимизации задержек.
- Выбор и конфигурация хранилища определяют устойчивость к сбоям и производительность: локальные SSD для BE и сетевые/облачные решения для гибкости и резервирования.
- Вычислительные ресурсы должны предоставляться с учётом параллелизма и особенностей работы аналитических запросов; NUMA-совместимость и детерминированные квоты способствуют стабильности.
- Безопасность, мониторинг и резервное копирование являются неотъемлемыми частями эксплуатации; инструменты Helm/Operator и CI/CD повышают надёжность и скорость развёртываний.
- Автоматизация развёртываний и управления обновлениями снижает риск ошибок и простоя, особенно при масштабировании кластера.
- Практические конфигурации и манифесты должны соответствовать реальной инфраструктуре, включая StorageClass, CSI-драйверы и политики безопасности.
- Взаимодействие между компонентами StarRocks и Kubernetes должно быть хорошо задокументировано и протестировано, чтобы обеспечить предсказуемость поведения кластера.
FAQ
Какие сетевые требования являются критическими для StarRocks в Kubernetes?
- Основные требования — низкая задержка между FE и BE, стабильные DNS-имена узлов, надёжная маршрутизация запросов и ограничение доступа между компонентами через сетевые политики. Важна также детерминированная адресация внутри кластера и возможность горизонтального масштабирования без прерывания сервиса.
Как выбрать подходящее хранилище для BE и FE?
- BE-узлы чаще всего выигрывают от локального NVMe/SSD для минимальной задержки и максимальной пропускной способности, особенно при больших скановах данных. FE-модули могут использовать общедоступные PVC, но для критических сцен лучше обеспечить кеширование и быстрый доступ к метаданным. CSI-драйверы Ceph, Longhorn или облачные блоки — варианты выбора в зависимости от инфраструктуры и требований к резервному копированию.
Какие ресурсы нужно резервировать FE и BE?
- FE требует стабильного CPU и памяти для парсинга и планирования запросов, BE — для выполнения сканов и агрегаций. Рекомендуется начать с базовых квот и затем адаптировать их под наблюдаемые загрузки. Важно учитывать NUMA-архитектуру и не перегружать узлы одновременным повышением нагрузки на FE и BE.
Как обеспечить безопасность внутри кластера?
- Применяйте TLS между компонентами, храните ключи и учетные данные в Kubernetes Secrets, используйте RBAC для ограничения доступа, и настройте NetworkPolicy для ограниченного взаимодействия FE/BE и доступа клиентов.
Какие практики резервного копирования особенно важны?
- Резервировать как данные BE, так и метаданные FE; хранить копии вне кластера (S3/облачное хранилище); регулярно тестировать восстановление и согласование сроков хранения копий с требованиями SLA.
Как автоматизировать развёртывание и обновления StarRocks в Kubernetes?
- Используйте Helm-чарт или Kubernetes Operator, чтобы управлять конфигурациями, зависимостями и обновлениями; внедрите CI/CD для проверки совместимости и безопасного развёртывания; обеспечить детерминированные обновления через rolling обновления и тестовые стенды.
Какие признаки указывают на необходимость перераспределения ресурсов?
- Увеличение задержек выполнения запросов, падение throughput, рост очередей планирования или ошибок RPC — признаки того, что необходимо перераспределить ресурсы или добавить BE-узлы; мониторинг и алерты помогают своевременно скорректировать параметры кластера.
Какую роль играет Helm/Operator в управлении StarRocks в Kubernetes?
- Helm/Operator упрощает развёртывание, управление конфигурациями и обновлениями, обеспечивает единообразие окружения, обеспечивает повторяемость изменений и позволяет автоматизировать масштабирование и DR-процедуры.
Какие риски несёт неправильная конфигурация хранения?
- Недостаточная пропускная способность, высокие задержки, потеря данных при сбоях диска и сложности резервного копирования. Поэтому следует тщательно выбирать StorageClass, проводить тесты на нагрузке и вернуть баланс между локальностью данных и доступностью.
Что важно при планировании обновлений кластера?
- Всегда тестируйте обновления на стенде, применяйте rolling-updates, сохраняйте совместимость протоколов и конфигураций, контролируйте влияние изменений на производительность и потребление ресурсов, и не забывайте о резервном копировании перед обновлениями.
Глава построена с учётом практических сценариев развёртывания StarRocks в Kubernetes и ориентирована на инженеров по данным, архитекторов решений и DevOps-инженеров, отвечающих за инфраструктуру аналитических систем. В дальнейшем разделы можно расширять конкретными примерами под целевые облачные среды, а также дополнять интеграциями с конкретными версиями StarRocks и инструментарием мониторинга вашей компании.


